ARTICLE · 998771
测试全绿,项目却越改越坏:AI 编程工具缺的不是速度,是交接记录
LoopsBench 给团队的一张新验收表:把“完成”拆成可追溯的状态
让 Coding Agent 修完 issue,测试变绿,只能证明这一刻的代码能跑。真正进入长期项目后,风险出现在下一轮接手:它是否知道哪些依赖已经满足、哪些旧测试必须继续保护、当前停点是什么?这正是 LoopsBench 试图测量的部分。
先看一个容易被忽略的数字
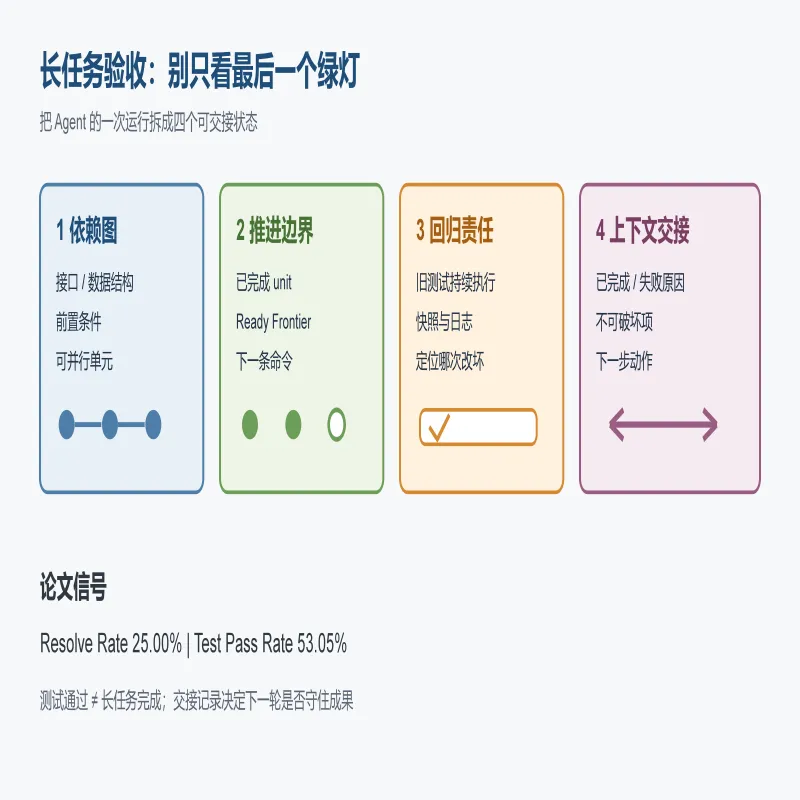
论文在 112 个 long-horizon tasks 上报告:最佳配置的 Resolve Rate 为 25.00%,Test Pass Rate 为 53.05%。前者要求一组有依赖的工程单元完整收敛,后者只统计测试通过。两者相差 28.05 个百分点,说明“测到绿灯”和“把任务推进到终点”不是同一件事。数字只适用于论文给出的数据集和配置,不能外推成所有工具的通用成功率。
我更关心的,是仓库里那套“交接协议”
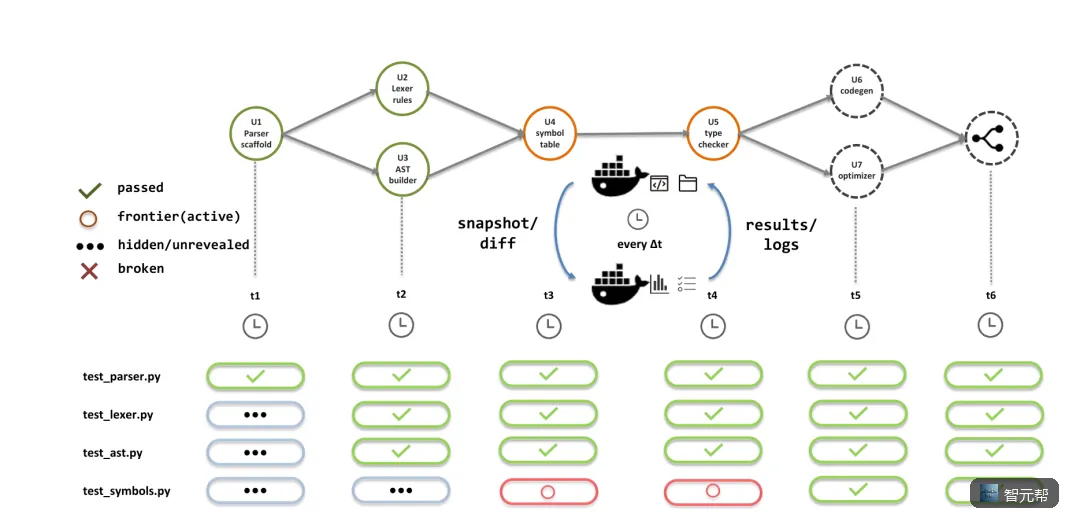
与其比较模型排名,团队真正能落地的是验收动作。我们查看 LoopsBench 公开仓库,发现它把一次运行拆成了几道可复核的门:
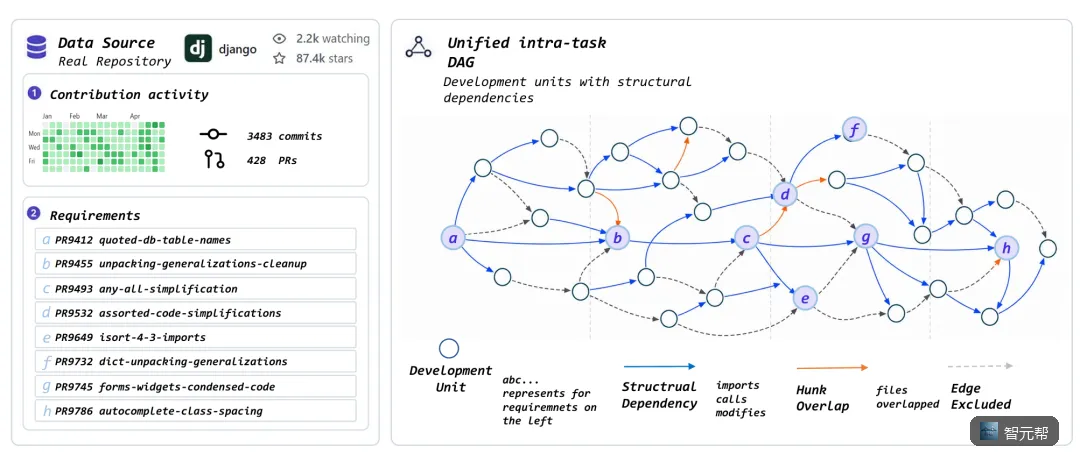
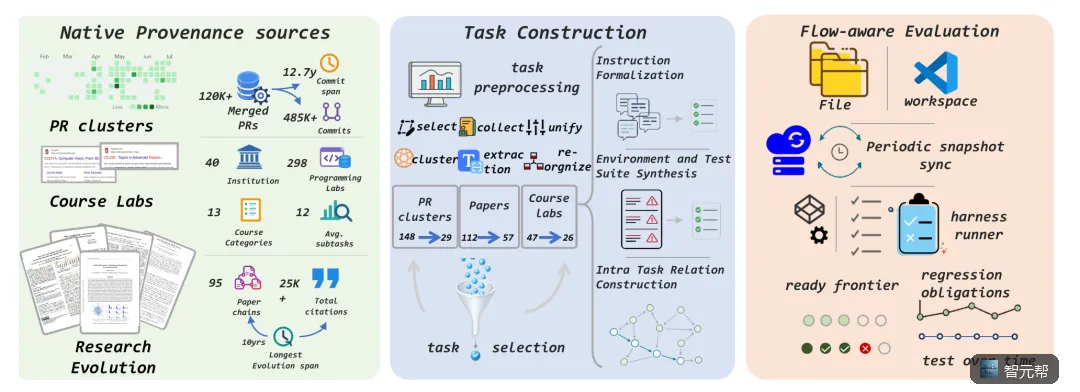
任务结构:每个任务有 unit-level requirements 和 dependency graph,后续单元只有在前置条件满足后才进入可评测状态。 状态留痕:通过 periodic snapshot、结果日志和快照校验,能够定位“哪次修改把已通过的功能弄坏”。 双层测试:公开测试用于推进,hidden tests 用于验收;仓库还要求先做静态校验,再跑 Oracle validation。 环境可复现:支持 remote、local-build、local-existing 三种 Docker 镜像策略,并为发布包生成 SHA-256 校验和。
这些不是“再加一个提示词”,而是一种交接协议:下一次调用 Agent 前,先把状态、依赖和不可破坏项写成机器和人都能读的记录。
团队可以直接抄走的四列验收表
依赖:本单元依赖哪些接口、数据结构或测试?未满足的 prerequisite 是什么? 停点:本轮完成了哪几个 unit,Ready Frontier(当前可继续推进的边界)在哪里? 守成:已有测试中哪些属于 Regression Obligation,下一轮必须重跑? 交接:如果换一个 context,三句话能否恢复“已完成、失败原因、下一步命令”?
验收时不要只保留最终 diff。至少保存一次运行配置、测试命令、快照时间点和失败日志。这样出了回归,责任边界才不会落成一句“模型自己改坏了”。
个人开发者的最小实践
如果你只是偶尔使用 Cursor、Claude Code 或 Codex,不必搭完整评测平台。每次长任务结束前,手动补三件事:把已通过的测试列出来;把下一步依赖写成一条命令;为新功能补一个会在后续运行中继续执行的回归测试。下一次会话先读这张清单,再允许 Agent 修改代码。
结论
LoopsBench 提醒我们的不是“哪个模型第一”,而是评分表缺了一栏:成果能否被下一次调用可靠接管。AI 编程工具要进入长期项目,速度只是起点;依赖、停点、回归和交接,才决定它能不能持续交付。
你在团队里验收 Coding Agent 时,最常丢失的是测试记录、依赖关系,还是上下文交接?欢迎把具体场景写在评论区。