2012 年计算机学科专业基础综合试题参考答案
一、单项选择题
1.
B
2.
A
3.
A
4.
B
5.
C
6.
C
7.
C
8.
A
9.
D
10.
A
11.
D
12.
D
13.
B
14.
D
15.
D
16.
A
17.
C
18.
C
19.
C
20.
D
21.
D
22.
B
23.
C
24.
B
25.
B
26.
A
27.
D
28.
A
29.
B
30.
C
31.
A
32.
B
33.
B
34.
C
35.
A
36.
B
37.
C
38.
A
39.
D
40.
D
1. 解析:
本算法是一个递归运算,即算法中出现了调用自身的情形。递归的边界条件是n~l, 每调
用一次factO, 传入该层facto的参数值减l 。采用递归式来表示时间复杂度有
0(1)
n~1
T(n) ={T(n-1)+1 n >
1
则T(n) = T(n-1) + 1 = T(n-2) + 2 =…= T(l) + n-1 = O(n), 故时间复杂度为O(n) 。
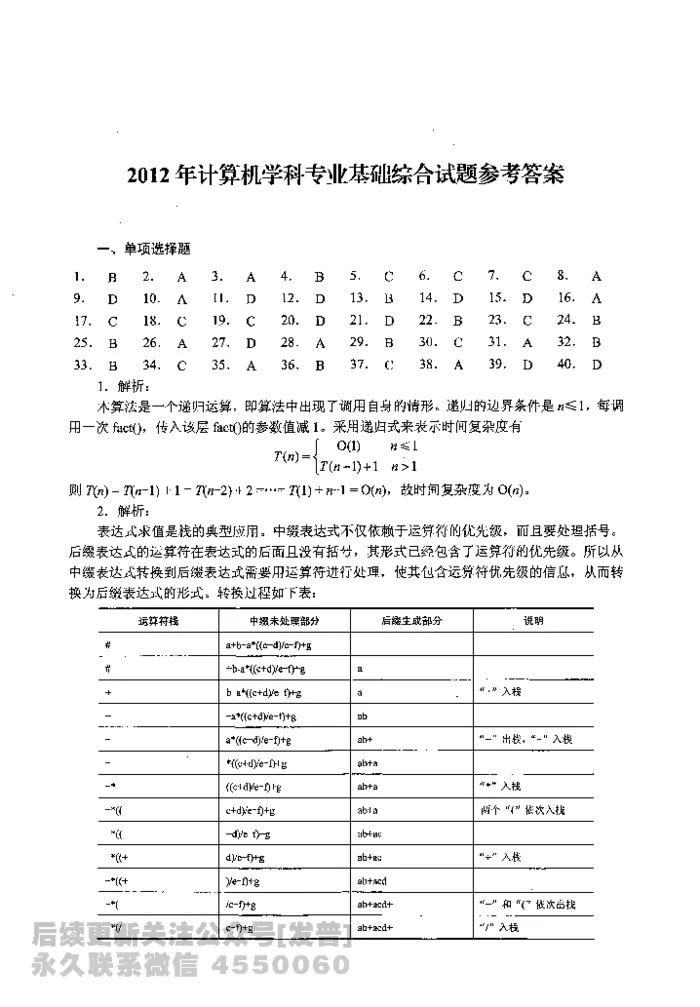
2. 解析:
表达式求值是栈的典型应用。中缀表达式不仅依赖千运算符的优先级,而且要处理括号。
后缀表达式的运算符在表达式的后面且没有括号,其形式已经包含了运算符的优先级。所以从
中缀表达式转换到后缀表达式需要用运算符进行处理,使其包含运算符优先级的信息,从而转
换为后缀表达式的形式。转换过程如下表:
运算符栈
中缀未处理部分
后缀生成部分
说明
#
a+b-a*((c+d)/e-t)+g
#
+b-a*((c+d)/e-f)+g
a
+
b-a *((c+d)le-f)+g
a
"+"入栈
+
-a*((c+d)/e-f)+g
ab
a*((c+d)/e-f)+g
ab+
"+"出栈,"-”入栈
*((c+d)/e-f)+g
ab+a
一*
((c+d)/e-f)+g
ab+a
"*"入栈
一*((
c+d)/e-f)+g
ab+a
两个"("依次入栈
-•((
+d)/e-f)+g
ab+ac
一*((+
d)/e-f)+g
ab+ac
"+"入栈
一*((+
)/e-f)+g
ab+acd
一*(
/e-f)+g
ab+acd+
"+"和"("依次出栈
一*(/
e-f)+g
ab+acd+
"I" 入栈
运算符栈
中缀未处理部分
后缀生成部分
说明
-*(I
-t)+g
ab+acd+e
-*(一
f)+g
ab+acd+e/
"I"出栈,“-”入栈
-*(一
)+g
ab+acd+e/f
-*
+g
ab+acd+e/f-
"-"和"("依次出栈
+g
ab+acd+e/f-*
"*"出栈
#
+g
ab+acd+e/f-*-
"-"出栈
+
g
ab+acd+e/f-*-
"+"入栈
#
ab+acd+e/f-*-g
"+"出栈
(续表)
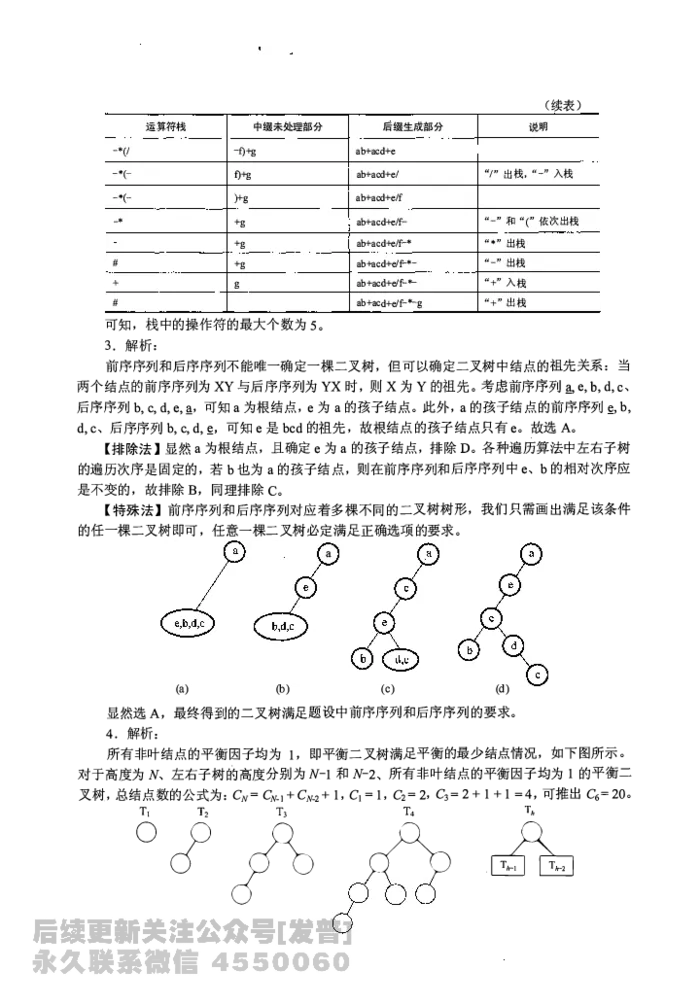
可知,栈中的操作符的最大个数为5。
3. 解析:
前序序列和后序序列不能唯一确定一棵二叉树,但可以确定二叉树中结点的祖先关系:当
两个结点的前序序列为XY与后序序列为YX时,则X为Y的祖先。考虑前序序列ö'e, b, d, C 、
后序序列b,c, d, e, 且,可知a为根结点,e为a的孩子结点。此外,a的孩子结点的前序序列_.b,
d,c、后序序列b,c, d,_. 可知e是bed的祖先,故根结点的孩子结点只有e。故选A。
【排除法】显然a为根结点,且确定e为a的孩子结点,排除D。各种遍历算法中左右子树
的遍历次序是固定的,若b也为a的孩子结点,则在前序序列和后序序列中e、b的相对次序应
是不变的,故排除B, 同理排除C。
【特殊法】前序序列和后序序列对应着多棵不同的二叉树树形,我们只需画出满足该条件
的任一棵二叉树即可,任意一棵二叉树必定满足正确选项的要求。
a
(a)
(b)
(c)
(d)
显然选A, 最终得到的二叉树满足题设中前序序列和后序序列的要求。
4. 解析:
所有非叶结点的平衡因子均为1, 即平衡二叉树满足平衡的最少结点情况,如下图所示。
对于高度为N、左右子树的高度分别为N-1和N-2、所有非叶结点的平衡因子均为1的平衡二
叉树,总结点数的公式为:CN=C凡I + C'. 凡2+1, C1 = 1, C2=2, C3=2+ 1 + 1 = 4, 可推出C6 =20。
勹/三三
【画图法】先画出m和Tz; 然后新建一个根结点,连接T公飞构成T3; 新建一个根结点,
连接T3、飞构成T4; 以此类推,直到画出T6,
可知飞的结点数为20。
【排除法】对千选项A,
高度为6、结点数为10 的树怎么也无法达到平衡。对于选项c,
结点较多时,考虑较极端情形,即第6层只有最左叶子的完全二叉树刚好有32个结点,虽然满
足平衡的条件,但显然再删去部分结点,依然不影响平衡,不是最少结点的情况。同理D错误。
只可能选B。
5. 解析:
广度优先遍历需要借助队列实现。邻接表的结构包括:顶点表;边表(有向图为出边表)。
当采用邻接表存储方式时,在对图进行广度优先遍历时每个顶点均需入队一次(顶点表遍历),
故时间复杂度为O(n), 在搜索所有顶点的邻接点的过程中,每条边至少访问一次(出边表遍历),
故时间复杂度为O(e), 算法总的时间复杂度为O(n + e)。
6. 解析:
对角线以下元素均为零,表明只有顶点l到顶点j (i <j)可能有边,而顶点j到顶点i 一定
没有边,即有向图是一个无环图,因此一定存在拓扑序列。对于拓扑序列是否唯一,试举一例:
0 1
1
设有向图的邻接矩阵[o o ol 则存在两个拓扑序列,因此该图存在可能不唯一的拓扑序列。
0 0 0
结论:对于任一有向图,如果它的邻接矩阵中对角线以下(或以上)的元素均为零,则存
在拓扑序列(可能不唯一)。反正,若图存在拓扑序列,却不一定能满足邻接矩阵中主对角线以
下的元素均为零,但是可以通过适当地调整结点编号,使其邻接矩阵满足前述性质。
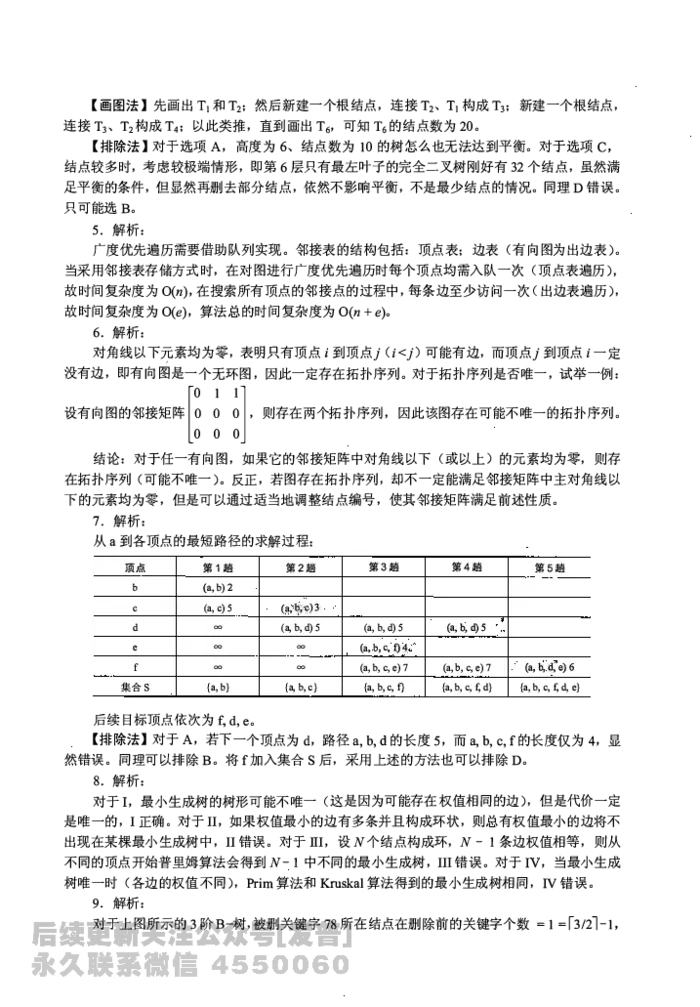
7. 解析:
从a到各顶点的最短路径的求解过程:
顶点
第1趟
第2趟
第3趟
第4趟
第5趟
b
(a, b) 2
C
(a, c) 5
(a, q; c) 3
d
=
(a, b, d) 5
(a, b, d) 5
(a, b, d) 5
e
ex,
=
(a, b, c, t) 4
f
=
=
(a, b, c, e) 7
(a, b, c, e) 7
(a, b, d, e) 6
集合S
{a, b}
{a,b,c}
{a, b, c, f}
{a, b, c, f, d}
{a, b, c, f, d, e}
后续目标顶点依次为f, d, e。
【排除法】对于A, 若下一个顶点为d, 路径a,b,d的长度5, 而a,b, c, f的长度仅为4, 显
然错误。同理可以排除B。将f加入集合S后,采用上述的方法也可以排除D。
8. 解析:
对于I, 最小生成树的树形可能不唯一(这是因为可能存在权值相同的边),但是代价一定
是唯一的,I正确。对于II, 如果权值最小的边有多条并且构成环状,则总有权值最小的边将不
出现在某棵最小生成树中,II错误。对于III, 设N个结点构成环,N - 1条边权值相等,则从
不同的顶点开始普里姆算法会得到N- 1中不同的最小生成树,III错误。对于IV, 当最小生成
树唯一时(各边的权值不同),Prim算法和Kruskal算法得到的最小生成树相同,IV错误。
9. 解析:
对于上图所示的3阶B-树,被删关键字78所在结点在删除前的关键字个数=1=「3127-1'
/
且其左兄弟结点的关键字个数=2DŽ「321, 属于
“兄弟够借
” 的情况,则需把该结点的左兄弟
结点中最大的关键字上移到双亲结点中,同时把双亲结点中大于上移关键字的关键字下移到要
删除关键字的结点中,这样就达到了新的平衡,如下图所示。
10
/
10
65
10 . 解析:
对于I, 简单选择排序每次选择未排序列中的最小元素放入其最终位置。对于II, 希尔排
序每次是对划分的子表进行排序,得到局部有序的结果,所以不能保证每一趟排序结束都能确
定一个元素的最终位置。对于III, 快速排序每一趟排序结束后都将枢轴元素放到最终位置。对
于IV, 堆排序属于选择排序,每次都将大根堆的根结点与表尾结点交换,确定其最终位置。对
于v, 二路归并排序每趟对子表进行两两归并从而得到若干个局部有序的结果,但无法确定最
终位置。
11 . 解析:
折半插入排序与直接插入排序都是将待插入元素插入前面的有序子表,区别是:确定当前
记录在前面有序子表中的位置时,直接插入排序是采用顺序查找法,而折半插入排序是采用折
半查找法。排序的总趟数取决于元素个数n,
两者都是n-l 趟。元素的移动次数都取决于初试
序列,两者相同。使用辅助空间的数量也都是0(1)。折半插入排序的比较次数与序列初态无关,
为O(nlog2n); 直接插入排序的比较次数与序列初态有关,为O(n)-O(n
2)。
12. 解析:.
程序A的运行时间为100s, 除去CPU时间90s, 剩余10s 为1/0时间。CPU提速后运行基
准程序A所耗费的时间是T=90/1.5 + 10 = 70s。
【误区】CPU速度提高50%, 则CPU时间减少一半,而误选A。
1 3. 解析:
将一个16位unsigned short 转换成32位形式的unsigned int, 因为都是无符号数,新表示
形式的高位用0填充。16位无符号整数所能表示的最大值为65 5 35, 其十六进制表示为FFFFH,
故x的十六进制表示为FFFFH -5H = FFFAH, 所以y的十六进制表示为0000 FFFAH。
【排除法】先直接排除C、D, 然后分析余下选项的特征。由于A、B的值相差儿乎近1倍,
可采用算出0001 OOOOH (接近B且好算的数)的值,再推断出答案。
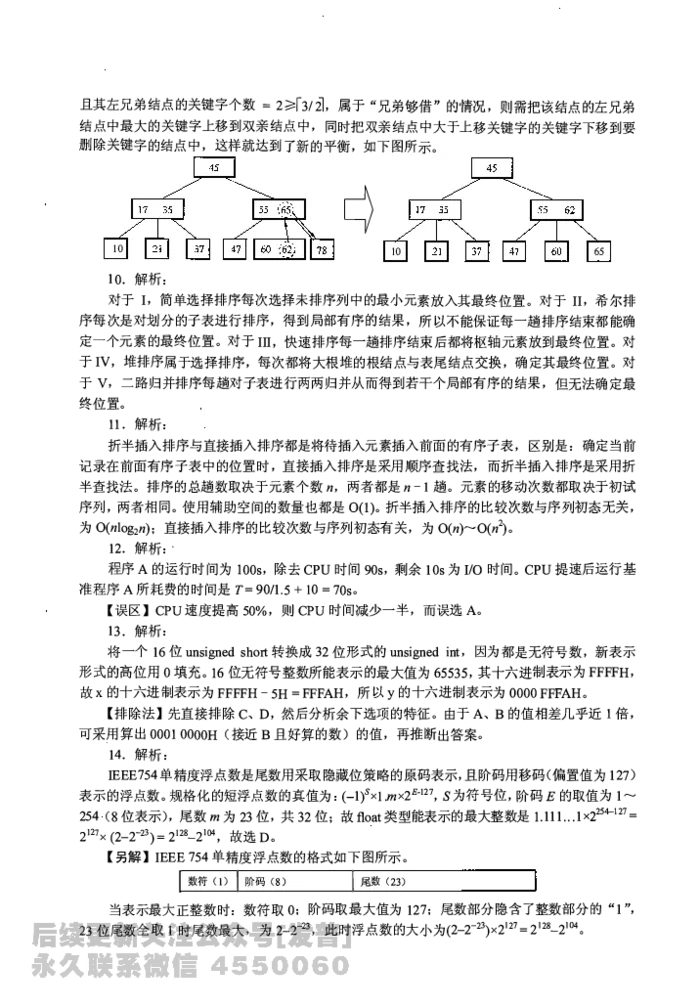
14. 解析:
IEEE 754单精度浮点数是尾数用采取隐藏位策略的原码表示,且阶码用移码(偏置值为127)
表示的浮点数。规格化的短浮点数的真值为:(-1)8 xl.mx2丘127, S为符号位,阶码E的取值为1-
254 (8位表示),尾数m为23位,共32位;故float 类型能表示的最大整数是1.111... 1 xl254-127 =
i21x (2-T23) = 212s_io4, 故选D。
【另解】IEEE 754单精度浮点数的格式如下图所示。
I 数符(I) I 阶码(8)
I 尾数(23)
当表示最大正整数时:数符取0; 阶码取最大值为127; 尾数部分隐含了整数部分的"1 "'
23 位尾数全取1 时尾数最大,为2-T23 , 此时浮点数的大小为(2-r23)x2'21= 2'2s_2'04 0
15. 解析:
尽管record大小为7个字节(成员a有4个字节,成员b有1个字节,成员c有2个字节),
由于数据按边界对齐方式存储(见考点笔记),故record共占用8个字节。record.a的十六进制
表示为0ǻ00000111, 由于采用小端方式存放数据,故地址OxC008 中内容应为低字节Oxll;
record.b只占1个字节,后面的一个字节留空;record. c占2个字节,故其地址为OxCOOE。各字
节的存储分配如下图所示。
;、.
·"
,,. 地.址
'
OxC008
-oxC009产
内容
record.a (Ox! I)
record.a (OxOI)
地址
OxCOOC
OxCOOD
内容
record.b
16. 解析:
OxCOOA
.e
record.a (OxOO)
OxCOOE
record.c
<.· ,, ,., •
.
OxCO
.·
O
.',
U
. ' 六
,'
m m m
record.a (OxOO)
OxCOOF
record.c
闪存是EEPROM的进一步发展,可读可写,用MOS管的浮栅上有无电荷来存储信息。闪
存依然是ROM 的一种,写入时必须先擦除原有数据,故写的速度比读的速度要慢不少(硬件
常识)。闪存是一种非易失性存储器,它采用随机访问方式。现在常见的SSD固态硬盘,即由
Flash芯片组成。
17. 解析:
地址映射采用2路组相联,则主存地址为0<1、4<5、g<9可映射到第0组Cache中,
主存地址为2<3、6<7 可映射到第1组Cache中。Cache置换过程如下表所示。
走向
。
4
8
2
。
6
8
6
4
8
第0组
块O
。
4
4
8
8
。
。
8
4
块l
Q
1
Ǽ
8
Q
。
8.
8
1
8.
块2
2
2
2
2
第1组
块3
i
2
2
6
6*
6
6
注:
“_”表示当前访问块,”*
”表示本次访问命中。
注意:在不同的《计算机组成原理》教材中,关于组相联映射的介绍并不相同。通常采用
唐朔飞教材中的方式,但本题中采用的是蒋本珊教材中的方式。可以推断两次命题的老师应该
不是同一位老师,这也给考生答题带来了困扰。
18. 解析:
字段直接编码法将微命令字段分成若干个小字段,互斥性微命令组合在同一字段中,相容
性微命令分在不同字段中,每个字段还要留出一个状态,表示本字段不发出任何微命令。5 个
互斥类分别包含7、3、12、5和6个微命令,需要3、2、4、3和3 位,共15位。
19. 解析:
总线频率为100MHz, 则时钟周期为lOns。总线位宽与存储字长都是32 位,故每一个时钟
周期可传送一个32位存储字。猝发式发送可以连续传送地址连续的数据,故总的传送时间为:
传送地址lOns, 传送128位数据40ns, 共需50ns。
20. 解析:
USB (通用串行总线)的特点有:O即插即用;@热插拔;@有很强的连接能力,采用菊
花链形式将众多外设连接起来;@有很好的可扩充性,一个USB控制器可扩充高达127个外部
USB设备;@高速传输,速度可达480Mbps。所以A、B、C选项都符合USB总线的特点。对
于D, USB是串行总线,不能同时传输2位数据。
21. 解析:
1/0接口与CPU之间的1/0总线有数据线、控制线和地址线。控制线和地址线都是单向传
输的,从CPU传送给1/0接口,而1/0接口中的命令字、状态字以及中断类型号均是由1/0接
口发往CPU的,故只能通过1/0总线的数据线传输。
22. 解析:
在响应外部中断的过程中,中断隐指令完成的操作包括:@关中断;@保护断点;@引出
中断服务程序(形成中断服务程序入口地址并送PC), 所以只有I、III正确。II中的保存通用
寄存器的内容是在进入中断服务程序后首先进行的操作。
23. 解析:
本题关键是对
“在用户态发生
“ (与上题的
“执行
” 区分)的理解。对于A, 系统调用是操
作系统提供给用户程序的接口,系统调用发生在用户态,被调用程序在核心态下执行。对于B,
外部中断是用户态到核心态的
“ 门
”,也发生在用户态,在核心态完成中断过程。对于C, 进程
切换属于系统调用执行过程中的事件,只能发生在核心态。对于D, 缺页产生后,在用户态发
生缺页中断,然后进入核心态执行缺页中断服务程序。
24. 解析:
子程序调用只需保存程序断点,即该指令的下一条指令的地址;中断调用子程序不仅要保
护断点(PC 的内容),而且要保护程序状态字寄存器的内容PSW。在中断处理中,最重要的两
个寄存器是PC 和PSWR。
25. 解析:
在程序装入时,可以只将程序的一部分装入内存,而将其余部分留在外存,就可以启动程
序执行。采用连续分配方式时,会使相当一部分内存空间都处于暂时或
“ 永久” 的空闲状态,
造成内存资源的严重浪费,也无法从逻辑上扩大内存容量,因此虚拟内存的实现只能建立在离
散分配的内存管理的基础上。有以下三种实现方式:CD请求分页存储管理;@请求分段存储管
理;@请求段页式存储管理。虚拟存储器容量既不受外存容量限制,也不受内存容量限制,而
是由CPU的寻址范围决定的。
26. 解析:
设备管理软件一般分为四个层次:用户层、与设备无关的系统调用处理层、设备驱动程序
以及中断处理程序。
27. 解析:
首先求得各进程的需求矩阵Need与可利用资源矢量Available:
Need
进程
R,
R2
Ri
p。
2
3
7
P1
I
3
3
P2
。
。
6
P3
2
2
I
P4
I
1
。
A,ailible 尸
二
比较Need和Available可以发现,初始时进程P1 与P3 可满足需求,排除A、C 。尝试给P1
分配资源,则P1 完成后Available将变为(6, 3, 6), 无法满足凡的需求,排除B 。尝试给P3 分配
资源,则P3 完成后Available将变为(4, 3, 7), 该向量能满足其他所有进程的需求。所以,以P3
开头的所有序列都是安全序列。
28. 解析:
对于I, 当所读文件的数据不在内存时,产生中断(缺页中断),原进程进入阻塞状态,直
到所需数据从外存调入内存后,才将该进程唤醒。对千II, read系统调用通过陷入将CPU 从用
户态切换到核心态,从而获取操作系统提供的服务。对于III, 要读一个文件首先要用open 系
统调用打开该文件。open中的参数包含文件的路径名与文件名,而read只需要使用open返回
的文件描述符,并不使用文件名作为参数。read要求用户提供三个输入参数:@文件描述符fd;
@buf缓冲区首址;@传送的字节数n。read的功能是试图从fd所指示的文件中读入n个字节
的数据,并将它们送至由指针buf所指示的缓冲区中。
29. 解析:
由于P2比P 1 晚5ms到达,P 1 先占用CPU, 作业运行的甘特图如下所示。
p l
CPU
tlms
I
I/Q
I
I
I
I
CPU
干----叩--宁一一一—
:
:
:
, CPU
I
I
I
I
匕—
I
I
I
I
I
I
I
I
I
I
I
I
I
I
I
I
I
80
220
260
:
CPU
:
I
I
I
I
,
YO
,
I
1-------------.J
I
I
I
I
I
I
I
I
I
I
..... --
'
...
60
140
30. 解析:
选项A、B、D显然是可以进行处理机调度的情况。对于c, 当进程处于临界区时,说明
进程正在占用处理机,只要不破坏临界资源的使用规则,是不会影响处理机调度的。比如,通
常访问的临界资源可能是慢速的外设(如打印机),如果在进程访问打印机时,不能进行处理机
调度,那么系统的性能将是非常差的。
31. 解析:
在引入线程后,进程依然还是资源分配的基本单位,线程是调度的基本单位,同一进程中
的各个线程共享进程的地址空间。在用户级线程中,有关线程管理的所有工作都由应用程序完
成,无须内核的干预,内核意识不到线程的存在。
32. 解析:
对于A, 重排1/0请求次序也就是进行1/0调度,从而使进程之间公平地共享磁盘访问,
减少1/0完成所需要的平均等待时间。对于c, 缓冲区结合预读和滞后写技术对于具有重复性
及阵发性的1/0进程改善磁盘1/0性能很有帮助。对于D, 优化文件物理块的分布可以减少寻
找时间与延迟时间,从而提高磁盘性能。在一个磁盘上设置多个分区与改善设备1/0性能并无
多大联系,相反还会带来处理的复杂和降低利用率。
33. 解析:
ICMP报文作为数据字段封装在IP
分组中,因此,IP协议直接为ICMP 提供服务。UDP
和TCP 都是传输层协议,为应用层提供服务。PPP 协议是链路层协议,为网络层提供服务。
34. 解析:
此题为概念题,过程特性定义各条物理线路的工作过程和时序关系。
35. 解析:
考虑到局域网信道质量好,以太网采取了两项重要的措施以使通信更简便:@采用无连接
的工作方式;@不对发送的数据帧进行编号,也不要求对方发回确认。因此,以太网提供的服
务是不可靠的服务,即尽最大努力的交付。差错的纠正由高层完成。
36. 解析:
本题即求从发送一个帧到接收到这个帧的确认为止的时间内最多可以发送多少数据帧。要
尽可能多发帧,应以短的数据帧计算,首先计算出发送一帧的时间:128x8/(16x103) = 64ms; 发
送一帧到收到确认为止的总时间:64 + 270x2 + 64 = 668ms; 这段时间总共可以发送668/64 =
10.4 C帧),
发送这么多帧至少需要用4位比特进行编号。
37. 解析:
I 和IV显然是IP路由器的功能。
对千II, 当路由器监测到拥塞时,可合理丢弃IP分组,
并向发出该IP分组的源主机发送一个源点抑制的ICMP报文。
对于III, 路由器对收到的IP分
组首部进行差错检验,
丢弃有差错首部的报文,但不保证IP分组不丢失。
38. 解析:
在实际网络的数据链路层上传送数据时,最终必须使用硬件地址,ARP协议是将网络层的
IP地址解析为数据链路层的MAC地址。
39. 解析:
子网掩码的第3个字节为11111100, 可知前22位为子网号、后10位为主机号。IP地址的
第3个字节为QlQQ且01 (下画线为子网号的一部分),将主机号(即后10位)全置为1, 可以
得到广播地址为180.80.79.255。
40. 解析:
SMTP采用
“ 推
” 的通信方式,在用户代理向邮件服务器及邮件服务器之间发送邮件时,
SMTP客户主动将邮件
“推
”
送到SMTP服务器。而POP3采用
“拉
” 的通信方式,当用户读
取邮件时,用户代理向邮件服务器发出请求,
“ 拉
” 取用户邮箱中的邮件。
二、综合应用题
41. 解答:
本题同时对多个知识点进行了综合考查。
对有序表进行两两合并考查了归并排序中的
merge()函数;对合并过程的设计考查了哈夫曼树和最佳归并树。外部排序属于大纲新增考点。
1)对千长度分别为m, n的两个有序表的合并,最坏情况下是一直比较到两个表尾元素,
比较次数为m + n-1次。故最坏情况的比较次数依赖于表长,
为了缩短总的比较次数,根据
哈夫曼树(最佳归并树)思想的启发,可采用如图所示的合
并顺序。
根据上图中的哈夫曼树,6个序列的合并过程为:
第1次合并:表A 与表B合并,生成含有45个元素的表
AB ;
第2次合并:表AB与表C合并,生成含有85个元素的
表ABC;
60
第3次合并:表D与表E合并,生成含有110 个元素的
�IO
表DE;
第4次合并:表ABC与表DE合并,生成含有195个元素的表ABCDE;
第5次合并:表ABCDE与表F合并,生成含有395个元素的最终表。
由上述分析可知,最坏清况下的比较次数为:第1次合并,最多比较次数=10 + 35 - 1 = 44;
第2次合并,最多比较次数=45 +40- 1 = 84; 第3次合并,最多比较次数=50 + 60 - 1 = 109;
第4次合并,最多比较次数=85 + 110-1 = 194; 第5次合并,最多比较次数=195 + 200 -1 = 394。
故比较的总次数最多为:44 + 84 + 109 + 194 + 394 = 825。
2)各表的合并策略是:在对多个有序表进行两两合并时,若表长不同,则最坏情况下总
的比较次数依赖于表的合并次序。可以借用哈夫曼树的构造思想,依次选择最短的两个表进行
合并,可以获得最坏情况下最佳的合并效率。
【1)2)评分说明】O对于用类似哈夫曼树(或最佳归并树)思想进行合并,过程描述正
确,给5 分。按其他策略进行合并,过程描述正确,给3分。
@正确算出与合并过程一致的总比较次数,给2分。若计算过程正确,但结果错误,可
给1分。
@考生只要说明采用的是类似哈夫曼树(或最佳归并树)的构造方法作为合并策略,即
可给3分。如果采用其他策略,只要能够完成合并,给2分。
42. 解答:
顺序遍历两个链表到尾结点时,并不能保证两个链表同时到达尾结点。这是因为两个链表
的长度不同。假设一个链表比另一个链表长k个结点,我们先在长链表上遍历k个结点,之后
同步遍历两个链表,这样就能够保证它们同时到达最后一个结点。由于两个链表从第一个公共
结点到链表的尾结点都是重合的,所以它们肯定同时到达第一个公共结点。
尾
部
对
齐
q
算法的基本设计思想:
@分别求出strl和str2所指的两个链表的长度m和n。
@将两个链表以表尾对齐:令指针p、q分别指向strl和str2的头结点,若m;;:=:n, 则使p
指向链表中的第m-n + l个结点;若m<n, 则使q指向链表中的第n -m+ 1个结点,即使指
针p和q所指的结点到表尾的长度相等。
@反复将指针p和q同步向后移动,并判断它们是否指向同一结点。若p和q指向同一
结点,则该点即为所求的共同后缀的起始位置。
2)算法的C语言代码描述:
豆n妞ode *F:irict'h七ComniortlLinkList·§trl, LinkLi.§t str2) {
··ɤ.. .
int lenl==Length(s七rlr,ɥen2=Leng七li(ɦ·tr2);
LinkNode *、P,*q;
for(p=strl;lenl>len2;lenl一一)
//使p指向的链表与q指向的链表等长
.,g==p->next;
, ɧ0立(q=stz;2江enl <;.l en2江�P:2 一一)
门使q指向的链表与p指向的链表等长
q=q->next;
while(p->next! =NULL&&p->next! =q-:->next){
II查找共同后缀起始点
p=p->next;
//两个指针同步向后移动
p,, 哭
夕.q=q一>next;
一了~沪尸心“
一鲨妇..
立eturn·p一>p.ext;
、. .. 于沁,·心产心\
,丫
,3..
II返回共同后缀的起始点
【1)、2)的评分说明】
@若考生所给算法实现正确,且时间复杂度为O(m+n), 可给12
分;若算法正确,但时间复杂度超过O(m+n), 则最高可给9分。
@若在算法的基本设计思想描述中因文字表达没有非常清晰反映出算法思路,但在算法
实现中能够清晰看出算法思想且正确的,可参照@的标准给分。
© 若算法的基本设计思想描述或算法实现中部分正确,可参照@中各种情况的相应给分
标准酌情给分。
3)时间复杂度为O(lenl+len2)或O(max(lenl,len2)), 其中lenl、len2分别为两个链表的
长度。
【3)的评分说明】
若考生所估计的时间复杂度与考生所实现的算法一致,可给1分。
43. 解答:
本题综合涉及多个考点:计算机的性能指标、存储器的性能指标、DMA的性能分析,DMA
方式的特点,多体交叉存储器的性能分析。
1)平均每秒CPU执行的指令数为:80M/4 = 20M, 故MIPS数为20; (1分)
平均每条指令访存1.5次,故平均每秒Cache缺失的次数=20Mxl.5x(l-99%) = 300k; (1分)
当Cache缺失时,CPU访问主存,主存与Cache之间以块为传送单位,此时,主存带宽为
16 Bx300k/s = 4.8MB/s。在不考虑DMA传送的情况下,主存带宽至少达到4.8MB/s才能满足
CPU的访存要求。(2分)
2)题中假定在Cache缺失的情况下访问主存,平均每秒产生缺页中断300000x0.0005% = 1.5
次。因为存储器总线宽度为32位,所以每传送32位数据,磁盘控制器发出一次DMA请求,
故平均每秒磁盘DMA请求的次数至少为l.5x4KB/4B = 1.5K = 1536。(2分)
3) CPU和DMA控制器同时要求使用存储器总线时,DMA请求优先级更高;(1分)
因为DMA请求得不到及时响应,1/0传输数据可能会丢失。(1分)
4)四体交叉存储模式能提供的最大带宽为4x4B/50ns = 320MB/s。(2分)
44. 解答:
1) X 的机器码为[x]补= 1111 1101 1111 1111B, 即指令执行前(RI) = FDFFH, 右移l位后位
1111 1110 1111 1111B, 即指令执行后(Rl)= FEFFH 。(2分)
2)每个时钟周期只能有一条指令进入流水线,从第5个时钟周期开始,每个时钟周期都
会有一条指令执行完毕,故至少需要4 + (5-1) = 8个时钟周期。(2分)
3) l3的ID段被阻塞的原因:因为l3与l 1 和l2都存在数据相关,需等到l 1 和l2 将结果写回
寄存器后,l3才能读寄存器内容,所以l3的ID段被阻塞CI分)。L的IF段被阻塞的原因:因
为l4的前一条指令l3在ID段被阻塞,所以L的IF段被阻塞(1分)。
注意:要求
”按序发射,按序完成
“ ,故2)中下一条指令的IF必须和上一条指令的ID并
行,以免因上一条指令发生冲突而导致下一条指令先执行完。
4)因2*x操作有左移和加法两种实现方法,故x=x*2+a对应的指令序列为
LOAD• • . F{l, Jx]
I2
LOAD
I3
SHL
I4
ADD
R2, .[a]
Rl
Rl, R2
IS
STORE-
R2, [x]
II或者
这5条指令在流水线中执行过程如下表所示。
时间单元
卢
:l'l'l'I'
l3
IF
IDIEXIMIWB
Rl, Rl
11 I 12 I 13 I 14 I 15 I 16 I 17
(续表)
时间单元
2 I 3 I 4 I 5 I 6 I 7 I 8 191 JO I II I 12 I 13 I 14 I 15 I 16 I 17
!4
IF
is
故执行x=x*2+a语句最少需要17个时钟周期。
45. 解答:
rn1Ex1M,WB
IF
IDIEXIMIWB
1)页框号为21。理由:因为起始驻留集为空,因此0页对应的页框为空闲链表中的第三
个空闲页框21, 其对应的页框号为21。
2)页框号为32。理由:因11 > 10故发生第三轮扫描,页号为1的页框在第二轮已处千空
闲页框链表中,此刻该页又被重新访问,因此应被重新放回驻留集中,其页框号为32。
3)页框号为41。理由:因为第2页从来没有被访问过,它不在驻留集中,因此从空闲页
框链表中取出链表头的页框41, 页框号为41。
4)合适。理由:如果程序的时间局部性越好,那么从空闲页框链表中重新取回的机会越
大,该策略的优势越明显。
46. 解答:
1)文件系统中所能容纳的磁盘块总数为4TB/1KB = 232。要完全表示所有磁盘块,索引项
中的块号最少要占32/8 = 4B。而索引表区仅采用直接索引结构,故512B 的索引表区能容纳
512B/4B = 128个索引项。每个索引项对应一个磁盘块,所以该系统可支持的单个文件最大长度
是128x 1KB = 128KB。
2)这里的考查的分配方式不同于我们所熟悉的三种经典分配方式,但是题目中给出了详
细的解释。所求的单个文件最大长度一共包含两部分:预分配的连续空间和直接索引区。
连续区块数占2B, 共可以表示2'6个磁盘块,即2
26B。直接索引区共504B/6B = 84个索引
项。所以该系统可支持的单个文件最大长度是226B + 84KB。
为了使单个文件的长度达到最大,应使连续区的块数字段表示的空间大小尽可能接近系统
最大容量4TB。分别设起始块号和块数分别占4B, 这样起始块号可以寻址的范围是232个磁盘
块,共4TB,
即整个系统空间。同样,块数字段可以表示最多232个磁盘块,共4TB。
47. 解答:
【解析】1)由题47-a 表看出,源IP地址为IP分组头的第13-16字节。
表中1、3、4号
分组的源IP地址均为192.168.0.8 Cc0a8 0008H), 所以1、3、4号分组是由H发送的。
题47-a 表中,1号分组封装的TCP段的SYN = 1,ACK = O, seq = 846b41c5H; 2号分组封装的
TCP段的SYN = 1,ACK= 1, seq = e059 9fefH, ack = 846b41c6H;3号分组封装的TCP段的ACK = 1,
seq = 846b 41c6H, ack = e059 9flDH, 所以1、2、3号分组完成了TCP连接的建立过程。
由于快速以太网数据帧有效载荷的最小长度为46字节,表中3、5 号分组的总长度为40
(28H)字节,小于46字节,其余分组总长度均大于46字节。所以3、5号分组通过快速以太
网传输时需要填充。
2)由3号分组封装的TCP段可知,发送应用层数据初始序号为seq = 846b 41c6H, 由5
号分组封装的TCP段可知,ack为seq = 846b 41d6H, 所以S已经收到的应用层数据的字节数