ARTICLE · 1001146
每换一个 AI 工具都要重新自我介绍?我把它们的记忆接到了一起
装了一个新的 AI 工具,装完第一件事,又是老一套:把项目背景粘一遍,把我的代码习惯说一遍,上次改到哪了再讲一遍。讲完我盯着屏幕算了下,这活儿今年干了不下十回。
Claude Code 记它自己的,Cursor 记它自己的,WorkBuddy 也记它自己的。各自都记得挺明白,就是互相不通气。同一个我,在几个工具里被记成了几个人。
前几天翻到一个开源项目,专门治这个:Memmy,MemTensor 做的,一句话说就是"给所有 AI 用的本地记忆中心"。装一个,几个工具读同一份。
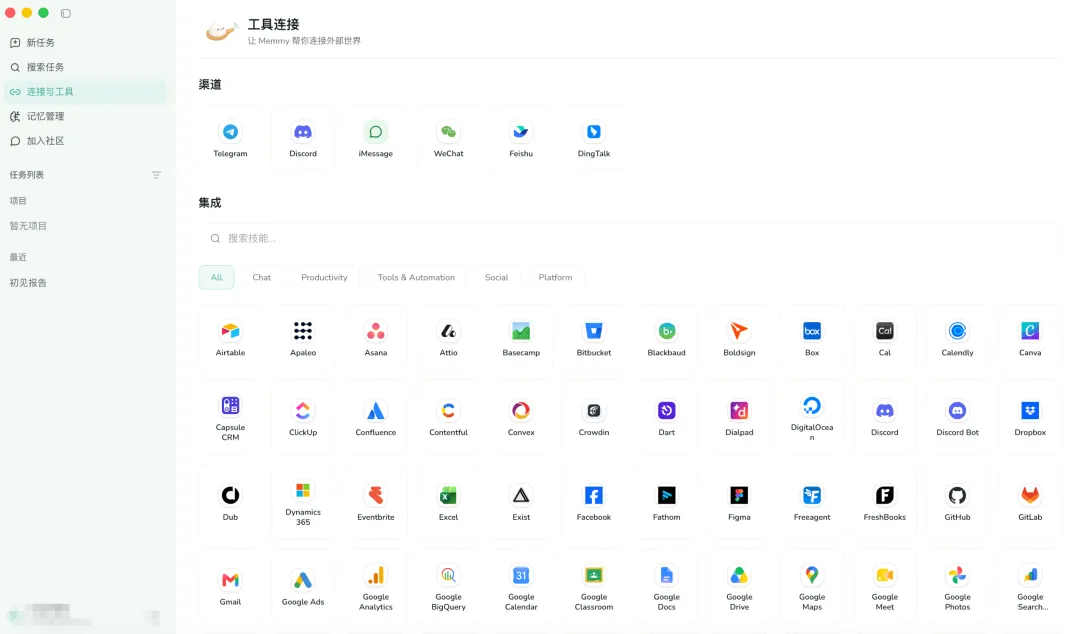
图 1|连接与工具页:上面是消息渠道,下面是能接的集成应用
它干的活其实就一件:把你本地攒下来的 AI 协作记录收拢起来,整理成结构化的记忆。等你换工具,项目背景、你的偏好、干到哪一步了,它替你带过去,不用你再开口。宣传里管这个叫三个能力,记住、接力、自己还能干活。我自己的体感是"接力"那一下最实在,换工具不卡壳。
跟工具自带的记忆比,差在哪?自带的只认自己家,出了这个门就不认了。Memmy 是几个工具读同一份,改一处,全都跟着变。
我装的是桌面版。第一次打开它会先扫一遍本地的 AI 协作历史,出一份"初次见面报告"。我最近在忙什么、跟几个 AI 都聊过什么,它自己先过了一遍,没让我喂材料。之后记忆服务就常驻在后台,别的工具要用随时来读。
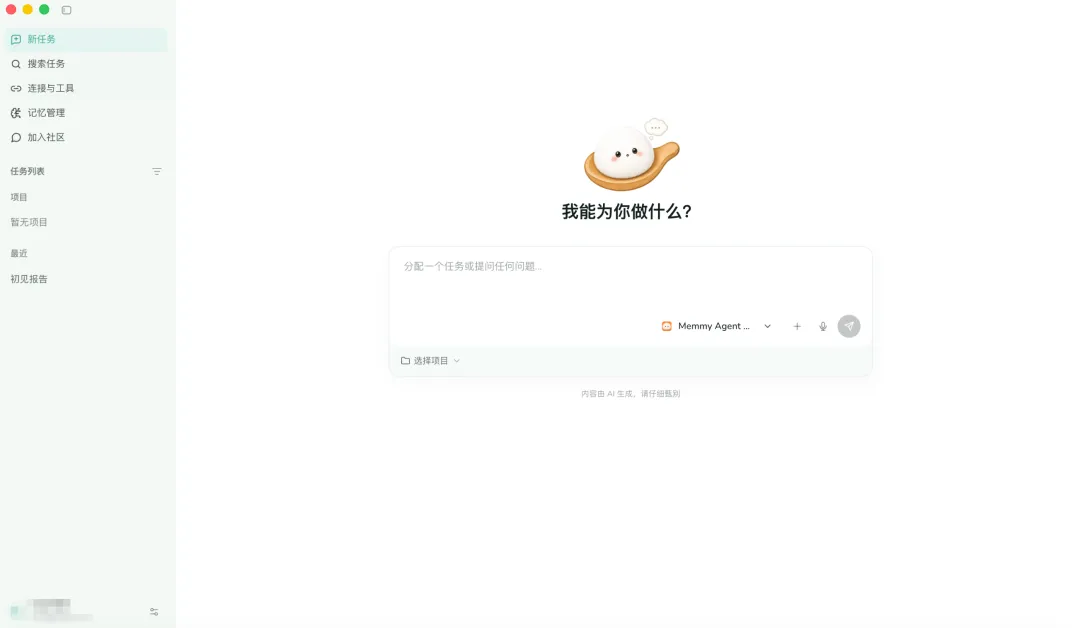
图 2|Memmy 桌面版主界面,新任务从这里发起
命令行也是全的。Linux 上一条脚本装 CLI,装完多两个本地服务,记忆服务和网关,地址都绑在 127.0.0.1。想给哪个工具接上,跑一次 memmy-memory init,它自己去找、自己装,不动你原来的配置。平时想查记忆,敲 memmy-memory search "关键词" 就行。它还能再起一个 OpenAI 兼容的 API,自己写的脚本想读记忆,走的也是这一份。
数据这块我看到的:记忆服务跑在本机,不是非得把历史传到别处才能用。不过注册送 token 这事本身也说明它有云端在配合。送的那点试用 token 够把功能跑全,用完了就换成自己的模型 key。想彻底断网用的同学注意,自己填 key 再配本地模式,更接近"全在自己手里",第一次接入还是得跟着它的引导走一遍。
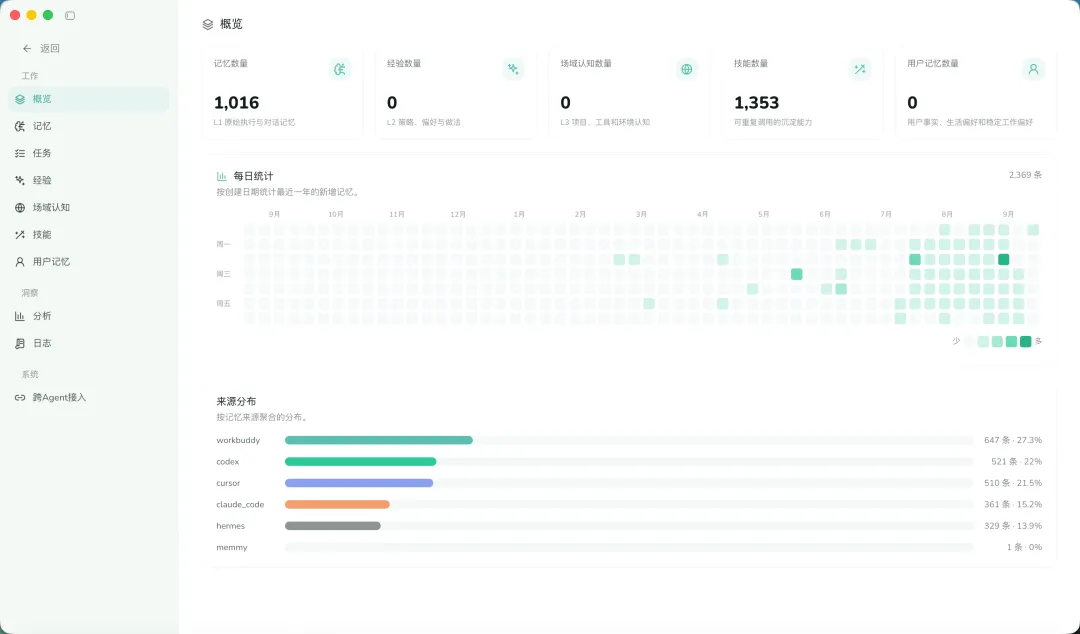
图 3|记忆概览页:来源分布里能看到每个工具各自贡献了多少条记忆
几句实话。项目迭代快,这几天还在合并代码,也上过 Product Hunt 的日榜,建议先用桌面版把流程跑通,别一上来就折腾命令行。
它的路线图我瞄了一眼:记忆来源以后要从 AI 对话扩到浏览器记录、本地文档,再往后是更多设备;团队协作也在计划里,让成员的 AI 在隐私前提下共享知识。真做出来,就不只是编程工具的事了。
我装完干的第一件事,是把 Claude Code 里的项目背景直接带到了 Cursor 和 WorkBuddy。没复制粘贴,它自己读的。
写完这段我看了眼时间,这大概是今年头一回换工具没花半小时自我介绍。