ARTICLE · 1001192
可以搜索,不能训练:网站开始给AI发三种通行证
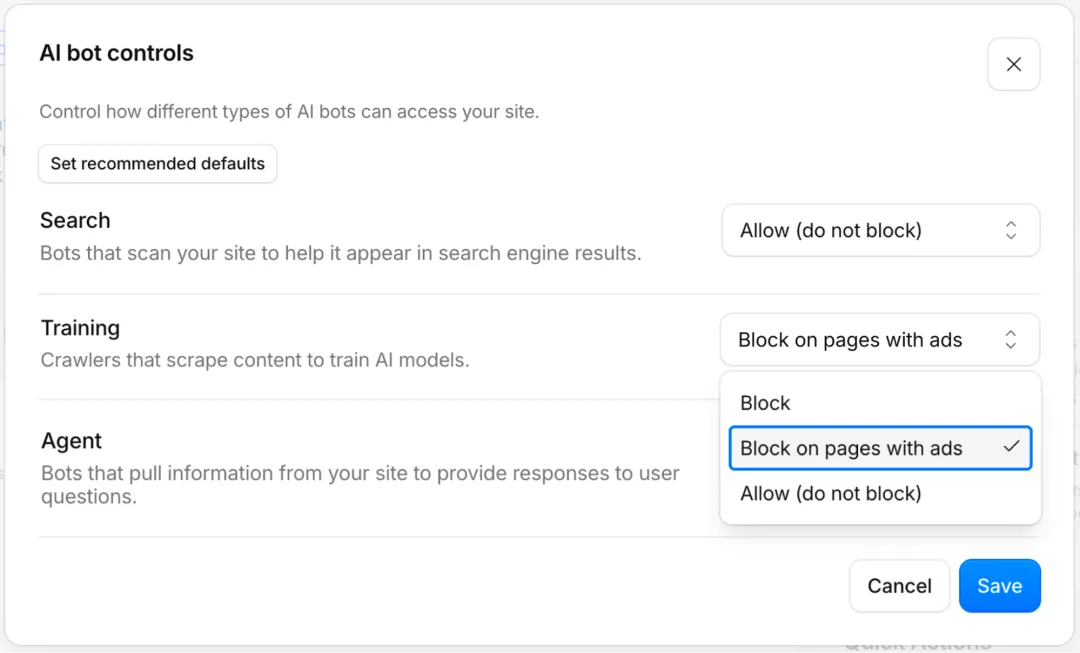
Cloudflare在7月1日公布了这项安排,并把9月15日设为生效节点。对于新客户、新增网站,以及到今天仍未修改相关设置的现有免费客户,含广告页面的默认规则变为:允许搜索用途,阻止训练和智能体用途。一个爬虫如果把搜索、训练和智能体访问混在同一个身份里,网站无法分别选择,它就会被这些页面默认拦下。
这不是“网站拒绝AI”。恰恰相反,它第一次把过去笼统的“AI能不能抓”拆成了三个问题:内容能否被找到,能否进入模型,能否在用户发问时直接成为答案或行动的输入。
同一次抓取,背后是三种生意
搜索抓取的基本交换很容易理解。
网站允许搜索引擎读取页面,搜索结果提供链接和短摘要,把用户带回原站。网站用内容换曝光,再通过广告、订阅、商品或服务完成收入。抓取不是目的,引流才是交换成立的原因。
训练抓取不同。内容进入模型训练或微调之后,会参与塑造模型长期能力。原网页未必在用户使用模型时被再次访问,网站也很难从一次回答追溯到哪篇内容发挥了多大作用。对内容方来说,这是把现有作品变成模型的生产资料。
智能体访问又是第三种用途。它可能在用户提问的当下读取网页,为回答提供事实;也可能替用户比较商品、查询库存、安排旅行或完成交易。Cloudflare的Content Signals把这类实时输入称为`ai-input`,包括检索增强生成、事实锚定和生成式搜索答案。它和训练的差别在于“当下使用”,和传统搜索的差别在于,用户有可能在AI界面里直接拿到结果,不再点击原网页。
因此,“允许搜索、拒绝训练”并不矛盾。网站愿意被找到,不等于愿意被训练;愿意提供链接和短摘要,也不等于愿意把全文直接交给答案引擎。
Google自己的爬虫规则也已经体现了这种分离。`Googlebot`影响Google搜索收录;`Google-Extended`则用于让网站管理内容是否可被用于Gemini训练和搜索锚定,而且Google明确说明,限制后者不会影响网站进入Google搜索,也不是搜索排名信号。
9月15日改变的,是默认选项
Cloudflare没有给全网制定新法律,也没有替所有网站作出永久决定。
它改变的是自己网络中的默认配置,而且范围带着四个限定:新客户、新网站、未自行修改设置的现有免费客户,以及含广告的页面。客户随时可以在控制台重新允许或阻止某类爬虫。
默认选项仍然重要,因为大多数网站不会逐一研究数十个爬虫的身份和用途。过去,混合用途爬虫把“能否被搜索”和“能否被AI使用”绑在一起,网站如果全部放行,就可能同时放行训练;如果全部拒绝,又可能失去搜索曝光。
Cloudflare这次把成本倒了过来:爬虫想获得不同用途的访问权,先要把身份和目的拆清楚。可识别、用途透明的爬虫可以被分别管理;无法区分用途的混合爬虫,在相关广告页面上先被挡在门外。
这使“机器访问”从一个开关,变成一张权限表。
为什么内容方不愿再给一张通票
Cloudflare披露,过去一年,出版商与AI平台已经签署超过50项重要内容许可协议。这个数字来自公司统计,并不是全球完整合同清单,但它至少说明:内容授权已经从原则争论进入真实采购。
与此同时,访问本身也在制造成本。Cloudflare称,超过50%的AI爬虫流量用于重新抓取没有变化的网页。每一次重复抓取都会消耗网站带宽、服务器资源和AI公司的计算,却没有带来更新的信息。
还有一个更微妙的数据。Cloudflare称,最大的搜索引擎可以访问的信息量大约是领先AI公司的两倍,原因在于网站很难既保留搜索可见性,又拒绝同一爬虫的其他AI用途。这同样是企业口径,不能当作独立审计后的全网份额;但它准确指出了混合身份带来的谈判优势:当搜索入口和AI使用权绑在一起,网站很难只拒绝其中一项。
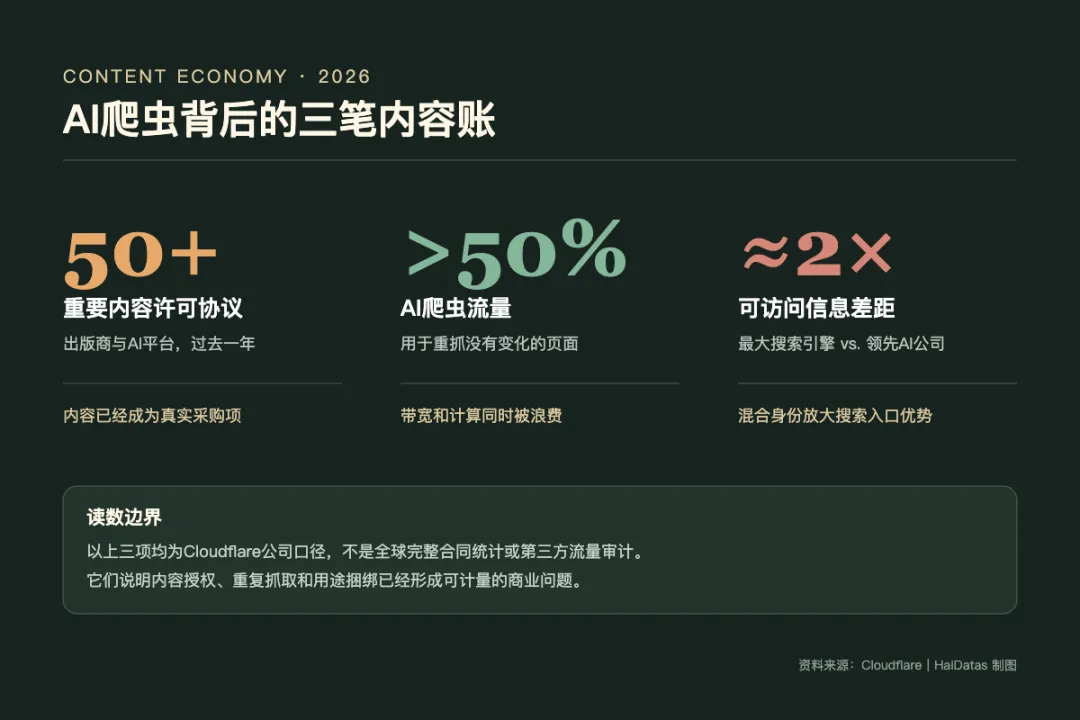
问题的核心不是爬虫数量,而是谁从每次访问中得到什么。
传统搜索通常给网站带回一次可计量的点击;AI训练获取的是长期模型能力;答案引擎和智能体则可能直接完成用户任务。三种用途创造的价值不同,却长期共用同一个“抓取”动作,冲突自然会集中到入口。
robots.txt为什么还不够
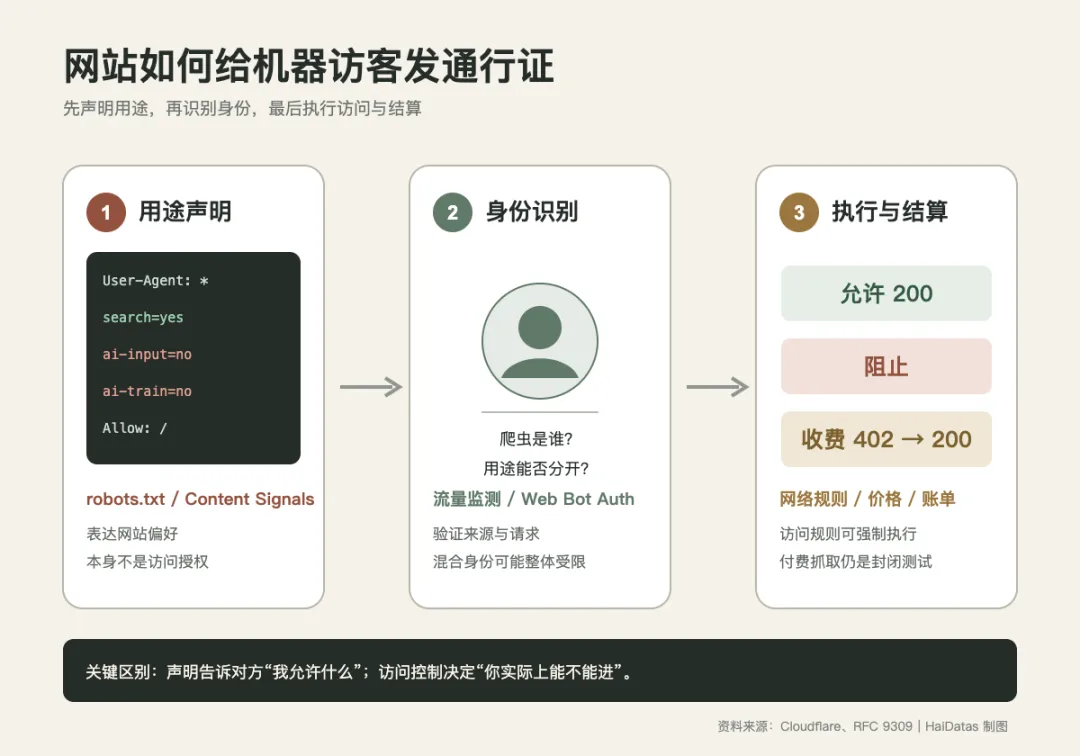
网站过去主要通过`robots.txt`告诉爬虫哪些路径可以访问。RFC 9309把这套协议标准化,同时明确写道:这些规则不是访问授权。Cloudflare的文档说得更直白——`robots.txt`表达偏好,合规依赖爬虫自愿遵守;要真正拦截,还需要AI Crawl Control、WAF或机器人管理规则。
Content Signals是在这份旧文件上增加用途标签。网站可以写明:`search=yes`,允许建立搜索索引并提供链接和短摘要;`ai-input=no`,拒绝在用户提问时把内容送入模型;`ai-train=no`,拒绝训练或微调。
这解决了“想表达什么”,却没有自动解决“对方是谁”和“对方会不会照做”。一个爬虫可以伪装User-Agent,也可能无视声明。Cloudflare因此把监测、身份验证和网络层拦截放在声明之后:先看见访问者,判断它的用途和是否遵守,再决定放行、阻断或收费。
换句话说,`robots.txt`像门口告示,网络访问控制才是门锁。
下一步不是只会封锁,而是给访问定价
当用途被分开,网站就不必只在“免费开放”和“彻底封锁”之间二选一。
Cloudflare正在测试的Pay Per Crawl给出了第三个选项:收费。网站按域名设置每次成功抓取的价格,最低为0.001美元。爬虫第一次访问付费页面时会收到`HTTP 402 Payment Required`和价格;愿意支付,就在经过身份验证的请求中带上可接受价格,成功返回`HTTP 200`后再记录实际费用。
这套产品目前仍是封闭测试,不能写成已经普遍运行的网页收费标准。Cloudflare也只是其中的技术和结算中介。网站设定的价格是否有人愿意付,单次抓取能否覆盖内容生产成本,按抓取收费会不会刺激更多缓存和更少更新,都还没有足够的公开数据。
而且按“抓了几次”计费也未必是最终形态。Cloudflare已经提出从Pay Per Crawl走向Pay Per Use:内容真正出现在AI搜索结果、被引用或帮助智能体完成一次高价值任务时再付费。前者容易计量,后者更接近内容创造的价值,但也更难归因。
网站真正需要的是一套“机器访客账本”
对内容网站来说,新的运营问题不再只是SEO。
它至少要知道四件事:谁来抓了哪些页面,抓取声称用于什么,遵守了哪些规则,以及这些访问带回多少点击、引用、订阅或收入。没有这本账,网站既无法判断该不该放行,也没有基础与AI公司谈授权价格。
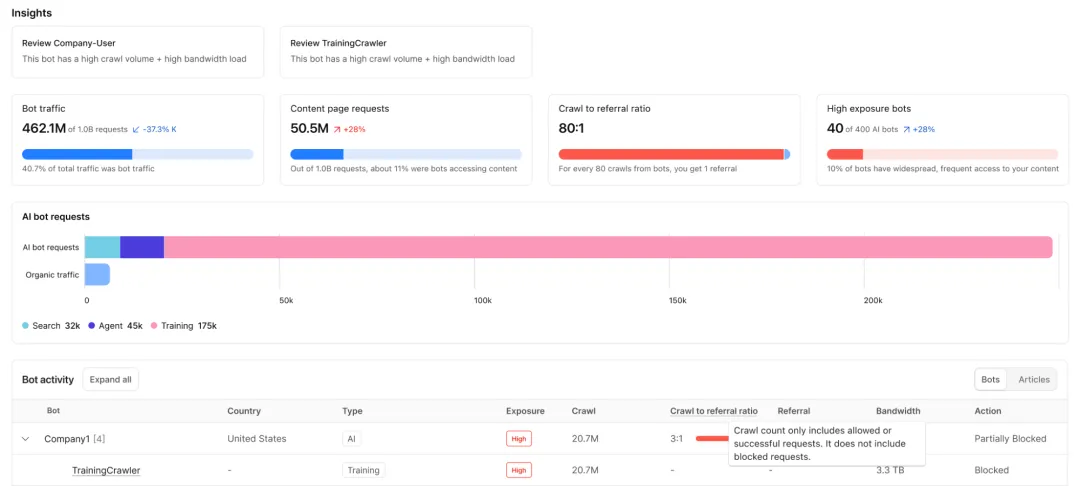
对AI公司来说,透明身份会成为新的基础设施。把搜索、训练和智能体访问拆成不同爬虫,短期增加了工程和合规成本,长期却能避免因为一个混合身份失去全部访问权。减少对未变化页面的重复抓取,也会直接降低计算与带宽浪费。
对普通用户来说,变化不一定表现为“AI突然看不到网页”。更可能出现的是内容分层:公开搜索可以找到标题和链接,AI回答只能引用获准内容,智能体访问高级信息时需要付费或跳回原站。搜索、答案和行动不再默认共享同一份网页权限。
网站正在把“被看见”和“被使用”分开
过去的开放网络建立在一个简单假设上:机器抓取最终会把人带回网页。
AI搜索和智能体改变了这条路径。机器不仅发现内容,还可能吸收内容、重组内容,甚至在不打开原站的情况下替用户完成任务。网站因此开始要求:每一种用途,都要有独立身份、独立许可和可计量的回报。
9月15日真正值得关注的,不是一家公司默认拦了多少爬虫,而是网络入口第一次开始按目的发放通行证。
可以搜索,不代表可以训练。
可以引用,不代表可以长期保存和复用。
能访问,也不再等于必须免费。
当这三条边界能够被机器读取、被网络执行、被账单记录,网站和AI之间的关系才从“先抓再说”,进入可以协商的阶段。
主要来源
Cloudflare 2026年7月1日公告[1]
Cloudflare AI Crawl Control[2]
Cloudflare Content Signals说明[3]
Cloudflare Pay Per Crawl文档[4]
RFC 9309[5]
Google爬虫说明[6]。
参考链接
[1] https://www.cloudflare.com/press/press-releases/2026/cloudflare-allows-the-agentic-internet-to-flourish-with-a-simple-philosophy-your-content-your-rules/
[2] https://developers.cloudflare.com/ai-crawl-control/
[3] https://developers.cloudflare.com/bots/additional-configurations/managed-robots-txt/
[4] https://developers.cloudflare.com/ai-crawl-control/features/pay-per-crawl/what-is-pay-per-crawl/
[5] https://www.rfc-editor.org/rfc/rfc9309.html
[6] https://developers.google.com/crawling/docs/crawlers-fetchers/google-common-crawlers