ARTICLE · 1002562
手写一个迷你 RAG:50 行代码跑通文档问答
手写一个迷你 RAG:50 行代码跑通文档问答
系列:RAG 实战系列 第01篇 上一篇:MCP vs A2A vs ACP:2026 年 Agent 协议选型指南(协议层系列完结) 预计阅读:12 分钟 读完你能得到:一个能跑、能改、能接你真实文档的迷你 RAG——完整 50 行代码在文末,可直接复制
引子:每个想做 RAG 的人,都死在第一周
一位读者的原话(私信):
"想让公司内部文档能问答。搜了三天教程:LangChain 版本对不上、LlamaIndex 文档看不懂、还得先装 Docker 起个 Milvus……我到现在一行代码都没跑起来。"
这是 RAG 落地最真实的死法——不是死于技术难,是死于框架太重。
RAG 的本质其实非常简单:
把你的文档切成小块 → 变成向量 → 用户提问时找到最相关的几块 → 塞进 prompt 让大模型回答。
就这么四步。什么 LangChain、向量数据库、Docker,都是这四步的"工业化包装"。包装有价值,但你不应该先学包装再学本质。
这篇用 50 行纯 Python 跑通上面四步——不用 LangChain,不用向量数据库,不用 Docker。跑通之后,你会对后面三篇(踩坑实录、向量库选型、Rerank)里的每个概念都有"体感"。
一、环境准备:2 分钟装好
1.1 装依赖
只需要两个包(Python 3.9+):
pip install sentence-transformers openaisentence-transformers | ||
openai |
1.2 验证安装
python -c "import sentence_transformers; print('OK', sentence_transformers.__version__)"# 输出类似: OK 3.x.x —— 就绪
1.3 准备大模型 API Key
用 DeepSeek 举例(换任何 OpenAI 格式的服务都行):
1. 打开 https://platform.deepseek.com/
2. API Keys → 创建 → 复制(形如 sk-xxxx)
第一次跑
SentenceTransformer时会下载模型文件(约 100MB,一次性)。国内网络慢的话设置镜像:export HF_ENDPOINT=https://hf-mirror.com
环境就绪。下面进入正题——先看全景,再逐块拆。
二、全景:50 行代码长什么样
先上完整结构(细节下节拆)。整个 RAG 就三个函数 + 一段准备:
# ── 准备:文档 + 嵌入模型 ──────────────────docs = [...] # ① 你的文档(切成块后的)model = SentenceTransformer(...) # ② 嵌入模型(本地)doc_vecs = model.encode(docs) # ③ 全部向量化(建索引)# ── 检索函数 ──────────────────────────────def retrieve(query, top_k): # ④ 问题向量化 → 余弦相似度 → 排序取前K# ── 生成函数 ──────────────────────────────def answer(question): # ⑤ 检索 → 拼上下文 → 调大模型
没有向量数据库。 因为 5 条文档的"向量检索"就是一个矩阵乘法——numpy 一行搞定。向量数据库解决的是"百万级向量的检索性能",你先用不到,等用到时再看第 03 篇。
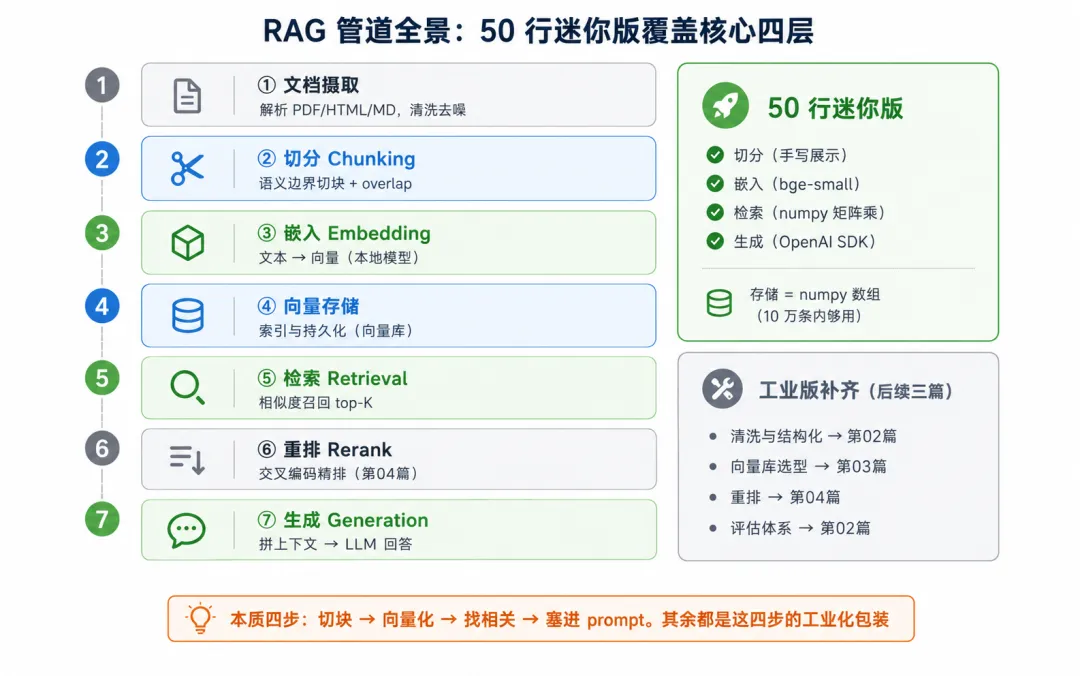
对照上图,这 50 行覆盖了管道的核心三层(切分→向量化→检索→生成)。工业级管道里剩下的层(清洗、重排、评估),是后面三篇的主角。
三、逐块拆解:每一行为什么这么写
3.1 文档块:chunk 是什么
docs = [ "RAG 是检索增强生成的缩写,通过检索外部知识来增强大模型的回答。", "RAG 系统的核心组件包括:文档切分、向量化、向量存储、检索和生成。", "RAG 相比微调的优势:成本低、知识可随时更新、不遗忘通用能力。", "chunk 是 RAG 中的最小检索单元,通常包含 256-512 个 token。", "余弦相似度是 RAG 中最常用的向量相似度度量方法。",]
为什么是一条一条而不是整篇文档? 因为检索的粒度决定命中的精度:你问"chunk 多大合适",如果索引的是整篇 5000 字文档,向量是全文语义的"平均值",跟问题的相关度就被稀释了。切成小块,每块向量语义集中,命中率才高。
这里的 5 条是演示数据(手工切好的)。接真实文档时把你的 md/txt 读进来,按段落或每 300-500 字切一刀即可——第 02 篇会专门讲切分怎么踩坑。
3.2 向量化:本地嵌入模型
model = SentenceTransformer("BAAI/bge-small-zh-v1.5")doc_vecs = model.encode(docs, normalize_embeddings=True)
• BAAI/bge-small-zh-v1.5:中文小模型,本地 CPU 可跑,512 维。选它是"中文 + 免费 + 快"三个条件的最优解
• normalize_embeddings=True:把向量归一化成单位长度。这一步是后面"矩阵乘法 = 余弦相似度"的前提——不是可选项,是伏笔
跑完 doc_vecs 是一个 5 × 512 的矩阵。你的"向量索引"建好了,就一个 numpy 数组。
3.3 检索:一个矩阵乘法
def retrieve(query: str, top_k: int = 2): q_vec = model.encode([query], normalize_embeddings=True) scores = q_vec @ doc_vecs.T # 余弦相似度 top_idx = scores[0].argsort()[::-1][:top_k] return [docs[i] for i in top_idx]
这五行是 RAG 的心脏,逐行看:
• q_vec @ doc_vecs.T:1×512 乘 512×5 = 1×5,得到问题和 5 个文档块的相似度。因为两边都归一化了,矩阵乘积就是余弦相似度——这就是 3.2 那个伏笔的回收
• argsort()[::-1]:按分数从高到低排序
• [:top_k]:取前 K 个。K 是超参数,迷你版取 2
验证一下检索好不好使:
print(retrieve("RAG 有什么优点?"))# 期望输出第一条是:「RAG 相比微调的优势:成本低、知识可随时更新……」
如果你的第一条不是它,先检查 normalize_embeddings=True 是不是漏了——没归一化时矩阵乘法算的是点积(受向量长度影响),排序会错。
3.4 生成:拼上下文调大模型
client = OpenAI(api_key="sk-xxx", base_url="https://api.deepseek.com")def answer(question: str) -> str: context = "\n".join(f"[{i+1}] {c}" for i, c in enumerate(retrieve(question))) resp = client.chat.completions.create( model="deepseek-chat", messages=[ {"role": "system", "content": f"仅根据以下资料回答,资料里没有就明确说不知道。\n{context}"}, {"role": "user", "content": question}, ], ) return resp.choices[0].message.content
三个细节决定回答质量:
1. system prompt 里那句"资料里没有就明确说不知道"——防幻觉的最低成本手段。没有它,模型会用自己的参数知识补答案,跟你的文档没关系
2. 带 [1] [2] 编号——后续要求模型引用编号,就得到最朴素的"引用溯源"
3. 只塞 top_k 个块,不塞全部——上下文不是越多越好(第 02 篇讲"中间衰减"时会展开)
3.5 跑起来
if __name__ == "__main__": print(answer("RAG 的核心组件有哪些?"))
预期输出:
根据资料 [2],RAG 系统的核心组件包括:文档切分、向量化、向量存储、检索和生成。问一个资料里没有的:
print(answer("RAG 支持图片检索吗?"))# 预期:资料里没有提到……(而不是模型自己编一段)
第二个输出比第一个更重要——它验证了"知识边界"生效,这正是 RAG 相比裸模型的全部意义。
四、接你的真实文档(10 行改造)
迷你版到真实版就差一个"读文件 + 切分":
import redef load_chunks(path: str, size: int = 300) -> list: """读文本文件,按段落粗切成 ~size 字的块""" text = open(path, encoding="utf-8").read() paras = [p.strip() for p in re.split(r"\n\s*\n", text) if p.strip()] chunks, buf = [], "" for p in paras: # 小段合并、大段切开 if len(buf) + len(p) < size: buf += "\n" + p else: chunks.append(buf.strip()); buf = p chunks.append(buf.strip()) return [c for c in chunks if len(c) > 20]docs = load_chunks("你的文档.md") # 替换这里doc_vecs = model.encode(docs, normalize_embeddings=True) # 重建索引
之后 retrieve / answer一行都不用改。这就是分层的红利:换数据不动逻辑。
千万文档块也别慌:1 万块 × 512 维的矩阵乘法在笔记本上也就百毫秒级。真正的瓶颈在"每次都重算全部文档向量"——所以工业界把
doc_vecs存起来(这就叫向量库,第 03 篇)。
五、踩坑实录(跟做时最容易翻的 4 个坑)
坑 1:模型下载 403/超时 症状:Connection error 卡住。解法:export HF_ENDPOINT=https://hf-mirror.com 后重跑。
坑 2:检索结果驴唇不对马嘴 症状:retrieve 第一条永远不对。十有八九是 normalize_embeddings=True 漏了,点积冒充了余弦相似度。加上它。
坑 3:回答是模型自己编的,跟文档无关 症状:问资料外的问题,模型对答如流。解法:检查 system prompt 的"仅根据资料回答,没有就说不知道"是不是被你精简掉了。这句是防幻觉底线。
坑 4:中文模型却全是英文文档(或反之) 症状:英文文档用 bge-small-zh,检索质量暴跌。嵌入模型有语言域——中英混合场景换 BAAI/bge-m3(多语言,稍大)。
这四个坑只是开胃菜。检索效果差的真实原因有 5 大类(chunk 边界、中间衰减、嵌入换版……),下一篇逐个拆。
六、完整代码(复制即跑)
"""mini_rag.py — 50 行跑通 RAG 文档问答依赖: pip install sentence-transformers openai"""import reimport numpy as npfrom sentence_transformers import SentenceTransformerfrom openai import OpenAI# ── ① 文档块(换成 load_chunks("你的文档.md") 即接真实数据)──docs = [ "RAG 是检索增强生成的缩写,通过检索外部知识来增强大模型的回答。", "RAG 系统的核心组件包括:文档切分、向量化、向量存储、检索和生成。", "RAG 相比微调的优势:成本低、知识可随时更新、不遗忘通用能力。", "chunk 是 RAG 中的最小检索单元,通常包含 256-512 个 token。", "余弦相似度是 RAG 中最常用的向量相似度度量方法。",]# ── ② 嵌入模型(本地,免费)+ ③ 建索引 ──model = SentenceTransformer("BAAI/bge-small-zh-v1.5")doc_vecs = model.encode(docs, normalize_embeddings=True)# ── ④ 检索 ──def retrieve(query: str, top_k: int = 2) -> list: q_vec = model.encode([query], normalize_embeddings=True) scores = q_vec @ doc_vecs.T top_idx = scores[0].argsort()[::-1][:top_k] return [docs[i] for i in top_idx]# ── ⑤ 生成 ──client = OpenAI(api_key="sk-替换成你的", base_url="https://api.deepseek.com")def answer(question: str) -> str: context = "\n".join(f"[{i+1}] {c}" for i, c in enumerate(retrieve(question))) resp = client.chat.completions.create( model="deepseek-chat", messages=[ {"role": "system", "content": f"仅根据以下资料回答,资料里没有就明确说不知道。\n{context}"}, {"role": "user", "content": question}, ], ) return resp.choices[0].message.content# ── 接真实文档的切分器(可选)──def load_chunks(path: str, size: int = 300) -> list: text = open(path, encoding="utf-8").read() paras = [p.strip() for p in re.split(r"\n\s*\n", text) if p.strip()] chunks, buf = [], "" for p in paras: if len(buf) + len(p) < size: buf += "\n" + p else: chunks.append(buf.strip()); buf = p chunks.append(buf.strip()) return [c for c in chunks if len(c) > 20]if __name__ == "__main__": print(answer("RAG 的核心组件有哪些?"))
收尾
50 行代码里藏着的,其实是 RAG 的世界观:
模型不必什么都知道——它只需要在回答的那一刻,拿到对的那几页资料。
迷你版的边界也很清楚:没有重排、没有混合检索、没有评估、向量重算是全量的。这些"工业化的部分"正是接下来三篇的内容:
觉得有帮助?,请转给正在学习Agent的朋友吧。
下一篇:RAG 落地踩坑实录:检索效果差的 5 个真实原因与解法
本文是 RAG 实战系列第 01 篇。系列导航:Agent 实战系列(已完结)→ DeepSeek Harness 实战系列(已完结)→ Agent 协议层系列(已完结)→ RAG 实战系列(更新中)。