ARTICLE · 1002935
扫描版 PDF 转 EPUB:一个脚本 + 云端 OCR,让整页图片变成可重排的电子书
扫描版 PDF 转 EPUB:一个脚本 + 云端 OCR,让整页图片变成可重排的电子书前言 扫描版 PDF 是阅读体验的灾难:整页是一张图,不能选中文字,字号放大脑袋得跟着歪,Kindle 上更是没法看。 OCR 能解决,但自己跑 OCR 模型要么吃显卡要么调参到天亮。pdf2epub-paddle 的思路很直接:识别这件事扔给百度飞桨的云端 API,本地只管编排——提交任务、盯进度、切章节、打包 EPUB。 整个项目就一个 Python 脚本,349 stars,MIT 协议。 GitHub:https://github.com/jarodise/pdf2epub-paddle 技术底座:PaddleOCR-VL 1.6 版面分析 API(OmniDocBench 96.3% SOTA,PP-DocLayoutV3) 依赖:Python 3.8+,一个 API Token,uv 管依赖 · · · 一、项目身份 一句话说清楚:> 用百度 PaddleOCR-VL 1.6 的云端 Jobs API,把扫描版 PDF 转成干净、可重排、带目录章节的 EPUB 电子书,本地一个脚本搞定。 它不是 OCR 引擎,是 OCR 云服务的编排层 + EPUB 打包器。识别的活全在云端,本地脚本干四件事:提交任务、轮询进度、和用户交互(确认元数据和目录)、组装 EPUB。 这个定位决定了它的气质:轻。没有本地模型、没有 GPU 要求、没有复杂依赖树,uv 一条命令跑起来。 二、主执行链路 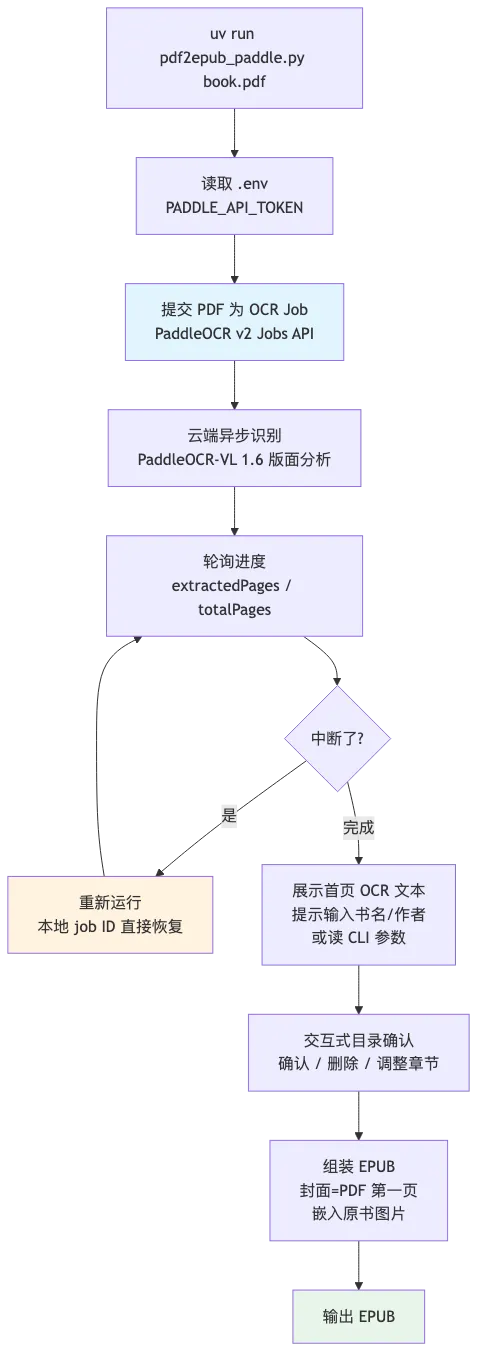
几个设计细节值得说: 异步 Job 而不是同步请求。整本书几十上百页,同步 API 会超时。Jobs API 天然支持多页,还带实时进度(extractedPages / totalPages),长任务不慌。 断点靠两个本地文件。job ID 和结果 JSON 都存本地,任务中断后重新跑一遍命令,直接续上。扫描一本书动辄几十分钟,这个兜底是刚需。 人在环里只出现两次。首页 OCR 文本展示出来让你确认书名作者(嫌麻烦就 三、核心模块与架构 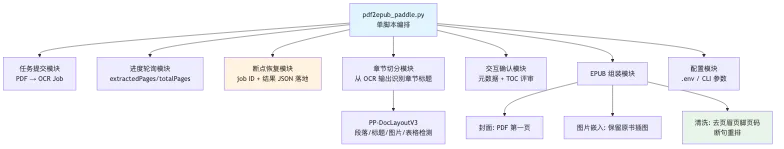
模块虽多,全在一个脚本里。真正的"重活"由两个外部能力承担: 版面分析靠 PP-DocLayoutV3。它不只是认字,还判断每块内容是什么——段落、标题、图片、表格分开处理。这是章节切分和干净输出的前提:知道哪行是标题才能切章节,知道哪行是页眉才能删掉。 清洗和重排是体验分水岭。去页眉页脚页码、把跨行断句重新接上——扫描书转出来的 EPUB 好不好读,八成看这一步。很多同类工具卡在"转出来了但没法读",就是没做重排。 四、跨端边界 本地端:Python 3.8+,无 GPU 要求,识别全在云端。macOS/Linux 原生支持,Windows 走 uv run 同样可用 云端:百度 AIStudio(飞桨星河社区)的 PaddleOCR Jobs API,模型固定为 PaddleOCR-VL-1.6,可用 全局命令:软链 输出端:标准 EPUB,Kindle / Apple Books / 微信读书等阅读器通用 边界很干净:本地只做编排和打包,算力和模型迭代都交给云端。 五、数据与状态流 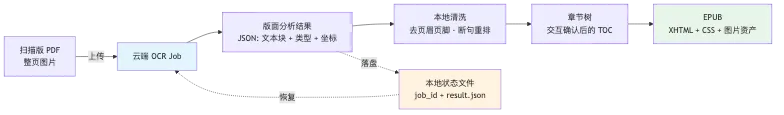
状态流的核心是结果 JSON 是唯一中间产物:云端识别一次,落盘一份,之后所有步骤(清洗、切章、打包)都从这份 JSON 出发。中断恢复、重新打包都不用再调 API——既省 token 也省时间。 六、配置边界 配置面极小,一个 配置项 方式 说明 API Token API 地址 模型 书名/作者 CLI 可选 输出路径 CLI 可选 目录策略 CLI 可选 没有配置文件体系、没有数据库、没有 daemon。 七、扩展点 说实话,这个项目的扩展点不多——单脚本、无插件体系。但有几个天然的生长方向: 模型切换: API 端点可换: 章节检测逻辑:章节识别基于 OCR 输出的标题检测结果,规则可改可调 CLI 参数即接口: 八、风险点 1. 云端依赖是硬依赖。识别全在百度云,AIStudio 服务变动、限流、停服,工具直接不可用。Token 也是门槛——没有国内手机号/实名,注册这一步就挡人2. 隐私边界要想清楚。整本书上传到第三方云服务识别。公有领域书籍无所谓,版权内容自己掂量3. 版权红线。扫描版 PDF 多半来自纸质书扫描,转 EPUB 自用可以,传播就是另一回事。工具中立,用法自负4. 章节检测不是万能。复杂排版(多栏、混排、无明确标题层级)的书,自动切章会出错——好在有交互确认兜底,但 · · · 记住 扫描版 PDF 转 EPUB 的难点从来不是 OCR 本身,而是识别之后的整理:切章节、去页眉、接断句、嵌图片。pdf2epub-paddle 的答案:识别扔给云端 PaddleOCR-VL 1.6,本地一个脚本只做编排——提交、盯进度、断点恢复、交互确认、打包。重活上云,轻活留本地。单文件工具的极致形态。 · · · 参考资源 GitHub:https://github.com/jarodise/pdf2epub-paddle 快速上手: License:MIT
--title--author 直接传),目录检测完让你过目一遍。其余全自动。PADDLE_MODEL 环境变量切换epub 脚本到 /usr/local/bin,任何目录下 epub book.pdf 直接用.env 加几个 CLI 参数:.env 必填PADDLE_API_TOKEN,从 AIStudio 个人面板复制.env 可选PADDLE_API_URL,默认官方 Jobs 端点.env 可选PADDLE_MODEL,默认 PaddleOCR-VL-1.6--title--author,不给就交互式问--output--auto-toc 跳过确认 / --no-toc 整本单章.env.example 复制改名填 token 就完事。PADDLE_MODEL 环境变量已留好口子,PaddleOCR 后续出新版可以平滑跟进PADDLE_API_URL 意味着自建 OCR 服务只要兼容 Jobs API 就能接--auto-toc / --no-toc / --output 这套参数,包一层就能进自动化流水线(比如网盘监控→自动转书)--auto-toc 模式下错了就错了5. 单脚本的维护风险。所有逻辑在一个 py 文件里,作者不更新就是终态。349 stars 的个人项目,别指望长期维护承诺 git clone https://github.com/jarodise/pdf2epub-paddle.git cd pdf2epub-paddle cp .env.example .env # 填入 PADDLE_API_TOKEN uv run pdf2epub_paddle.py /path/to/book.pdf