ARTICLE · 1002958
AI第一版不好用,先别自己重做:把这4类背景补给它
有一次,我让Codex帮我整理内容创作要用的表情包素材库。
第一轮,它按照“热门、亲切、不太冒犯”等方向,交付了45张图片。
数量够了,文件也整理好了。可我点开一张张看,很快发现:很多图放进我的公众号和小红书并不合适。
有些梗太泛,有些情绪和账号语气不搭,还有些图单独看挺有意思,真放进文章里却显得突兀。
从任务完成情况看,它确实交付了45张;从真实用途看,这批素材还进不了我的内容流程。
第一版不好用时,我以前很容易自己接过来
AI交回来的东西不合适,最省心的动作似乎是:算了,我自己挑。
可一旦自己接手,AI只完成了最前面的搜索,后面的判断、筛选和分类仍然全部回到我手里。下一次做类似任务,它还是不知道什么样的素材适合我。
这次我没有立刻换成手工整理。
我先回头看第一版为什么不合适。问题并不在图片数量,也不只是搜索能力,而是它只拿到了“热门、亲切”这类通用要求,不知道这些图片最后要进入哪一个账号、给谁看、用什么语气表达。
AI完成的是一份通用素材清单,我需要的是能进入具体内容场景的素材库。
我补了4类背景,让它按业务重新筛选
我随后提供了4个账号的资料,让Codex重新理解每个账号的使用场景。
对外公开时,我不会展示这些账号资料的具体内容,但可以把需要补充的背景归成4类:
- 账号定位
:这个账号长期讲什么,想建立什么认知 - 目标受众
:主要是谁在看,他们熟悉什么、在意什么 - 表达语气
:整体偏专业、亲切、克制,还是更轻松 - 内容禁区
:哪些粗口、攻击性、关系梗或过度摆烂的表达不能用。
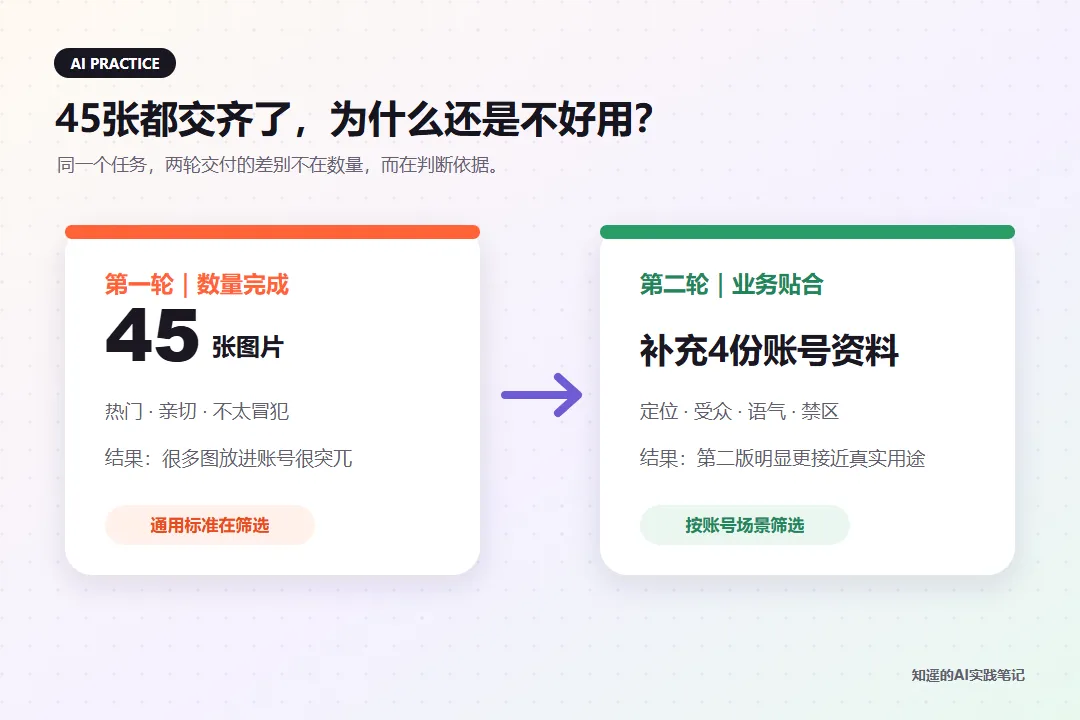
图1:第一轮完成了数量,第二轮才开始围绕真实账号筛选。
这些背景补进去后,筛选标准发生了变化。
它不再只判断一张图是不是热门、是不是好笑,还要判断:这张图放进某类文章是否自然,会不会破坏账号气质,目标读者能不能看懂,有没有踩到内容禁区。
第二轮完成后,我的明确评价是:比第一版的45张好多了。
这是我对素材贴合度的主观判断,不代表这些图片已经提高了阅读量、互动或转化。但至少,它们开始更接近“我可以拿来用”的状态。
返工不能只说“还是不对”,要指出差在哪
很多时候,我们给AI的反馈只有一句:
这句话表达了不满意,却没有提供新的执行依据。AI只能继续猜,第二版很可能只是换一种方式重复第一版。
我现在会先把问题分开:
是数量不够,还是质量不合适 是风格偏了,还是使用场景不对 是受众看不懂,还是内容踩了禁区 是AI没有按要求做,还是我根本没提供足够背景。
问题分清后,只补和这次返工有关的资料,不需要一次把整个知识库都丢进去。
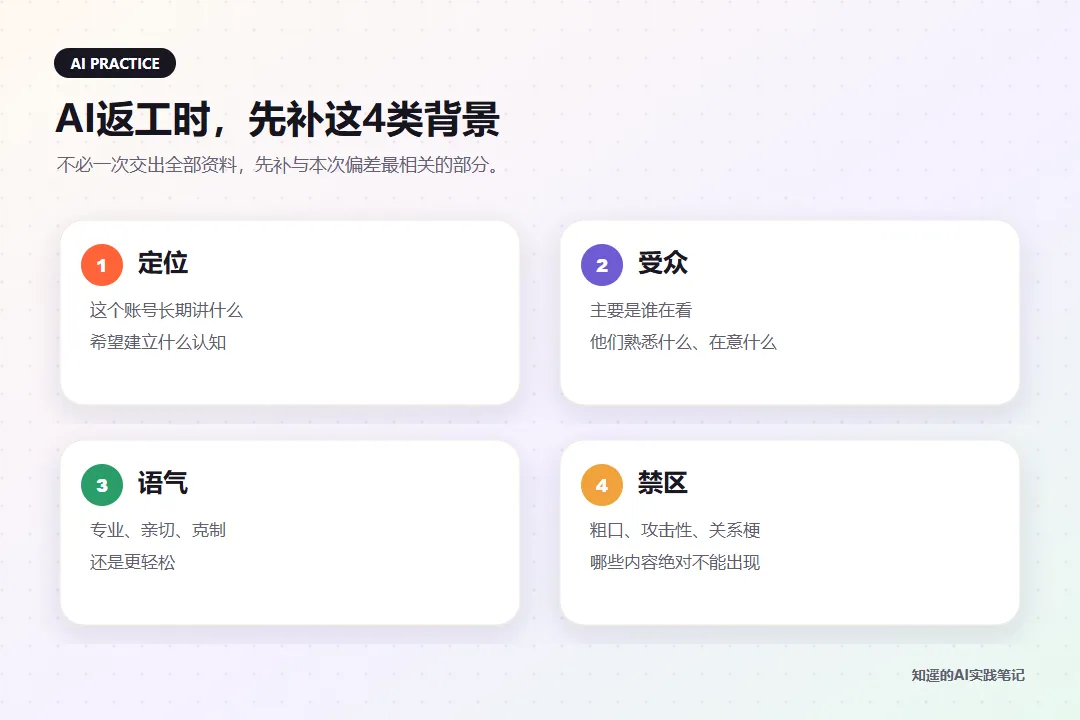
图2:定位、受众、语气和禁区,帮助AI从通用结果走向具体业务。
正面案例和反例,比堆很多形容词更有用
除了账号背景,我还会补两类东西。
一类是接近目标的正面案例,告诉AI哪些图片、表达或处理方式更符合方向。
另一类是不适合的反例,并说明排除原因。比如把“不要低俗”继续拆开,指出粗口、攻击性、关系梗或过度摆烂会和账号定位发生什么冲突。
案例让边界有了参照,AI后续的搜索和筛选也更容易检查。
AI返工以后,人仍然要再验收一次
补充背景不会让第二版自动变成正确答案。
AI负责按新资料重新执行,人仍然要逐项确认:这批结果是否符合真实用途,放进内容里是否自然,有没有遗漏禁区,分类和使用时机是否合理。
如果第二版仍然不合适,就继续记录返工原因。几轮真实任务下来,这些原因会慢慢变成一份稳定的业务说明和验收清单。
下次再遇到AI第一版不好用,可以先别急着自己重做。
先回答四个问题:
这份结果给谁使用?
需要什么表达语气?
哪些内容绝对不能出现?
把最缺的背景补进去,再让AI重新执行一次。
你最近哪一份AI结果,是“看起来完成了,实际却用不上”?