ARTICLE · 1004007
APatch 源码笔记(三):没有 ioctl、没有 netlink——supercall 通信机制解剖
本文基于双仓库交叉核实:APatchmain@6ec140e + KernelPatchtag 0.13.8(HEAD bcc8498)。所有结论附 仓库:文件:行号。
01 这一篇我们要解决什么问题?
上一篇结尾,apd 发出了它的第一次"刷脸":sc_su(key, &profile)。这个函数只有一行核心——libc::syscall(45, ...)——但它身后站着整个 APatch 与内核的全部对话。
学过 Linux 的人第一次听说"用户态和内核态的内核模块通信",脑子里蹦出来的通常是:ioctl?netlink socket?procfs/sysfs 文件?APatch 全都没有。KernelPatch 的选择是"征用"一个现有的系统调用——45 号,也就是 arm64 上 truncate 的编号。这期我们把它解剖开,回答四个具体问题:
1. syscall 45 是怎么被"劫走"的?劫持之后,普通程序的 truncate 还能用吗? 2. 用户态发出的参数(密钥、命令、数据)是怎么编码的?内核怎么解析? 3. 内核怎么决定"谁有资格说话"?说错密码会怎样? 4. 内核处理的结果和错误是怎么回到用户态的?
把这张图看懂,后面 Root 提权(第 5 篇)、授权同步(第 6 篇)、KPM 加载(第 17 篇)就全是在这张图上走不同的路了。
02 为什么从这里开始?
因为这是整个系统的"通信地基"。回顾一下我们目前已经见过的 supercall 使用点:apd 自证身份(privilege_apd_profile)、上报 su 路径(init_load_su_path)、授权全量同步(refresh_ap_package_list)、查 safe mode(is_safe_mode 的一半)——这些全都汇往同一个入口。管理器 App 也是:JNI 层的 Natives.grantSu() 等函数最终同样是 syscall 45(第 15 篇细讲)。搞懂这一篇,等于拿到了后面每一篇的门票。
03 背景:为什么不用 ioctl / netlink / procfs?
先三十秒复习系统调用:用户态程序把 syscall 号放进 x8 寄存器、参数放进 x0~x5,执行 svc 指令陷入内核;内核按号分派,返回值放在 x0,负数表示 -errno。syscall(2) 这个 C 包装就是干这个的。
再看传统机制为什么都不合适。ioctl 需要一个字符设备文件——你得先在内核里注册设备、在 /dev 下造出文件,用户态才能 open 它。netlink 需要注册一个协议号。procfs/sysfs 需要挂载文件。而 KernelPatch 的形态是什么?它不是可加载模块(那条路叫 KPM 和 lkm,后面专讲),kpimg 是直接嵌进内核镜像的补丁——它跟着内核一起被 boot 加载,没有机会在设备模型里注册任何东西。
但它拥有一样更本质的能力:hook 一切。patch 内核的人当然可以改写任意函数。于是设计选择变得自然:与其造一个新设备,不如征用一个现成的系统调用入口(作者推测,源码未给理由)。
征用谁?源码明确行为:45 号,arm64 通用编号里的 __NR3264_truncate。scdefs.h:20-21 留了一行有趣的注释考古:
// #define __NR_supercall __NR3264_truncate // 45#define __NR_supercall 45为什么挑 truncate?源码没写,我只能给推测:它冷门(普通 App 极少直接调)、参数少(真实 truncate 只用 x0 路径和 x1 长度,x2~x5 寄存器是空着的,正好塞进 4 个附加参数)、而且误伤可以归零——这一点是源码明确保证的,第 07 节见。
04 源码入口:两份客户端、一份契约、一个内核
supercall 的用户态客户端有两份,内核处理端一份,中间靠一份头文件对齐:
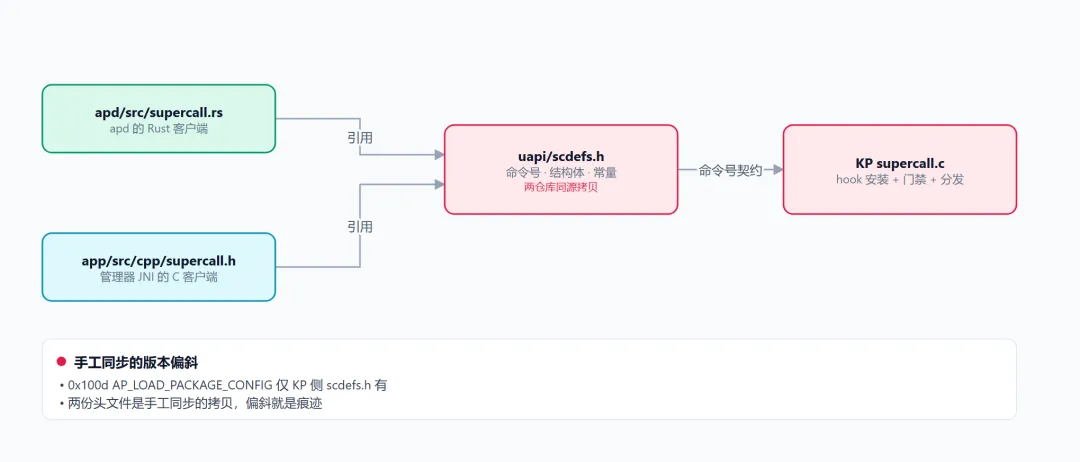
先看契约头文件。它就是一张命令号地图(scdefs.h:23-113),布局工整得像一张表格:
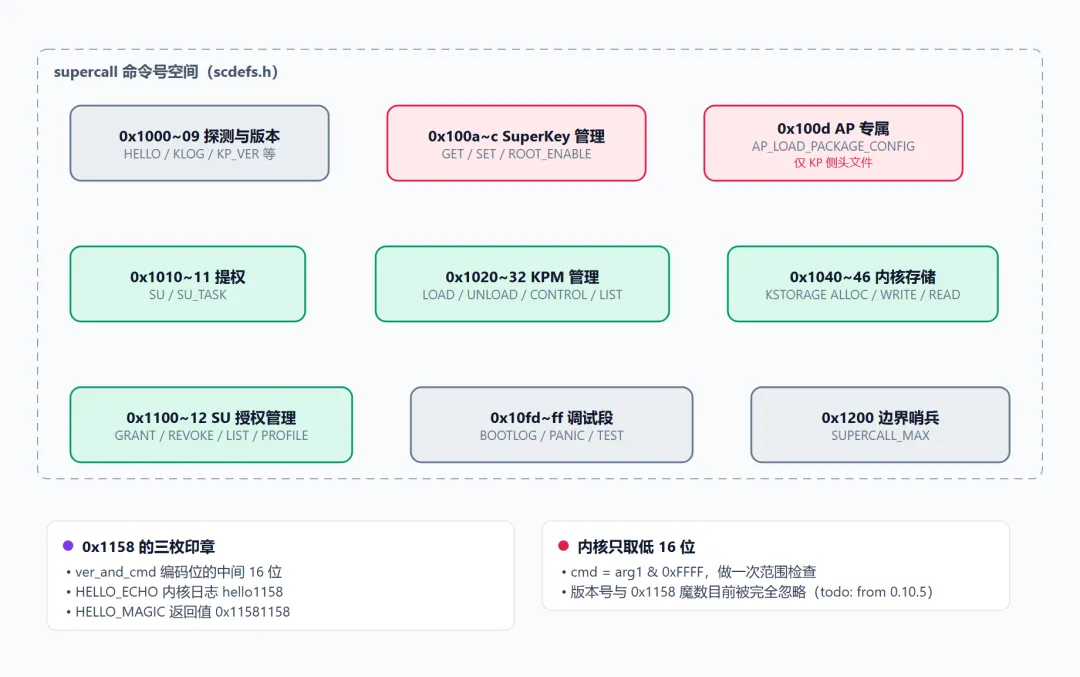
顺带一个双仓库对读才可见的彩蛋:SUPERCALL_AP_LOAD_PACKAGE_CONFIG 0x100d 只存在于 KP 侧的 kernel/patch/include/uapi/scdefs.h:36,APatch 仓库里的那份拷贝没有这条——内核比用户态头文件多了一条命令。两边头文件是手工同步的拷贝关系,这种轻微的版本偏斜就是手工同步的痕迹。
05 核心数据结构:一次调用都带了什么
ver_and_cmd:把版本、暗号、命令塞进一个 64 位整数
第一个参数是密钥字符串指针,第二个参数是一条精心编码的命令。编码函数 Rust 和 C 各有一份,逐字相同(APatch:apd/src/supercall.rs:39-44 / APatch:supercall.h:17-22):
fn ver_and_cmd(cmd: c_long) -> c_long { let version_code: u32 = ((KP_MAJOR << 16) + (KP_MINOR << 8) + KP_PATCH) .try_into() .unwrap(); ((version_code as c_long) << 32) | (0x1158 << 16) | (cmd & 0xFFFF)}64 位整数被切成三段:高 32 位是 KernelPatch 版本号(0.13.8 → 0x0D08),中间 16 位是魔数 0x1158,低 16 位是命令号。也就是说,一次调用在 x0 放密钥指针、x1 放这个大整数、x2~x5 放最多 4 个业务参数——加起来正好 6 个寄存器,这就是第 03 节说"参数少"的真正含义。
那 0x1158 是干嘛的?先卖个关子,第 07 节内核代码里见分晓——剧透版:内核根本不看它。
SuProfile:一张 104 字节的提权名片
#[repr(C)] // supercall.rs:32-37struct SuProfile { uid: i32, to_uid: i32, scontext: [u8; SUPERCALL_SCONTEXT_LEN], // 0x60 = 96 字节}C 侧在 scdefs.h:71-76 有逐字节相同的定义。#[repr(C)] 保证 Rust 按 C 布局排布——跨语言传递结构的铁律。scontext 是 SELinux 上下文字符串(如 u:r:magisk:s0),96 字节定长、零填充;填充函数 convert_string_to_u8_array(supercall.rs:190-196)还做了一次 min 截断防溢出。
有意思的是这个结构体在不同命令里的字段语义漂移——同一个 uid 字段:
uid | ||
|---|---|---|
SUPERCALL_SU 0x1010 | call_suKP:supercall.c:135-143) | 被忽略 |
SUPERCALL_SU_TASK 0x1011 | call_su_task:145-153) | |
SUPERCALL_SU_GRANT_UID 0x1100 | call_grant_uid:179-186) | 授权记录的主键su_add_allow_uid(profile->uid, ...)) |
一份结构、三种用法——读协议代码时一定要对照内核的消费端,别被字段名骗了。
06 内核侧第一层:45 号是怎么被劫走的
一切从开机最早期的一次安装开始(KP:kernel/patch/common/supercall.c:437-449):
int supercall_install(){ int rc = 0; hook_err_t err = hook_syscalln(__NR_supercall, 6, before, 0, 0); if (err) { log_boot("install supercall hook error: %d\n", err); ...一句话:给 45 号系统调用挂一个名叫 before 的前置钩子,声明要观察 6 个参数。安装发生在 rest_init 之前的开机阶段(KP:patch.c:85)——比 init、比任何用户态程序都早。
hook_syscalln 内部(KP:kernel/patch/common/syscall.c:320-325)有两套手段,按条件降级:
hook_err_t hook_syscalln(int nr, int narg, void *before, void *after, void *udata){ if (sys_call_table) return fp_wrap_syscalln(nr, narg, 0, before, after, udata); return inline_wrap_syscalln(nr, narg, 0, before, after, udata);}• 首选(fp_wrap):通过 kallsyms_lookup_name("sys_call_table")找到系统调用表(syscall.c:360),把表里 45 号槽位的函数指针替换成带钩子的包装函数。这是最"文明"的方式:所有 syscall 都要查这张表,改表即改全局。• 降级(inline_wrap):找不到表时(内核加固、符号被抹),退而对 __arm64_sys_truncate这个函数符号本身做 inline hook——直接改写函数开头几条指令跳进钩子。
注意一个重要的定性:这不是"注册一个新系统调用",而是"给一个旧系统调用装门铃"。系统调用总量没变,45 号的正规职责没有被注销。
07 内核侧第二层:before()——门禁、解码、分派
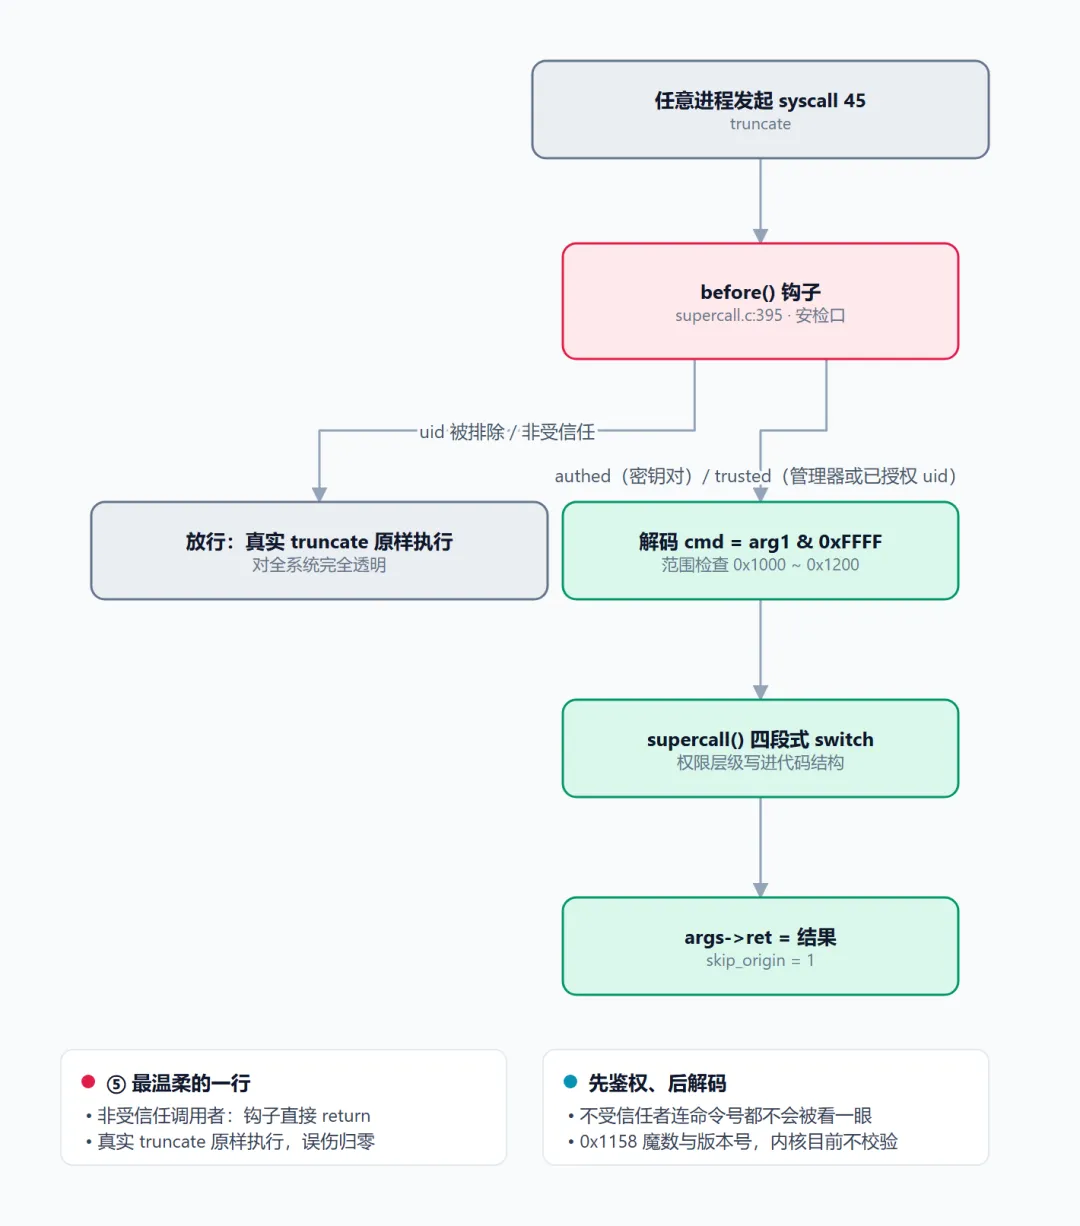
这个函数(KP:supercall.c:395-435)是整个 supercall 的安检口,值得逐段精读。第一段,门禁:
static void before(hook_fargs6_t *args, void *udata){ int uid = current_uid(); if (get_ap_mod_exclude(uid)) return; // ① 被显式排除的 uid:直接放行真 truncate int is_trusted_caller = 0; int is_authed = 0; if (has_preset_superkey()) { const char *__user key_user = (const char *__user)syscall_argn(args, 0); char key[MAX_KEY_LEN]; long len = compat_strncpy_from_user(key, key_user, MAX_KEY_LEN); if (len <= 0) return; is_authed = !auth_superkey(key); // ② 密钥对 → authed is_trusted_caller = is_authed; } if (is_trusted_manager_uid(uid)) { // ③ 受信任管理器(APK 签名验证):authed + trusted is_trusted_caller = 1; is_authed = 1; } else if (is_su_allow_uid(uid)) { // ④ 已授权 uid(含默认的 0/2000):仅 trusted is_trusted_caller = 1; } if (!is_trusted_caller) return; // ⑤ 四类都不是:放行真 truncate这 20 行是一个完整的安全模型,值得逐条念:
• 四条通道,两个等级。 trusted(有资格说话)和authed(说了算的密钥持有者)是两个独立布尔量。密钥对 → 两者都是;受信任管理器(内核验过 APK 签名的通道,判定在supercall.c:411,签名验证逻辑在KP:userd.c:352+)→ 两者都是;已授权 uid → 只有 trusted;被排除名单里的 uid → 连门都不进。• ⑤ 是整个设计最温柔的一行:不是受信任调用者?钩子什么都不做、直接 return——真实的 truncate 原样执行。被劫持的系统调用对全系统其余部分完全透明,这就是第 03 节"误伤归零"的来源。KernelPatch 的 lkm README 对这套机制的描述也是同一句话:"hooks syscall 45 (truncate) as the KP supercall channel"(KP:lkm/README.md:16)。• 注意顺序:先鉴权、后解码。不受信任的调用者连自己的命令号都不会被看一眼。
第二段,解码与分派(:420-434):
long ver_xx_cmd = (long)syscall_argn(args, 1); long cmd = ver_xx_cmd & 0xFFFF; if (cmd < SUPERCALL_HELLO || cmd > SUPERCALL_MAX) return; // todo: from 0.10.5 // uint32_t ver = (ver_xx_cmd & 0xFFFFFFFF00000000ul) >> 32; // long xx = (ver_xx_cmd & 0xFFFF0000) >> 16; long a1 = (long)syscall_argn(args, 2); ... args->skip_origin = 1; args->ret = supercall(is_authed, cmd, a1, a2, a3, a4);}谜底揭晓:0x1158 魔数和版本号,内核压根不校验——只取低 16 位当命令号,做一次范围检查(0x1000~0x1200),那两行被注释掉的解析代码带着一个 todo: from 0.10.5,明明白白地写着"将来要做"。这是一个非常诚实的细节:协议头里预留了版本协商字段,内核侧还没兑现。我上一篇文章说"内核不校验 magic",出处就是这里。
最后两行是钩子框架的返回协议:skip_origin = 1 表示"真的 truncate 不用执行了",ret 里放返回值。这个结构在 KP:kernel/include/hook.h:99-111 里定义得清清楚楚——hook_fargs6_t 开头就是 chain / skip_origin / local / ret 四件套,后面跟着柔性数组装参数。syscall_argn(args, n) 取的就是这块柔性数组里的第 n 个寄存器值。
08 内核侧第三层:supercall() 的四段式 switch
真正的业务分发在 supercall()(KP:supercall.c:275-385)。它不是一张函数表,而是一串顺序执行的 switch,用层级表达权限——这个结构本身就是权限文档:
static long supercall(int is_authed, long cmd, long arg1, ..., long arg4){ switch (cmd) { // 第一段:任何受信任者可用 case SUPERCALL_HELLO: logki(SUPERCALL_HELLO_ECHO "\n"); // 打一句 "hello1158" return SUPERCALL_HELLO_MAGIC; // 返回 0x11581158 case SUPERCALL_KLOG: ... case SUPERCALL_KERNELPATCH_VER: return kpver; ... case SUPERCALL_AP_LOAD_PACKAGE_CONFIG: ... // 0x100d,内核自读授权文件 } switch (cmd) { // 第二段:受信任者可用的敏感段 case SUPERCALL_SU: return call_su(...); case SUPERCALL_SU_TASK: return call_su_task(...); case SUPERCALL_SU_GRANT_UID: return call_grant_uid(...); ... } ... // BOOTLOG/PANIC/TEST 段 if (!is_authed) return -EPERM; // ← 分水岭(supercall.c:352) switch (cmd) { case SUPERCALL_SKEY_GET: ... } // 第三段:密钥持有者专属 switch (cmd) { case SUPERCALL_KPM_LOAD: ... } // 第四段:KPM 管理 ... return -ENOSYS; // 兜底}这一段给出三个重要结论:
结论一:SuperKey 真正守护的东西比想象中少。 看仔细:SU、SU_GRANT_UID、KSTORAGE 这些敏感命令都在分水岭之前——一个已授权 uid 的进程,就算拿错密钥,照样能提权、能授权别人。密钥真正把守的是两件事:无特权普通 App 的准入(不对、不 trusted,连门都进不去)和分水岭之后的 SKEY/KPM 管理命令。这个认知对理解第 7 篇"新默认签名授权为什么够用"至关重要:签名验过的管理器走 trusted_manager_uid 通道(③),密钥可有可无。
结论二:HELLO 是探针。SUPERCALL_HELLO 返回 SUPERCALL_HELLO_MAGIC 0x11581158(scdefs.h:117),顺便在内核日志里打一句 "hello1158"(scdefs.h:18)。C 客户端里它被包装成:
static inline bool sc_ready(const char *key) // APatch:supercall.h:46-49{ return sc_hello(key) == SUPERCALL_HELLO_MAGIC;}"内核补丁在不在?"——问一句 HELLO 就知道。0x1158 这个魔数前后出现三次(编码位、HELLO 回声、HELLO 返回值),像作者盖在同一样东西上的三个章。
结论三:错误就是标准 errno。 每个 call_* 的返回值一路穿透到 args->ret,再变成 syscall 的返回值。内核端用满了 C 语言的错误词汇表:-EPERM(没过分水岭)、-ENOSYS(查无此命令)、-ENOMEM/-ENOBUFS(拷贝缓冲不够)、-E2BIG(密钥超长)、-EFAULT(用户指针非法)、-EEXIST(KPM 重名)……用户态拿到的和调普通 syscall 没有任何区别。
09 数据流:一次 sc_su_grant_uid 的完整旅程
把第 1 篇见过的授权同步场景走一遍全程,作为本篇的收束(每一步都已在源码核实):
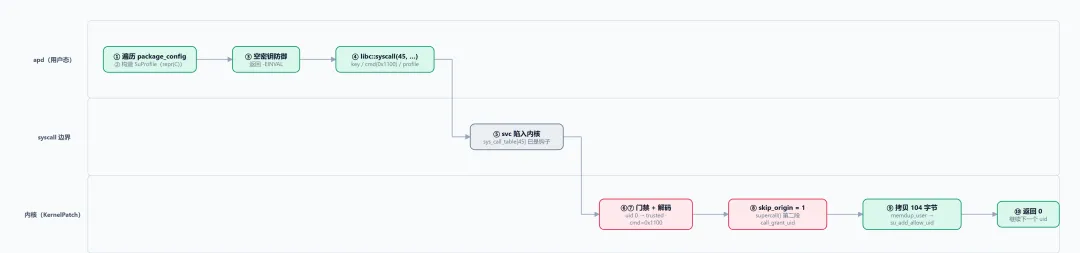
十步里前四步在用户态、中间一步在边界、后五步在内核——没有一次上下文切换以外的开销,没有一处协议解析以外的魔法。这就是"征用 syscall"路线的效率底气。
10 常见误区
1. "内核新增了一个系统调用"——没有。45 号槽位被装了门铃,调用总量没变;README 说 "adds a new system call"( APatch:docs/en/faq.md)是从"给用户态提供了新能力"的角度说的,机制上是 hook。2. "0x1158 魔数用于内核鉴权"——不是。内核只取低 16 位,版本和魔数目前被完全忽略( supercall.c:424-426的 todo 注释)。3. "没密钥就不能用 supercall"——不准确。已授权 uid 和受信任管理器不需要密钥就能用第二段全部命令;密钥卡的是普通 App 的准入和 SKEY/KPM 管理段。 4. "hook 了 truncate 会影响系统正常截断文件"——只有受信任调用者的 truncate 被拦截;其余一律原样放行( before()的return路径)。
11 本篇源码地图
APatch:apd/src/supercall.rs | sc_* 函数 + ver_and_cmd 编码 + 空密钥防御 |
APatch:app/src/main/cpp/supercall.h | sc_hello/sc_ready…,管理器 JNI 用) |
APatch:app/src/main/cpp/uapi/scdefs.h | su_profile、0x11581158 |
KP:kernel/patch/common/supercall.c | supercall_installbefore()(门禁解码)、supercall()(四段式分发)、全部 call_* |
KP:kernel/patch/common/syscall.c | hook_syscalln |
KP:kernel/include/hook.h | hook_fargs6_tskip_origin/ret/参数柔性数组 |
KP:kernel/patch/include/uapi/scdefs.h | 0x100d) |
12 总结与思考题
这一篇我们打通了 APatch 的"通信地基":45 号 syscall 被装上门铃而非改行换业;未授权者面前它是真 truncate,受信任者面前它是 supercall 安检口;before() 用"trusted / authed"两个布尔量搭出四级门禁,supercall() 用四段式 switch 把权限层级写进代码结构本身;SuperKey 真正把守的是普通 App 的准入和 SKEY/KPM 管理段——而不是全部。
三道思考题,前提均已核实:
1. before()把"非受信任者直接放行"(:418)放在了解码命令之前——如果顺序反过来(先解码再鉴权),功能上没有区别,但会多付出什么、又可能引入什么风险?(提示:想想第 05 节那 20 行的执行频率。)2. scdefs.h:51/56定义了SUPERCALL_KSTORAGE_ALLOC_GROUP和REMOVE_GROUP,但内核的 switch 里没有对应的 case——调用它们会返回什么?结合scdefs.h:59-62的四个组常量想想为什么可以不实现。3. 管理器用 sc_ready()(HELLO == 0x11581158)探测"内核补丁在不在"。一个 uid 10xxx 的普通未授权 App 发同样的 HELLO 调用,会得到 0x11581158 吗?由此推断:这个探测必须以什么身份执行才可靠?(提示:回看before()的 ⑤ 号放行路径,以及真 truncate 拿到一个字符串指针当路径会发生什么。)
下一篇我们把时间倒回开机第 0 秒:《APatch 源码笔记(四):boot.img 是怎么被改的——kptools 注入与 kpimg 的开机自举》。kpimg 这块"内核补丁镜像"是怎么被 kptools 塞进 boot.img 的?它开机后怎么在符号被抹、地址随机的内核里找到 sys_call_table?以及第 06 节那个 supercall_install 到底排在开机时间线的第几秒?我们将进入 KernelPatch 的 tools/ 和 patch.c——这个系列里最接近"内核手术"的一篇。