ARTICLE · 1004012
128k 的文档丢给模型,它记不住怎么办:Prime Agent 的答案是给它一间书房
先说个每个做过长文档处理的人都遇到过的事。
你有一份 128k token 的材料——可能是几百页的日志、一整个代码仓库的文档、一年的会议记录。你要模型基于它回答问题。
现在的模型窗口都够大,塞得进去。但塞进去之后你会发现一个很难受的现象:它读了,但它用不好。问它某个细节,它答得含含糊糊;让它统计一下某类事件出现了多少次,它给你一个明显是猜的数;你追问一句,它前后说法还不一致。
这不是模型笨。这是注意力在超长序列上被稀释了——关键信息淹在几十万字里,它捞不出来。
Prime Agent 对这个问题的答案,我觉得是整个项目里最容易被普通人理解、也最容易被低估的一个:别让它背,让它查。
这一篇讲清楚这个方案长什么样、好在哪、代价是什么。
一张图看懂差别
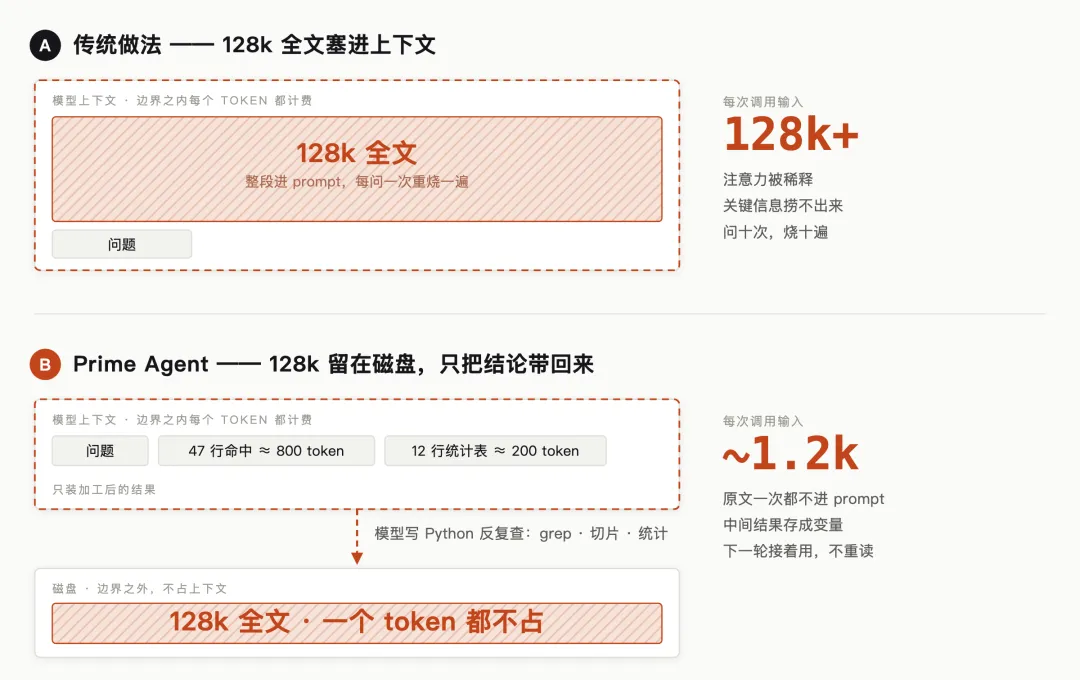
两条路线的差别:128k 全文在上下文边界的里侧还是外侧。左边那个数字是每次调用真正要付钱的输入量
论文 3.2 节把这个转变说得很准:
This changes long-context reasoning from passive attention over a fixed sequence into a programmatic information-management problem.
把长上下文推理,从"对一段固定序列的被动注意力",变成"程序化的信息管理问题"。
一个更土的比方
我给不搞技术的朋友讲这事儿的时候用这个比方,屡试不爽:
关键在最后两行。
"记不住怎么办"——传统做法没有退路。信息一旦进了 prompt 又没被注意到,就等于没有。你唯一的补救是把 prompt 重发一遍,然后祈祷这次它看见了。
书房模式下,"记不住"根本不是个问题。因为它从来就没打算记住,它只是知道东西在哪、怎么去拿。
这个心态差别,比技术实现重要得多。
那间"书房"具体是什么
三样东西:一个文件、一个常驻的 Python 环境、一套教模型怎么用的说明书。
第一样,文件。评测的时候,128k 的正文被直接写进一个可读文件,比如 /tmp/context_810080000.txt。任务提示里只告诉模型两件事:文件在哪,要回答什么问题。正文一个 token 都不进 prompt。
日常使用的时候也一样。启动时框架会从当前目录一级级往上找 AGENTS.md 和 CLAUDE.md,把项目约定注进系统提示;剩下的资料,你放文件里就行。
第二样,一个常驻的 IPython 内核。这是"书房"的本体,下一节细讲。
第三样,说明书。框架在系统提示词里塞了一大段,专门教模型怎么用这间书房。这段我后面会引,它比你想的重要——给了工具不教用法,模型是不会用的。
一次交互,实际发生了什么
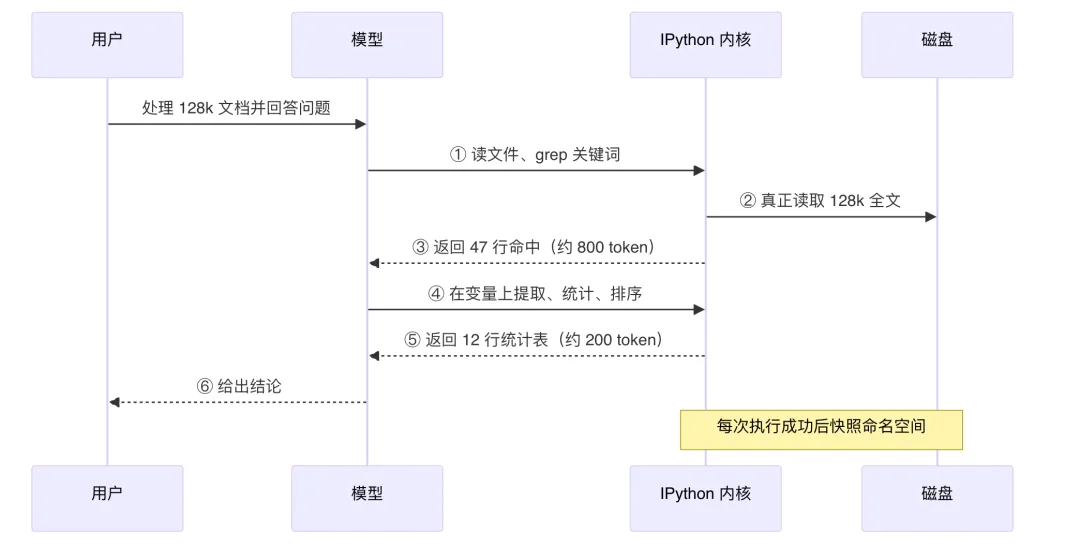
这张图是我认为最能说明问题的一张。假设你让它处理那份 128k 文档:
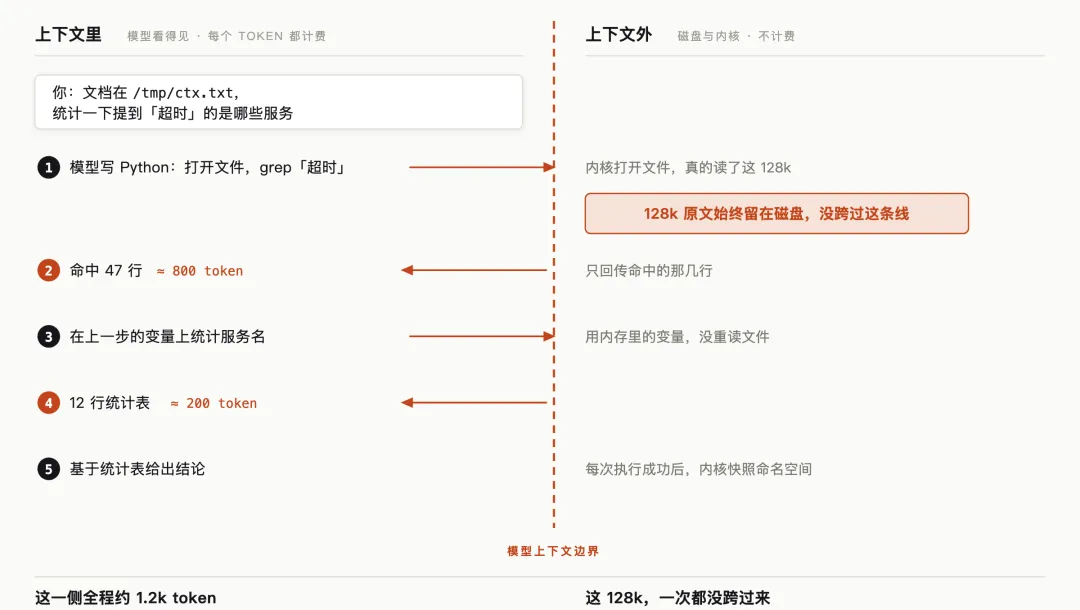
一次交互实际发生了什么。橙色虚线是模型上下文边界,跨过来的只有几百 token 的加工结果,128k 原文从头到尾在线的右边
盯着第 ③ 步和第 ⑤ 步看。
回到模型上下文里的,只有工具的输出——命中的 47 行、统计出来的 12 行表。那 128k 原文,从头到尾没进过上下文。
上下文占用从 128k 以上,降到一千出头。
而且注意第 ④ 步:它是在第 ① 步产生的变量上接着算的,不是重新读一遍文件。这就是"常驻"的意义。
为什么必须是"常驻"的
这是 Prime Agent 和其他框架最本质的差别,值得单独说。
Claude Code 也能跑代码,Codex 也能跑。区别在于——跑完之后,状态还在不在。
Claude Code 的 Bash 工具,每次调用起一个新进程。你这条命令 cd /tmp,下一条还在原来的目录。上一步算出来的中间结果,想让下一步用上,只有两条路:写文件,或者让它出现在工具输出里、再进模型上下文。
Prime Agent 那个 IPython 内核,是一个活着的 Python 进程,从会话开始一直活到会话结束:
hits = [line for line in open('/tmp/ctx.txt') if '超时' in line] # 第 3 轮services = extract_services(hits) # 第 17 轮,hits 还在隔了十四轮,中间还触发过一次上下文压缩,hits 照样能用。
框架在系统提示词里对这件事的说法是(源码 core/prompts/rlm.ts):
IPython is the agent's long-lived notebook: a persistent control environment for reasoning, context management, state, tool orchestration, and recursive subcalls.
长期笔记本。这个词选得好。它想建立的心智模型是"工作台",不是"一次性的终端"。
底下这套是怎么兜住的:
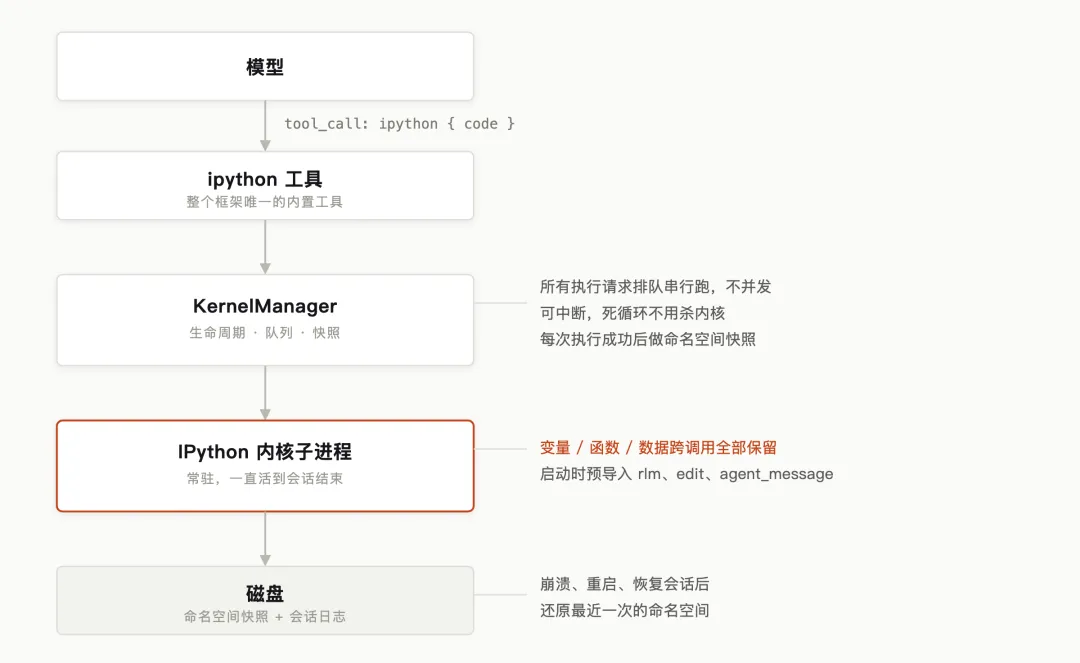
内核这一层怎么兜住:串行队列防止写坏共享状态,快照让崩溃和重启之后还能捞回命名空间
那个快照机制是长任务的命门。源码注释写得很直白:干完活就存一次盘,这样后面恢复会话、或者优雅关闭之前崩了,能捞回最近的命名空间。
跑七天的任务,中间崩一次,内核状态要是全没了,前面基本白干。
说明书这一环,比想象中关键
给了工作台不等于模型会用。系统提示词里那一大段是配套的,我挑几条讲讲它在教什么。
教它这是个笔记本,不是终端。"把中间变量留下来"、"写点小辅助函数"、"检查和转换输出"——这些话是在建立习惯。
教它工具调用就是普通代码。这句我觉得是整段里最重要的:
Tool calls are themselves Python
awaitexpressions, so their return values can be bound to variables and composed into program logic just like any other call.
工具调用本身就是 Python 的 await 表达式,返回值能绑到变量上,能像普通函数一样组合进程序逻辑。
在别的框架里,工具调用是协议层的事——模型吐个 JSON,框架解析、执行、把结果塞回上下文。在这儿,工具调用就是代码里的一行,你可以写 results = [await f(x) for x in items],可以 try/except,可以塞进列表推导。
教它大文件放磁盘。压缩时会清理掉序列化后超过 16 MiB 的单个变量,所以大块源数据该落盘落盘,需要时重新加载。这条是在逼模型养成好习惯。
教它别在自己的环境里假装干活。这条我要单独夸:
Do not assume IPython is the native runtime of the external thing being investigated.
别假设 IPython 是你正在调查的那个东西的原生运行环境。仓库、服务、数据集、API,人家有自己的环境和正常入口,你该走人家的入口,IPython 只负责协调过程、分析回来的东西。
配套还有一条:不许为了让某个项目能 import 就往内核里装依赖。
这条堵的是模型一个特别顽固的坏毛病:让它跑项目测试,import 失败了,它第一反应是 pip install,装到自己内核里,装完 import 成功,它就觉得搞定了——可项目本身的环境依然是坏的。
我们自己那套框架吃过这个亏。agent 报告"测试全过了",实际上它是在自己造的临时环境里跑的,项目真实的 venv 里少三个包。交付前一晚发现的,后怕。
框架层面把这条写死,等于替你挡住了一整类假成功。这是我认为这段说明书里最值钱的一句。
好处,用数字说
讲完机制说收益。三个层面。
第一层,token 账。
同一个 128k 的问答任务:
塞 prompt: 每问一次,输入 128k+ ← 问十次,烧十遍落盘 + 查: 首次几百,后续每次几百到几千 ← 原文一次都不进上下文论文在 PMPP-Hard 那一组里提了一句,我觉得比分数更实在:同样的成绩,Prime Agent 的 token 消耗明显更低,逐 token 比它是占优的。省钱这事儿比涨分实在。
**第二层,模型行为真的变了。**这是我觉得最有意思的部分。
论文 3.3 节测 nanoGPT 速通,发现在 Prime Agent 里跑的模型,会自发地做一些任务没要求它做的事:
• DeepSeek V4 Pro 每次训练运行创建的"循环外实验",大约是在 Claude Code 下的 6 倍——先在合成梯度上模拟一遍候选优化器,先把更新规则的系数数值优化一遍,然后才去启动真正的训练。 • Kimi K3 自己定义了一个探针函数,通过它跑了大约 90 次筛选实验和全部 19 项有效记录。同一个模型在自家 CLI 上,全程直接编辑文件,没有构建任何这类机制。 • 附录里还提到 Kimi K3 用全局优化器重新推导了 Newton–Schulz 迭代系数,还逐位检查了 bf16 舍入;GLM 5.3 则是在碰 GPU 之前先在 CPU 上把 SOAP 实现调通了。
同一个模型,给它一张工作台,它开始搭工具;只给一支笔,它就只会写字。
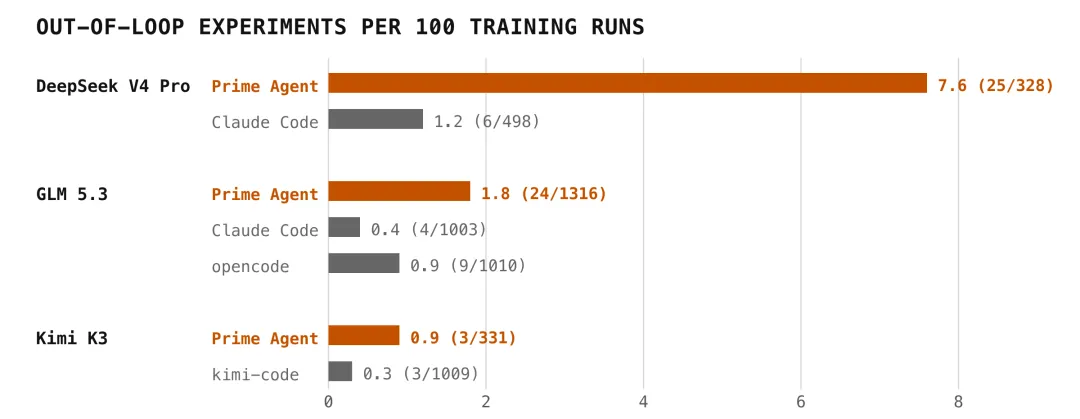
论文图 6:不同框架下的「循环外实验」数量,按每个智能体实际执行的训练运行次数归一化。标签是「实验数/训练运行数」|图片来自论文 arXiv:2608.23552
论文对 DeepSeek 那个 6 倍的猜测很实在:DeepSeek 自家的 agent 框架就提供了类似的代码执行模式,所以 REPL 对它来说是"训练时见过的工作流"。
第三层,分数。OOLONG(Yahoo,128k)这一行:
| 0.700 | |||
| 0.920 | |||
| 0.940 |
我得说句实话:这组数字没有前两层有说服力。
第一行赢 67%,但对照组是裸 API,等于拿"有书房"比"只有桌子",赢了不奇怪。后两行才是同量级对手,结果一负一胜,差距都在几个点以内——Opus 5 在 Claude Code 上反而更高。
框架和模型是有匹配效应的,谁围着谁训练的,谁在主场就更顺手。这一点我在第一篇展开过。
还有个坑,做评测的要注意:**这两种测法的分数不能混比。**Prime 那一列跑的是"写文件 + REPL 查",跟官方 OOLONG 协议报的分数不是一回事。你拿裸 API 跑一遍,那对标的是 Pi-mono 那一列。混着比就成笑话了。
三个真会踩的坑
用起来会碰到的,我压缩成一段说完,赶时间可以跳过这节。
%%bash 必须是代码单元的第一行,前面不能有注释、空行、import、任何 Python 语句。这是 IPython 的硬规矩。写进提示词说明模型经常犯。
%%bash 的 shell 状态不跨单元。每个 cell 是一次性子 shell,cd、export、source 出了这个 cell 全没。有依赖的几步要塞进同一个 cell,或者用内核级的等价物:%cd 换目录、os.environ['VAR'] 设环境变量,这两个会留下来影响后续所有 %%bash。
这个坑我在别处吃过一模一样的亏:Jupyter 里 %%bash 里 source venv/bin/activate,下一个 cell 跑 python xxx.py,死活用的是系统 Python。查了一个多小时才反应过来是子 shell 的问题,当场想给自己两拳。
别用 !cmd 那种 shell 转义跑项目命令,用 %%bash。理由是让 shell 行为显式,多行命令共享同一个 shell 上下文。
什么时候别用这套
得说另一面,不然就成软文了。
简单短任务,直接塞 prompt 更快。几千 token 的东西,一轮就出答案。走 REPL 可能要五六轮工具调用,为了用而用纯属自找麻烦。
它省 token,但费时间。成本从"上下文 token"转移到"测试时计算"——轮次多了,墙钟时间和延迟涨了。论文图 5 显示,不同模型把输出 token 转化成进展的效率差得很远,强的一路往上爬,弱的很早就到平台期。
它吃模型的工具使用能力。模型得真的会"用电脑":知道该 grep 什么、怎么切片、什么时候写个中间文件。这个能力弱的模型,在 REPL 模式下可能比直接塞 prompt 还差。给它一间书房,它也只会在里面发呆。
**它明确不是安全沙箱。**文档反复强调这条,我原文抄:
The IPython kernel runs model-generated Python and project commands with the worker's operating-system permissions. It is a durable control environment, not a security sandbox.
worker 和 kernel 分进程是为了生命周期隔离和故障隔离,不是为了安全。它们跑在跟你一样的操作系统权限下。跑不受信任的仓库和指令,老老实实上外部沙箱。
最后
回到开头那个问题:128k 的文档丢给模型,它记不住怎么办。
传统方案一直在往"让它记得更多"的方向使劲——更大的窗口、更好的注意力机制、更精巧的检索。这些都对,但都在同一条路上。
Prime Agent 换了条路:**别让它记,让它查。**桌子摆不下就换个书房,反正你也不指望一个人把整个档案柜背下来。
代价是它得学会怎么用书房,而这件事今天的模型学得参差不齐——有的进去就开始建索引、造工具,有的进去发呆。
给的是资料还是工作台,决定了模型是在背书还是在做事。
下一篇单讲上下文压缩:桌面终究会满,满了之后哪些东西该收进柜子、哪些必须留在手边,那套逻辑比我以为的讲究得多。
附:配图源文件
正文三张图都是手写 SVG(images-prime-agent/fig-*.svg),改文字、调颜色直接编辑 SVG 即可,重新渲染成 PNG 就行。下面另附 mermaid 版本,方便你导进别的工具。
图一,两条路线对比:
图二,一次交互的时序:
图三,内核这一层: