ARTICLE · 1006840
AI办公斩杀线,一页文档多少钱
腾讯混元Hy4 preview正式发布并开源,770B参数,权重全放,搞得WorkBuddy紧急扩容,并且限免到9月10号。
WorkBuddy + Hy4的组合很明显,腾讯要重磅押注AI办公赛道。
Hy4 preview
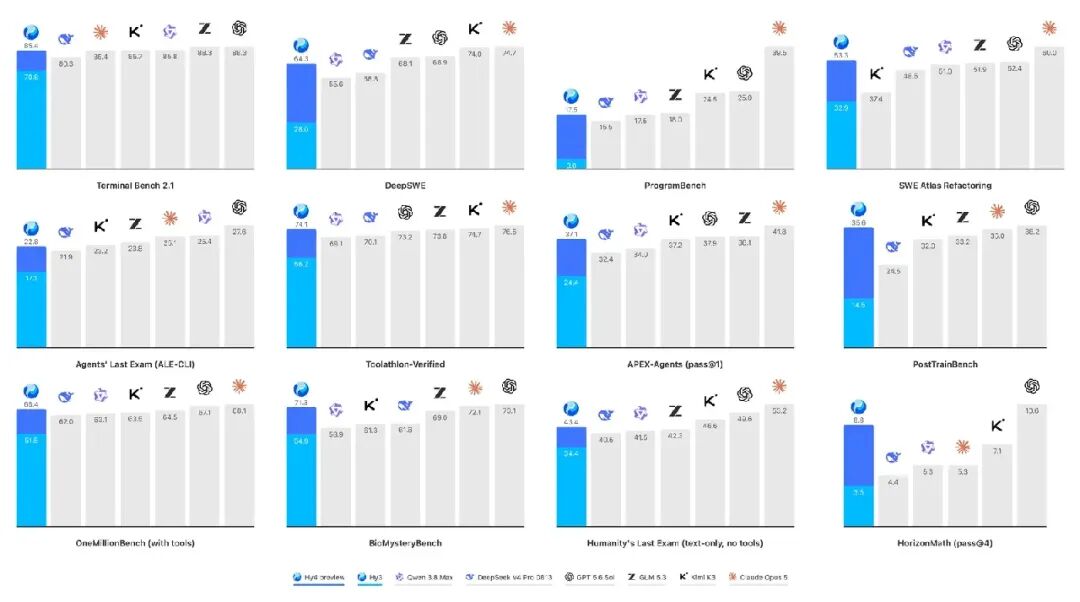
总参770B,每token激活49B,1M上下文,78层,第一层标准FFN,后面77层全是MoE。
这是目前开源阵营里参数最大的Apache 2.0模型。
一份几百页的财报,一本几万行的员工手册,几十个部门的报表,一次全塞进去,不用拆,不用先处理再喂。
能撑起这么长的上下文,靠的是架构。
它的注意力用Gated DSA,就是DeepSeek那套稀疏注意力的改良版,粗扫一遍知道内容在哪,需要的时候再精读,长文本的成本就这么被打下来了。
残差侧用了iHC超连接,让信息在层与层之间跑得更顺。官方自己写得很老实,受DeepSeek和GLM启发。
主干之外还内置了MTP投机解码,推理的时候带着你一路快跑。
Hy4的生产力
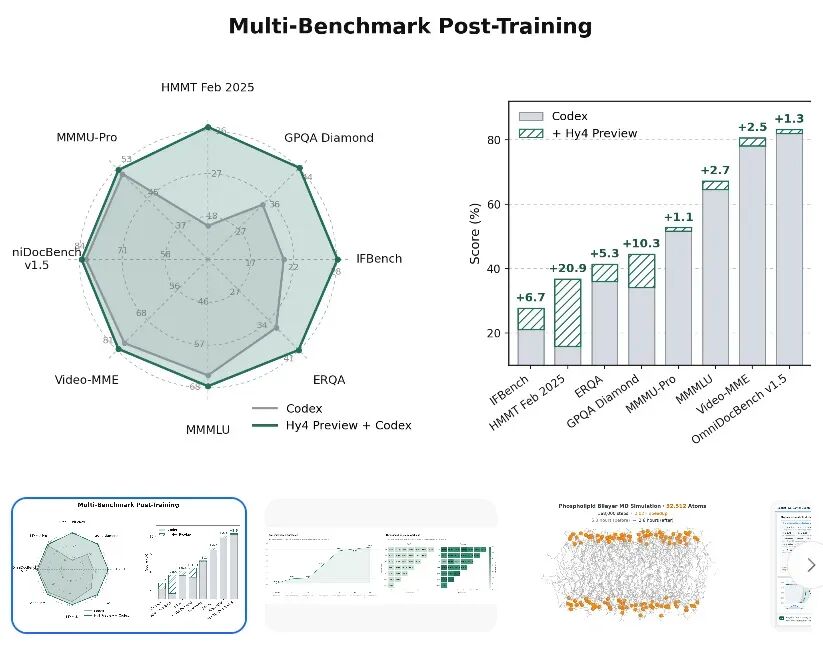
Hy4 preview 的官方定位有四个方向,软件工程、办公分析、游戏开发、科学研究。
软件工程:增强长程开发任务的理解、规划、调试与验证能力,进一步提升前端开发的视觉审美和交互质量;
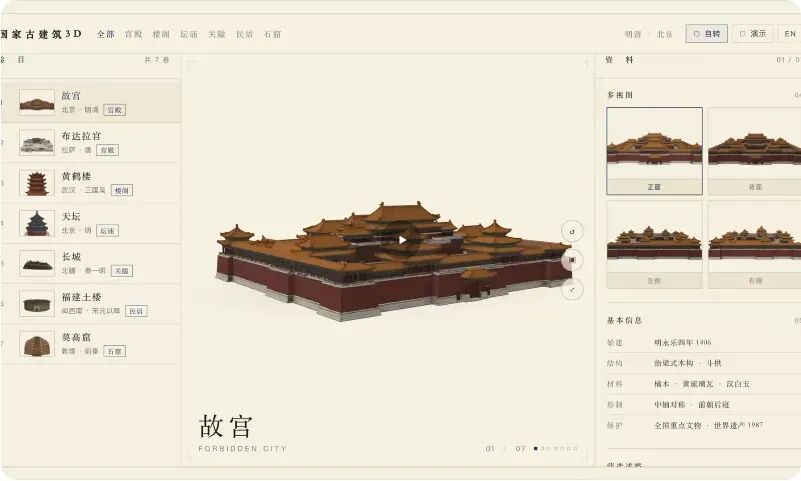
办公分析:复杂办公环境理解和金融分析能力,着重优化数据分析、跨文件协作,完成从信息处理到文档、表格与演示文稿交付的完整流程;
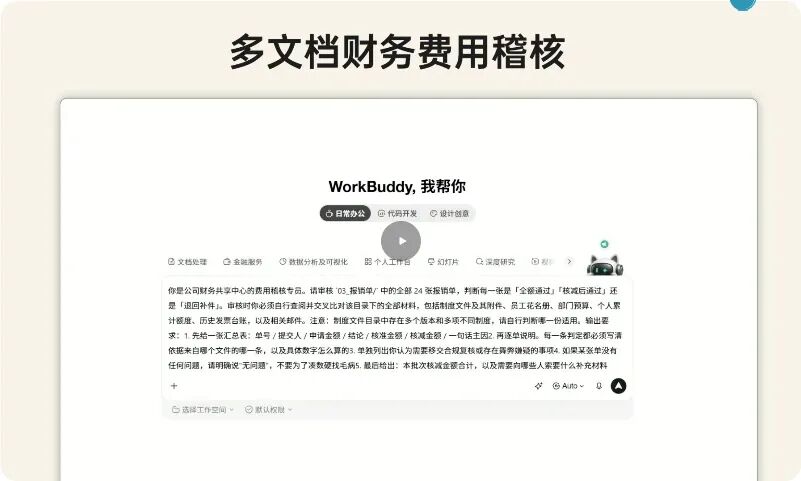
游戏开发:增强一句需求直接生成可玩原型能力,并能熟练使用游戏引擎,开发者可以通过多轮交互持续完善复杂游戏项目;
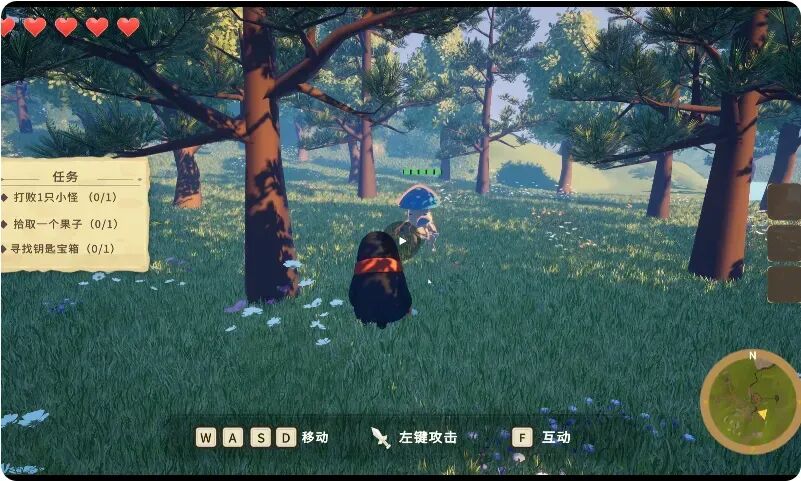
科学研究:提升复杂科研问题的理解、推理与求解能力,模型在 AI 研发、分子动力学模拟、凝聚态物理、基础数学等各类场景中均有长足进步。
二、处理一页文档,到底要花多少钱
作为打工人,比较关心在WorkBuddy上,处理一页文档,到底要消耗多少token,要花多少钱,值不值得用。
先搞清楚,一页文档是多少token
要算钱,先算token。
一页A4的中文文档,排版乱一点、带表格的,提取出来大概1000到1500个token。
如果直接截图喂给视觉模型,按 DeepSeek V4 Flash Vision 的算法,一张图最多算384个token。
Hy4 preview 的账本
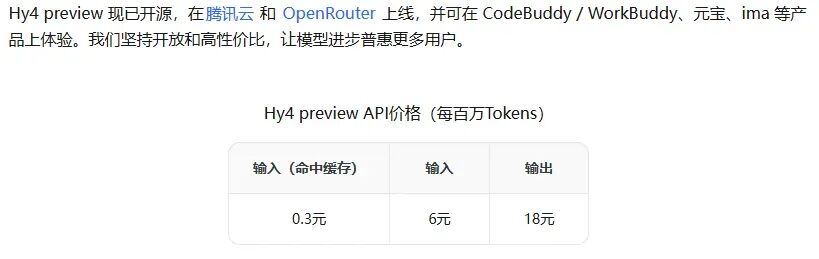
Hy4 preview 是文本推理模型,6元进18元出,缓存命中0.3元。
假设它读一页提取好的文本,一千五百个token进去,0.9分钱。再让它出一段分析,300~400百个token,约6厘钱。
加起来,一页大约1分5厘钱。
100页的报告,一块五。1000页的招股书,15块。
跟文档解析老玩家的成本对比
自建的 MinerU 和 PaddleOCR,软件免费开源,但你要自己养服务器和GPU。
PaddleOCR 一个CPU就能跑,一页几乎不要钱,可它只认字不认结构,干不了分析。
MinerU 强在结构,但用VLM后端处理一页要六千多个token,这个量级喂给大模型,token钱哗哗的。
视觉直读这条路,DeepSeek V4 Flash Vision 一页图最多384个token,按 V4-Flash 的价格,一页输入不到一厘钱,加上输出,三厘钱封顶。
三百页的古籍扫描件,一块钱以内搞定,这是实测过的数字。
GLM-5.3-Flash 更狠,原生多模态,阿里云百炼上输入0.8元输出2.8元,还在半价促销,一页的成本同样低到可以忽略。
谁更划算
这么一比,结论其实很清晰。
识别这层,视觉模型最划算。DeepSeek V4 Flash Vision 和 GLM-5.3-Flash,一页几厘钱,自建的OCR甚至不要钱,但只负责"看清"。
分析这层,才是 Hy4 preview 的菜。
它不跟你抢识别的活,它贵在"读懂加想明白加交付",一页1分5厘钱,换来的是一个能直接用的结论。
所以真正的成本优势,不在某一个模型身上,在流水线上。识别交给便宜的那层,分析交给 Hy4,一整套下来,100页的报告成本不超过3块钱,还不用自己养服务器。
这个账,算到这儿,就知道该怎么选了吧。
三、办公AI的下半场,是"读懂"而不是"识别"
从"识别"到"读懂"
我一直觉得,AI办公的这十年,其实就一个词,从识别到读懂。
早期OCR,是把纸上的字识别出来,一个字一个字。后来文档解析,是识别结构。再往后,多模态是看见。
而 Hy4 preview 这种,是读懂,理解了,还能接着干活。差别在哪,OCR告诉你发票上有"某某公司"四个字,读懂是告诉你,这张发票跟另一张对不上,可能是重复报销。
再比如,OCR能告诉你合同里写着"违约金20%",读懂是告诉你,这条跟前面的付款条款打架,真要照这个签,你大概率要吃亏。
这就是"认识一个字"和"明白一句话"的区别,也是办公AI和以前的文档工具的分水岭。
文档这个东西,从纸张、到电子文档,一直是人类文明的载体。以前技术只能让机器看见文档,现在终于有东西开始读懂文档了。这个转变,比参数大小重要得多。。。
再说说腾讯手里的牌
腾讯跟其他模型厂最大的不同,是手里攥着一整套办公场景。WorkBuddy、腾讯文档、企业微信、元宝,全是现成的入口。
Hy4 preview 往 WorkBuddy 里一塞,文档、表格、PPT一条龙,用户都不用换习惯,在原来的界面里就把活干了。
模型开源,权重全放,等于把底座也交出去了。开发者拿着这个底座,接上自己的文档解析、OCR、多模态工具,能拼出无数种办公方案。
这在闭源模型那里是想都不敢想的。
还有一件事别忘了,腾讯这次给了两个礼拜的免费期,到9月10号,每天还有免费额度,摆明了是让你先白用,用顺手了后面再掏钱。这套"先免费后收费"的打法,跟当年微信抢用户是一个路数。
收个尾
说一说我对AI办公的一些理解。
AI办公正在从"单点工具"走向"流水线"。文档解析管结构,视觉模型管读图,推理模型管分析,谁能把这三层捏合成一个顺手的流程,谁就赢了。 文档解析、OCR、多模态这些方向,不会因为大模型变强就消失,反而会变成大模型的"眼睛"和"手",越卷越重要。
以前AI是帮你查资料的助手,现在它开始替你读完和干完。当模型能把几十份文档读懂,再把活干完交给你,办公这件事的规则,就真的变了。
谢谢你看我的文章,我们下次再见。
https://github.com/Tencent-Hunyuan/Hy4-preview/tree/main https://hy.tencent.com/research/hy4-preview
推荐阅读