ARTICLE · 1011868
AI 进笔记软件,有两种“坐法”
上周我干了件小事:把一堆视频素材导进笔记库,想让 AI 帮我提炼成大纲。动手前愣了一下——这活儿,我该在哪儿喊它?
是在笔记软件里直接喊,还是切到另一个窗口,把整个笔记库打包丢给它?说起来有点玄学,但入口不一样,AI 干活的方式真的不一样。
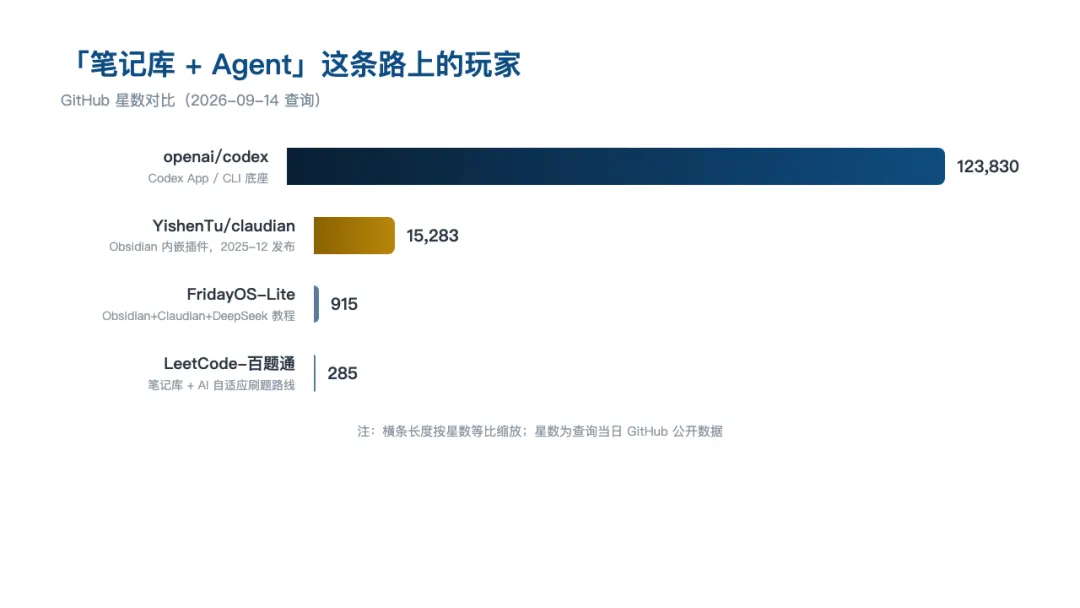
这两天看到一个Up主的视频,把这事讲得挺透。他拿两个具体工具做例子:OpenAI 的 Codex App,和一个叫 Claudian 的 Obsidian 插件。我查了下 GitHub,前者背后的 Codex CLI 有 123830 颗星,后者 15283 颗星,2025 年 12 月才发布——不到一年,这条路已经挤满了人。
先把两个名词交代了。Obsidian 是一款本地笔记软件,所有笔记是纯文本 Markdown 文件,它管你的整个笔记库叫 vault(仓库)。Agent 这词专栏里说过很多次了,就是能自己规划步骤、自己动手干活的 AI,不只是聊天。
两种坐法:一个在你旁边,一个在隔壁
那位Up主的框架很干净,两种模式,四维度拆解。
外部 Agent,以 Codex App 为代表。它有自己的独立界面,你把 Obsidian 的 vault 当成一个项目导入进去,在它那边的窗口里派活、看结果。干活的 AI 坐在隔壁房间——你把材料送过去,它做完送回来。
内嵌 Agent,以 Claudian 加 Codex CLI 为代表。它直接嵌在 Obsidian 里面,侧边栏就能唤起对话窗口,你写到哪儿、问到哪儿。AI 就坐在你旁边,探头就能看见你桌上摊开的那页笔记。
界面上看只是窗口切换的差别,真正的分野在底下——外部 Agent 从任务出发,内嵌 Agent 从当前笔记出发。前者偏任务中心,后者贴着阅读、写作、整理的现场。
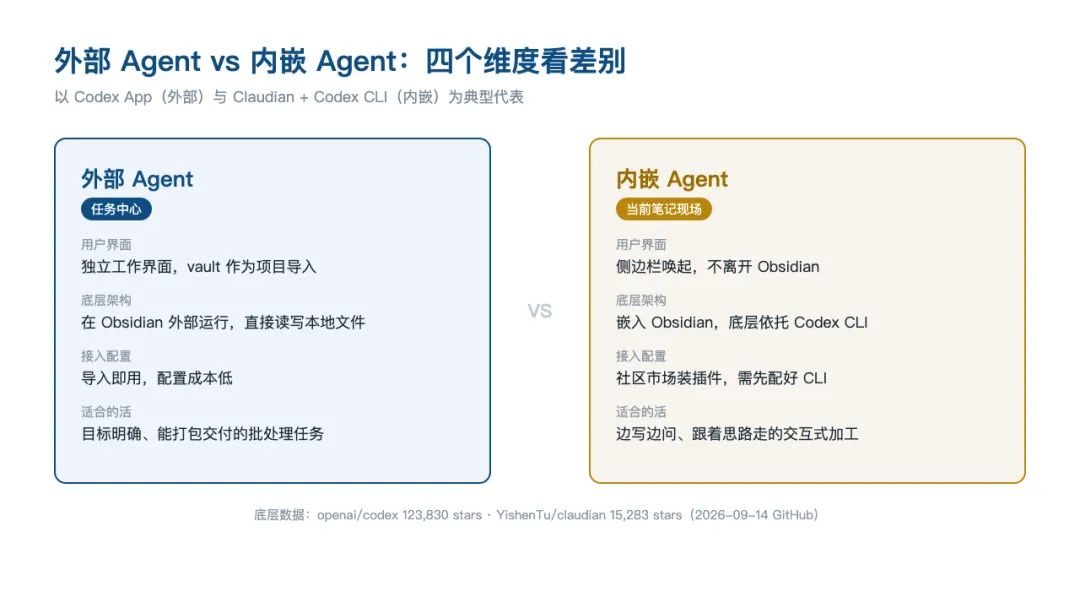
Codex App 这边,把 vault 导入就能干活,配置成本几乎为零;Claudian 那边,插件从 Obsidian 社区市场装,但底层得先装好 Codex CLI——它是站在 CLI 肩膀上的,不是从零违的轮子。
说白了,是上下文从哪来
我自己琢磨这事的时候,脑子里蹦出来的全是数据工程里的概念。
外部 Agent 像什么?像批处理作业。你给它一个任务包:这是我的库,这是我要的产出,去跑吧。它自己读文件、自己规划、批量交付结果。适合目标明确、边界清晰的活——「把这 50 个视频的要点都提出来」。
内嵌 Agent 像什么?像交互式查询。你正看着一页笔记,随手问一句「这段跟我上周那条结论矛盾吗」,它立刻基于现场给你答案。来回快,但每一步的上下文就是眼前这一小片。
你想想,我们在数仓边上干了这么多年,批和交互的区别早就刻进肌肉了。原来给笔记接 AI,碰上的是同一道题。
所以那个「选哪种」的问题,答案其实不新鲜:看你的活是什么形态。任务能打包、有明确验收标准的,丢给外部 Agent 批量跑;需要边看边想、跟着思路走的,留在笔记里现场问。
让我意外的,倒是两条铁律
视频里他讲了一个完整案例:导入视频资料(外部 Agent 批量处理)→ 在当前笔记里分析整理(内嵌 Agent 现场加工)→ 生成 PPT 大纲 → 跨工具制作 PPT(再交回外部 Agent)。
一个任务链,外部、内嵌、外部地接力。不是二选一,是按阶段切换。
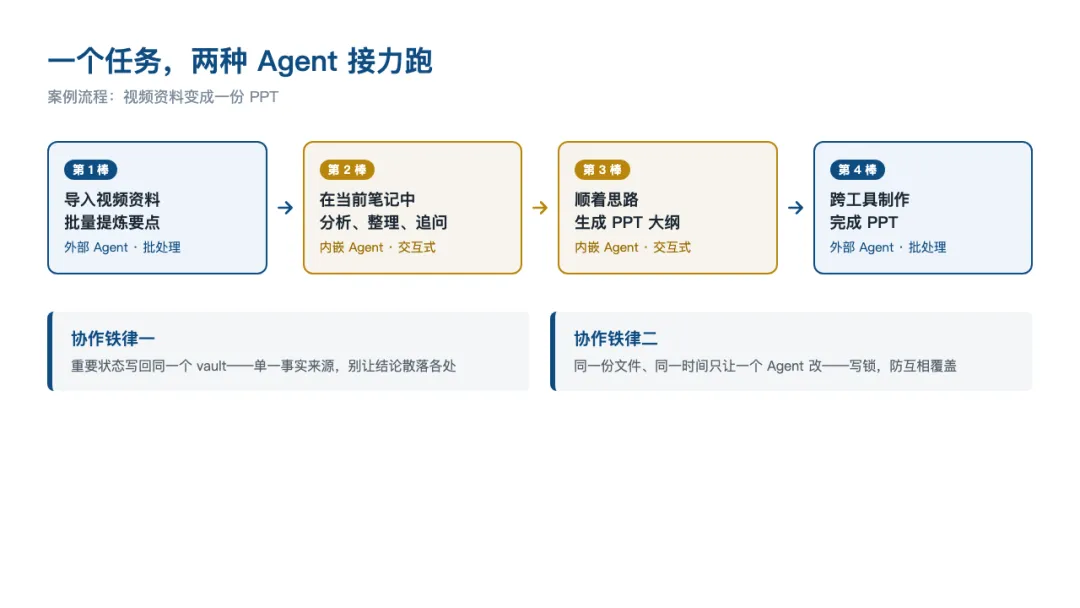
但整个视频里我最想划重点的,是他提到的两条协作原则——说实话,我看到的第一反应是:这不就是我们数据工程的老规矩吗?
第一条:重要状态写回同一个 vault。 不管哪个 Agent 干的活,关键结论都要落回同一个库。这就是单一事实来源。多工具协作最大的坑就是状态散落各处,最后没人知道哪份是真的。
第二条:同一份文件,同一时间只让一个 Agent 改。 这不就是写锁吗!并发控制的教科书第一条。两个 Agent 同时改一个文件,谁覆盖谁?数据工程师看到这条会心一笑——数据库事务隔离搞了几十年的问题,在笔记协作里原样重来一遍。
你看,AI 工具换了三代,「单一事实来源」和「写锁」还是稳稳坐在那儿。这些老规矩不是过时了,是换了个地方继续值钱。
已经有人在上面过日子了
翻翻 GitHub 你会发现,这不是极客的自嗨。
有个教程仓库专门教小白搭「AI 第二大脑」:Obsidian 加 Claudian,配国产模型 DeepSeek,宣称 20 分钟装完,不用翻墙不用订阅,攒了 915 颗星。更垂直的也有人玩——有人用同一套搭配刷算法题,把 LeetCode Hot 100 做成一个笔记库,让 AI 驱动自适应学习,收了 285 颗星。
这些数字跟 Ponytail 那种十几万星没法比,但它们说明一件事:笔记库加 Agent 这套玩法,已经开始向下渗透到普通用户了。工具链还是有点糙(要装插件、要配 CLI、要懂点命令行),但愿意折腾的人先把路踩出来了。
我的两个补充
视频没展开的,我补两句自己的看法。
一是把 vault 放进 git。既然 Agent 能直接读写你的本地文件,版本控制就不是可选项了。AI 改坏了你的笔记,至少能回滚。我做数据管道这些年,没有版本控制的目录我一律不敢让程序碰——笔记库凭什么例外。
二是新手别一上来搭全家桶。他自己也说了,先用一种模式跑通。我的经验也类似:工具越攒越多的时候,先想清楚你手里的活是批处理还是交互式,入口自然就定了。
一句话总结:AI 进笔记软件,坐哪儿不重要,重要的是别让两个 AI 同时摸一个键盘。
如果你每天也在和数据、信息打交道,欢迎关注,我们下篇见。
我是非著名数据工程师,干了十年,把数据变成信息,把信息变成判断。现在探索 AI 时代「只工作、不上班」的落地方案,往超级个体(OPC)走。AI 和数据的新东西,我先替你摸一遍,值不值得入坑,直接说;探索路上的账,也在这里一笔一笔记着。