ARTICLE · 1012040
DeepSeek-Harness 源码深读(07):压缩的会话日志,凭什么还能从尾部接着写
摘要:会话日志默认压成 zstd,却要支持从尾部追加。做法是把文件做成独立帧的拼接:每个写入批压成一个带校验的帧,追加即封帧。崩溃留下的半帧,不解压就能定出字节偏移;半帧里已完整的事件,捞回来重新追加。读写两侧、两步修复、link 与 MoveFileExW 的原子发布,对着源码逐段过。
教程篇《不保存任何会话状态,session 插件凭什么断点续跑》拆持久化时,停在了接缝上:协调器管缓冲、串行化、修复编排,后端只交几个字节级原语。那篇留了一个没打开的盒子:jsonl 后端落到磁盘上,到底做了什么。这篇拆盒子。
先交代观感。这个包第一眼容易绕道:zstd 帧格式、Win32 FFI、崩溃语义,三样各占一角。实际上每个文件只回答一个小问题,问题之间还是串着的。我们拿一个会话文件当主线,跟着它走完一生:出生、每批一帧地长大、被 kill -9 劈中、被救回来。
第一个问题出在出生之前。dsh 的会话日志默认压缩(compression 缺省 zstd),而持久化的命根是 append-only。这两件事天生打架:把压缩理解成整文件一条流,追加就得重压全部历史,或者维持一个一直开着的压缩流状态,进程一死流就废了。无论哪种,append-only 都名存实亡。
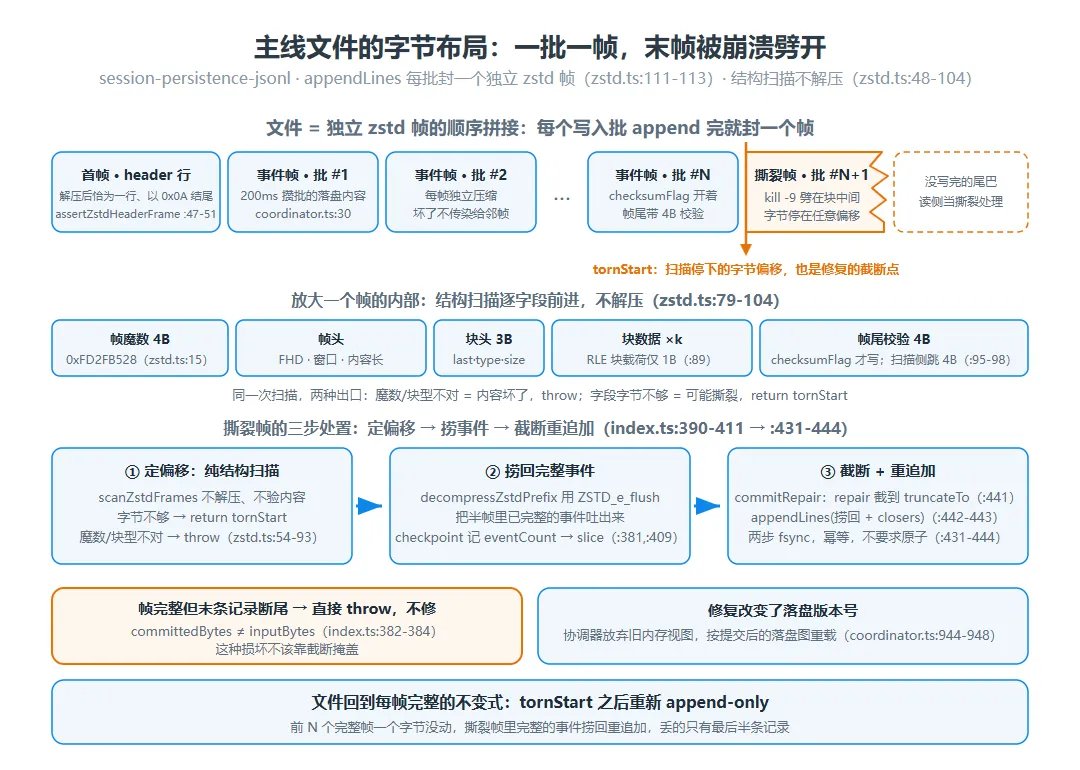
dsh 的解法是换压缩的单位。session.jsonl.zstd 被做成一串独立 zstd 帧的拼接:每攒出一批事件,压成一个自带校验的帧,接在文件尾。帧与帧之间没有共享状态,追加之后,前面的字节一个都不用再碰。
一批一帧,末帧被崩溃劈开
一、一批一帧:追加即封帧
先看写侧的最小单元。这段是压帧的全部(zstd.ts:18-20、111-113,中间省略无关代码):
const CHECKSUM_OPTIONS: ZstdOptions = { params: { [constants.ZSTD_c_checksumFlag]: 1 },}// ...export async function compressZstdFrame(input: Buffer | string): Promise<Buffer> { return zstdCompressAsync(input, CHECKSUM_OPTIONS)}这段就一行有效逻辑:Node 的 zstdCompress,配一个参数。注意 checksumFlag,它让每个帧尾部多出 4 字节校验。校验的价值要到崩溃恢复那节才显出来,先记下。
哪个粒度压一帧?事件先进 SessionWriteBehind 的攒批窗口(默认 200ms 一批,DEFAULT_WRITE_BATCH_MAX_DELAY_MS,coordinator.ts:30;这条缓冲链教程篇讲过),窗口到了整批序列化、压成一帧、追加。帧的粒度等于批的粒度,这直接决定了崩溃最多劈掉最后一批。
文件的第一个帧是特殊的。这段是首次落盘的编码(index.ts:619-626):
private async encodeMaterialization(meta: SessionHeader, events: readonly SessionEvent[]): Promise<Buffer | string> { const header = JSON.stringify(toHeaderLine(meta)) + '\n' const body = eventLines(events, this.packChunks) + '\n' if (this.compression === 'none') return header + body const headerFrame = await compressZstdFrame(header) const eventFrame = await compressZstdFrame(body) return Buffer.concat([headerFrame, eventFrame]) }这段把 header 行和首批事件分开压成两个帧。注意看:没有任何合并两帧的逻辑,连「header 只有一行,单独一帧太浪费」的优化都没有。assertZstdHeaderFrame(index.ts:47-51)强制首帧明文恰好是单条换行结尾的 header 行。list() 拿这个约束做了一件划算的事:只解压第一帧读元数据(readFirstZstdLine,index.ts:737-771,8KB 一块增量读,凑出第一个完整帧就停)。会话列表的成本随会话数增长,跟单个日志多长无关。
写侧到此成立:一批一帧,追加即封帧。可崩溃随时会来,来的时候多半劈在最后一帧中间。恢复的第一问:从哪个字节开始算垃圾?
二、结构扫描:不解压,先找到撕裂点
直觉做法是把日志解出来逐行解析,发现哪里 JSON 断了就从哪里截。dsh 没走这条路,它靠 zstd 帧自身的结构信息,不解压任何一个块就划出边界。
一个 zstd 帧的骨架:4 字节魔数开头,1 字节描述符说明后面跟什么,若干块各带 3 字节块头,帧尾可能带 4 字节校验。这些字段自描述,读它们不需要碰压缩数据。这段是扫描器的帧头部分(zstd.ts:54-77):
if (buffer.length - offset < 4) return { frames, tornStart: start } if (buffer.readUInt32LE(offset) !== ZSTD_MAGIC) { throw new Error(`corrupt Zstandard session log: invalid frame magic at byte ${offset}`) } offset += 4 if (offset === buffer.length) return { frames, tornStart: start } const descriptor = buffer.readUInt8(offset) offset += 1 if ((descriptor & 0x18) !== 0) { throw new Error(`corrupt Zstandard session log: reserved frame-header bit at byte ${offset - 1}`) } const contentSizeFlag = descriptor >>> 6 const singleSegment = (descriptor & 0x20) !== 0 const checksum = (descriptor & 0x04) !== 0 const dictionaryFlag = descriptor & 0x03 const dictionaryBytes = dictionaryFlag === 3 ? 4 : dictionaryFlag const contentSizeBytes = contentSizeFlag === 0 ? (singleSegment ? 1 : 0) : 1 << contentSizeFlag const remainingHeaderBytes = (singleSegment ? 0 : 1) + dictionaryBytes + contentSizeBytes if (buffer.length - offset < remainingHeaderBytes) return { frames, tornStart: start } offset += remainingHeaderBytes这段从魔数走到帧头结束,只做位运算和整数比较。注意看三个 return 和两个 throw 的分工:return 的分支都是「字节不够了」,文件在帧中间被 EOF 打断,返回撕裂起点 tornStart;throw 的分支是魔数错、保留位被置位,字节够但内容不对。两种下场不同:长度不足是崩溃的正常产物,可以修;结构内容损坏是介质或程序出错,修也没意义,直接抛。扫描器靠这组分支,把撕裂和损坏劈成了两个语义。
块的部分更短(zstd.ts:79-93):
for (;;) { if (buffer.length - offset < 3) return { frames, tornStart: start } const blockHeader = buffer.readUIntLE(offset, 3) offset += 3 const lastBlock = (blockHeader & 1) !== 0 const blockType = (blockHeader >>> 1) & 0x03 const blockSize = blockHeader >>> 3 if (blockType === 0x03) { throw new Error(`corrupt Zstandard session log: reserved block type at byte ${offset - 3}`) } const payloadBytes = blockType === 0x01 ? 1 : blockSize if (buffer.length - offset < payloadBytes) return { frames, tornStart: start } offset += payloadBytes if (lastBlock) break }这段逐块跳过载荷,纯加法推进 offset。注意 payloadBytes 那行:RLE 块(blockType 0x01)的载荷只有 1 字节,其余按 blockSize 跳。见到块头的 last 位,这个帧就收尾。若描述符说帧带校验,再让过 4 字节,一个帧的完整边界就出来了。循环走完整个文件,得到完整帧列表加一个可选的 tornStart。list 路径还用了它的 maxFrames 参数:scanZstdFrames(content, 1)(index.ts:752),只要第一帧。
上一节埋的 checksumFlag 在这里补上后半段:结构扫描只把校验当 4 字节占位跳过,真校验发生在解压时,Node 的解码器会验它,不匹配直接抛。扫描负责定位,解压负责验真,两道关卡各干各的。
tornStart 有了,从它开始的半帧即将被截掉。可这半帧里可能已经躺着几条完整事件:一批事件压成一个帧,崩溃劈在中间,前面几条明明完整落了盘。截掉它们,恢复出来的会话就凭空少了事件,seq 从此断在里面。这半帧必须先解开看一遍。
三、半帧捞金:把已完整的事件捞回来
结论先给:截断照做,但截之前先把半帧尽力解压一遍,里面完整的事件一条条捞回,修复时重新追加到日志尾部。
解半帧是另一个入口(zstd.ts:147-156,含注释):
/** * Recover available plaintext from a structurally incomplete final frame. * `ZSTD_e_flush` deliberately suppresses final-frame and checksum completion; * callers must establish the torn frame boundary before using this helper. * @param input - available bytes from a known incomplete Zstandard frame. * @returns plaintext produced from the available input. */export async function decompressZstdPrefix(input: Buffer): Promise<Buffer> { return zstdDecompressAsync(input, INCOMPLETE_FRAME_OPTIONS)}这段是「尽力解压」的全部实现,配置只有一行(zstd.ts:21-23):finishFlush 取 ZSTD_e_flush。普通解压要求帧收尾、校验完成,半帧喂进去只会报错;flush 模式把「能解多少算多少」变成合法操作。注释里那句 callers must establish the torn frame boundary 值得停一下:这个函数不检查收到的字节是不是真撕裂帧,边界判定是调用方的责任,也就是上一节的 scanZstdFrames。
调用方在 readZstdPrefix(index.ts:348-419),这段是撕裂分支(390-411):
let recoveredPlaintext: Buffer = Buffer.alloc(0) try { signal?.throwIfAborted() recoveredPlaintext = await decompressZstdPrefix(buffer.subarray(tornStart)) } catch { /* v8 ignore next -- decoder failure plus concurrent abort is timing-dependent */ if (signal?.aborted) signal.throwIfAborted() // A structurally incomplete final frame may end before Node's decoder can // emit any plaintext; the complete prior frames remain recoverable. } signal?.throwIfAborted() scanner.write(recoveredPlaintext) const recoveredPrefix = scanner.finish() signal?.throwIfAborted() return { meta: recoveredPrefix.meta, events: recoveredPrefix.events, tornMarker: { truncateTo: tornStart, recoveredEvents: recoveredPrefix.events.slice(complete.eventCount), }, }这段把半帧明文喂回 SessionLogScanner。注意看三个细节。第一,scanner 不是新起的:完整帧的明文早就喂过它,checkpoint() 记下了当时的 eventCount,所以末行 slice(complete.eventCount) 切出来的,恰好是半帧新贡献的事件。第二,seq 连续性校验(format.ts:362-372,教程篇讲过的 seq 契约)在这里挡住半行 JSON:没有换行结尾的行留在 fragments 里,一条都进不了 events,捞回来的必然是完整事件。第三,catch 分支:撕裂帧可能短到解码器吐不出任何明文,吞掉这个失败,前面的完整帧照常可用,恢复降级成只截断。还有一条边界我核稿时标了出来(index.ts:382-384):帧本身完整、帧里的 JSONL 记录断了尾,直接抛错。帧级撕裂可修,记录级损坏不修。
捞回的东西装进 tornMarker(index.ts:86-89):truncateTo 是字节偏移,recoveredEvents 是捞回的事件。这个对象对协调器完全透明:PersistenceBackend 的 TornMarker 是泛型参数(coordinator.ts:127),协调器只检查它存在不存在,原样传回,从不拆开。字节偏移这种 jsonl 特有的细节,不越过接缝泄漏;换成 SQLite 后端,令牌长什么样这边永远不知道。
令牌在手,剩下的是磁盘动作。
四、两步修复:先剪掉,再重新贴上
后端把修复落盘的方法叫 commitRepair(index.ts:431-444):
/** * Make a crash repair durable: truncate a torn tail, restore complete events * decoded from it, then append synthetic closers. Two fsync'd steps — the seam * does not require this to be atomic. */ async commitRepair( meta: SessionHeader, tornMarker: JsonlTornMarker | undefined, closers: readonly SessionEvent[], ): Promise<void> { if (tornMarker !== undefined) await this.repair(meta, tornMarker.truncateTo) const repairedEvents = [...(tornMarker?.recoveredEvents ?? []), ...closers] if (repairedEvents.length > 0) await this.appendLines(meta, repairedEvents) }这段是修复的全部落盘逻辑,两步。第一步 repair()(index.ts:692-701):truncate(path, truncateTo) 把文件剪回撕裂起点,开句柄 fsync。第二步把捞回的事件和 closers 拼成一批,走正常的 appendLines 追加,事件重新压进新帧。
注意看注释原话:Two fsync'd steps — the seam does not require this to be atomic。接缝层面明说这两步不必原子。敢这么说靠的是幂等:假设第二步之前进程又死了一次,磁盘停在「已截断、恢复事件还没写回」的状态;下次重启重走 prepare,loadStored 重新扫,得到的还是同一个前缀加同一个 tornMarker,修复路径原样再跑一遍。中间死多少次,结果都收敛到同一个终点。
closers 是什么,教程篇拆过:协调器用 interruptedTurnClosers 扫出没配对的 tool/call,合成 TOOL_OUTCOME_UNKNOWN 一族收尾事件,从第三个参数递进来。后端在这里只做搬运,不参与内容决策。协调器那边还有个细节(coordinator.ts:944-948):修复落盘会改变文件的 revision(dev/ino/size/mtime 全变了),所以 commitPrepared 在修复后放弃旧的内存视图,重新加载已提交的图,不让旧数据挂上新版本号。
异常路径闭环了。正常路径上的失败呢?磁盘满、权限丢,追加写到一半抛错,日志怎么办?
五、写失败:截回写入前的尺寸
appendLines 的做法朴素得像手工记账(index.ts:651-679,全文):
private async appendLines(meta: SessionHeader, events: readonly SessionEvent[]): Promise<void> { const content = await this.encodeEventBatch(events) const path = logPath(this.root, meta.cwd, meta.id, this.compression) const handle = await open(path, 'a') let closed = false const closeAppendHandle = async (): Promise<void> => { if (closed) return closed = true await handle.close() } try { const { size: before } = await handle.stat() try { await handle.writeFile(content) await handle.sync() } catch (error) { try { await closeAppendHandle() await this.rollbackAppend(path, before) } catch (rollbackError) { throw new AggregateError([error, rollbackError], `failed to roll back append to 「${path}」`) } throw error } } finally { await closeAppendHandle() } }这段是追加的主体:'a' 模式开句柄,写入前先 stat 记下 before。注意看 catch 里的顺序:关句柄、rollbackAppend 截回 before、再抛原错误。为什么要急着截?半截留在那里,下次重启靠撕裂尾机制也能清掉,听起来也行。卡点在活着的重试:写入失败后协调器的游标没动,重试会再写整批;半截加整批,同一个 seq 在文件里出现两次。当场截回 before,写入位置等于没动过,整批重试是安全的。回滚自己再失败,两层错误打包成 AggregateError 一起抛,不吞。
读侧有个对称的小设计,readStableFile(index.ts:296-303):
for (;;) { signal?.throwIfAborted() const before = fileRevision(await stat(path, { bigint: true })) const buffer = await readFile(path, { signal }) signal?.throwIfAborted() const after = fileRevision(await stat(path, { bigint: true })) if (before === after) return { buffer, revision: after } }这段防的是读写并发:stat、read、stat,两次 revision 一致才认这次读到的字节。fileRevision 由 dev/ino/size/mtimeNs/ctimeNs 拼成(index.ts:100-108),写者只要在 read 前后动过文件,循环重来。
追加和修复都默认一件事:文件已经在磁盘上了。可它总有第一次落地,那一刻目录还不存在,可能有两个进程同时想创建它,创建完还可能立刻断电。
六、出生:link 的 EEXIST,MoveFileExW 的写透
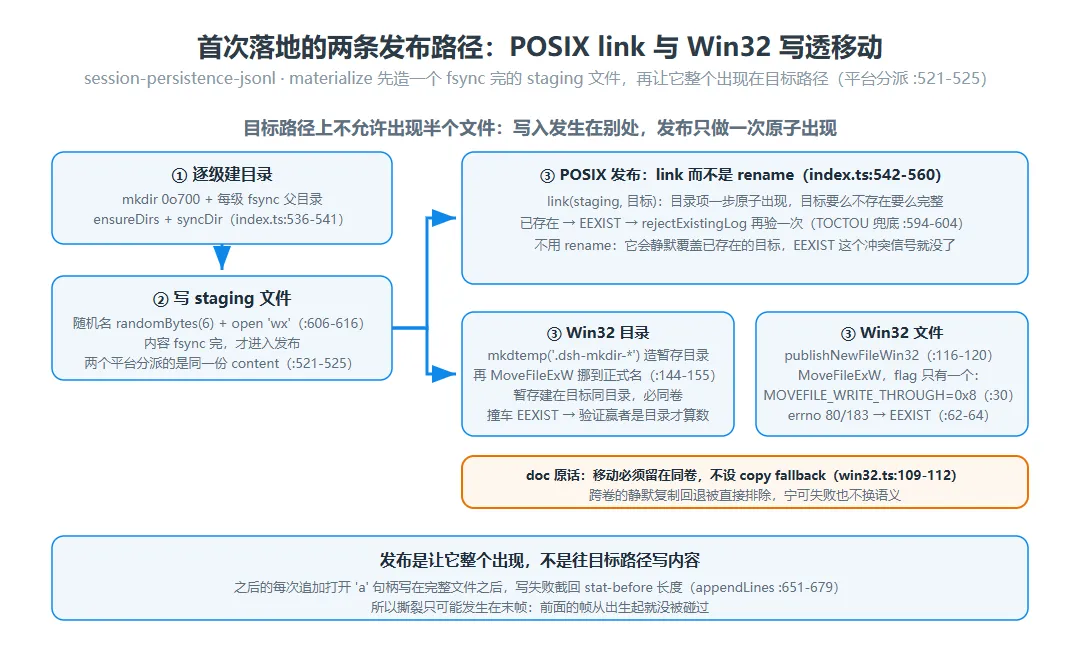
首次落地(materialize)要保证 header 和首批事件作为一个整体出现,中间状态不可见。做法三步:先写临时文件并 fsync,再用一个「只创建、不覆盖」的原语发布到最终路径,最后让目录项本身崩溃持久。
临时文件这步(index.ts:606-616):wx 标志独占创建,文件名带 6 字节随机数的十六进制后缀,write、sync、close。发布原语两个平台各有一个,POSIX 这边(index.ts:542-560):
await this.rejectExistingLog(finalPath, id) const tmp = await this.writeSyncedTempFile(finalPath, content) // Publish via link()+unlink(), NOT rename(): link fails with EEXIST if the // final path already exists, so two processes materializing the same id // concurrently cannot clobber each other. rename() would silently overwrite. let linked = false try { await link(tmp, finalPath) linked = true } finally { // Remove an unpublished temp on failure. After publication, defer cleanup // until the directory entry is durable so cleanup cannot reject a live log. /* v8 ignore next -- link failure is the TOCTOU/IO race guarded above; not reachable in test */ if (!linked) await rm(tmp, { force: true }) } // link() succeeded — the log is published. fsync the directory so the new // entry survives a power loss: the new link is not crash-durable until the // parent directory's metadata is synced. await this.syncDirPosix(dir)这段是 POSIX 发布的核心。第一行的 rejectExistingLog(index.ts:594-604)先查最终路径是否已有提交日志,内存里查过一遍碰撞,这里是磁盘侧的 TOCTOU 兜底。注意看注释为什么点名 rename:link 在目标已存在时失败并返回 EEXIST,rename 会静默覆盖。两个进程并发物化同一个会话 id,赢家 link 成功,输家收到 EEXIST,转头去加载赢家写好的日志,谁也没踩谁。换 rename 的话,输家会把赢家刚落好的日志整个盖掉,输家还以为自己是赢家。materializePosix 开头五行逐级 mkdir(0o700)加逐级 fsync 父目录(index.ts:536-541),处理目录项的崩溃持久:新建的 link 在父目录元数据同步之前,断电后就没了。
Windows 上这套走不通,卡点很具体:Node 不提供打开目录做 fsync 的能力。win32.ts 绕开 Node,经 koffi 直调 kernel32(win32.ts:116-120):
export async function publishNewFileWin32(existing: string, replacement: string): Promise<void> { const api = await win32() const ok = api.moveFileExW(toNamespacedPath(existing), toNamespacedPath(replacement), MOVEFILE_WRITE_THROUGH) if (ok === 0) throw win32Error('MoveFileExW', api.getLastError(), existing, replacement)}这段是 Windows 的发布原语。注意 flags 只有一个 MOVEFILE_WRITE_THROUGH(win32.ts:30,值 0x8):写透,移动在返回前落到盘上;不带替换语义,目标存在就失败;不设 MOVEFILE_COPY_ALLOWED,跨卷不悄悄退化成复制。目录创建也走写透移动(win32.ts:144-155):
async function createLeafDirectoryWin32(parent: string, target: string): Promise<void> { // Keep the staging component independent of the target basename so a legal // 255-byte target component does not make mkdtemp's sibling name too long. const staging = await mkdtemp(toNamespacedPath(join(parent, '.dsh-mkdir-'))) try { await publishNewFileWin32(staging, target) } catch (error) { await rm(staging, { recursive: true, force: true }) if (isEEXIST(error) && await assertDirectory(target)) return throw error }}这段把创建目录也变成了发布:先 mkdtemp 造一个随机 staging 兄弟目录,再写透移动到最终名。注意 catch 里那行:移动失败且错误是 EEXIST 时,验证赢家确实是目录才认输返回,否则照抛。Win32 错误码在这层被翻回 errno 形状(errnoCode,win32.ts:53-70),ERROR_FILE_EXISTS(80) 和 ERROR_ALREADY_EXISTS(183) 都映射成 EEXIST,上层用同一套判断处理两个平台。materialize 在入口按平台分派(index.ts:521-525),两条路径喂的是同一份 content。
POSIX link 与 Win32 写透移动
文件落在正确的位置了。最后一个变量是位置的名字本身。
七、路径编码:id 是个没验证过的字符串
会话 id 的类型是 SessionId,一个品牌字符串。类型系统只知道它是 string,不知道里面装的是不是 ../../etc。所以 id 进路径之前,必须过一道编码(format.ts:121-136):
export function encodeSegment(raw: string): string { if (raw.length === 0) throw new Error('cannot encode an empty path segment') if (raw === '.') return '~002E' if (raw === '..') return '~002E~002E' let out = '' for (let i = 0; i < raw.length; i++) { const code = raw.charCodeAt(i) const ch = String.fromCharCode(code) if (ch !== '~' && /^[A-Za-z0-9._-]$/.test(ch)) { out += ch } else { out += '~' + code.toString(16).toUpperCase().padStart(4, '0') } } return out}这段是会话目录名的全部来源。注意看三处:~ 自己也被编码成 ~007E,否则解码有歧义;. 和 .. 整段特判,这是路径穿越的最后一条缝;逐 code unit 处理,孤立代理项也编得进去。文件头注释给它的定语是单射,injectively over ALL JS strings(format.ts:110-112):两个不同的 id 编不出同一个目录名,路径穿越无门。
项目目录那边宽松得多(format.ts:147-167):分隔符折叠成 -,截断到 251 码元,两侧包 --。我拿本机路径推了一遍,E:\winning\code\AI\deepseek-harness 变成 --E-winning-code-AI-deepseek-harness--,一眼能认出是哪个项目。这层有损是故意的,注释写明 following the common human-navigable project-directory convention:目录名给人看,身份校验不靠它。真正的身份校验在 header 行里,assertStoredIdentity(index.ts:808-828)读出 header 后,要求 header 里的 id 和 cwd 反推的路径与实际路径互相印证,对不上按损坏处理。cwd 缺失的会话落进 _no-cwd 目录(format.ts:177)。
root 本身没有默认值(index.ts:60-68 的注释):默认 process.cwd() 会随 bash 调用、子进程起停而漂移,同一个会话的文件被写散在不同目录。所以配置里 root 必填。同一个 root 也不允许混两种物理编码:zstd 和 none 各写各的文件名后缀,扫描发现对方的存在直接抛错(ensureRootEncoding,index.ts:876-888),让用户分开 root,不做自动迁移。
八、设计取舍
把这条链摊开对账。
拷贝次数。同一段事件数据从内存到磁盘要走三层拷贝:进攒批队列时 structuredClone 一次,排队前 snapshotJsonValue 快照一次,落盘前 JSON.stringify 一次。三层都在买同一个东西,隔离:等待窗口里调用方怎么改手里的对象,都不影响已入册的事件。chunk 打包行(packChunks,默认开,实测日志小约 60%,index.ts:70-75 的注释)是对吞吐的部分补偿。
压缩率。每帧独立压,等于每帧带一份自己的字典状态,压缩比低于整文件单流。这笔账换的是 append-only 本身。
长日志的解码。readZstdPrefix 解帧时每 500ms 让一次事件循环(ZSTD_DECODE_YIELD_INTERVAL_MS,index.ts:44),几百 MB 的日志不会把进程卡死。但让步只到帧级,单个帧内部仍是同步解码,它不让出。
结语
回到主线那个文件。此刻它在磁盘上的样子:第一个帧明文恰好一行 header,后面 N 个完整帧各带 4 字节校验,最后一个帧从 tornStart 字节起是半截。重启之后,scanZstdFrames 在 0xFD2FB528 魔数之间数出 N;readZstdPrefix 把半帧尽力解一遍,捞出最后一批里已完整的几条;commitRepair 先 truncate 回 tornStart,再把捞回的事件加一条 turn/end 重新压成新帧接上去。整个过程里,前面 N 个帧一个字节没被碰过。压缩、追加、崩溃恢复,三件事在同一个文件格式里同时成立。
深读线下一篇(08)拆 checkpoint-policy:这篇解决的是「怎么存」,什么时候必须停下来等落盘(turn 边界?工具调用之后?改完文件?)是另一层的策略问题,83 行的策略插件就是干这个的。
你的持久化损坏检测,是逐行解析兜底,还是格式自带结构校验?评论区聊聊你踩过的损坏现场。
本系列基于 DeepSeek Harness 源码(MIT,0.1.1-rc.1)与官方 Agent Notes 整理,仓库:github.com/deepseek-ai/deepseek-harness。有收获就点个关注,下一篇见。