ARTICLE · 1012248
你的 AI 编程助手,九成 token 不是在思考
开头
用 AI 写代码的人大概都有同一个体感:效率是涨了,账单涨得更快。Spotify 的一位产品负责人把账单拆开看了一眼,发现问题可能不在价格——你的 AI 编程助手,大部分时间根本没在思考。
他的原话:AI 编程 agent 为我做的事,大部分不是思考,是 I/O。
读五个文件,只为回答某个方法的一个问题;照着旁边二十个测试文件的写法,再生成一个一模一样的测试文件;开完会顺手更新一下文档。几千个 token 花出去,推理几乎为零。而这些活,全被喂给了一个贵得多的顶级模型。
这笔钱有多离谱
文章给了几个数字:按预测,到 2028 年 AI 编程的成本会超过开发者的平均工资;四分之一的工程负责人,现在每个开发者每月就要烧掉 200 到 500 美元,有些早就超过了 2000 美元。工具本身是能回本的——前提是你别再拿最贵的模型去干最便宜的活。
(这几个数字是文章引用的预测与调研,不是作者本人的实测。)
解法:两个「模式」
他用的是 Portal by Spotify 里的 AiKA Modes。一个 mode 就是一个声明式的 agent,跑在临时运行时上——作者的说法是「像 AWS Lambda,但是给 agent 用的」。你写好指令、挑一个模型、设几个参数(比如 temperature),再挂上 MCP 工具(Model Context Protocol,模型上下文协议,让模型调用外部工具的标准),剩下的交给 Portal。不用管基础设施,不用配 API key,也没有长驻服务。调用走 Portal 的 CLI 或 API;mode 可以公开给全公司,也可以私有。
为了做这次分流,他只建了两个 mode,示例里 worker 模型都用 Gemini 2.5 Flash(model 字段填你 Portal 里配好的任何模型都行):
bulk-reader(批量读)——专门处理「Claude 为了一个问题要读一堆大文件」的情况。指令里写死:只输出结构化要点,不要问候、不要铺垫、不要散文;每条要点以文件名、类型或行号开头;调用方没问的东西一律跳过。
code-writer(批量写)——负责测试、配置脚手架、类型桩这类「照着现有写法就能推出来」的输出。指令要求严格匹配现有代码的命名、风格和模式,并且只输出代码。作者特意强调,「只输出代码」这句很重要:不加,模型就会把结果裹进 markdown 代码块和解释文字里,Claude 还得再费劲解析一遍。
怎么让它自动发生
第一版是把路由规则写在 CLAUDE.md 里,靠 Claude 自己读规则、自己分流。问题有两个:规则只是建议、拦不住;而且每个项目都得复制一份。
现在的版本是一个叫 shunt 的 Claude Code 插件,委托走 Portal CLI 的 actions registry,分三层:
第一层,钩子(hooks)。 Claude Code 的钩子会在每次工具调用前触发,shunt 注册了两个 PreToolUse 钩子:check-file-size 盯着每一次 Read 调用,文件超过行数阈值(默认 350 行)就直接拦下,告诉 Claude 改用 /bulk-reader;check-bash-read 拦 cat、head、tail、less、more 这类整文件读法,管道命令(像 cat 文件 | grep)放过——那算有针对性的读。阈值可以用 SHUNT_MIN_LINES 环境变量调。
第二层,脚本。 两个 bash 脚本包住 Portal CLI 的调用,Claude 只要给命名参数,剩下的(拼请求、调 actions、解错误、把 token 用量报到 stderr)脚本内部处理。mode 按名字寻址,Portal 的解析是大小写不敏感的,优先级是「你自己的 → 你团队的 → 公开的」;你把公开的 bulk-reader fork 一份改一改,自己的版本自动生效,不用任何配置。
第三层,技能(skills)。 两个 skill 文件告诉 Claude 什么时候、怎么调这两个脚本。钩子拦下一次读的时候,拦截信息会把 Claude 指向对应的 skill,把转向做得更顺。
这三层的好处是能优雅降级:就算 Claude 没读 skill 描述,钩子照样会拦住那次昂贵的读。
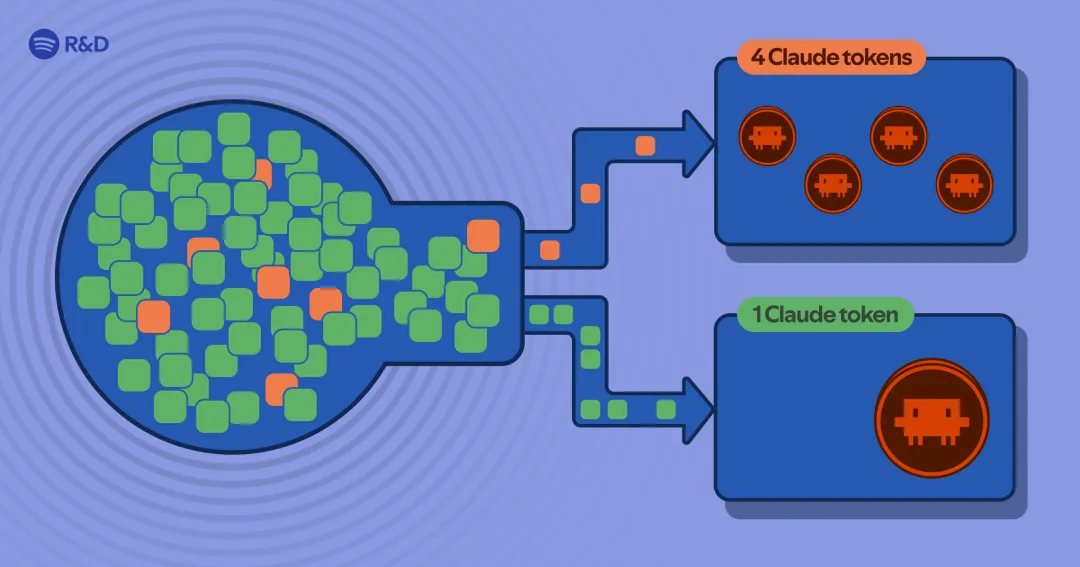
shunt 分流示意:同一个动作,走上路要 4 个 Claude token,走下路只要 1 个(原文配图,Spotify R&D)
省了多少
测试在一个 Java 单仓上跑,四个场景,对比「Claude 直接读文件」和「读 bulk-reader 的摘要」——bulk-read 平均省下约 90%。注意,这个 90% 说的是批量读这个场景,不是总账单(标题里的「砍掉 90%」指的就是它)。
code-write 场景很难用 token 衡量:没有 shunt 时,Claude 既要读参考文件,又要把生成的代码作为昂贵的输出 token 吐出来;用了 shunt,代码直接落盘,Claude 从头到尾看不到。省了多少,账面上看不见。
作者自己列的「做不到」
比插件更值钱的部分
插件是个 Claude Code 的产物,但底下那层意思——用 AiKA modes 做模型路由——才是承重的。作者列了四条:可复用(同一套 mode 跨项目、跨所有能调 Portal CLI 的工具);可分享(两个 mode 都已经在 AiKA 公开,现在就能直接用);可组合(写文档的 doc-writer、做代码审查摘要的 reviewer、做国际化的 translator,各是几次点击的事);还有把「何时委托」和「怎么回应」解耦——插件决定什么时候分流,mode 决定怎么回答,换便宜模型、改系统提示词、加 MCP 工具,插件一行都不用动。
他的总结是:AiKA modes 把模型路由从系统工程问题,变成了配置问题。你不用搭基础设施,你只要描述你要什么,然后给它起个名字。
想自己试
claude plugin marketplace add spotify/portal-ai-plugins
claude plugin install portal@portal
claude plugin install shunt@portal
装完开一个新的 Claude Code 会话,跑 /portal:setup,把 Portal CLI 对着你的 Portal 实例认证一下。bulk-reader 和 code-writer 已经是公开的,不用自己建;想改(换 worker 模型、改指令),在 Portal 里 fork,你的版本自动优先。
最后
这篇文章真正戳人的,不是那个 90%,而是它指出的方向:省 token 不是把模型换个便宜的,而是别让贵的模型去干便宜的活。
也别急着照搬。这套东西搭在 Spotify 自家的 Portal 上,作者本人就是 Portal 的产品经理;两个 mode 是公开的,插件也能从 Spotify 的 marketplace 直接装,但你的团队没有 Portal,就得先有那层基础设施。真正能立刻拿走的,是那个判断——下次账单涨了,先问一句:这些 token 里,有多少是在思考,有多少只是在搬砖?
原文:Dimitri Mazmanov《Portal by Spotify: Cut my Claude Code token usage by 90%》,Spotify Engineering,2026 年 9 月 3 日。