ARTICLE · 1013496
FreeRTOS延时机制源码剖析:vTaskDelay与vTaskDelayUntil,一字之差,本质之别
平台:STM32F103RET6(Cortex-M3)内核:FreeRTOS V11.1.0(RVDS/ARM_CM3 移植层,SMP-capable 新版内核,本工程按单核编译)本文所有代码均取自本工程实际源码(所属源文件在代码块首行注释标注)
一、两种延时语义:一字之差,本质之别
FreeRTOS 任务阻塞延时有且只有两个入口:
*pxPreviousWakeTime | ||
| 累积 | 锁定 | |
pdTRUEpdFALSE 未睡(目标刻度已过,或恰好到点) | ||
用时间轴看最直观(tick=100Hz,负载 100ms,周期 500ms):
TaskDelay(相对): 0 ---负载100--- 100 --睡500-- 600 ---负载--- 700 --睡-- 1200 ...唤醒点:600, 1200, 1800... 每圈 +600,误差累积vTaskDelayUntil(绝对): 0 ---负载100--- 100 --睡400-- 500 ---负载100--- 600 --睡400-- 1000 ...唤醒点:500, 1000, 1500... 恒在 500 网格上
判断口诀:代码里出现"每 x ms 必须执行一次"——用 vTaskDelayUntil;只是"等一会儿"——用 vTaskDelay。前者的周期是需求,后者的间隔是礼貌。
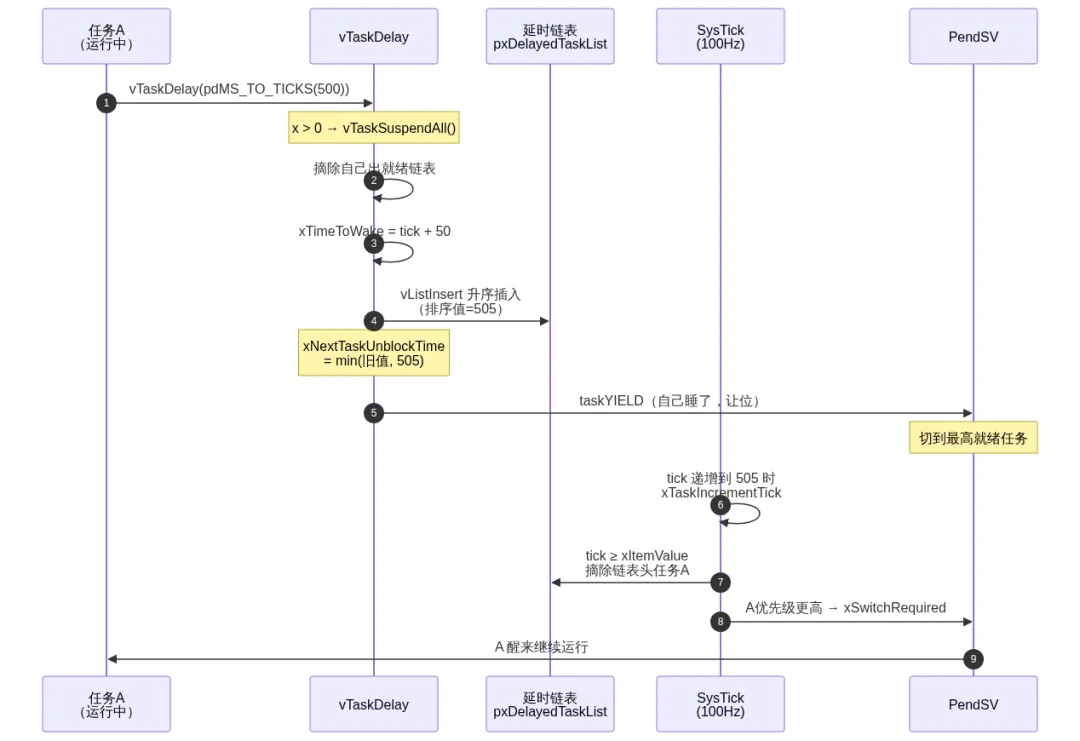
二、vTaskDelay:四步走完一次相对延时
/* FreeRTOS/tasks.c */void vTaskDelay(const TickType_t xTicksToDelay ){BaseType_t xAlreadyYielded = pdFALSE;/* A delay time of zero just forces a reschedule. */if( xTicksToDelay > ( TickType_t ) 0U ){vTaskSuspendAll();{configASSERT( uxSchedulerSuspended == 1U );prvAddCurrentTaskToDelayedList( xTicksToDelay, pdFALSE );}xAlreadyYielded = xTaskResumeAll();}/* Force a reschedule if xTaskResumeAll has not already done so */if( xAlreadyYielded == pdFALSE ){taskYIELD_WITHIN_API(); /* 触发 PendSV,CPU 交给最高就绪任务 */}}
四个要点:
- x=0 语义
:不进任何链表,只强制一次调度(变相的 taskYIELD)——本工程 tick=100Hz, pdMS_TO_TICKS(5)向下取整就是 0,想睡 5ms 实际一次都没睡; - 为什么先 vTaskSuspendAll 再干活
:挂起调度器比关中断便宜(不屏蔽中断,只锁任务切换),搬链表期间 tick 中断照常 pend,恢复时由 xTaskResumeAll统一补账; - 内部断言
uxSchedulerSuspended == 1U:如果你在外面已经 vTaskSuspendAll()过一次,这里计数为 2,断言必失败——本工程configASSERT是关中断 + 死循环,当场冻死(实测见挂起调度器后使用延时导致卡死问题记录.md); - 真正的脏活全部下沉
到 prvAddCurrentTaskToDelayedList——它同时也是队列/信号量超时阻塞的公共后端(xCanBlockIndefinitely=pdTRUE时portMAX_DELAY挂挂起链表)。
三、延时链表:阻塞任务睡在哪里
3.1 两条按唤醒时刻排序的链表
/* FreeRTOS/tasks.c */PRIVILEGED_DATA static List_t * volatile pxDelayedTaskList; /* 当前轮延时链表 */PRIVILEGED_DATA static List_t * volatile pxOverflowDelayedTaskList; /* 溢出轮延时链表 */PRIVILEGED_DATA static volatile TickType_t xNextTaskUnblockTime; /* 最早唤醒时刻缓存 */
任务阻塞时, xStateListItem的排序值被写成绝对唤醒时刻xTimeToWake,vListInsert按升序插入——链表头永远是最先该醒的任务;xNextTaskUnblockTime是"下一个该醒的时刻"缓存:tick 中断先比它,不等到点连链表都不碰,把 O(n) 的扫描摊销成绝大多数 tick 的 O(1)。
3.2 prvAddCurrentTaskToDelayedList:搬家全过程
/* FreeRTOS/tasks.c */static void prvAddCurrentTaskToDelayedList( TickType_t xTicksToWait,const BaseType_t xCanBlockIndefinitely ){TickType_t xTimeToWake;const TickType_t xConstTickCount = xTickCount;/* ① 先从就绪链表摘下来(同一个 xStateListItem 两边复用) */if( uxListRemove( &( pxCurrentTCB->xStateListItem ) ) == ( UBaseType_t ) 0 ){portRESET_READY_PRIORITY( pxCurrentTCB->uxPriority, uxTopReadyPriority );}if( ( xTicksToWait == portMAX_DELAY ) && ( xCanBlockIndefinitely != pdFALSE ) ){/* ② 永久阻塞:挂挂起链表,tick 永远叫不醒 */listINSERT_END( &xSuspendedTaskList, &( pxCurrentTCB->xStateListItem ) );}else{/* ③ 相对 → 绝对:唤醒时刻 = 现在 + 睡多久 */xTimeToWake = xConstTickCount + xTicksToWait;listSET_LIST_ITEM_VALUE( &( pxCurrentTCB->xStateListItem ), xTimeToWake );if( xTimeToWake < xConstTickCount ){/* ④ 加法回绕 → 挂溢出链表 */vListInsert( pxOverflowDelayedList, &( pxCurrentTCB->xStateListItem ) );}else{/* ⑤ 未回绕 → 挂当前链表(按唤醒时刻升序) */vListInsert( pxDelayedList, &( pxCurrentTCB->xStateListItem ) );if( xTimeToWake < xNextTaskUnblockTime ){xNextTaskUnblockTime = xTimeToWake; /* 刷新最早唤醒缓存 */}}}}
注意第 ③ 步:传进来的参数是"睡多久"(相对值),链表里存的是"何时醒"(绝对值)。vTaskDelay 和 vTaskDelayUntil 的全部差别,就发生在"睡多久"怎么算出来这一步——下一节。
四、xTaskDelayUntil:绝对刻度 + 基准无条件推进
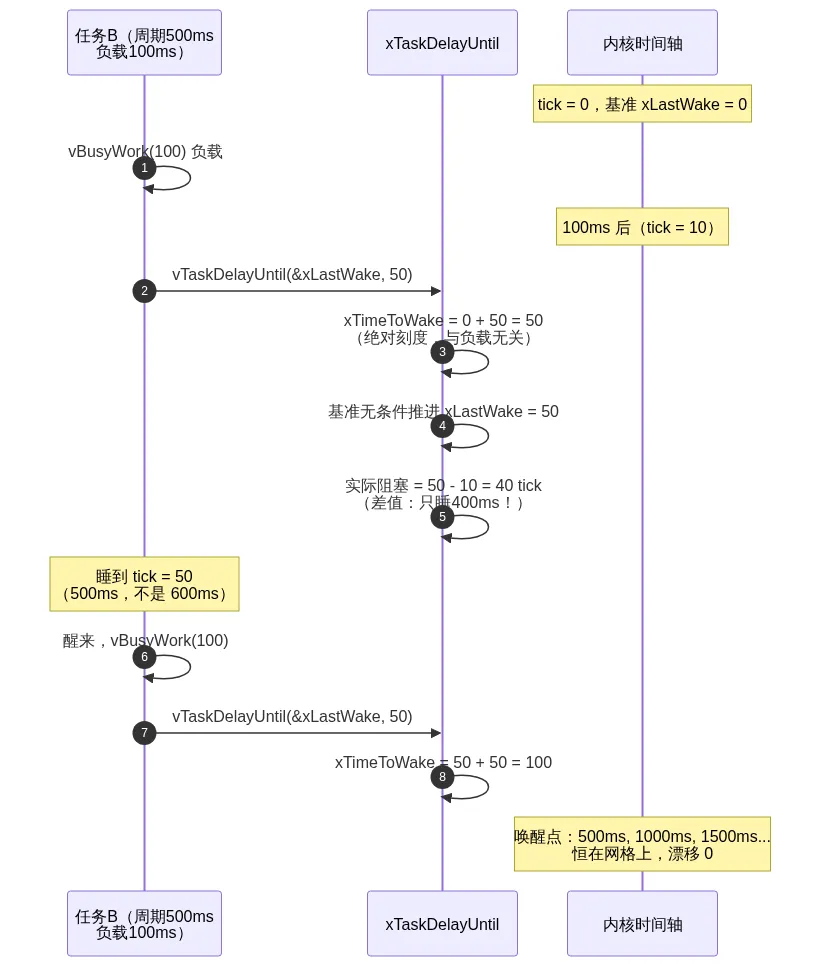
/* FreeRTOS/tasks.c */BaseType_t xTaskDelayUntil( TickType_t * const pxPreviousWakeTime,const TickType_t xTimeIncrement ){TickType_t xTimeToWake;BaseType_t xAlreadyYielded, xShouldDelay = pdFALSE;configASSERT( pxPreviousWakeTime );configASSERT( ( xTimeIncrement > 0U ) ); /* 周期必须 > 0 */vTaskSuspendAll();{const TickType_t xConstTickCount = xTickCount;/* ① 绝对刻度:目标唤醒时刻 = 上次基准 + 周期 */xTimeToWake = *pxPreviousWakeTime + xTimeIncrement;if( xConstTickCount < *pxPreviousWakeTime ){/* tick 已回绕而基准还没跟上 → 只有目标刻度也回绕且在未来才睡 */if( ( xTimeToWake < *pxPreviousWakeTime ) && ( xTimeToWake > xConstTickCount ) ){xShouldDelay = pdTRUE;}}else{/* ② 常规分支:目标刻度回绕了,或还在未来 → 睡 */if( ( xTimeToWake < *pxPreviousWakeTime ) || ( xTimeToWake > xConstTickCount ) ){xShouldDelay = pdTRUE;}}/* ③ 灵魂:基准无条件推进——不管这次睡没睡成 */*pxPreviousWakeTime = xTimeToWake;if( xShouldDelay != pdFALSE ){/* ④ 实际阻塞时长 = 目标刻度 - 现在(差值!) */prvAddCurrentTaskToDelayedList( xTimeToWake - xConstTickCount, pdFALSE );}}xAlreadyYielded = xTaskResumeAll();if( xAlreadyYielded == pdFALSE ){taskYIELD_WITHIN_API();}return xShouldDelay; /* pdFALSE = 丢拍:刻度已过,没睡就返回了 */}
四个关键行为:
- 基准无条件推进
(③):不管这次有没有真的睡, xLastWake都被推到下一刻度。所以周期计算与本次实际阻塞时长解耦——这就是"负载被吸收"的机制; - 实际阻塞时长是差值
(④): 目标刻度 - 当前tick。负载 100ms 后调用,只睡 400ms;负载 0 时睡满 500ms。同样的 API,睡的时间不同,醒的时刻相同; - 判断核心只有一条
(②):目标刻度还在未来才睡。等号不算—— xTimeToWake == xConstTickCount(恰好此刻到点)不睡,立即返回; - 返回值 xShouldDelay
:pdFALSE = 未睡——多数是刻度已过(丢拍),也可能是恰好踩点( xTimeToWake == xConstTickCount,判断用严格大于,等号不算,刚好到点就不用睡了,实际影响很小)。返回值不是让你忽略的(见第七节丢拍恢复)。
4.1 误差累积的数学本质
vTaskDelay: 第n圈起点 = Σ(负载i + x)—— 负载每圈全部进入时间轴,误差线性累积;vTaskDelayUntil: 第n圈起点 = 基准 + n×T—— 负载被xTimeToWake - xConstTickCount的差值逐圈扣除,唤醒点恒在 T 的整数倍网格上。
代价:负载持续 > 周期时,每圈 xTimeToWake 都在过去,xShouldDelay=pdFALSE,函数立即返回不睡,任务一直忙转、IDLE 被饿死——不存在"还清"这回事,丢拍本身不累积债务(基准已自动推进,只影响当前圈)。只有负载降回 < 周期,下一圈目标刻度才会重新出现在未来,恢复正常睡眠(详见第七节)。
五、谁叫醒你:xTaskIncrementTick 的唤醒路径
任务睡进延时链表后,叫醒它的是每个 tick 中断里的 xTaskIncrementTick()(SysTick 100Hz,10ms 一次):
/* FreeRTOS/tasks.c */BaseType_t xTaskIncrementTick(void){...xConstTickCount = xTickCount + 1;xTickCount = xConstTickCount;/* ① tick 回绕(0xFFFFFFFF → 0)→ 交换两条延时链表 */if( xConstTickCount == ( TickType_t ) 0U ){taskSWITCH_DELAYED_LISTS();}/* ② 没到下一个唤醒时刻 → 直接返回,连链表都不看 */if( xConstTickCount >= xNextTaskUnblockTime ){for( ; ; ){if( listLIST_IS_EMPTY( pxDelayedTaskList ) != pdFALSE ){xNextTaskUnblockTime = portMAX_DELAY; /* 链表空了,无限期休眠 */break;}/* ③ 链表头 = 最早该醒的任务(升序保证) */pxTCB = listGET_OWNER_OF_HEAD_ENTRY( pxDelayedTaskList );xItemValue = listGET_LIST_ITEM_VALUE( &( pxTCB->xStateListItem ) );if( xConstTickCount < xItemValue ){xNextTaskUnblockTime = xItemValue; /* ④ 还没到点:刷新缓存走人 */break;}/* ⑤ 到点了:从延时链表摘除(顺带从事件链表摘除) */listREMOVE_ITEM( &( pxTCB->xStateListItem ) );if( listLIST_ITEM_CONTAINER( &( pxTCB->xEventListItem ) ) != NULL ){listREMOVE_ITEM( &( pxTCB->xEventListItem ) );}prvAddTaskToReadyList( pxTCB ); /* 挂回就绪链表 *//* ⑥ 抢占开着且醒来的是高优先级 → 标记切换 */if( pxTCB->uxPriority > pxCurrentTCB->uxPriority ){xSwitchRequired = pdTRUE;}}}...return xSwitchRequired; /* 返回 true 则 PendSV 执行上下文切换 */}
三个设计精髓:
- 唤醒是"搬链表"不是"回调"
:不执行任务侧的任何代码——任务只是从延时链表摘下、挂回就绪链表,下次调度自然轮到它。延时到期不切换正在运行的高优先级任务(除非醒来的更高); - 升序链表 + 头部短路
(③④):一旦链表头任务的唤醒时刻还在未来,后面全在未来,循环立刻退出; - 缓存先行
(②):绝大多数 tick 里 xNextTaskUnblockTime还没到,O(1) 返回——100Hz 的心跳不因阻塞任务多而变贵。
这也解释了为什么裸机 Delay_us 改写 SysTick 会杀死所有 vTaskDelay:tick 停了,xTaskIncrementTick 不再执行,延时链表里的任务永远等不到第 ⑤ 步——不是死循环,是没人来叫醒(实测见关联踩坑文档)。
六、tick 溢出:两条链表的轮换
本工程 32 位 tick @ 100Hz,xTickCount 从 0 数到 0xFFFFFFFF 要 497 天——回绕是真的会发生的。内核的对策是"两条链表 + 到点交换":
/* FreeRTOS/tasks.c */#define taskSWITCH_DELAYED_LISTS() \do { \List_t * pxTemp; \configASSERT( ( listLIST_IS_EMPTY( pxDelayedTaskList ) ) ); \pxTemp = pxDelayedTaskList; \pxDelayedTaskList = pxOverflowDelayedTaskList; \pxOverflowDelayedTaskList = pxTemp; \} while( 0 )
插入时(第三节 ④⑤): xTimeToWake加法回绕(变小了)→ 挂溢出链表;否则挂当前链表;tick 回绕瞬间(第五节 ①):当前链表必然已空(所有唤醒时刻 ≤ 0xFFFFFFFF 的都到期了),整体交换——原溢出链表变成新的当前链表,周而复始; xTaskDelayUntil内部对基准跨回绕也做了完整分支(第四节 ①②的 if/else 就是干这个的)。
别自己造轮子:手工用 vTaskDelay(目标刻度 - xTaskGetTickCount()) 模拟绝对延时,回绕判断全要自己写,写错就是周期性抽风——这正是"用 vTaskDelayUntil"的第 497 天理由。
七、实测:相对 vs 绝对
两个任务做同一件事——"每 500ms 执行一次 100ms 真实负载",只差延时 API;数据来自串口 printf(USART1 @ 115200)。当前 main.c 已换为优先级反转实验,复现时用 7.1 代码替换任务创建即可。
7.1 实验代码
/* 方案A:vTaskDelay —— 相对延时,误差累积 */voidtask_delay(void *pvParameters){(void)pvParameters;uint32_t ulCnt = 0;TickType_t xCycleStart = xTaskGetTickCount(); /* 固定漂移基准,不重置! */TickType_t xLast = xTaskGetTickCount();for (;;){vBusyWork(100); /* 100ms 真实负载 */vTaskDelay(pdMS_TO_TICKS(500)); /* 相对:从"此刻"再等 500ms */TickType_t xNow = xTaskGetTickCount();ulCnt++;/* 累计漂移 = 实际唤醒时刻 - 理想时刻(起始 + 次数×周期) */int32_t lDrift = (int32_t)(xNow - xCycleStart)- (int32_t)pdMS_TO_TICKS(ulCnt * 500);printf("[A vTaskDelay ] #%u 周期=%ums 累计漂移=%dms\n",(unsigned)ulCnt,(unsigned)((xNow - xLast) * portTICK_PERIOD_MS),(int)(lDrift * portTICK_PERIOD_MS));xLast = xNow;}}/* 方案B:vTaskDelayUntil —— 绝对延时,节拍锁定 */voidtask_delay_until(void *pvParameters){(void)pvParameters;uint32_t ulCnt = 0;const TickType_t xPeriod = pdMS_TO_TICKS(500);TickType_t xCycleStart = xTaskGetTickCount(); /* 漂移基准(只用于打印) */TickType_t xLastWake = xTaskGetTickCount(); /* 节拍基准,由内核推进 */TickType_t xLast = xTaskGetTickCount();for (;;){vBusyWork(100); /* 同样 100ms 负载 */vTaskDelayUntil(&xLastWake, xPeriod); /* 绝对:睡到下一节拍点 */TickType_t xNow = xTaskGetTickCount();ulCnt++;int32_t lDrift = (int32_t)(xNow - xCycleStart)- (int32_t)pdMS_TO_TICKS(ulCnt * 500);printf("[B vTaskDelayUntil] #%u 周期=%ums 累计漂移=%dms\n",(unsigned)ulCnt,(unsigned)((xNow - xLast) * portTICK_PERIOD_MS),(int)(lDrift * portTICK_PERIOD_MS));xLast = xNow;}}/* main 中创建(栈 256 字:printf 栈开销大,128 字易触发栈溢出钩子) */xTaskCreate(task_delay, "delayA", 256, NULL, 1, NULL);xTaskCreate(task_delay_until,"delayB", 256, NULL, 1, NULL);vTaskStartScheduler();
实测结果(串口 printf 逐行整理;vBusyWork 分辨率 10ms,数据有 ±10ms 抖动,不影响结论):
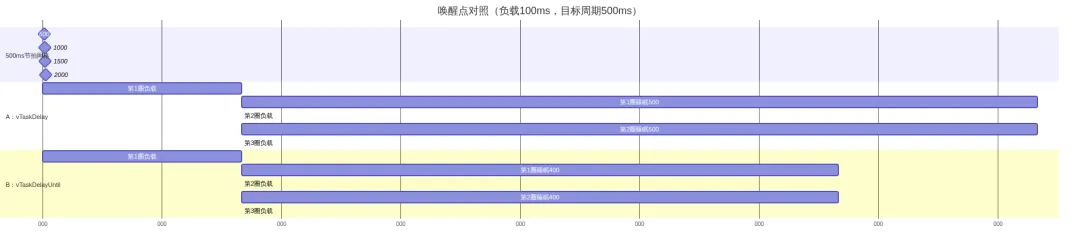
图中菱形是 500ms 节拍网格(理想唤醒点),——A 每次迟到且越迟越多,B 每次准点:
- 相对(A):以调用时刻为基准睡满 500ms,负载 100ms 顺延到下一圈——唤醒点 600/1200/1800...,总在菱形右侧且每圈多偏 100ms,误差累积;- 绝对(B):睡到刻度,负载被差值扣除(每圈只睡 400ms)——唤醒点 500/1000/1500...,始终压在菱形上。睡得更少,却醒得更准。
唯一前提:负载必须 < 周期。否则目标刻度永远在过去,函数立即返回不睡,任务忙转饿死 IDLE——此时返回 pdFALSE(丢拍,变得无意义)。
注意函数名的坑:vTaskDelayUntil 是丢弃返回值的宏,返回 void,不能跟 pdFALSE 比较(编译报错);要拿返回值必须用 xTaskDelayUntil:
/* 丢拍恢复:基准已落后现实,重置后重新锁定节拍 */if( xTaskDelayUntil( &xLastWake, xPeriod ) == pdFALSE ){xLastWake = xTaskGetTickCount();}
八、注意事项(踩坑清单)
uxSchedulerSuspended == 1U,外层已挂起则计数为 2,断言死机(本文第二节,卡死记录) | |
pdMS_TO_TICKS(x) | |
*pxPreviousWakeTime | |
xTimeIncrement > 0U,本工程直接死机 | |
周期 > 最坏执行时间 + 裕量(建议负载 ≤ 周期的 70~80%,剩余留给调度抖动和其他任务)。
九、时序图
9.1 vTaskDelay 全流程
9.2 vTaskDelayUntil:负载如何被吸收
十、总结
1. 两个 API 只差一个数:vTaskDelay 传"睡多久"(以调用时刻为基准,误差逐圈累积),vTaskDelayUntil 内部把"上次基准 + 周期"换算成"睡到何时"(基准无条件推进,实际阻塞取差值,负载被吸收);2. 阻塞任务的家在两条按唤醒时刻升序的延时链表里(正常轮 + 溢出轮,tick 回绕时整体交换), xNextTaskUnblockTime缓存让 tick 心脏绝大多数时候 O(1);3. 唤醒是"搬链表"不是"回调"——所以 tick 停了(裸机函数毁 SysTick)等于永远没人叫醒;负载必须 < 周期(建议 ≤ 70~80%)。偶发丢拍基准自动推进、无需干预;持续丢拍(连续 pdFALSE)时可重置基准恢复睡眠,但重置会改变节拍相位(详见第七节)。
— 写在最后 —
如果这篇文章对你有帮助,欢迎点赞、在看、转发三连支持,这是我持续更新的最大动力。
关注我,更多硬核技术剖析持续更新中,下一期再见。