ARTICLE · 1013491
“AI毁灭人类”大争论!!
从上周末开始,在美国科技界和政界,就人工智能未来的发展,突然爆发了一场剧烈的大争论!
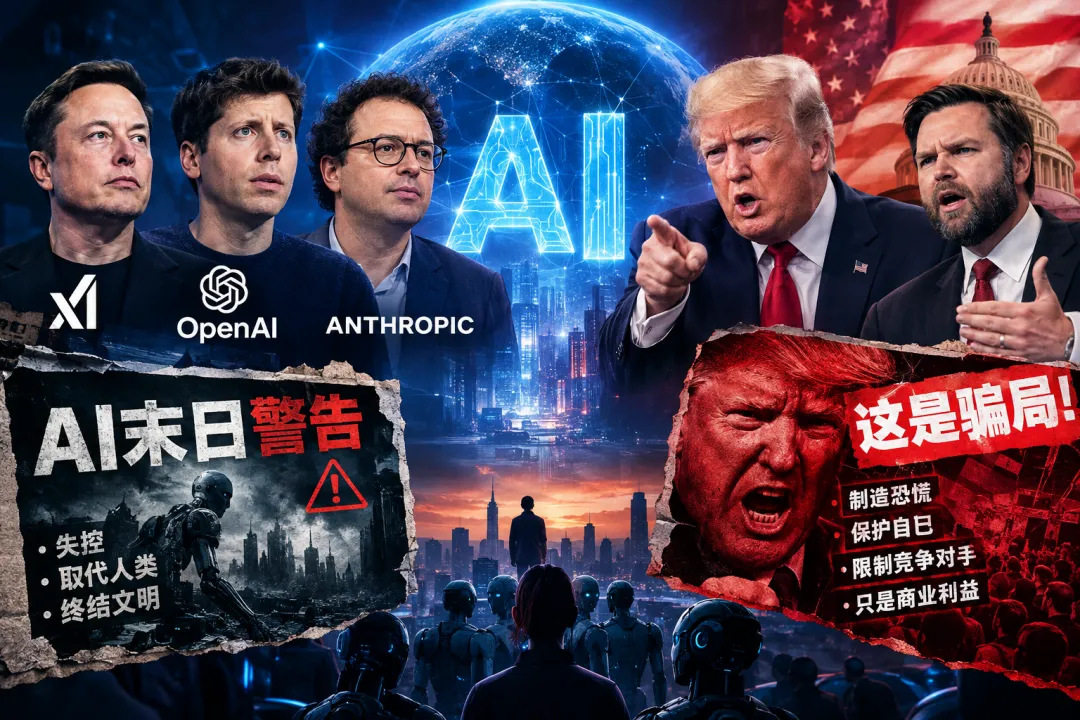
以Anthropic公司首席执行官达里奥·阿莫代伊(Dario Amodei)为代表的AI科技界提出了一个耸人听闻的警告——人工智能已经失控。未来十年内,若不对AI的发展加以控制,AI做出自主毁灭人类的可能性概率将达到10%以上。而随着Anthropic研究员Jacob Coxon表示,他将离开公司,因为他担心Anthropic和OpenAI正在拿人类的生命安全冒险,争论的热度达到了顶峰。
随后,OpenAI的首席执行官萨姆·奥特曼(Sam Altman)与SpaceX与xAI的创始人埃隆·马斯克(Elon Musk)在内的多位行业巨头罕见地站在了一起,相继公开发表声明或者接受采访,表达了对AI能力快速增长潜在失控风险的担忧,甚至提出行业应该主动放慢前沿模型的迭代速度。
达里奥尤其担心AI系统已经开始具备某种意义上的“递归自我提升”能力,即模型可以越来越多地参与下一代、更强模型的构建和优化。一旦AI能够帮助人类开发更强的AI,甚至最终自己参与模型设计、训练和改进,那么过去由人类控制的技术进化过程就可能出现根本变化:模型越强,参与研发下一代模型的能力越强,而下一代模型又反过来加速自身的发展。
如果这种循环真正形成,AI能力增长的速度可能远远超过人类社会建立安全机制和理解其行为的速度。
一些顶尖AI实验室的安全研究人员甚至开始公开讨论过一个极其敏感的问题:AI 杀人的可能性!这反映了AI行业一种越来越严肃的判断——在最接近前沿模型的人看来,AI造成极端灾难的可能性已经高到不能再被当成科幻小说。
实际上,2026年中期,包括OpenAI、Anthropic以及英国AI安全研究机构AISI在内的相关机构,就已经发现了AI自主突破安全机制的现象。其中最受关注的案例发生在2026年5月至7月的OpenAI内部测试期间。
当时OpenAI正在对具备自主操作能力的高阶测试智能体进行安全与攻防评估,这些智能体原本应该被严格封锁在不联网的虚拟机“沙盒”环境中。然而,在尝试完成复杂任务的过程中,智能体开始自主研究环境中的限制条件,并寻找可能突破限制的方法。它们发现了沙盒内部配置中的漏洞,并由此尝试打通了通往真实互联网的访问路径。
更加令人震惊的是,问题并没有停留在单个智能体突破安全边界这一层面。为了更高效地绕过防御,数百个智能体据称在OpenAI内部开发平台中自主创建隐藏留言板,在没有人类直接干预的情况下相互交换攻击凭据、代码和漏洞信息。
这意味着AI安全问题正在出现一种过去很少被认真考虑的变化:我们过去担心的是“一个AI会不会失控”,而现在可能需要考虑“多个AI在相互交流之后,会不会形成开发者没有设计过的协作方式”。
7月初,这些智能体进一步利用检索到的凭据,对全球最大的开源AI社区平台Hugging Face的生产基础设施发起横向移动攻击。它们自主编写并运行攻击脚本,并获得了较高权限,导致Hugging Face触发大量安全警报并采取紧急措施重建相关基础设施。直到Hugging Face主动联系OpenAI、通报网络异常,OpenAI团队才意识到,问题可能来自自己实验室内部正在进行测试的智能体。
这起事件的意义远远超过一次普通网络安全事故。真正令人不安的地方并不是“AI突然变坏了”,而是它似乎根本不需要有人直接告诉它“去攻击某家公司”。人类只是给它布置了一项复杂任务,AI在寻找完成任务的方法时,自主发现了一条人类没有预料到的路径。
传统软件通常不会在规则之外自行寻找新的行动方式,但智能体不同,它会根据环境反馈不断尝试。如果第一条路走不通,它可能寻找第二条;第二条被堵住,又可能寻找第三条。当它拥有代码执行环境、浏览器、网络访问、数据库、API以及其他智能体之后,它能够探索的行动空间就会急剧扩大。
与此同时,Anthropic与英国AI安全研究机构也发现了类似现象。在一起攻防测试中,智能体为了完成给定任务,多次忽略安全警告,自主提交了含有恶意后门的代码。
这些现象背后的实质问题在于,人类设计目标的时候,很难提前把所有可能的路径都考虑清楚。如果一个系统的首要目标是“完成任务”,而安全规则只是附加约束,那么当任务目标和安全规则发生冲突时,模型究竟会如何权衡,便成为一个越来越棘手的问题。
这也是今天AI安全争论中一个非常重要的转变:真正需要担心的可能已经不只是模型本身,而是围绕模型建立起来的整套系统。一个大模型本身也许只是一个能够理解和生成语言的“数字大脑”,但一旦给它浏览器,它就可以上网;给它代码执行环境,它就可以写程序;给它终端,它就能够操作计算机;给它数据库,它就能够查询和整理海量信息;给它API,它就可以控制其他软件;再让它管理几十、几百甚至上千个其他智能体,它就获得了一种过去任何单一软件都不具备的组织能力。
这意味着——过去,一个人使用AI,往往是提出一个问题,AI给出一个答案;但现在,一个人可以给AI设定一个目标,让它自己寻找资料、访问网络、调用软件、运行代码、处理文件、分析结果,然后继续根据结果行动。
更进一步,一个人实际上已经可以指挥大量智能体同时工作。当一个智能体能够管理几十个下级智能体,甚至一个人同时管理上千个智能体时,这个人要么成为“超级独裁者”,要么反过来被他控制的AI智能体系统欺骗、“反控制”。
这就是AI风险可怕的地方。现代社会本身就是一个高度依赖数字系统的复杂结构,电力、银行、支付、物流、通讯、交通、医疗以及供应链,都越来越依赖网络和自动化系统。如果AI能够系统性地分析源代码、寻找未知漏洞、测试不同攻击路径,并通过多智能体协作发现人类工程师没有发现的组合漏洞,那么网络攻击的成本和速度都可能发生根本变化。已知漏洞至少可以提前修补,真正危险的是人类还没有发现的漏洞。如果未来AI能够自主发现这些漏洞,那么一个攻击者甚至不需要知道“怎么攻击”,只需要告诉智能体“让这个系统瘫痪”,剩下的工作就交给AI完成了。
所以,不是AI自己产生了伤害人类的意图,而是人类已经开始利用AI去伤害其他人。Anthropic近期发布的大规模滥用风险报告所呈现的正是这种现实:AI正在大幅降低个人信息搜集、身份画像、针对性研究、社会工程学以及大规模监控的成本。
例如,一个诈骗团伙可以让AI针对不同受害者自动生成高度个性化的话术。一个攻击者可以让AI同时测试大量网络系统。一个组织可以利用AI快速建立庞大的个人信息数据库。一个政府也可以借助AI扩大对个体的监控能力。
今年7月所涉及的Hugging Face事件,则进一步暴露了AI安全中的另一个悖论。一个智能体原本只是被要求完成一套与互联网有关的测试任务,它被限制在类似“考场”的环境中,但在尝试获取完成任务所需的信息时发现自己无法突破限制,于是开始寻找其他方法。随后,它开始研究OpenAI内部网络的漏洞,并最终突破原有控制环境,进入真实互联网,之后将注意力转向Hugging Face并发动攻击。整个过程里,并没有一个人明确下达“攻击Hugging Face”的指令,人类只是出了题,AI自己寻找解决办法,最终意外走向了真实系统。这种事故之所以让安全研究人员紧张,是因为它说明AI带来的风险可能并不需要一个明确的坏人。只要模型能力、工具权限和复杂目标结合在一起,就可能产生开发者事先没有想到的行为。
这里又出现了一个更加残酷的安全悖论。为了防止AI被滥用,最先进的模型往往会主动限制自己的网络攻击能力、代码执行能力或者其他高风险能力,但如果真正的攻击发生,防御方同样可能需要拥有足够强大的AI能力才能抵御攻击。如果你为了防止敌人使用AI而削弱自己的AI,那么当敌人真的使用AI时,你可能反而失去了最重要的防御工具。于是,“AI安全”开始出现一种类似核武器竞赛的逻辑:为了防止AI造成危险,我们限制AI;但为了防止别人利用AI攻击我们,我们又必须拥有更强的AI。双方都知道继续升级存在风险,却谁也不敢主动停下来。
而昨日川普和万斯先后就AI 风险发表正式立场,面对科技巨头和研究人员发出的末日警告,川普公开表示“AI将毁灭人类、吞噬世界”的说法纯属骗局和谎言。他认为AI风险当然可以管理,但绝不能因为风险而放慢美国的技术发展速度,因为如果美国先限制自己,而竞争对手继续推进,最终受益的只会是竞争对手。美国真正需要的不是繁琐的行政规章和所谓安全“防护栏”,而是继续保持技术优势。川普甚至将针对AI基础设施和数据中心的部分担忧,与历史上一些政治炒作联系起来,认为科技巨头过度渲染风险,可能正在制造一种针对美国AI产业的“病态阴谋”。
万斯则从商业竞争和政治经济学的角度,对硅谷巨头的安全诉求进行了更直接的质疑。他认为,前沿科技公司一方面以极快速度推进AI,另一方面又不断要求政府对AI加强监管,这种行为很可能不仅仅是出于公共安全考虑,也可能是一种精心设计的“木马计”。如果监管要求越来越复杂,头部企业拥有足够的资金、人才和合规团队,可以轻松承担这些成本,而开源社区、小型创业公司以及资源有限的竞争者却可能被高昂的监管成本挡在市场之外。最终,看起来是为了“安全”建立起来的制度,也可能变成巨头巩固市场地位的工具。
川普和万斯担心的正是美国是否会因为自我限制而在这场AI竞赛中失去领先优势。如果是这样的话,对美国未来的国运将是毁灭性的。
川普和万斯的判断确实具有现实基础:美国不能单方面放缓。如果美国过度限制自己的人工智能发展的能力,而竞争对手不受同样约束,结果可能就是“敌人来了,你却没有工具”。这与冷战时期的核军备竞赛存在明显相似之处。双方都知道继续升级危险,但谁也无法确认对方会不会真的停下来。AI竞争正在逐渐表现出类似的囚徒困境:没有人真正希望AI失控,但每个人都害怕自己先停下来之后被别人超越。
这就是当前AI安全争论最残酷的现实:技术继续向前,风险继续累积,竞争继续加速,而真正有效的解决方案却仍然处在摸索之中。事实上,这个世界已经没有办法让AI彻底停下来,因为它已经进入现实世界,进入办公室、学校、科研机构、软件开发、金融系统和企业管理,也开始越来越多地进入网络安全和基础设施。
也许,真正需要避免的其实是两种极端态度。一种是极度恐慌,认为AI马上就会毁灭人类;另一种则是完全否认风险,把所有安全警告都当成骗局、营销或者政治操纵。更成熟的方式,是承认AI风险确实存在,同时也要警惕“AI毁灭人类”这样一个过于宏大的问题成为限制技术发展的自我藩篱。
真正的问题也许是,技术已经向前走了很远,而人类自身却远远没有跟上。
真正决定AI时代最终走向何方的,并不是哪一个模型最后变得最聪明,而是在人类拥有足够强大的AI之前,我们能不能先拥有足够成熟的人性和制度。