ARTICLE · 1014578
11种AI编程工具共用一套团队Skills:teamai-cli冲上GitHub热榜|海盗Sharp 深读 09-15
11种AI编程工具共用一套团队Skills:腾讯teamai-cli冲上GitHub热榜|海盗Sharp 深读 09-15
主题: 腾讯开源的 teamai-cli 把团队的 skills、rules、hooks、MCP 配置收进一个 Git 仓库,走 push→MR→评审→pull 分发给 11 种编程 Agent。同一天热榜上,另一个项目管的是 Agent 的权限。
今日看点: #AI编程 #Agent工程化 #团队知识沉淀
三周调教出来的东西,换台电脑就归零
你大概见过这个场面。一个人花三周把项目规范、测试跑法、踩过的坑写进自己的 CLAUDE.md 和几个 skill 文件,AI 终于肯按团队的方式干活。然后他旁边的人换了 Cursor,技能躺在另一套配置里;再然后有人换电脑、有人离职,半年的调教原地清零。「这个团队 AI 用得不错」,靠的一直是口口相传。
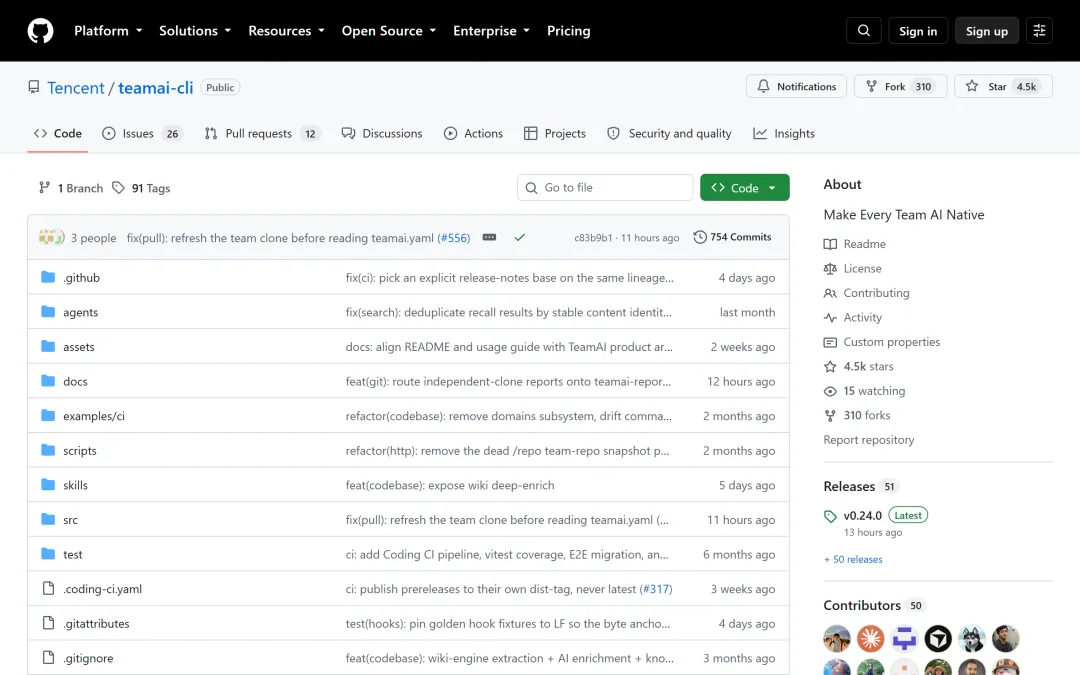
腾讯 4 月底在 GitHub 开放的 Tencent/teamai-cli 干的就是这件事。来龙去脉不长:前身是腾讯内部的 Team AI DevKit,内部代号 tad,走 TGit 给同事分发 skills 和 rules;4 月底以腾讯开源许可落到 GitHub 组织下。9 月第一周星标曲线一度近乎垂直,9 月 14 日冲上 GitHub Trending 日榜,当天新增星标 800 以上。npm 上 9 月 10 日到 14 日四天连发 7 个 beta,0.24.0 正式版 9 月 14 日落地,累计 61 个版本号。到 9 月 15 日中午,仓库 4512 星、310 个 fork。
团队的配置不存本地,存 Git 仓库
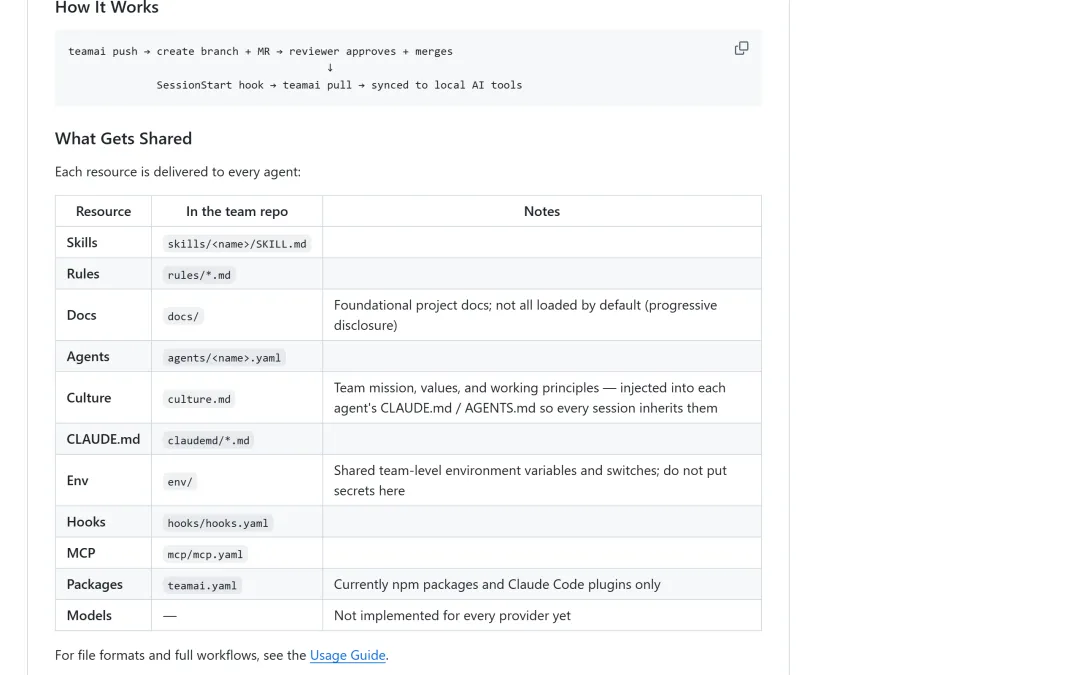
整个项目其实只有一个决定。技能放 skills/
适配范围铺得很宽,Claude Code、Codex、Cursor、CodeBuddy、WorkBuddy、OpenCode、OpenClaw、Hermes、DeepSeek Harness、Qoder、ZCode,一共 11 种。Git 平台是 GitHub、GitLab、GitCode、CNB、TGit 加私有 Git,后三个意味着它在设计时就把国内企业的代码托管环境和腾讯内部的 TGit 算了进去,这在国产大厂 CLI 里不常见。配置本身也被当成代码治:YAML 和 frontmatter 全过 Zod 校验,CI 跑 validate→build→e2e→publish 四段,错误在合并之前就被拦下。
用「今天纠正了几次 AI」给会话打分
beta 部分更有意思。它把团队协作切成三层:执行层铺规范,语境层让 Agent 干活前先查团队已知什么,改进层从执行里回收新经验。
语境层是这么运作的。会话结束时 Stop hook 给这次会话打一个「摩擦分」,看的是你打断了几次 AI、拒绝了几次工具调用。分数够高,它会提示你把这次的经验推进团队仓库。往后别人搜「端口冲突」这类词,底层用 BM25 加代码知识图谱重排;tree-sitter 把源码解析成组件和跨仓引用边,落在 teamwiki/ 目录。改进层是另一件事:digest 出周报,dashboard 开网页看板看团队成员的会话状态。这两块默认关闭,要显式打开。
它没打算让你换模型
这波趋势里最反直觉的地方在于,teamai-cli 从头到尾没碰模型。它的杠杆全在模型外面:配置怎么分发、经验怎么沉淀、会话怎么被观测。
这两天公开的两组数字,说的是同一件事。Scale AI 的 MCP-Atlas 基准测出,Agent 工具调用失败里有 63.3% 属于「认知失败」,典型形态是工具已经执行成功,Agent 自己却过早停下;微软研究院那篇智能体记忆论文则证明,在记忆写入之前加一道环境核对,CLBench 通过率能从 39% 拉到 73%。Agent 落地的瓶颈不在参数,在流程。
我更愿意把 teamai-cli 类比成十年前的「基础设施即代码」,而不是「又一个 AI 工具」。手工运维变成声明式仓库加评审流程之后,运维才第一次可审计、可回滚。现在轮到 prompt、skills、rules 了。省下的复制粘贴时间不重要,重要的是「团队 AI 能力」第一次变成能交接的东西。
同一张热榜上的另一件事
9 月 14 日冲上日榜的还有 CopilotKit 的 OpenBot,4890 星,8 月 17 日建仓。每个 AI 同事分到一台容器化电脑,浏览器、文件、MCP 动作先过一道 CEL 策略门,deny 优先于 allow,规则坏了宁可拒绝执行。一个管 Agent 带什么配置,一个管 Agent 能做什么动作,两件事加起来正好是 Agent 规模化之后缺的那层基础设施,而且都跟模型选型无关。
同一周,国内政策也指到了这里。工信部《「人工智能+软件」专项行动实施方案》定下 2028 年覆盖 2 万家规模以上软件企业、打造 100 个智能体软件标杆应用,其中两条举措跟今天的话题严丝合缝:「推动建设智能体软件应用商店和技能包(Skills)资源库」,以及「防范智能编程工具恶意指令注入等新型攻击」。
后面那条建议多读两遍。skills、hooks、MCP 配置从一个 Git 仓库自动分发进你每次会话,这个分发渠道本身就是注入面。一份语义模糊的 hooks.yaml、一个悄悄改掉行为的规则文件,换来的可能是你开发机上的执行权,而 PR 上的 reviewer 未必看得懂。评审是唯一的闸门,闸门却常常停在「看不懂就点合并」。这是流程自带的结构性漏洞。
谁该在意,在意什么
个人开发者最顺手的入口是单仓库模式 teamai init .,不建额外仓库、不注册账号,就能看清本地配置和团队配置差在哪;beta 能力默认关着,别一上来就开 recall,文档里写得不显眼,但本意是防止新人第一周被一屏历史决策淹没。
团队负责人面对的是流程问题。push→MR→评审→合并→自动 pull 这套能直接套进现有的代码门禁,teamai roles 支持角色到命名空间映射,前端只拿前端该用的 skills。真正要提前划界的是 dashboard,会话状态、干预率、prompt 数摆在同一张表上,它既是可观测性也是绩效面。
平台和工具建设者可以留意一个收敛信号:11 种 Agent 的适配点,最终被抽象成 skills、rules、docs、agents、hooks、mcp、env 七类资源加一份 culture.md。能被穷举,说明这层抽象接近定型,先标准化的人占住「团队 AI 配置」这个位置。
摩擦分我保留意见。拿「你纠正了几次 AI」当学习价值的代理指标,天然偏向挣扎过的会话,又长又顺的那种反而不触发;真被当成 KPI,团队会先学会关掉它,再学会制造摩擦。
真正要等时间回答的问题在更上游。团队的 AI 配置成了可评审、可回滚、也能被审计的仓库资产之后,「谁在审」和「审什么」就成了新的分界线。一个效率工具头一次长出管理属性,这大概才是 AI 进团队工作流的真实成本。
📊 今日互动
读完这篇,你最想让我深挖哪个点?留言告诉我,精选 3 条上下周推送
💬 你在用哪款 Coding Agent?踩过什么坑?评论区等你