ARTICLE · 1015053
【excel实战】从一串编码里截取组号,我用了一行公式
前几天处理一份分行业的失业统计数据,
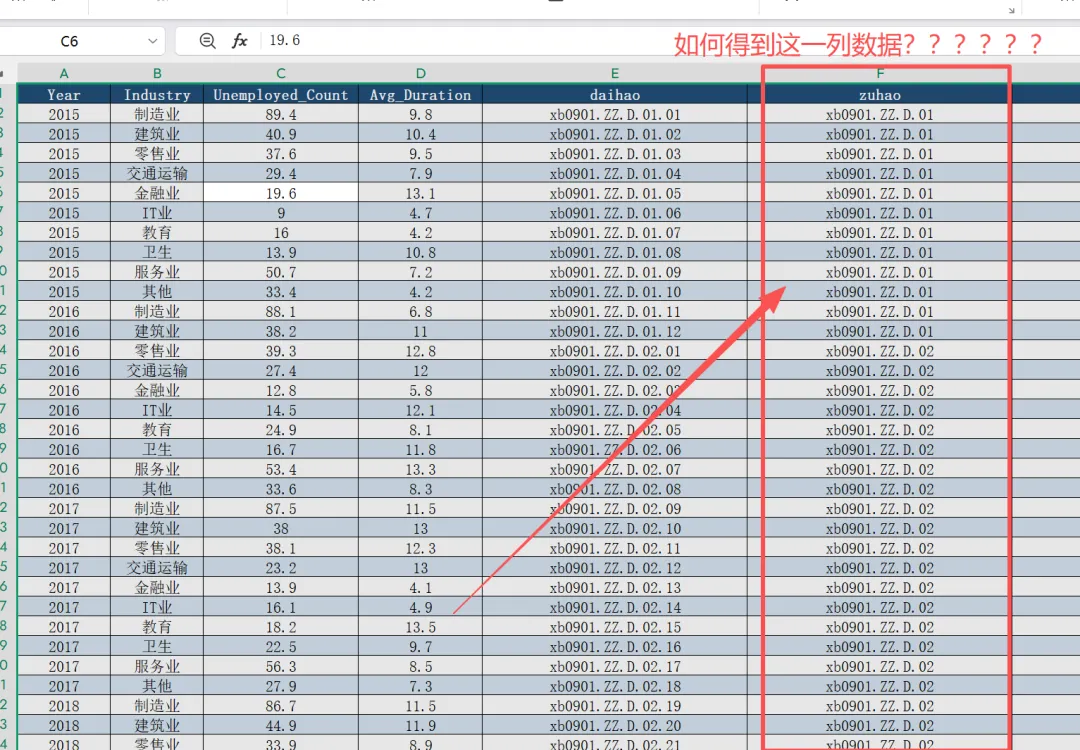
数据表长这样:
E 列是细分到每个行业的代号,F 列是组别的组号。现在要做的,就是从 E 列把 F 列“抠”出来——把 xb0901.ZZ.D.01.01 变成 xb0901.ZZ.D.01。复制处理太慢了,还容易错!
后来想起来新版本有个 TEXTBEFORE,试了一下:
=TEXTBEFORE(E2,".",-1)
回车下拉,完事。
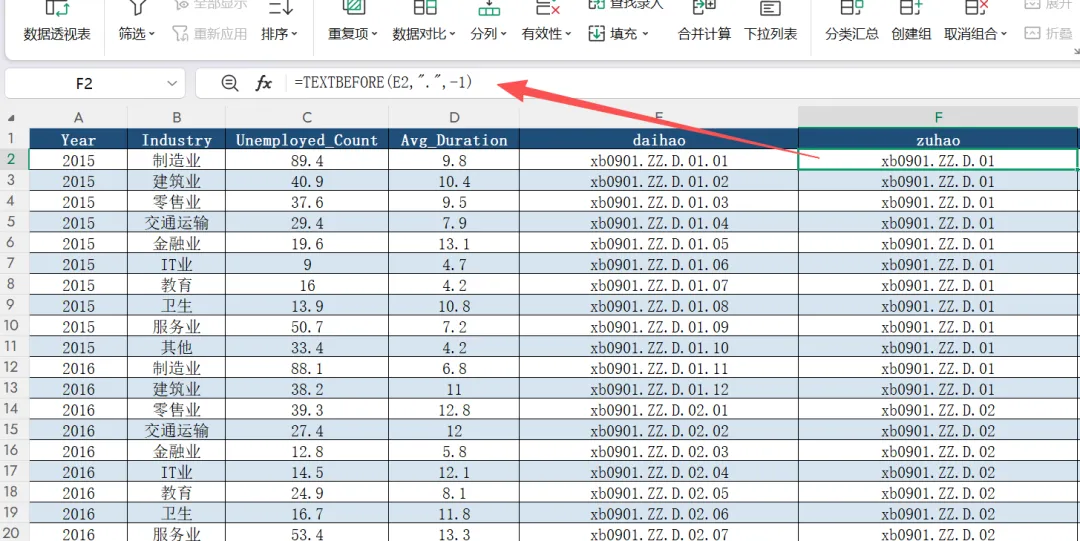
这个 -1 是关键
TEXTBEFORE 的语法很简单:TEXTBEFORE(文本, 分隔符, 第几处)。 前两个参数没什么好说的,重点是第三个。正数是从左往右数,负数是从右往左数。写 -1,意思就是“最后一个点前面的所有内容”。 比如 =TEXTBEFORE(E2,".",3) 会得到 xb0901.ZZ,是第 3 个点前面的部分。 那为什么这里要倒着数?因为编码前面那段 xb0901.ZZ.D 是固定的,但组号 .01、.02 一直往下排,从左边数第几个点根本说不准。从右边数就稳了,不管编码多长,永远砍掉最后一段就行。 如果反过来,想要最后那一段行业序号(01、02、03……),换个孪生函数就行:
=TEXTAFTER(E2,".",-1)
截出来干嘛用
组号提出来之后就能按组汇总了,比如:
=SUMIF(F:F,"xb0901.ZZ.D.01",C:C)
顺手看了眼这份 2015、2016 两年的数据,有几个地方值得留意: 两年的失业总人数是 339.9 万和 348.9 万,基本持平。制造业一直是失业人数最多的行业,接近 90 万,比第二名服务业高出一大截。更扎心的是平均失业时长,从 2015 年的 8.2 个月涨到了 2016 年的 10.2 个月——不是丢工作的人变多了,而是找到下一份工作的时间明显变长了。其中服务业(13.3 个月)和金融业(13.1 个月)找工作最慢,IT 业反而是平均 4.7 个月就再就业了,行业之间差距非常大。
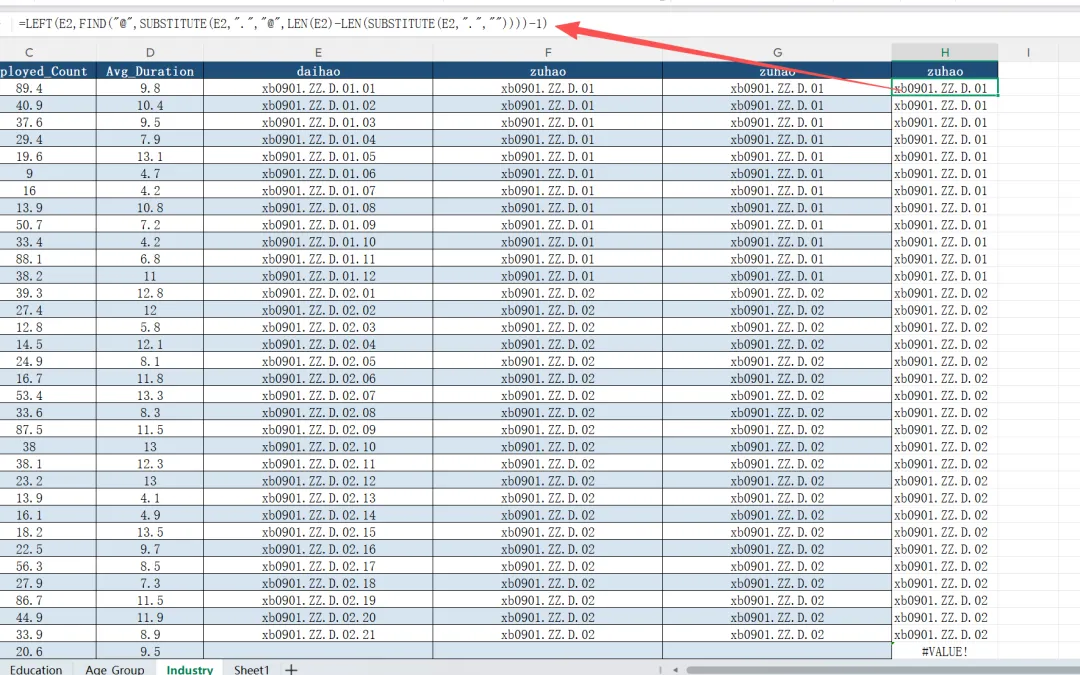
如果用的是office,也可以用下面公式:
公式(兼容所有Excel/WPS版本)
=LEFT(E2,FIND("@",SUBSTITUTE(E2,".","@",LEN(E2)-LEN(SUBSTITUTE(E2,".",""))))-1)
只加了 -1,代表不取那个小数点。
原理
SUBSTITUTE(A1,".","@",第几个点):把最后一个.替换成@FIND("@",...):得到最后一个.所在的位置序号-1:位置往前挪一位,舍弃最后的小数点LEFT截取前面文字
还有一种公式是:
公式(兼容所有Excel/WPS版本)
=LEFT(E2,FIND("~",SUBSTITUTE(E2,".","~",LEN(E2)-LEN(SUBSTITUTE(E2,".",""))))-1)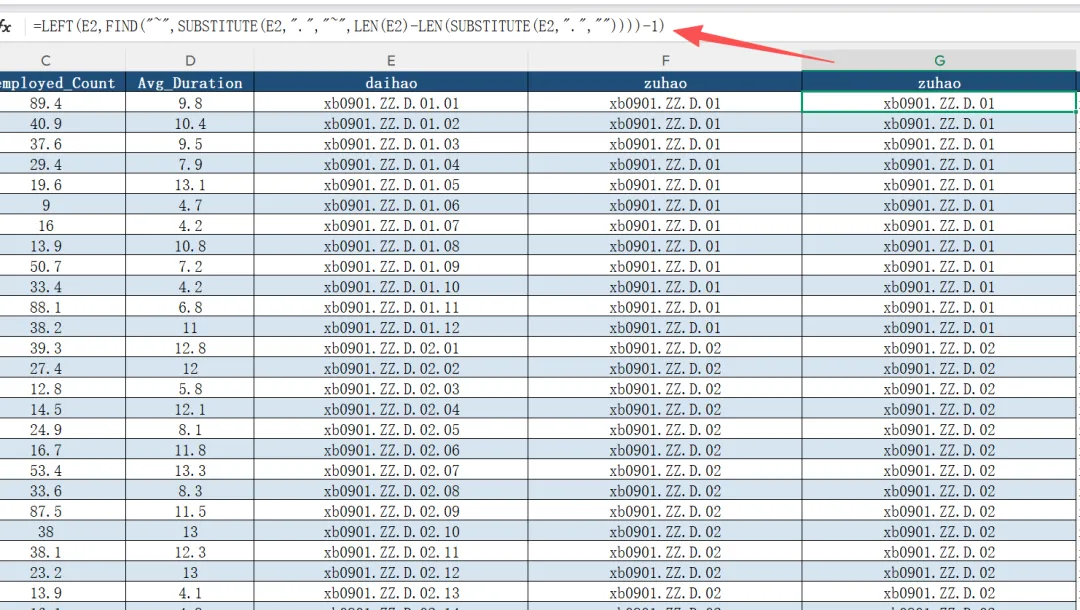
先说清楚:TEXTBEFORE 和 TEXTAFTER 是比较新的函数,Excel 365 / 2024 能用,WPS 要 15712 以上版本,两边用法完全一样,公式直接照抄。 WPS 版本太旧的话,在“帮助”里点“检查更新”升一下。实在升不了,就退回开头那串老公式凑合用——或者收藏这篇,等升了版再看。 就这些。一个参数,省掉一长串嵌套,这种函数多遇到几次,你会越来越喜欢它。
为了能随时获取最新动态,大家可以动动小手将公众号添加到“星标⭐”哦,点赞 + 关注,用时不迷路!!!!
关注公众号:IT小本本 👇