ARTICLE · 1015471
AI让科研更快之后 研究者的价值在哪里
准备这次《AI in Research》分享时,我最初想从具体的研究工作讲起:怎样查文献、写综述,怎样管理引用、编排论文,又怎样借助大模型写代码、做实验、表达研究成果。这些经验确实能够帮助刚进入研究领域的同学。
准备到后来,我越来越想把这次分享再往上推一层。工具越来越多,也越来越好用。当获取知识和实现想法都变得更快,我们更应该想清楚:究竟什么值得研究,又怎样判断自己做的是一项好的研究?
作为研究者,我愿意拥抱AI,学习新的方法和工具;也越来越在意,效率提升之后,我们能否对问题形成更深的理解。以下想讨论的,是这种变化对研究本身意味着什么,以及研究者可以怎样回应。
01
先回到科研本身:我们为什么要做研究?
我理解的科研,是一种遵循严谨逻辑、能够接受质疑与检验的探究活动。它的目的是创造新的知识,不断拓展已有认识的边界。我们提出问题、寻找证据,建立或修正解释,再将它与已有知识相互对照,检验它能否成立。
因此,一项研究的完成,除了意味着多了一篇文章,也应当意味着我们对某个问题有了更清楚的理解。一个新概念、一种新方法、一项可信的发现,或者对旧结论适用范围的修正,都可能增加知识。研究的形式可以不同,但需要说清楚,究竟在哪一点上推进了认识。
笼统地说,在经验研究中,我们经常接触定性和定量两种分析取向。定量方法帮助我们测量、比较和估计关系,定性方法帮助我们理解意义、过程、经验与情境。两者能够互为补充。当然,理论推演、数学证明和概念分析等研究,并不能被这两类方法完全概括。
这些年,数据获取的门槛在许多领域明显降低了。过去很难拿到的行为记录、交易信息或公开资料,现在可能已经能够通过数据库、平台和数字化系统获得。于是,某些原本主要依赖定性材料的问题,也有了开展定量分析的条件。一些研究者会自然地倾向于:既然可以量化,那就尽量量化。
数据更容易获取,并不意味着定性研究已经落后。在很多特别前沿的领域,数据依然极难获得,研究样本依然很少,连我们要测量的概念都可能尚未明确。这时,采访、深度访谈和观察能够提供重要材料,对文献和其他文本材料的逻辑梳理、批判性比较,也仍然不可缺少。
从整体把握一个问题,往往要先理解现象怎样发生、人们怎样解释自己的行动,以及这些解释之间有什么矛盾。文献梳理帮助我们澄清概念、辨认理论脉络;访谈和观察帮助我们了解研究对象的实际处境。文献综述本身也有不同做法,其研究性质取决于具体方法,不能一概归为定性研究。
即使数据已经很多,定性研究也有独立的价值。记录了某种行为,并不等于理解了当事人为什么这样行动;能够给现象编码,也不等于已经准确把握了这个现象的含义。定性研究可以帮助我们发现尚未进入数据库的问题,而定量研究又可以进一步检验某种解释在什么范围内成立。
开始一项研究时,可以采用定性方法、定量方法,或者混合方法。这取决于研究课题与问题。采用混合方法时,两类证据要形成联系:访谈可以帮助定义变量,统计结果也可能提出需要进一步访谈的问题。美国国立卫生研究院(NIH)的混合方法研究指南,也强调这种有目的的整合。参见NIH混合方法研究指南。
方法的选择,应该服务于我们真正想知道的事情。手头有了一组数据,我们还要检查,它是否包含了理解这个问题所需的信息。
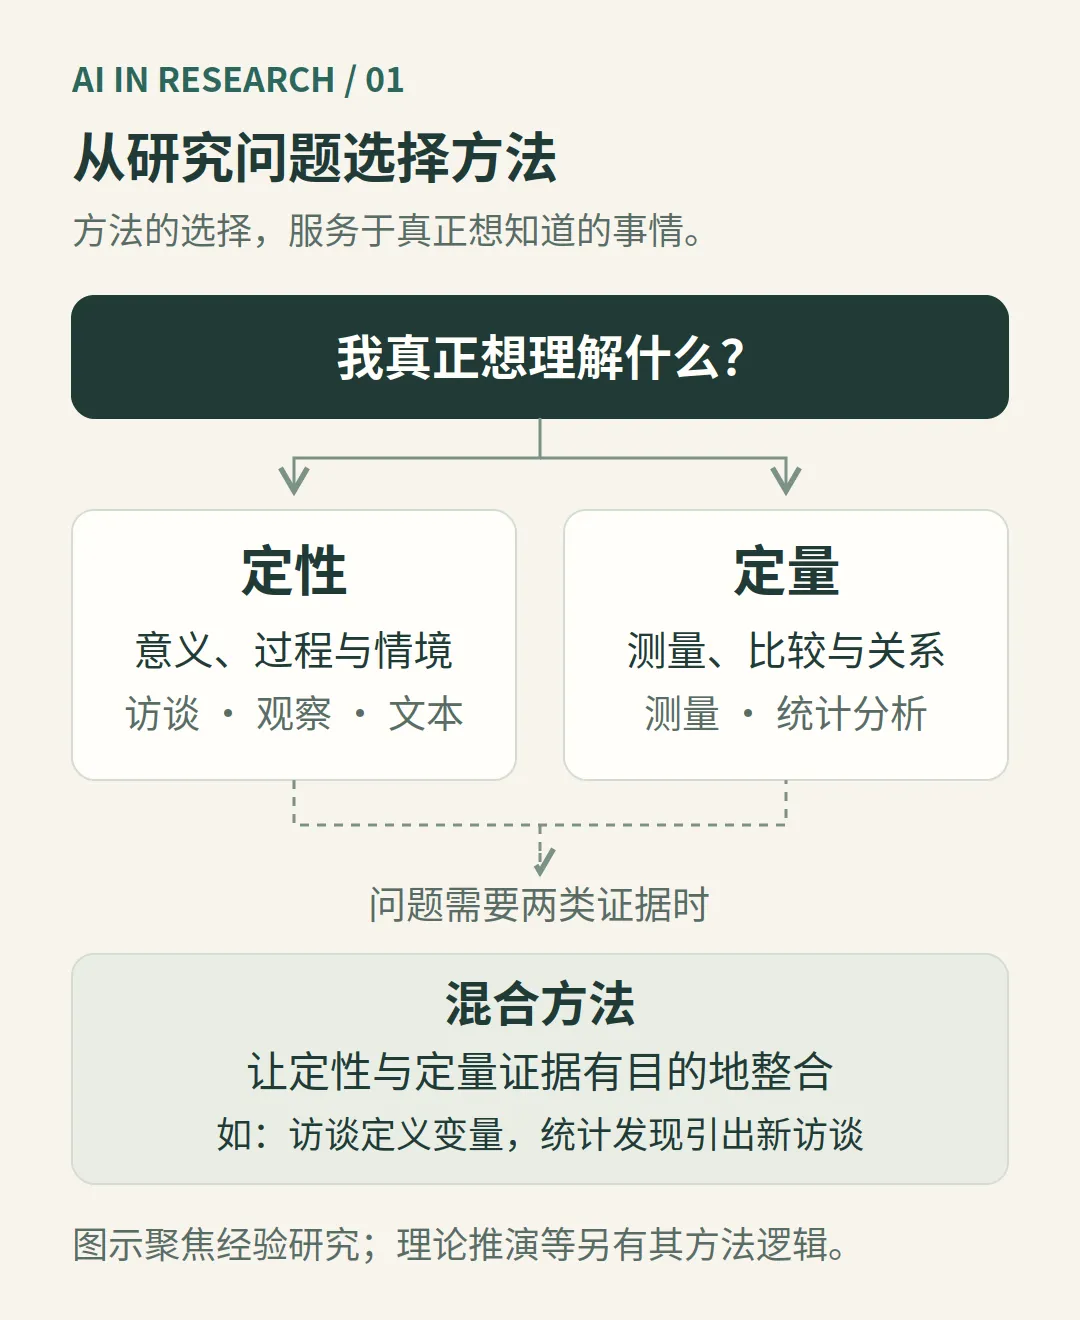
图1|从研究问题出发,理解定性、定量与混合方法的关系。
02
今天的变化,是知识获取与研究执行的成本正在下降。
这几年,生成式AI迅速进入研究工作,AGI,也就是通用人工智能,也成为频繁被讨论的话题。讨论AGI是否已经实现,要先说明采用的定义和判断标准。研究者已经能够直接感受到的,是工具越来越强,也越来越容易使用。
我常常想,今天的很多研究条件,可能是上一代研究者在求学时难以想象的。过去,为了完成一篇文献综述,有人需要跑几所学校、翻几个图书馆,才能找到想读的资料。我们今天习惯的下载,在当时可能意味着查目录、找馆藏、借阅和复印,一篇文献背后就有不少时间成本。
为了拿到一点实验数据,研究者可能要在简陋的场地中自己摸索,学习搭建实验环境,再一点点尝试。为了完成计算,又要在算力和存储都远逊于今天的计算机上,独自学习一门编程语言,想办法让程序跑起来。那些年,信息、知识和实施研究所需的条件,都可能很难获得。
今天,知识和信息大量涌现。对于检索能力和自学能力很强的人,过去由地域、学校或资源造成的许多学习壁垒正在被削弱。一根网线,就能让我们方便地接触顶尖专家和大学的课程。这种变化带来了机会,也提出了新的要求。
获取知识更方便之后,基础知识、实验设备、数据权限、实践经验和高质量反馈,仍然影响一个人能够走多远。信息越多,筛选也越重要:有些内容可靠,有些只是重复已有观点,还有些看起来很有说服力,却缺少依据。
这也给大学和教育界带来了一个核心挑战:课堂不再天然占据知识获取的中心位置。学生在课外也能找到优秀的讲解、案例和课程。课堂因此更需要帮助学生理解问题、获得反馈,并逐渐形成自己的思考方式。
03
工具已经进入研究的各个环节。
以自己的博士研究为例,我是这场变化的见证者,也是较早就开始拥抱GPT等大模型的年轻研究者。这些模型一直相伴其中。得益于软件工程背景和持续自学的习惯,我能够比较快地掌握不同的工具,并把它们用到自己的研究流程中。
这些工具覆盖了一项研究从阅读、实验到写作和表达的各个环节,可以分享的内容很具体。
先从Markdown和Typora讲起,再把Typora、Pandoc、Zotero配合起来,介绍怎样组织写作、管理文献、自动化引用,以及转换文档格式。整个流程可以涉及HTML、LaTeX、Word、PDF、Markdown、RTF、Wiki标记、纯文本,以及图像的导入、输出或识别。
这几个工具各有所长:Typora提供Markdown编辑环境,Pandoc承担多种文档格式转换,Zotero管理文献与引用。生成PDF通常还需要相应的渲染工具,图像或扫描件转成可编辑文本则涉及文字识别。复杂公式、图表和版式在转换后也要检查。尽管做不到任意文件之间无损互转,这套配合已经能减少大量重复操作。参见Pandoc官方说明及Zotero引用集成说明。
寻找文献时,我们会接触不同类型的渠道。Web of Science,简称WoS,以及Scopus,提供文献索引与引文信息,也能用于查看收录信息;Google Scholar帮助检索学术内容;ResearchGate则兼有研究交流与资料发现的作用。
获取文献全文,又会用到ScienceDirect、IEEE Xplore、ACM Digital Library,以及Springer/Springer Nature相关平台。它们背后的机构也不同:IEEE、ACM是专业学会;Springer Nature、Elsevier(爱思唯尔)和Wiley是学术出版机构,ScienceDirect是Elsevier旗下的平台。分清数据库、内容平台和出版机构,查找资料时就更有方向。
JCR,即Journal Citation Reports,可以用于了解期刊指标。收录情况和期刊分区提供了背景信息,单篇文章是否可靠,仍要通过阅读来判断。研究中的论证需要回到原始文献。
找到资料后,还要知道自己读的是什么。文献综述梳理既有研究、比较证据、辨认分歧,也可以通过新的综合形成贡献;研究性文章通常报告新的研究过程与结果。分清文章的任务,才能确定阅读重点,也才能更好地组织自己的写作。
基于已有研究开展的Meta分析,则要对适合合并的定量结果进行统计综合,考虑研究之间的可比性、差异与偏倚。它有具体的方法要求,不能仅凭模型对多篇文章的总结来完成。参见Cochrane关于Meta分析的方法说明。
在此基础上,可以利用SciSpace,结合GPT、Gemini等不断发展的前沿大模型,提高检索、阅读和梳理的效率,逐步完成一篇覆盖充分、结构清楚的文献综述。检索范围是否恰当、筛选过程是否清楚、证据是否经过核对,决定了这篇综述是否足够全面。
研究还需要被清楚地表达出来。我可以分享怎样更快地准备PPT、整理演示逻辑,以及完成科研绘图,把研究框架、实验结果或复杂关系讲清楚。图表既要易读,也要对应真实的数据与推理,让读者能够看懂研究究竟做了什么。
实验和开发也是我想分享的一部分。借助Codex等编程工具,可以加快实验设计的实现、分析代码的编写与调试,缩短从一个设想到取得实验结果的过程。这些结果要来自真实的数据处理与实验执行,研究者也要核验设计、代码和结论是否合理。
结合我的软件工程背景,这部分可以展开到C、Java、Python、R,以及SAS、Stata等统计软件环境,介绍它们各自适合做什么。也可以讲数据库知识,讲数据怎样存储、组织、查询和连接。理解这些基础,有助于我们看懂整个研究流程,并判断工具的输出是否符合预期。
借助Claude,还可以把一个想法更快地做成程序或者软件原型,再逐步完善功能。到了论文写作阶段,则可以讲怎样使用LaTeX,怎样在Overleaf中协作,把论文编排成结构清楚、版式美观的文稿。能够分享的工具和平台远不止这些,它们也会继续变化。
对于过去需要自行摸索这些流程的人,或者刚进入研究领域的新生,这些方法、技能和工具都非常重要。它们能减少很多无谓的试错,使一个人更快获得独立推进工作的能力。
我也理解,为什么很多人一开始会沉浸其中,甚至有些不能自拔。掌握一种语言、跑通一个模型、学会一套排版和引用流程,都能带来成就感。于是,人很容易把“我掌握了这些”理解成“我已经学会了读博士”。这些确实是研究训练的一部分。随着工作推进,我们还要学会评价自己做出来的东西。
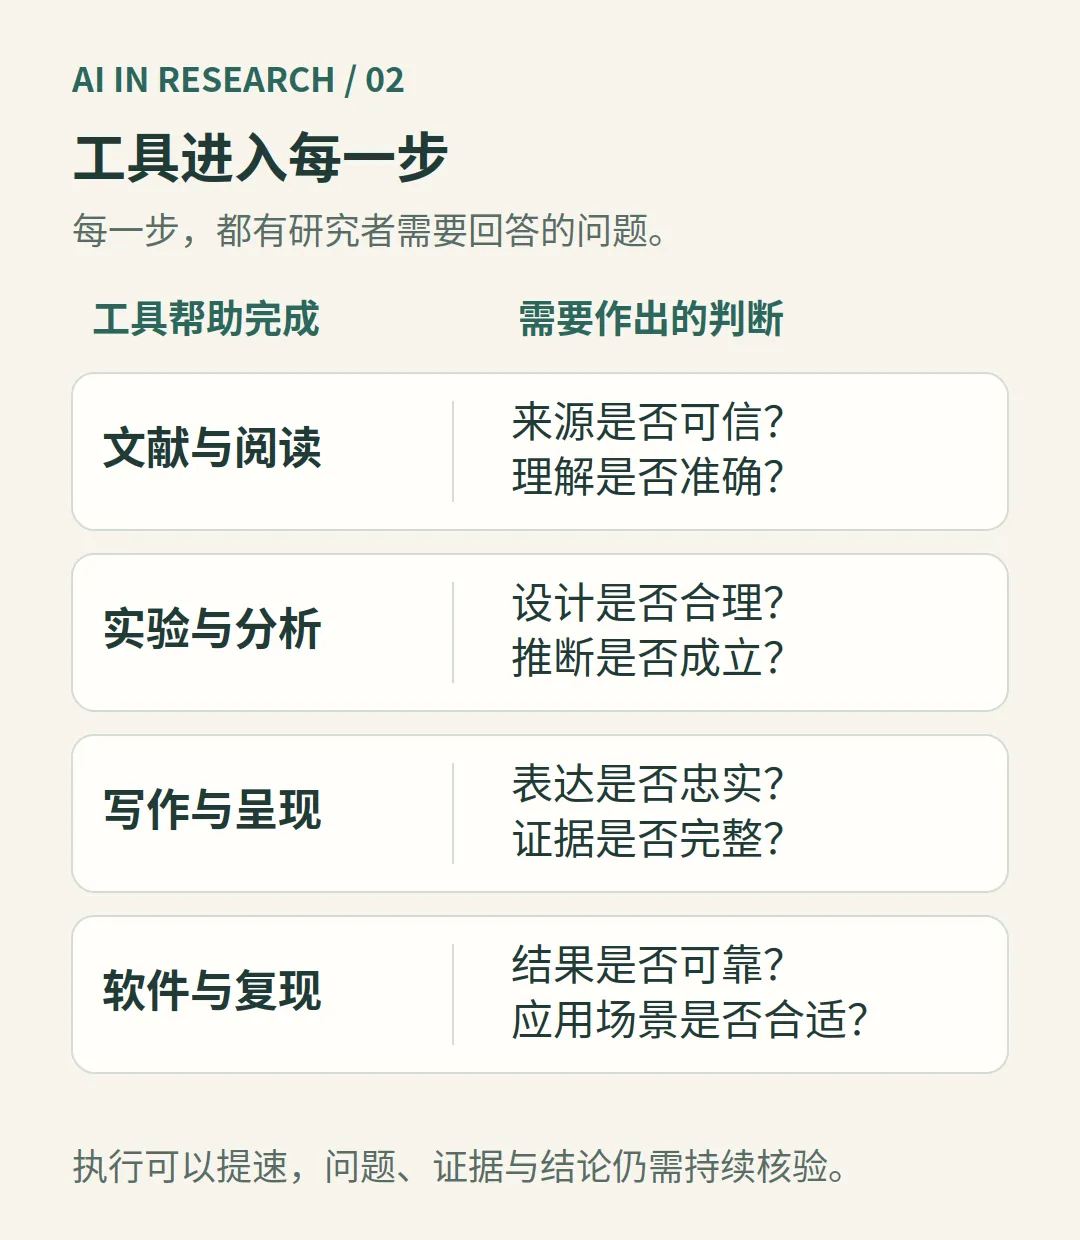
图2|研究的各个环节可以提速,每一步也都需要判断。
04
当研究已经能够顺利做出来,我们怎样判断它做得好不好?
判断一项科研工作是否优秀,影响因子、期刊分区、行业和同行评价都可以提供依据,却不能成为唯一的答案。
期刊指标受到学科、研究方向和引用习惯等因素影响,同行评价也受到具体学术共同体的影响。圈子、学术权威和商业出版机制,都值得纳入考虑。人们有时会用“学阀”这个尖锐的词批评权威垄断,追问评价权是否过度集中,以及哪些问题和声音能够被看见。
这些因素值得反思,但不能据此把所有同行评价都视为无效,也不能凭一个人的身份或所属圈子就否定其研究。对具体论文的判断,仍然需要回到问题、方法和证据。《旧金山科研评价宣言》,即DORA,也明确反对用期刊层面的指标代替对单篇研究贡献的评价。参见DORA宣言。
构思研究时,我经常会想到三个词:modify、extend、combine,也就是修改、扩展和组合。修改已有方法或解释,扩展其适用范围,或者结合不同的理论与方法,都是常见的研究路径。这是一个帮助产生想法的粗略框架,还不足以完整说明科研贡献。
沿着这些路径做出结果后,还要说明贡献在哪里。修改一个模型,是纠正了原有问题,还是仅仅换了一种实现?把方法扩展到新情境,是检验了新的边界条件,还是重复了已经清楚的结论?组合A和B,又增加了什么解释力,是否值得为此增加复杂度?
在一些以理论推进为重要目标的高水平期刊中,编辑和审稿人会格外关注理论贡献。我们是否修改了一个重要假设,解释了过去解释不了的现象,发现了某种机制,或者改变了原有理论的适用边界?这也是为什么研究者会感到,仅有一个新的结果,有时仍然不足以回应这类期刊的期待。
另一类贡献,通常被称为实证贡献。它可能提供新的事实,验证某种关系在具体环境中是否存在,或者检验一种方法在真实数据上的效果。这样的贡献很有价值,即使它没有直接推动一个理论体系发生变化。
理论与实证也会相互推动。一个反复出现的新事实,可能迫使我们修改理论;一项理论突破,也往往需要经验材料支持。不同学科与期刊的要求不同,因此,“好的期刊更重视理论”要放在具体领域中理解,不能据此把理论贡献一律排在实证贡献之上。
工业界则常常从另一组问题出发:这个发现能否带来可用的效果,能否解决真实业务中的困难,能否产生足够大的商业价值。对大量应用型研发而言,可靠的实证效果尤其重要。一个方法是否足够新,与它是否值得投入使用,有时是两回事。
在许多应用型岗位中,研究者并不直接承担最前沿、足以引领整个行业的基础突破。日常工作的很大一部分,是阅读和复现别人的论文(paper),理解方法为什么有效,找到适合的场景,再实现它的商业价值。这正是技术驱动的一条现实路径。做过业务的人通常会理解,一项成熟技术进入合适的场景,也可以产生很大的价值。
从复现到应用,还有数据适配、工程实现、业务验证和持续维护。工业界也会产生基础突破,学术界同样重视实际问题。不同工作推进知识和应用的方式不同,评价也应当与其任务相匹配。大量可靠的实证积累,还可能为后来“量变引起质变”的时刻提供条件。
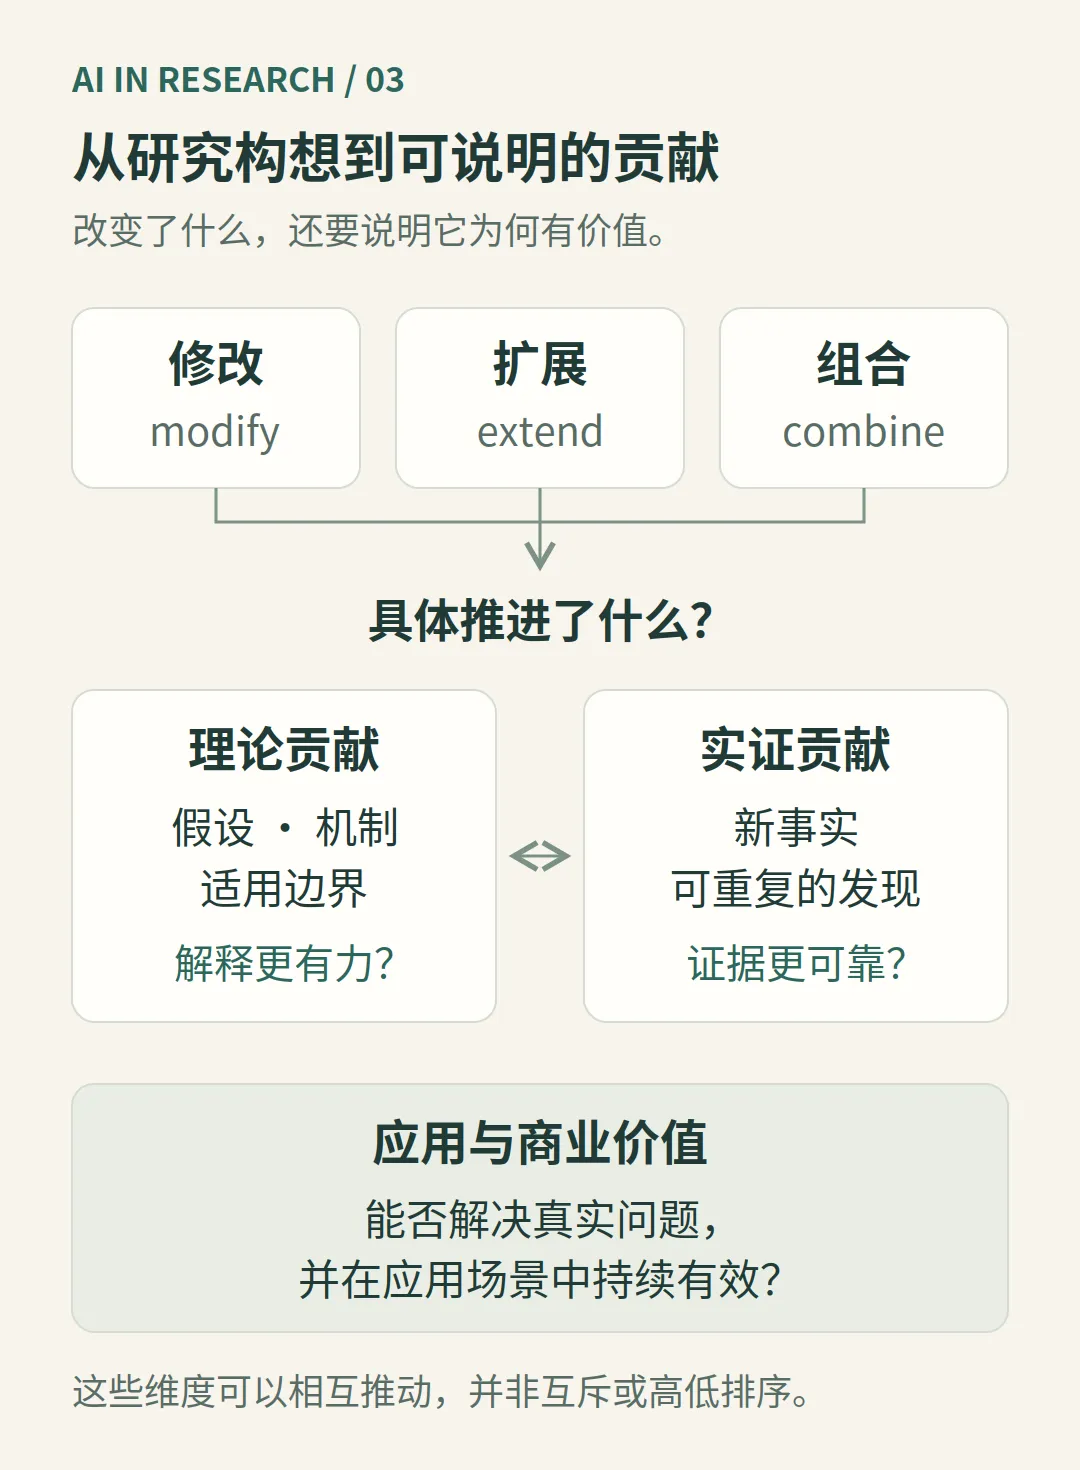
图3|构思路径需要转化为可以解释、检验和评价的贡献。
05
熟悉一个领域之后,研究构想会变多,筛选也就更重要。
等到我们熟悉一个领域,对其中的理论、方法,以及不同理论家族的谱系如数家珍,很多研究构想,也就是我们常说的idea,确实会水到渠成。知道一种理论在回应什么,了解它的假设与边界,再观察现实中尚未被解释的现象,就更容易看见新的研究入口。
与此同时,成熟的理论体系、优秀的实验室、稳定的数据与代码,也能够形成强大的组织化生产能力。学术共同体内部会出现不同的流派、团队,甚至是人们口中的“山头”。这样的组织可以积累知识、培养研究者,也可能逐渐形成自己的选题习惯和评价偏好。
如果把数量目标推到极端,可以设想这样的情形:一个资源充足、分工成熟的团队,将理论、变量、数据集、模型和应用场景排列组合,列出数千甚至数万个候选idea,再朝着一年几十篇、几百篇SCI论文的目标推进。这些数字用于描述一种极端设想,不代表所有实验室的实际产出。
科研中的一些调侃,正好道出了这种感觉:遇事不决,加点石墨烯;把A和B combine起来;把用在C上的方法搬到A;把ABC作各种“魔改”,再比较是不是比之前更好。这些做法本身未必有问题,关键是能否说清楚为什么这样改,具体解决了什么限制。
如果组合有机制上的理由,迁移揭示了新的边界,改进能够在充分、公平的比较下成立,那么这些工作就可能有意义。相反,如果只要结果稍好一点,就可以不再解释为什么有效、在哪些条件下有效,研究就容易停留在不断制造可发表差异的层面。
这种流水线感,容易让人联想到“论文工厂”。不过,在出版伦理语境中,paper mills特指制造稿件、出售署名等不诚信活动,不能用来指称合法而高产的实验室。我在这里反思的,是以发表数量为主要目标、逐渐模板化的研究组织方式。参见COPE与STM的论文工厂研究报告。
渐进研究仍然有重要价值。大量研究空白需要有人去填,已有结论需要被检验,各种方法需要在不同条件下比较。也许某一天,长期积累会为质的变化创造机会。要让积累有意义,就应当说清楚空白为什么值得填,并使结果可靠、能够相互连接。
在AI乃至我们所期待的AGI时代,这种产出能力还可能继续放大。生成候选idea、写代码、跑实验、制作图表和起草论文都越来越容易,一个研究者可以比过去更快地完成许多工作。
我担心的是,长期投入这样的流水线,科研会不会逐渐变成带有“体力劳动”意味的重复工作,挤占了深度思考的时间?我们忙着做实验、写文章,却越来越少停下来想:这个问题为什么重要,我究竟想理解什么?
长期如此,科研最初吸引我们的那部分乐趣,可能会慢慢消失。发现问题时的好奇,解释矛盾时的兴奋,终于想通一件事的满足,都可能被下一轮实验、下一篇文章和下一次投稿替代。工具本来能够省下时间,但省下来的时间,也可能被新的产出要求全部占满。
06
我因此越来越珍惜,围绕一个问题长期思考的时间。
回看那些令人着迷的idea和突破,我常会想到两种情形。一种是历史的机遇:一个领域积累了很久,技术、知识与条件终于成熟,恰好到了某个人这里,量变出现了质变。我们会半开玩笑地说,他似乎成了那个“天选之子”。
另一种,是一个人围绕某个问题沉寂思考了很多年,反复碰壁、修改理解,最终提出一种新颖的工具、方法或idea,并且把它实现出来。旁人看到的,可能只是最后那个突然出现的结果;真正支撑它的,却是长时间的阅读、尝试和打磨。
科学发现当然还有其他路径,这两种情形也常常交织在一起。历史机遇需要有人识别,长期思考依赖前人的积累与他人的合作。重要研究怎样发生,很难只用论文数量和固定周期来解释。
所以,我想说,好的科研需要“慢”的部分。我们要留出时间反复理解一个问题,让证据挑战自己的想法,也容许自己暂时没有答案。耗时长并不保证质量,但有些理解确实无法靠加快执行来获得。
工具使实验更快、资料更易得,这是好事。更理想的情况,是这些节省出来的时间,让研究者能够多读一点不同的解释,多想一想某个异常结果,多回到现实中观察。岁月的沉淀和持续的打磨,应该有机会进入我们的研究生活。
说到这里,有人可能会觉得,大家都是普通人,自己也不一定擅长深度思考;如果真正的研究最终依赖洞察力,那是不是又回到了天赋?我承认,研究需要一定的敏感性和创造力,人与人之间确实存在差异。
承认天赋的差异,也应当给训练留下空间。一个人今天还不善于提出问题,以后仍然可能进步。熟悉一个领域、辨认矛盾、比较解释、持续追问原因,都可以在工作中练习。研究训练,包括博士阶段的训练,都应当帮助我们逐渐获得独立思考的能力。
07
最近AI与数学界的争论,让这个问题变得格外具体。
2026年9月11日,陶哲轩在个人博客发布了一份声明,最初由25位菲尔兹奖得主联署。声明承认大模型在数学解题上的进步,也肯定AI能够帮助数学研究。它批评的是过度强调用数学解题来测试AI能力的取向,提醒人们关注理解、新概念与工具的发展,以及研究者的培养。参见陶哲轩发布的声明。
这让我想到,如果数学越来越被当成一项“暴力解题”的任务,我们会怎样理解数学本身?我用“暴力”比喻过度强调搜索、计算和答案产出的倾向。AI的解题当然可以包含有价值的推理,值得继续追问的是,这个答案是否带来了能够帮助后来研究的新理解。
数学家解决一个问题,可能同时创造新的工具、证明思路,或组织概念的方式。这些思想能够被后来者理解、使用和继续发展,从而支撑学科的发展。解题的价值,也体现在它留下了什么。
这也关系到研究者的培养。假如学生还没有形成自己的理解,就习惯直接取用模型的答案,会不会减少独立尝试和深度思考的机会?长期如此,是否会影响创造新工具、新方法的能力?这仍是有待研究的问题,却值得我们在享受工具便利时认真关注。
教育界对短视频与AI使用边界的讨论,也涉及注意力、判断和思考习惯的培养。具体措施各有对象和目的。例如,澳大利亚自2025年12月起,要求受规管平台防止16岁以下用户创建或保留账户,涉及TikTok、YouTube等平台。这项限制针对账户使用,并非禁止未成年人观看一切短视频。参见澳大利亚eSafety说明。
联合国教科文组织(UNESCO)也提出过AI独立使用的年龄边界和适龄教学设计建议。这些建议与各国或学校的禁用规定有所不同。对中小学生使用AI的限制,涉及隐私、安全与教育目标等多种考虑,既不等于全面否定AI,也不能直接证明AI会破坏深度思考。参见UNESCO教育与研究中的生成式AI指南。
对我而言,实际要解决的是怎样使用工具,既提高效率,也加深理解。重复排版和机械操作可以交给工具,概念、证据和推理上的困难,则值得我们亲自参与。可以请模型解释、质疑或提供不同思路,再回到原始资料中验证,让每次使用都包含自己的判断。
08
那么,怎样辨认一项研究的结论是否足够好?
对理解的重视,也应该体现在研究评价中。前面谈到期刊指标与科研贡献,现在可以进一步用几个问题,检查一项研究的结论建立在什么基础上。这些问题既适合读别人的文章,也适合检查自己的工作。
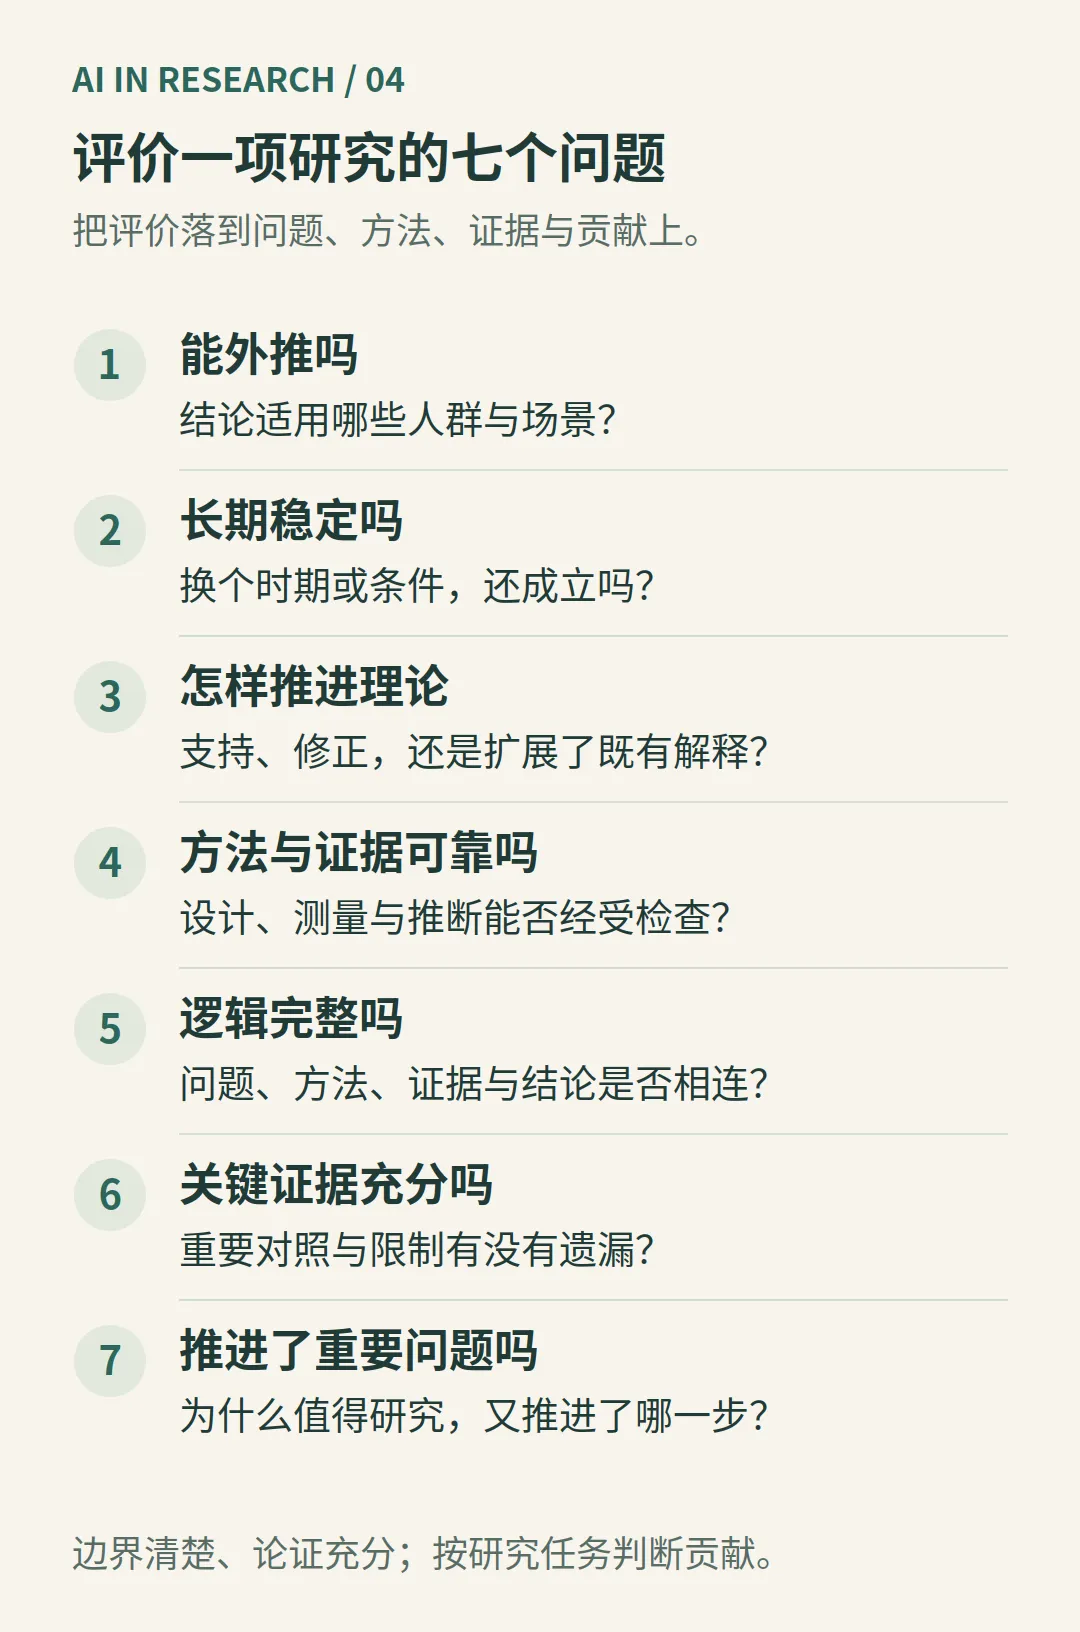
图4|评价一项研究时,可以追问的七个问题。
这个结论能外推吗? 它只适用于当前样本,还是能够推广到其他人群、地区或场景?如果要外推,还需要满足什么条件?有些研究追求的是对特定情境的深入理解,不必声称适用于所有地方,但需要清楚说明边界。
这个结论长期稳定吗? 换一个时期、环境或制度条件,它还成立吗?如果关系发生变化,这种变化是否揭示了重要的边界?稳定性需要结合对象判断,不能把所有具有情境性和时间性的发现都视为没有价值。
它对当前的理论家族产生了什么影响? 是支持了已有解释,修正了某个假设,扩展了适用范围,还是提出了一种值得比较的新解释?即使主要贡献是实证发现,也应当说清楚这个发现与既有知识有什么关系。
它可靠吗? 整个研究方法、实验设计和分析过程是否足以支撑结论?概念有没有被恰当测量,材料和样本怎样产生,比较是否公平,替代解释有没有得到处理,过程又能否被他人理解与检查?方法听起来先进,并不等于推断自然可靠。
逻辑叙事完整吗? 从研究问题、理论依据、方法设计,到证据与结论,各个环节是否能够连接起来?完整的叙事应当交代推断的理由,也如实呈现矛盾和不确定性。隐藏不一致的结果,反而会破坏这种完整性。
研究足够全面吗? 围绕核心主张,证据是否充分,关键的对照、解释和限制是否被考虑?全面程度应当由问题决定,重点是那些会实质影响结论的环节,是否还有遗漏。
它解决了一个核心问题吗? 这个问题为什么重要?即使研究没有完全解决它,是否推进了关键的一步,排除了某种解释,或者揭示了此前忽视的困难?一个研究可以诚实地留下问题,同时仍然作出有价值的贡献。
带着这些问题读文章,影响因子和分区仍然可以提供背景信息,我们也能够形成更具体的判断:研究好在哪里,还有什么没有解决,各自的理由是什么。
09
研究者的长期价值,体现在怎样观察和理解世界。
前几天,我在审阅(review)一篇有关信用评估的文章时,又想起了这一点。信用评估是金融领域一个重要的问题,很多研究聚焦于怎样使用数据、建立模型和改进预测。这些定量问题本身就有很多挑战。
继续追问,信用评估也涉及社会学和制度层面的问题。我们怎样定义“信用”,数据中记录了哪些人,借款人的行为发生在怎样的处境中,都会影响我们的理解。同一个问题,可以同时具有数学和社会的复杂性。对理论与现实理解得更深,眼前的问题也会呈现出更多层次。
我有时会开玩笑,说自己想做一个“被知识诅咒的人”。知识多了,很多原本理所当然的事情,就再也没有那么简单。我们开始注意概念背后的假设,追问现象的原因,也看见自己尚未理解的部分。
这个比喻想表达的,是知识带来的敏感性。当然,我也希望自己保持开放,避免被熟悉的理论束缚。知道得更多以后,仍然愿意承认不知道,愿意在新证据面前改变看法,这种状态尤其可贵。
对一个研究者而言,长期积累下来的价值,很难用掌握了多少工具、记住了多少知识,或者熟悉了多少套方法流程来衡量。博士阶段的训练也一样,最值钱的东西需要放在更长的时间中理解。方法论素养当然重要;当它真正进入一个人的思考习惯,也就体现在他怎样提出问题、分析矛盾和形成自己的判断之中。
这种进阶也会延伸到哲学,延伸到我们怎样理解这个世界。什么可以算作证据,怎样的理由足以支持一个判断,人怎样行动,技术和制度又怎样改变人的处境?这些问题未必马上形成一篇论文,却可能逐渐改变我们选择研究方向的方式。
能够精准识别一个重要问题(issue),看见具有研究前景的方向,再持续投入思考和验证,是很有价值的能力。时间会让知识、经验、失败后的修正和对现实的观察,逐渐汇入一个人的判断,形成属于他自己的价值。
我仍然愿意学习新工具,也愿意分享怎样更快地完成文献、实验、绘图、写作和软件开发。与此同时,我希望AI为我们省下来的时间,能够让我们多一些机会思考:我真正想理解的是什么,这个问题为什么值得研究,我又能够为它增加什么新的认识。
几年之后,工具也许已经换了许多轮。如果我们仍能独立提出值得研究的问题,为判断提供理由,并不断深化对这个世界的理解,我们就在持续创造属于研究者的价值。
资料来源
01 · NIH|混合方法研究指南
https://obssr.od.nih.gov/sites/obssr/files/Best_Practices_for_Mixed_Methods_Research.pdf
02 · Pandoc|文档格式转换官方说明
https://pandoc.org/
03 · Zotero|文字处理软件引用集成
https://www.zotero.org/support/word_processor_integration
04 · Cochrane|Meta分析方法说明
https://www.cochrane.org/authors/handbooks-and-manuals/handbook/current/chapter-10
05 · DORA|旧金山科研评价宣言
https://sfdora.org/read/
06 · COPE与STM|Paper mills研究报告
https://members.publicationethics.org/sites/default/files/paper-mills-cope-stm-research-report.pdf
07 · 陶哲轩|AI与数学研究的联署声明
https://terrytao.wordpress.com/2026/09/11/a-severe-misalignment-of-ai-in-mathematics/
08 · 澳大利亚eSafety|社交媒体年龄限制说明
https://www.esafety.gov.au/about-us/industry-regulation/social-media-age-restrictions
09 · UNESCO|教育与研究中的生成式AI指南
https://www.unesco.org/en/articles/guidance-generative-ai-education-and-research