ARTICLE · 1016052
vivo AI Lab智能体工具调用:4B模型用1.1万条合成数据做到86.40%
论文基本信息
标题术语:工具闭环框架(ToolLoop)、闭环方法(Closed-Loop)
工具使用技术(Tool-Use)、动态自反馈方法(Self-Feedback)
原文标题:ToolLoop: Closed-Loop Tool-Use Data Synthesis via
Decomposed Generation and Dynamic Self-Feedback
主要单位:vivo AI Lab
首次公开:2026年9月8日
原论文:https://arxiv.org/abs/2609.09072
龙哥导读
训练智能体学会调用工具,难点不只是“多造数据”,而是让用户问题、目标工具和参数三者真的对得上。ToolLoop把一次性生成改成逐段检查、逐段返工:用1.1万条合成样本训练4B模型,在伯克利函数调用榜单拿到86.40%,隔离重叠函数后仍有86.07%。更值得看的,是它把预算花在修错上,而不是把整条样本扔掉重来。
假设你对智能体说:“查一下上海和深圳的天气,再把结果换算成适合出差准备的建议。”模型要做的并不是写一段顺口的话。它得先从一堆长得很像的工具里选对函数,再填对城市、单位等参数,还要判断两次查询能否并行执行。任何一步错了,最终回复可能依旧很像人话,却根本跑不起来。
这正是工具调用数据最麻烦的地方:自然语言“看起来合理”,不等于调用链在逻辑和格式上都成立。过去常见做法是先让大模型整条生成,再用规则或另一个模型筛掉坏样本。它像工厂在成品下线后才抽检,发现螺丝装错,就把整台机器报废。
ToolLoop提出的反转很朴素:别等到最后才判死刑。把制造过程拆成三道工序,每道工序都检查;发现哪里错,就把具体问题退回那一步重做。这不是给模型多讲大道理,而是把“错误发生在哪里”变成可操作的信息。
一、工具调用数据为什么比普通问答更难
普通问答数据通常是一问一答。只要答案大体正确、语言通顺,它就可能有训练价值。工具调用则至少同时约束四件事:用户真正想做什么、候选工具里该选哪一个、参数如何填写、多个调用之间是什么关系。四者必须咬合,不能各自“差不多”。
例如用户说“比较北京和杭州的空气质量”,候选列表里同时有天气、空气质量、城市搜索和历史统计函数。选错工具是语义错误;把“杭州”填进经纬度字段是参数错误;只调用一次是基数错误;先查北京、等结果回来再查杭州,则可能把本可并行的任务写成无谓串行。
更棘手的是,坏样本经常“局部正确”。问题写得自然,工具名字也真实,参数格式也像样,可它们拼在一起并不一致。单看每一块都挑不出大毛病,训练后却会把模型教成一个很会装懂的执行者:语气坚定,动作跑偏。
论文把旧路线概括为“生成—过滤”。完整样本一次成型,随后由规则或模型做静态验收。通过就留下,不通过就丢弃。这种方式简单,但有三个代价:复杂工具组合很难一次写对;过滤器只说“错了”却不告诉生成器怎么改;长期丢弃某类难样本,还会让数据分布越来越偏向容易案例。
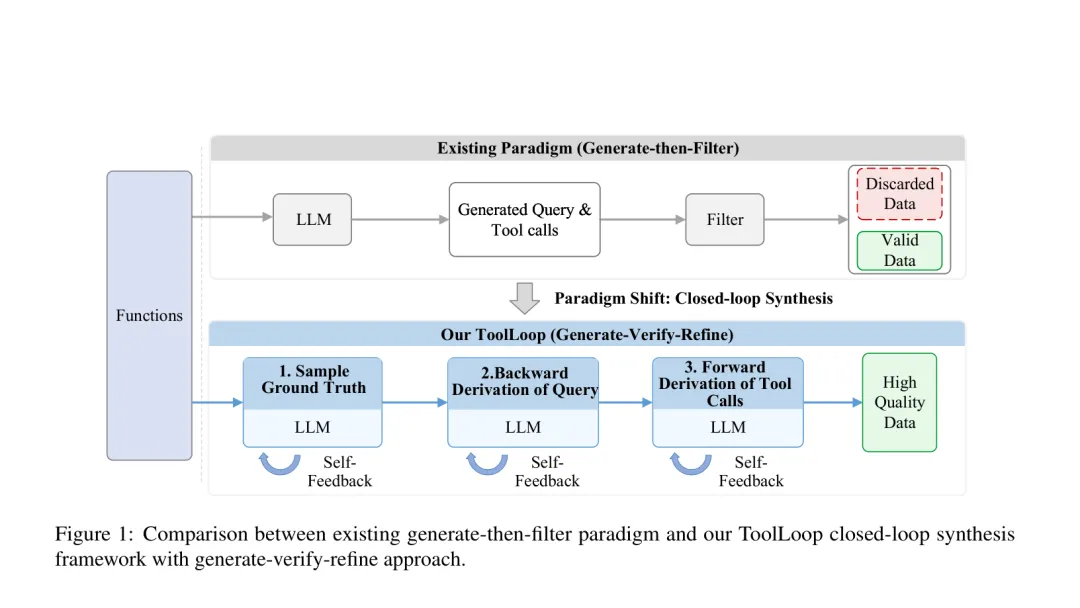
图1|上半部分是传统“整条生成后过滤”:坏数据直接进入丢弃分支。下半部分把流程改成采样目标、反推问题、生成调用三段,每段下方都有反馈回路,最终才汇入高质量数据。来源:ToolLoop论文图1。
看图1最重要的不是多了三个框,而是箭头方向变了。旧流程只有一条向前的流水线,过滤器位于末端;ToolLoop在每个阶段下方都放了回路。于是“失败”不再只是删除理由,而成为下一次生成的修改说明。
这和写代码很像。编译器若只说“程序失败”,你可能整段重写;若指出第37行类型不匹配,修复成本会小得多。ToolLoop就是给每道中间结果配上更细的“报错信息”。
二、先定答案,再反推问题:三阶段生成到底怎么走
ToolLoop覆盖四类单轮函数调用场景。第一类是简单调用:只给一个函数,也只调用一次。第二类是多选一:候选函数很多,但只有一个真正匹配。第三类是并行调用:同一个函数要针对多个对象独立执行。第四类是并行多工具:既要从多个候选中挑出正确工具,又可能多次并行调用。
团队从既有工具数据和伯克利函数调用榜单中整理出5281个可执行工具,再把工具描述编码成向量,用聚类分成26个语义组,每组约200个。这样能让候选工具彼此相似,迫使模型认真分辨用途和参数。
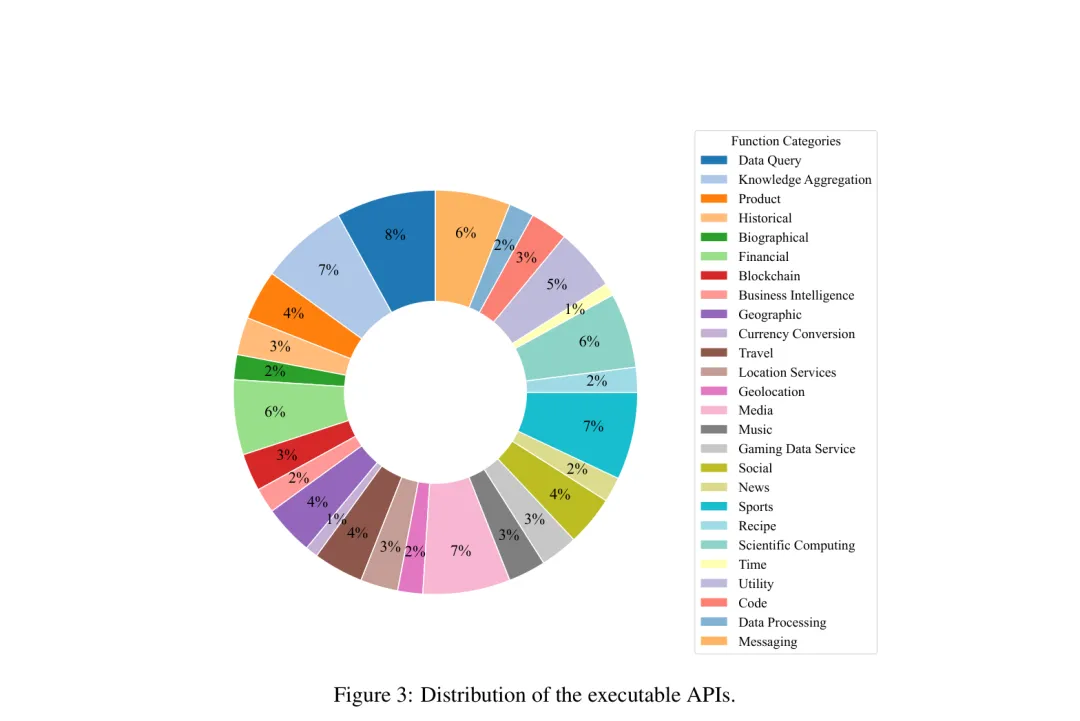
图2|工具池覆盖数据查询、知识聚合、产品、历史、生物、金融等多类用途。不同扇区说明候选函数并非集中于单一领域,聚类后的同类工具会构成更有迷惑性的选择题。来源:ToolLoop论文图3。
第一阶段:采样目标函数名组合。这里先决定正确答案应调用哪些函数。简单和多选一场景可以随机挑目标函数;并行场景则由模型从候选集合中选出能够在同一情境下独立执行的2到4次调用。检查重点包括:这些调用能否并行、组合是否形成合理任务、调用数量是否符合场景。
为什么第一步不直接写用户问题?因为先写问题,模型很容易顺着语言惯性随便挑工具;先固定函数组合,相当于先确定“这道题要考什么”,再去设计题面。目标从隐含变量变成显式真值,后面两步都有了参照物。
第二阶段:反向推导用户查询。系统拿着目标函数及相关说明,要求模型写出一个自然问题,使它确实需要这些工具才能完成。查询既不能直接念出函数名,也不能漏掉必需参数,更不能额外暗示目标集合之外的工具。
这一段最考验语义对齐。符号化的函数计划要被翻译成自然语言,稍微写得含糊,后续调用就可能出现多个合理答案。论文数据显示,第二阶段需要返工的比例最高:18.1%的样本至少重试一次。这说明“把确定的工具计划写成恰到好处的人类请求”,比把请求再翻译成结构化调用更容易出错。
第三阶段:正向生成工具调用。系统根据用户问题和候选函数,输出具体函数名及参数。语义验证器判断调用是否真的满足请求;确定性规则检查字段、数据类型和结构;抽象语法树解析则负责抓出会在执行时直接报错的语法问题。
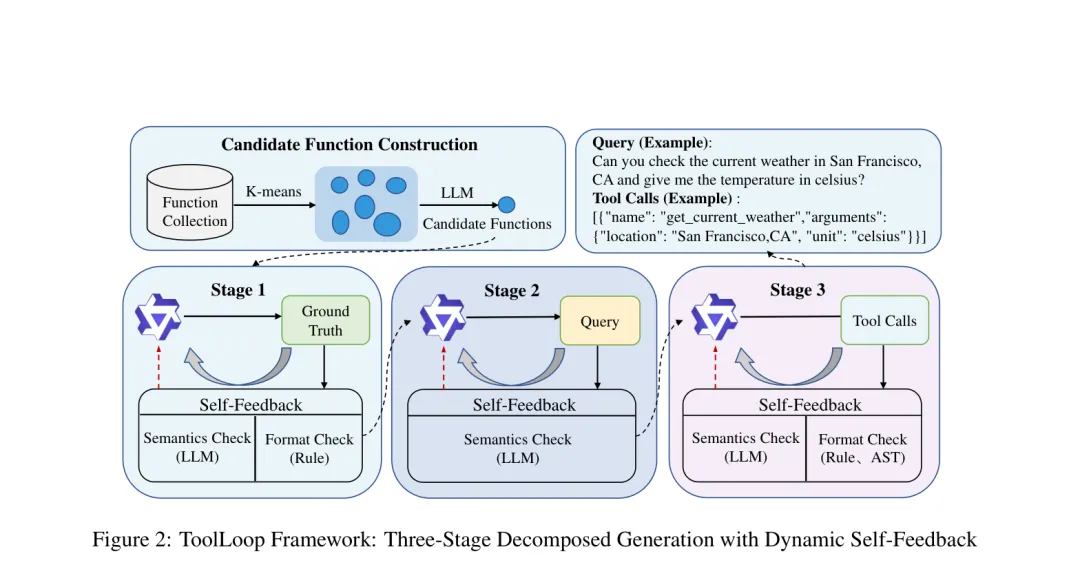
图3|左侧先收集并聚类候选函数;中间三列依次生成目标函数组合、用户问题和最终调用。每列下方的反馈器只检查该阶段:第一阶段看语义与格式,第二阶段重点看问题是否忠于目标,第三阶段同时检查语义、格式与语法树。右上角示例展示了天气查询如何落到函数名和参数。来源:ToolLoop论文图2。
顺着图3的箭头看,信息经历了一次“反向”再“正向”的往返:函数组合先定义任务骨架,用户问题把骨架翻译成人话,工具调用再把人话还原成可执行结构。两次转换若能闭合,样本才真正一致。
这也是ToolLoop最值得借鉴的设计:不要让生成模型同时猜题目、猜答案、猜格式。把一个高耦合任务拆成可检查的中间状态,既降低单步难度,也让错误有地址可查。
三、动态反馈不是打分,而是告诉模型返工哪里
很多所谓“自我改进”,实际只是让模型给自己的答案打一个总分。总分低并不能帮助重写:到底是函数选错、参数漏了、调用顺序不合理,还是输出结构坏了?若反馈没有定位能力,第二次生成仍可能重复第一次的错误。
ToolLoop的反馈是阶段化的。第一阶段若函数组合缺少并行性,就要求重选组合;第二阶段若查询漏掉必要地点或暗示了额外动作,就只重写查询;第三阶段若参数类型或字段名不合规,就修正最终调用。前一阶段已经通过的中间结果不必推倒。
验证器由三类检查共同组成。模型判断负责语义正确性与逻辑连贯,因为“这句话是否真的需要这组工具”很难靠字符串规则判断。确定性规则负责数量、字段、类型和结构约束。抽象语法树解析则检查工具调用表达能否被机器正确读取。
三者各自守一段:模型擅长理解意思,但可能放过细小类型错误;规则擅长抓硬约束,却理解不了“旧金山”在这个字段里究竟是城市还是更宽泛的地点;语法树能看见括号、对象结构和语法,却不知道调用是否解决了用户问题。语义判断与确定性检查互补,才让闭环不只是“模型自己夸自己”。
论文用100个随机样本人工复核语义验证器,通义千问旗舰模型(Qwen-Max)的判断与人工结果一致率为94%。这个数字说明它足以承担批量筛查,但也留下6%的分歧。作者观察到的典型问题包括:函数要求整数,调用却给出带小数部分的浮点数;或者地点粒度与参数要求不完全对应。
因此,94%不应被理解成“验证器已经可靠到可以单独拍板”。更准确的工程结论是:模型验证适合处理语义,规则与语法检查必须继续兜住客观约束。只用其中任何一种,都会漏掉另一类错误。
四、消融实验给出的答案:过滤不如修复
一套闭环方法最容易被质疑的地方是:成绩提升究竟来自更多生成次数,还是反馈真的有用?论文用相同基础模型、相同合成框架、相同初始生成预算做了三组对照。
未加入反馈时,4B基础模型在伯克利函数调用榜单的总体准确率是82.14%,直接用未经质量控制的合成数据训练后反而降到79.97%,下降2.17个百分点。这是一个很有价值的负结果:合成数据并非越多越好,内部不一致的数据会把原有能力教坏。
把错误样本在最后过滤掉,总体分数回升到82.56%,仅比基础模型高0.42个百分点。完整动态反馈则达到86.40%,比最终过滤高3.84个百分点。三组差异把核心因果链讲得相当清楚:生成本身不够,末端清扫也不够,真正有效的是在错误尚未扩散时进行局部修正。
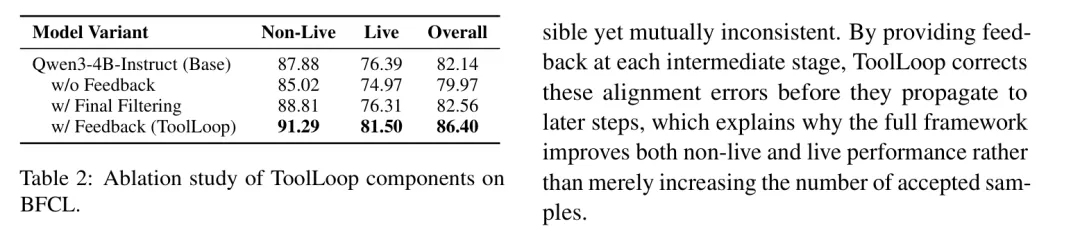
图4|消融表从上到下依次是基础模型、无反馈、只做最终过滤、完整反馈。最右列总体分数为82.14、79.97、82.56和86.40;完整反馈在非实时与实时子集上也同时领先。来源:ToolLoop论文表2。
为什么“过滤”与“修复”会差这么多?假设一个样本的用户问题漏写了单位,但目标函数与其余参数都正确。末端过滤只能损失整条样本;局部反馈则补上单位,保留已经正确的结构。对复杂的多工具样本来说,前面已经生成好的部分更昂贵,整条丢弃尤其浪费。
此外,过滤容易造成幸存者偏差。越简单、越模板化的样本越容易一次通过,复杂选择题和并行调用更容易被删。久而久之,训练集看起来“干净”,却缺少真正能提升能力的难例。ToolLoop通过返工保住难例,提高的不是数据条数,而是有效监督的密度。
五、4B模型的86.40%,到底追近了谁
ToolLoop以通义千问3的四十亿参数指令版为基础,使用1.1万条合成样本训练两个周期,最大序列长度为1.6万词元,推理时不输出额外思维链,直接生成榜单要求的函数调用格式。这一设置很重要:智能体运行通常在意延迟,不能靠拉长推理过程把准确率“磨”出来。
在伯克利函数调用榜单上,工具调用模型(ToolLoop-4B)总体准确率达到86.40%。同为4B、使用6万条训练数据的自动接口数据生成方法(APIGen)是83.11%,使用5.5万条数据的工具思维方法(ToolMind)是83.53%。
也就是说,本方法以约五分之一的数据规模,分别高出3.29和2.87个百分点。表中8B模型为86.43%,ToolLoop-4B只低0.03个百分点;30B混合专家模型为86.26%,17B模型为85.78%。“4B小模型追近更大模型”有直接表格依据,但只指这套函数调用评测。
与商业模型相比也要看清对象。本方法的86.40%高于表中两个商业系统的85.87%与81.00%,但低于另外两个系统的88.77%与90.36%。这些系统的训练数据和接口策略并不透明,更适合说明小模型在特定格式任务上很有竞争力,而非综合能力排名。
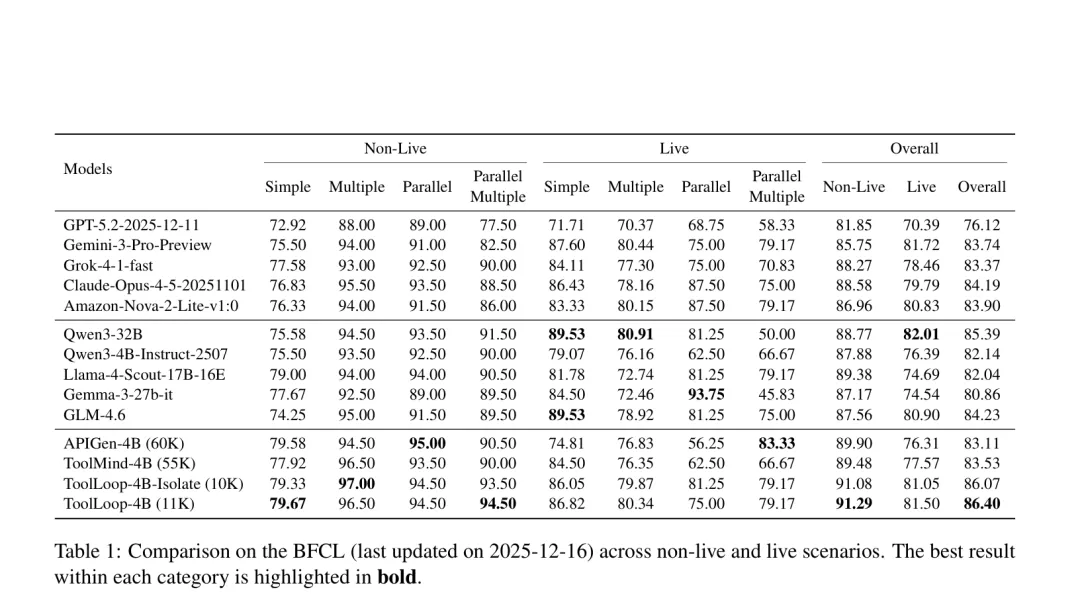
图5|表格按非实时、实时与总体三组列出结果。最后两行是隔离重叠函数的10K版本与完整11K版本;右侧总体分数分别为86.07和86.40。阅读时应同时看模型规模、训练数据量和测试分组。来源:ToolLoop论文表1。
论文还专门做了函数重叠控制。ToolLoop-4B-Isolate在合成前删除与评测候选函数重叠的工具,训练集缩为1万条,最终仍有86.07%,只比完整版本低0.33个百分点。它不能排除所有形式的数据污染,但至少说明主要收益并非靠记住评测里出现过的函数描述。
分项结果也很有启发。非实时场景总体91.29%,比最强的非ToolLoop基线高1.39个百分点;多候选选择达到96.50%,并行多工具达到94.50%。这恰好对应方法重点:先显式确定目标函数组合,再围绕组合生成问题,尤其适合训练“从相似候选中选对”和“保持多个调用一致”。
实时场景总体81.50%,仍高于APIGen方案的76.31%和ToolMind方案的77.57%。不过实时并行多工具子集只有24个样本,本方法的79.17%与前者的83.33%只差一个样本,不能把这一列当成稳定排名。
六、跨榜单结果:省数据的优势是真的,但不是处处领先
只在一个榜单上表现好,可能是训练格式刚好贴合测试。论文因此又在综合工具评估系统(ACEBench)上比较原始4B模型与三种数据训练方案。这个榜单还考查单轮任务、相似工具辨别和用户画像选择。
ToolLoop总体达到72.1%,高于APIGen的67.0%和ToolMind的70.2%。它在原子操作上达到84.0%,在相似工具辨别上达到78.0%,两项都是表中最高。尤其值得注意的是,ToolLoop只用1.1万条数据,相当于APIGen 6万条数据的18.3%,总体还高5.1个百分点。
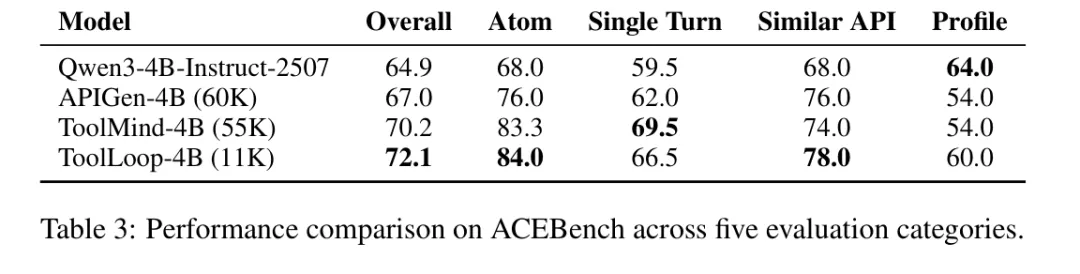
图6|横向五列依次为总体、原子操作、单轮、相似工具和用户画像。ToolLoop在总体、原子操作与相似工具三列领先;单轮低于ToolMind,用户画像低于未经微调的基础模型。来源:ToolLoop论文表3。
但图6也把短板摆得很清楚。单轮任务上,ToolLoop是66.5%,低于ToolMind的69.5%;用户画像选择上,ToolLoop是60.0%,虽然高于两个数据基线的54.0%,却低于基础模型的64.0%。这意味着合成数据加强了通用工具语义和相似函数辨别,却没有充分表达“这个用户偏好什么”。
对产品团队来说,这个差异很现实。企业助手不仅要会调用“订票”工具,还要记得用户偏好高铁、靠窗、少中转。如果训练集只关心函数与参数是否正确,模型可能更会执行,却没变得更懂人。
七、对照两代代表方法,ToolLoop补的是哪一块
把ToolLoop放回工具学习的发展线,会更容易理解它并不是“第一个合成工具数据”。2023年的大模型工具学习框架(ToolLLM)从商业接口平台收集16464个真实接口,覆盖49类;再让ChatGPT生成单工具与多工具指令,并用深度优先搜索决策树寻找可行调用路径。
ToolLLM解决的是“开放模型如何接触足够广的真实工具,并学会多步调用”。它还训练了接口检索器,在推理时先推荐相关工具,再让配套模型执行多轮调用,并用自动评估器打分。这条路线重覆盖、检索和搜索式推理,奠定了大规模工具学习的数据底座。
它的代价也来自同一设计:整条指令与解题路径由外部强模型生成,复杂链条一旦前后不一致,纠错位置不够细。ToolLoop没有取代ToolLLM的工具库思想,而是把关注点收缩到“让每条单轮调用样本内部更一致”。
2024年的函数调用数据框架(ToolACE)则把覆盖与难度控制推进了一大步。它通过工具自演化合成,把接口池扩到26507个、390个领域,并覆盖嵌套参数、并行调用、依赖调用和多种数据类型。随后用多智能体生成对话,由复杂度评估器调节题目难度,再用规则检查与模型检查组成双层验证。
ToolACE解决的是三个词:多样、复杂、准确。它不只依赖现成接口,而是主动演化新工具;不只生成简单单轮题,还让数据难度略高于当前模型能力;不只做一种检查,而是同时看可执行性与语义一致性。其8B模型在当时达到可与顶级商业模型竞争的水平。
ToolLoop与ToolACE最关键的区别在错误处理方式。ToolACE的双层验证强调把关,ToolLoop进一步强调把验证结果送回当前阶段,让生成器按具体错误修改。一个更像严格质检线,一个更像带返修工位的生产线。两者都使用模型与规则,但信息是否回流,决定了坏样本是被淘汰还是被修好。
数据规模也揭示了两种路线的取舍。ToolACE追求更广工具域和更丰富交互类型;ToolLoop只覆盖四类单轮函数调用,用5281个可执行工具生成11024条样本。它没有覆盖ToolACE强调的依赖调用与多轮交互,却在受控范围内证明:中间过程对齐得更好,可以用更少数据换来很强的特定任务表现。
因此三篇工作的关系可以这样记:ToolLLM回答“如何把真实工具世界搬进训练”;ToolACE回答“如何扩大工具、场景和难度的多样性”;ToolLoop回答“如何发现一条样本究竟坏在哪,并只返工那一段”。它不是规模竞赛的新纪录,而是质量控制粒度的一次推进。
八、为什么它能省数据:返工集中在少数难点
ToolLoop最终保留11024条样本。第一阶段有10720条一次通过,第二阶段有9029条一次通过,第三阶段有10257条一次通过。换句话说,大多数中间结果不需要反复生成,额外计算主要集中在那部分真正有问题的样本上。
若把需要两次或三次返工的样本合并计算,第一阶段占1.72%,第二阶段占8.05%,第三阶段占4.25%。第二阶段最高,再次印证自然语言问题是整条链最容易产生“听起来对、实际不够精确”的位置。
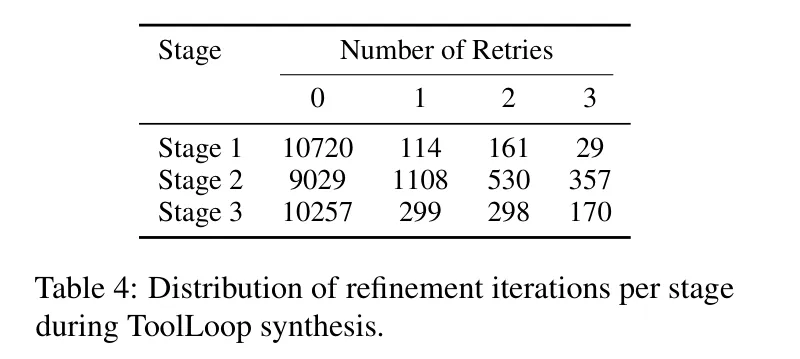
图7|每行对应一个生成阶段,每列对应0到3次返工。第二阶段的一次、两次、三次返工数量分别为1108、530、357,明显高于另两阶段。来源:ToolLoop论文表4。
全部合成估算消耗2613万输入词元和728万输出词元,总计3341万词元。并行样本成本最高,因为它既要在第一阶段构造合理的工具组合,后续查询和调用也更长。论文没有给出统一货币成本,因为价格取决于所用生成与验证模型,但词元账单至少让工程团队能估算自己的预算。
达到最多三次返工后,仍有280条样本无效并被丢弃。其中192条持续未通过语义检查,83条未通过规则检查,5条两类检查都失败。相对于11024条保留样本,这个最终丢弃集合约占2.48%。闭环并非保证每条都能救回来,而是先尽量修复,实在修不好再放弃。
“省数据”也不能简单理解成“省掉82%的全部成本”。18.3%指的是与APIGen训练样本数的比例,不是端到端费用比例。ToolLoop为返工引入了额外推理,验证器本身也要消耗资源。它节省的是训练数据数量和从头重生成的浪费,真实总成本仍取决于生成模型、验证模型与重试率。
九、从论文到真实智能体,还差执行环境这一关
ToolLoop当前评测的是静态函数调用:给出用户请求与工具定义,模型输出标准化调用。它没有让工具在真实环境里跑起来,因此没有覆盖超时、权限不足、返回字段变化、服务限流、半途失败和级联错误。
这一区别很关键。静态调用答对,说明模型会选函数、填参数;真实智能体完成任务,还要读取执行结果、判断是否成功、根据错误调整下一步,并在高风险动作前请求确认。ToolLoop把训练数据制造过程做成了闭环,但被训练的智能体本身还没有在论文实验中完成执行闭环。
验证器也可能带来一致性偏差。三个阶段都使用Qwen-Max做语义判断,同一个验证模型若对某类表达存在偏好,错误可能在多个阶段相关出现。100条人工样本的94%一致率是有用的健康检查,但还不足以细分每种错误、每个阶段和每类工具的校准情况。
另一个现实问题是覆盖范围。论文处理四类单轮调用,没有训练多轮澄清、依赖前一步结果的链式调用,也没有把用户画像作为核心状态。这与ACEBench里用户画像分项下降相呼应:当训练目标没有显式包含某种能力,漂亮的总体分数不会自动把它补出来。
论文v1没有给出专属代码仓库,因此本文删除“代码与本地实测”章节,不用“尚未运行”凑篇幅。当前最有价值的复用对象是方法思想:把复杂合成流程拆成有可验证中间状态的步骤,并让错误反馈回到对应工位。
十、龙哥点评:真正稀缺的不是样本,而是可修复的过程
龙哥觉得,这篇论文最有价值的地方,不是4B模型在某张表里压过几个更大模型,而是它把数据生产从“成品抽检”改成“过程质检”。在企业场景里,错误样本最贵的部分往往不是重新生成几个词,而是重新确定意图、工具组合和参数关系。能定位哪一层坏了,才有机会把预算用在刀刃上。
它也提醒我们,小模型追近大模型并不神秘。任务被收窄、输出格式明确、训练样本内部一致时,4B模型完全可能在函数调用上接近8B、30B甚至部分商业模型。模型大小决定能力上限的一部分,数据是否把问题讲明白,决定这部分能力能不能被有效调用。
若团队把ToolLoop思想用于生产,下一步应优先补执行反馈:工具是否返回结果、参数是否被接受、连续失败时是否停止,高风险动作是否转人工。
从研究路线看,ToolLoop还可以与ToolACE互补。前者提供细粒度返修回路,后者提供更丰富的工具类型、依赖关系和多轮场景。若把“多样性生成”和“阶段化修复”结合,再加入真实沙箱执行,工具调用数据才会从格式正确走向任务可靠。
龙迷三问
第一问:为什么不直接让更强模型生成更多数据?因为规模不能自动修复内部矛盾。若问题、目标函数和参数互相打架,更多数据只会更快放大噪声。阶段化检查的价值,是先保证一条样本从意图到调用闭合。
第二问:86.40%是否意味着4B模型已经胜过大模型?它意味着在论文采用的函数调用格式与榜单设置下,4B微调模型非常有竞争力。开放问答、多轮规划、真实执行恢复和安全决策不在同一个分数里。
第三问:普通团队最容易借鉴哪一步?先给每个生产阶段定义可检查的中间结果,再把错误原因回传到原步骤。即使不用同一套模型,也可以把“整条重来”改成“局部返工”。
总结
ToolLoop给出的主张可以压缩成一句话:高质量工具调用数据,不该是一口气写完再筛,而应先确定目标函数,反推用户问题,再生成可执行调用,并在每一步发现错误后局部修正。
它用11024条样本把4B模型推到伯克利函数调用榜单86.40%,隔离重叠函数后仍有86.07%;在ACEBench上以APIGen 18.3%的训练数据达到72.1%。消融实验进一步表明,无反馈数据会让模型退步,末端过滤只能小幅恢复,动态返修才带来主要增益。
真正值得带走的,不是某个榜单名次,而是一种工程习惯:把复杂任务拆成可观察、可验证、可返工的中间过程。当智能体开始替人操作真实工具,这种能力会比“再生成一次试试”更重要。
本文基于龙哥读论文数据库(PaperDaily)及论文工具(PaperMiner)的模型上下文协议(MCP)进行汇总整理。
本文为论文解读与个人技术分析,不构成论文评审或项目采用建议;具体实验设置与完整结果请以原文为准。
原文:https://arxiv.org/abs/2609.09072