ARTICLE · 1018249
PDFBox 解析 PDF:正文好拿,表格和图片全是坑
上一篇我们把「文档从哪来」的「四问 + 六列」列完,这篇终于写代码了。
我挑的是法律场景的硬骨头:民事判决书 PDF。
为什么挑它?因为它三种坑全占:
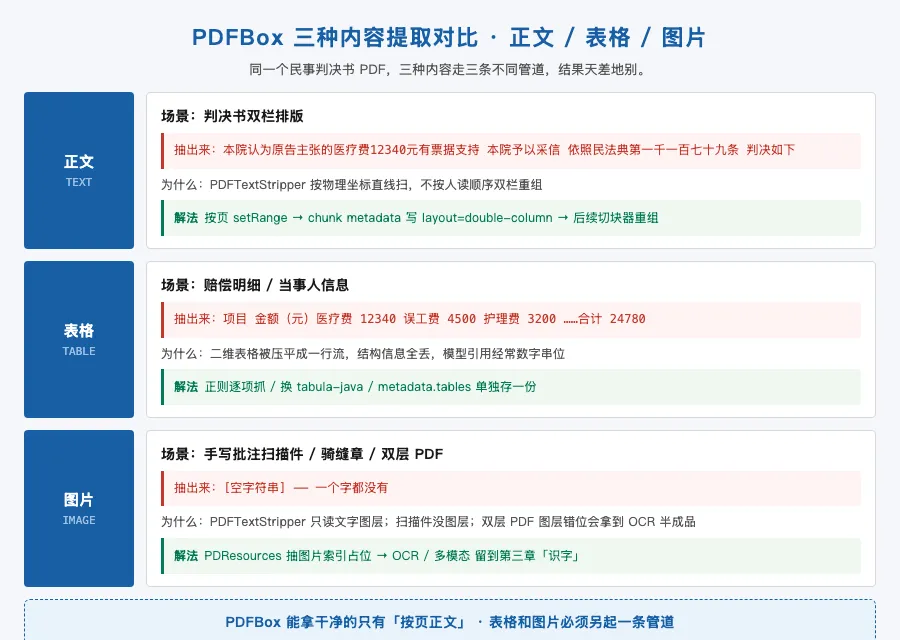
正文是双栏排版——法院判决书标准排版,左栏是事实与理由,右栏是判项。如果直接
PDFTextStripper全文撸,你会读到「这法院写的东西怎么语序全是乱的」,因为它把左栏读到底再读右栏,根本不是人读顺序。表格碎成一行行——当事人信息栏、利息计算表、赔偿项目明细表,原本是二维结构,PDFTextStripper 把它们读成「| 原告 | 张三 | 男 | 1990 年... |」,表格的结构信息全丢。
图片里的字一个都拿不到——判决书首页的法院 logo、二维码、骑缝章,以及当法院把法官手写批注扫描进 PDF 时,那些字全是像素。
这一篇我们用 Apache PDFBox 把这三种坑当场拆给你看。
一、环境与依赖
Maven 依赖(pom.xml):
<!-- PDFBox 3.0.x:JDK 17+;旧版 2.x 在 JDK 17 上跑要加 --add-opens --><dependency><groupId>org.apache.pdfbox</groupId><artifactId>pdfbox</artifactId><version>3.0.3</version></dependency>JDK 用 17+ 即可。3.0.x 对 jakarta 的依赖更干净,PDFBox 自带 Loader.loadPDF 替换掉了过时的 Loader.loadPDF+RandomAccessRead 组合写法。
二、最简代码:按页抽正文
// 合同纠纷 PDF 入库:按页切分,每页单独成一个 chunk 候选,方便后续切块器再细分public class JudgmentPdfLoader {public record PageChunk(int pageNo, String text) {}public List<PageChunk> loadByPage(Path pdfPath) throws IOException { List<PageChunk> pages = new ArrayList<>();try (PDDocument doc = Loader.loadPDF(pdfPath.toFile())) {// 拿到页数;后续切块器拿到这个游标可以在 chunk metadata 里写 "page": 3int pageCount = doc.getNumberOfPages(); PDFTextStripper stripper = new PDFTextStripper();for (int i = 1; i <= pageCount; i++) { stripper.setStartPage(i); stripper.setEndPage(i);// 按页 setRange 后只抽这一页文本,规避双栏全文乱序的 80% 问题 String pageText = stripper.getText(doc); pages.add(new PageChunk(i, normalize(pageText))); } }return pages; }private String normalize(String raw) {// 把 PDF 里的零宽空格、连字符、连续空白压成单空格return raw.replace('\u00AD', ' ').replaceAll("\\s+", " ").trim(); }}这就是 v0.1 的全部抽取逻辑——按页切分、不做表格识别、不抓图片、把零宽字符压掉。
至于页面顺序错乱、表格拆碎、图片字拿不到的事,下面现场看。
三、翻车现场 1:双栏判决书的「乱序」
(这个坑最容易被忽视)
下面这段是真实双栏排版(左边是事实,右边是判项):
左栏末段:本院认为,原告主张的医疗费 12,340 元有票据支持,本院予以采信……右栏首段:依照《民法典》第一千一百七十九条……判决如下:
我们用上面 loadByPage 抽出来打印,是这样的:
第 3 页正文:本院认为原告主张的医疗费 12340 元有票据支持 本院予以采信 依照民法典第一千一百七十九条 判决如下
一句话。把左栏后半截和右栏前半截糊在一起了。
PDFTextStripper 是按 PDF 文本流的物理坐标顺序(从页面左上到右下)读,不会自动按「双栏的语义」重组。它读到的顺序是:
[左栏第一段][左栏第二段][左栏第三段]→[右栏第一段][右栏第二段]→继续下一页
你以为它在读「左栏从上到下 → 切右栏」,它真就是按文字块的物理坐标直线扫过去。
我们的解法分两步:
- 最小可用版本
:按页切,承认双栏问题是「后续切块器 + 阅读顺序还原器」的工作。入库时在 chunk metadata 里写 {"page": 3, "layout": "double-column"},给后续处理做提示; - 正经版
:拆 PDF 文本块(PDFBox 的 PDFTextStripper加setSortByPosition(true)),再按 Y 坐标聚簇、按 X 坐标分栏,输出结构化的Block → Paragraph → Sentence。这部分代码这一篇不展开,留到第三章「识字」篇讲多模态时连同版面分析一起做。
最坑的不是分栏,是法院的真·双栏 PDF 在每页左下角和右下角有页脚「- 本页第 3 页 共 8 页 -」和诉讼费栏,这些会被 normalize() 一起拼进正文,必须在切块器里再剥一次。
四、翻车现场 2:表格碎成一行行
法院判决书里,最常见的表格就是「当事人信息」和「赔偿明细」。
PDFBox PDFTextStripper 抽出来的样本:
当事人信息:[空格多] 原告 [空格多] 张三 [空格多] 男 [空格多] 1990 年 5 月 [空格多] ……[空格多] 被告……赔偿明细:项目 金额(元)医疗费 12340 误工费 4500 护理费 3200 ……合计 24780
表格的二维结构丢了,全成「一行流」。
问题来了:用户问「这案子的医疗费是多少?」,向量检索召回的是「项目 金额(元)医疗费 12340 误工费 4500 护理费 3200」这一行——模型看到的是堆在一起,吐出来的数字经常串位。
最小可用方案(这一篇给思路,下一篇 POI 也有表格,到时候合并讲结构化):
- 思路 A:让 PDFBox 抽表格就用
PDFTextStripper输出后做正则——「金额(元)[^X]\d+」逐项抓取,配合行首的「项目」锚词; - 思路 B:换库
——用开源 tabula-java(Apache 2.0)或商业Aspose.PDF,能直接拿到Table → Row → Cell结构; - 思路 C:在 metadata 里单独存一份
——把表格抽出来单独放一个 tables/字段,让切块器把表格 chunk 单独建立。
RAG 实战里,思路 A 够用 80% 的简单明细表,复杂表格(合并单元格、跨页表)必须走 B 或 C。
这一篇不展开 tabula-java 的代码,下一篇 POI 解析 docx 表格时一并演示结构化写法。
五、翻车现场 3:图片里的字一个都拿不到
(这个最严重,必须留伏笔)
法院有些判决书会扫描附加证据——手写病历复印件、签收单、质证意见。这些「纸拍照」生成的 PDF 内部其实是图片,PDFTextStripper 抽出来 ""——空字符串,没有任何文字。
有些更狠:「双层 PDF」——表层是扫描图,底层藏一份真文字图层(OCR 结果)。PDFTextStripper 默认抽的是底层文字图层,如果图层缺失或版本错位,可能抽到的是「OCR 半成品」——错别字一堆。
更隐蔽的是:有些法院的电子签章,是把整章戳的图片塞进 PDF 再压文字图层——PDFTextStripper 一抓一个空。
最小可用思路:把图片单独抽出来留占位,不指望 PDFBox 读字。
// 抽图片资源清单,给后续 OCR / 多模态接管留入口public List<String> extractImageRefs(PDDocument doc) throws IOException { List<String> refs = new ArrayList<>();for (int i = 0; i < doc.getNumberOfPages(); i++) { PDPage page = doc.getPage(i); PDResources res = page.getResources();if (res == null) continue;// 拿到 XObject 里的图片资源;不抽像素,只在 chunk 里写占位for (COSName name : res.getXObjectNames()) {if (res.isImageXObject(name)) { refs.add("p" + (i + 1) + "/" + name.getName()); } } }return refs;}接下来在 chunk metadata 里写 {"images": ["p1/Im0", "p3/Im1"]},OCR 留到第三章「识字·让 RAG 看懂非文本」——那一篇我们引入 PaddleOCR / 多模态大模型时一起讲。
这一刻你只需要记住一件事:图片里的字 PDFBox 拿不到。把它当「占位符 + 索引」入库,别假装它有内容。
六、把这套代码收成一个最小入库流程
把上面三段拼起来,判决书 PDF 入库的最小流水线是这样的:
loadByPage(path)拿到所有 PageChunk;每条 PageChunk配上一份 metadata:{"docId": "民初123号", "page": 3, "layout": "double-column", "images": [...]};写入临时 Chunk列表,先别急着 Embedding;把这个临时列表人工抽 5 条打印出来,看看正文是不是连贯的——前面 normalize()那段把零宽字符干掉就是这一步的命门。
第 3 步之后接 Embedding + 向量库(EP011 我们上 Tika,EP012 我们上 LangChain4j Embedding)。这一篇我们只把 PDF 这一根管道打通。
自检清单(v0.1 PDF 入库)
按页切分正常,每页文本可在 1-2 个自然段 文字零宽字符、连字符已归一化 每页 chunk metadata 含有 page、layout字段表格 chunk 至少做了「逐项」或「单独字段」处理,不再糊成一行流 图片有占位记录(路径/索引),不假装有内容 抽样 5 条 chunk 人工读过、判断「能检索」
下一篇(立骨 · 03),我们换 Java 生态解析 docx 的同款硬骨头:用 Apache POI 的 XWPFDocument 解析合同。你会看到 Word 的「修订模式」「批注」「页眉页脚」是怎么把一份作废条款继续留在语料里、然后被律师当现行合同引出去的——以及我们怎么把这些「陷阱字段」主动剥离。
我们下一篇见。
声明:本系列所有内容均为个人原创(含基于公开文档、资料、书籍与个人实践的重述和代码实现)。文中医疗、法律相关案例均为脱敏的合成示例,与公司核心业务完整脱离,只讲技术,不构成医疗建议或法律意见。