ARTICLE · 1018264
不写公式做Excel分析:AI 10分钟出结论
QUOTE
不写一个公式,把表格丢给 AI——省时间的前提,是先让它证明自己读懂了。
—— 金句先生
周五下午17:40,市场运营小林正准备关电脑。领导在微信里甩来3个文件:3月销售明细(8000多行订单)、门店维度汇总、退货明细CSV。
「周一早会9点,给我一页结论:哪个区、哪个品类异常,退货怎么回事,下周怎么调。」
小林盯着屏幕。VLOOKUP语法早忘光了,数据透视表只在三年前培训里点过一次。这个周末,看起来又没了。
如果你每周都要跟表格打架,这篇讲一件事:不写一个公式,把Excel丢进AI对话框,10分钟级拿到能上早会的结论。整套流程免费,今天下班前就能试。
本文看点
01
AI读表现在到底行不行
02
7步操作+3段可抄提示词
03
翻车点识别与脱敏
01
CAN IT READ
AI读表,现在到底行不行
2025年起,国内主流AI直接读Excel已经是成熟能力,不是极客玩法。
腾讯元宝2025年3月21日上线读Excel,上传表格后一句话提问即可完成计算、分析、重点提取,DeepSeek和混元双模型都支持;千问2026年4月14日上线「表格Agent」,官方称所有用户免费,能在沙箱里写代码,生成带真实公式、条件格式的xlsx,通常1到2分钟输出可下载文件;Kimi有专门的Kimi Sheets,支持透视、出图、清洗后下载回xlsx。
免费额度方面,元宝、千问、Kimi、豆包、DeepSeek网页版登录后都能免费跑通主流程。元宝官网口径:一次最多传50个文件、单个不超过100MB;千问一次最多10个文档、可处理500页(单文件MB上限官方未公开,以上传提示为准);Kimi开放平台口径单文件100MiB,C端以客户端提示为准。
但「能传」不等于「算得对」。通用对话模型不执行Excel公式引擎,多Sheet、合并单元格、超大数据量都容易读错。第三方实测显示,DeepSeek处理多Sheet工作簿时只读第一个Sheet、不重算公式,约束约为20MB、1万行、100列(第三方口径,非官方)。它适合单Sheet干净CSV的归因推理,多表回写要图表,元宝、千问、Kimi更顺手。
所以正确姿势只有一条:把AI当实习生,先让它汇报「我读到了什么」,对完口径再听结论。
02
SEVEN STEPS
7步操作:小林这3张表怎么跑
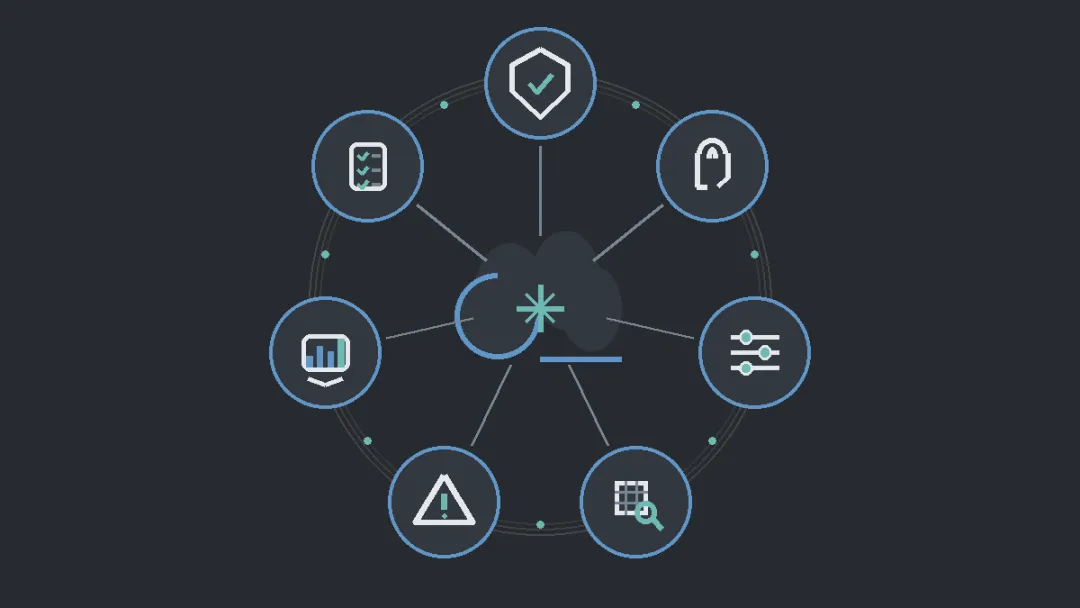
— 从脱敏上传到抽查删除:小林这3张表的7步处理流程
电脑浏览器打开 yuanbao.tencent.com 登录。文件先别裸传,删掉客户姓名、手机号列,门店名换成「门店A、门店B」,另存3个干净文件。映射关系只存在你本机。
点输入框的上传(回形针)按钮,把3个文件一次拖进去。也可以直接从微信、腾讯文档选取,文件本来就在微信里,这条路最省事。
数据量大时,把模型切到「混元」、关闭「深度思考」,让它走代码方式跑大表。这是元宝官方发布时给的建议,能避免长表读到一半中断。
发第一段提示词:
你将收到 3 个表格文件。先不要给分析结论,请先逐一如实回报:
1)每个文件的文件名、工作表(sheet)名、实际读到的数据行数与列数;
2)每一列的列名、你判断的数据类型(文本/数值/日期/百分比),以及前 3 行示例;
3)数据的时间范围(最早日期、最晚日期)、主键列(如订单号)是否唯一、有无空值或重复行;
4)哪些列存在合并单元格、表头多行、日期格式不统一、数字里带单位或货币符号等问题;
5)哪些字段你没有把握正确解析。
如果某个文件有多个工作表,请明确告诉我你默认只读了哪一个,不要自行猜测其他工作表内容。
它回报的行数,和Excel底部行号逐项核对。对不上,立刻停,先解决读取,再谈分析。
口径对上后,发第二段提示词:
基于你已确认读取正确的这 3 个表(销售明细、门店汇总、退货明细),帮我找异常并归因,要求:
1)按【区域】和【品类】两个维度,分别给出销售额、订单数、客单价、退货率的本期值与环比变化,列出变化绝对值最大的前 5 项;
2)对每一个异常项,必须写明:数据来自哪个文件的哪些列、用什么口径计算(求和/计数/去重计数)、涉及的具体门店或SKU名称;
3)区分"事实"与"可能原因":原因只能作为假设提出,并告诉我需要再查哪张表/问谁来验证;
4)凡是你无法从数据中直接算出的数字,一律写"数据不足",绝对不要估算或编造;
5)最后用三句话说明:哪条异常最值得周一早会优先讲。
注意让它写明退货率的分子分母。跨表关联要有共同键(门店编码、订单号),名称对不上时,先让它列出各表的键值再关联。
发第三段提示词:
把上面的分析整理成周一早会可直接讲的一页内容:
1)5 条结论,每条一句话,格式为"结论 + 支撑数字(含来自哪张表)+ 影响";
2)3 条下周可执行动作,每条写清"做什么、谁来做、预期改善哪个指标";
3)为每条结论推荐最合适的图表类型(柱状/折线/堆叠/占比)并说明 X 轴、Y 轴、分类字段分别用哪列;
4)单独列一节"数据可信度说明":哪些数字已能直接核对、哪些只是假设、本次分析没覆盖什么;
5)语气面向非技术管理者,不要出现公式和技术名词。
需要真正的图表文件,把同样的要求发给千问表格Agent或Kimi Sheets,注明「按区域×品类做透视并生成柱状图,输出可下载xlsx」,1到2分钟拿文件。
让AI把每个关键数字对应到「表名+筛选条件+求和或计数口径」,你自己用数据透视表抽查2到3个数字。对不上的,一律不进早会材料。跑完删除对话和云端文件。
03
PITFALLS
三个高频翻车点,都有识别方法
翻车点1:编造数字
出现数据里不存在的门店名、品类名,或过于整齐的百分比,基本是幻觉。识别方法:要求每个数字带「文件名+列名+计算口径」,直接追问「这是算出来的还是估计的?算不出就写数据不足」。
翻车点2:读错列、只读第一个Sheet
合并单元格、多行表头、日期数字混排都会串列。识别靠第4步的数据概览,看前3行示例对不对;DeepSeek多Sheet只读首表,要先按Sheet拆成单独CSV,CSV一律用UTF-8另存,GBK编码可能乱码。
翻车点3:图表和文字对不上
条形图漏类别、折线图有空月、比率图用错分母最高发。识别方法:让AI同时给出图表背后的汇总表,用汇总表对图,X轴Y轴和合计逐项核。
04
PRIVACY
公司的表,先脱敏再传
免费C端产品在合规上不等同于内网。Kimi帮助中心原文写明:去标识化前提下,对话数据「可能」用于模型训练,且只能账号级退出,不能按文件退出;企业版和API才承诺数据不进训练。含客户、薪酬、合同的表,记住三个做法:
删列替换:另存副本,删掉姓名、手机、身份证、银行卡、地址;门店和客户用编号替换,映射表只存本地;敏感金额可等比缩放或只传区间。
分箱抽样:只传分析必需的字段和时间窗,比如只传3月、只传区域+品类+金额3列;敏感明细改传抽样或聚合后的汇总表,[[原始数据不出本机]]。
走企业版或本地:敏感数据用Kimi Business、腾讯文档企业权限,或阿里「千问办公」桌面端本地文件直读;用完及时删除对话与文件。
05
PICK TOOL
按表选工具,一张图记住
四类情况对号入座,限额和能力边界一次说清:
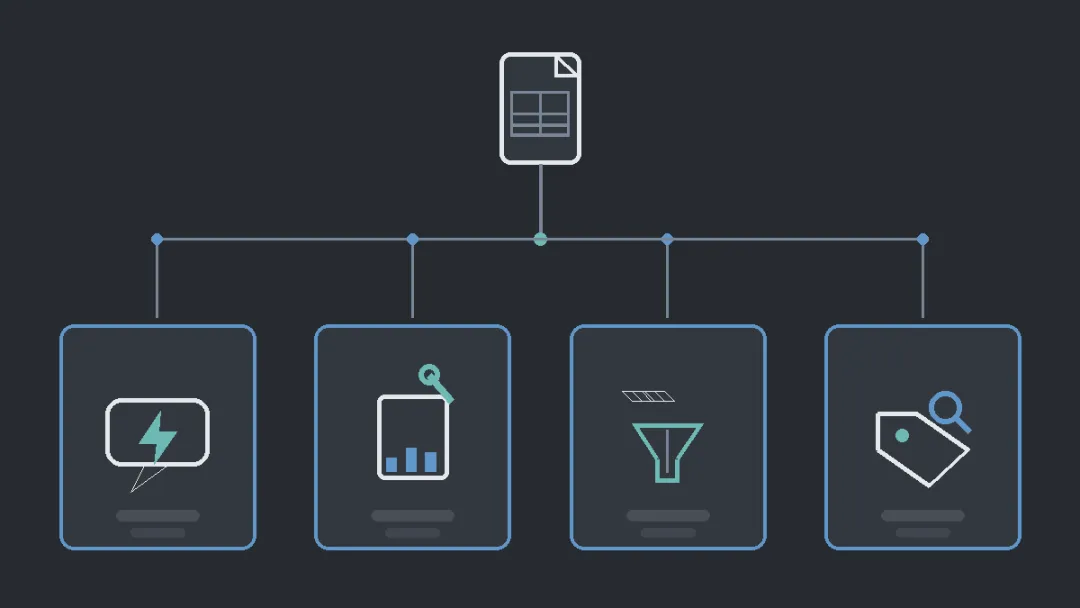
— 一张表进来,按文件位置和目标分流到四条工具路径
你的情况
用什么
关键口径
文件在微信,要快速出结论
腾讯元宝
免费登录即用,单文件≤100MB、一次≤50个;大表切混元、关深度思考
要回写带公式的xlsx、要图表文件
千问表格Agent
全用户免费,一次10文档、500页,出文件约1–2分钟
多表透视、清洗、出图下载
Kimi Sheets
基础免费,API口径单文件100MiB;敏感表走企业版
单个干净CSV做归因推理
DeepSeek
免费;第三方实测只读首个Sheet、约1万行,多表先拆CSV
表:按表选工具决策表(数字均为官方口径,DeepSeek行为第三方实测)
∞
THE END
关于「10分钟」,说句实话
10分钟级是熟练后的口径:第二次以后、表又干净,从上传到拿到5条结论确实在这个量级。第一次用,注册、脱敏、抽查都要额外时间。
收益数字建议你自己掐表测:同一组3张表,手工组从打开文件到做出汇总、图表、5条结论计时(含查VLOOKUP用法的时间);AI组按上面7步计时,跑两次报中位数,并单独记录核对返工花了几分钟。这个纠错成本,是所有「AI提效」宣传里最容易被漏掉的部分。
下一步你现在就能做:找一张不含敏感信息的工作周报或汇总表,打开 yuanbao.tencent.com ,只发第4步那段「数据概览」提示词,看它回报的行数和你表里的行号对不对得上。这一步不需要任何基础,5分钟见分晓。
这篇适合发给你们团队里每周跟表格打架的同事。
我是金句先生,专注 AI 应用落地与提效实战的干货分享。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。