ARTICLE · 1019077
抗体预测AI工具开源:不用MSA,抗体预测追平AlphaFold3
AlphaFold2 之后,"查同源序列"(MSA 搜索)几乎成了蛋白结构预测的标准动作——精度上去了,代价是慢:先跑数据库比对,再进模型推理。有没有一条彻底绕开 MSA、直接从单条序列出结构的路线?
2026 年 9 月,韩国科学技术院(KAIST)化学系 Woo Youn Kim / Seonghwan Seo 团队在 bioRxiv 发布 Atlas 模型家族,给这条路线交出了一份成绩单:
- 单体预测:纯语言模型路线里的最好成绩
——在 CAMEO22、CASP14、CASP15 三个基准上全面领先 ESMFold、SimpleFold-3B,CAMEO22 上与 MSA 路线的 AlphaFold2 基本打平; - 抗体–抗原预测追平 AlphaFold3
——只用 25,000 步微调,DockQ 成功率 46.96%,逼近 AlphaFold3 的 49.3%; - 推理又小又快
:1024 残基序列生成 5 个结构只要 11.57 秒(AlphaFold2 单个模型要 34.38 秒),2048 残基时峰值显存 39.81 GiB,约为 ESMFold2(160.32 GiB)的 四分之一; - 全部开源
:训练代码、训练数据、各阶段 checkpoint 与模型权重,MIT 许可证放出。
这是一份预印本(未经同行评审),但它是可复现、可续训的开源工作——这一点在当前的结构预测格局里意义不小。
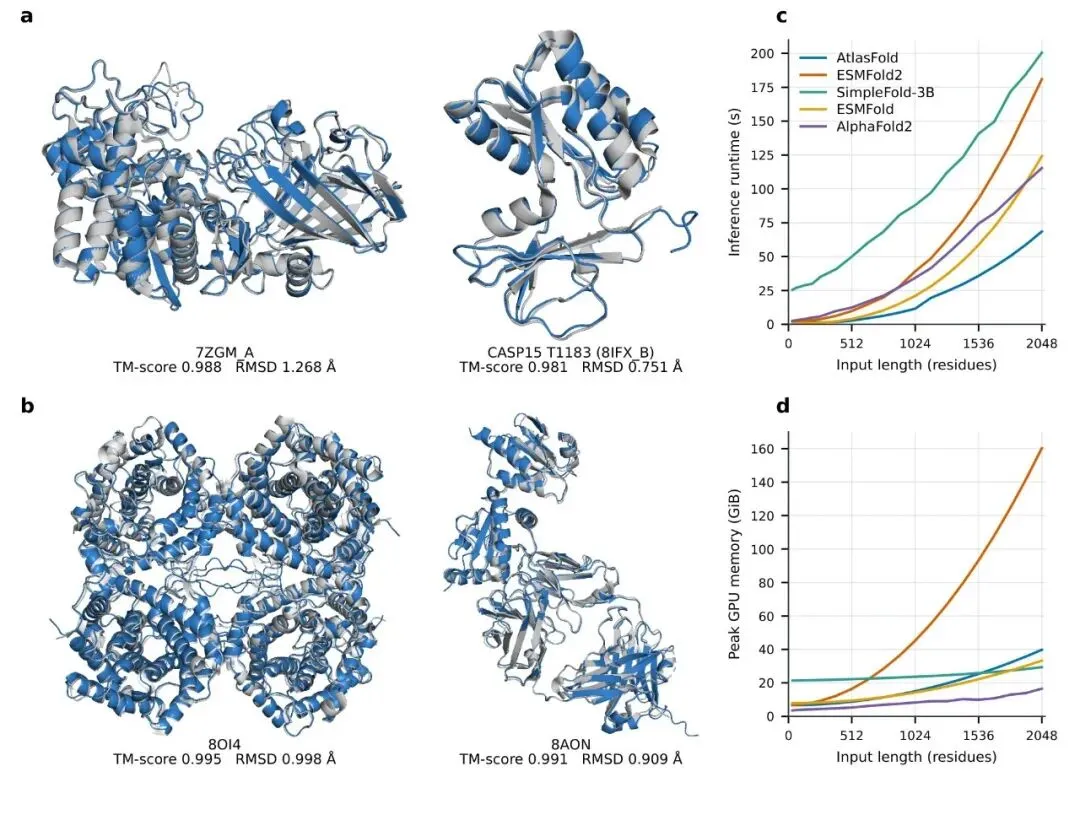
图1|AtlasFold 与 AtlasFold-M 的预测效果(灰色为实验结构,蓝色为预测)。(a) 单体示例:7ZGM_A(TM-score 0.988)与 CASP15 靶标 T1183;(b) 复合物示例:8OI4 四聚体与 8AON Fab 复合物;(c) 推理耗时随序列长度的变化;(d) 峰值显存随序列长度的变化。测量在单张 B200 GPU 上完成,不含 MSA 搜索时间
Atlas 家族的第一个成员是 AtlasLM-3B:一个 30.6 亿参数的 transformer 蛋白语言模型,用掩码语言建模(MLM)目标预训练。
它的"教材"规模是关键:约 15.6 亿条蛋白序列,除 UniRef 之外,还纳入了宏基因组数据集 MGnify 与 MetaClust——宏基因组序列来自环境样本中大量未被培养的微生物,覆盖了常规数据库里没有的演化多样性。
衡量方式是"无监督接触预测":不做任何结构监督,只看注意力图能否恢复长程残基接触(P@L、P@L/5)。
同参数规模下,AtlasLM-3B 在两项指标上都超过 ESM2-3B; 还超过了 15B 的 ESM2 以及 300M/600M 的 ESMC; 只有 ESMC-6B 精度更高(团队也坦诚说明:AtlasLM 开发早于 ESMC 与 ESMFold2 发布,数据集规模与训练设置存在差距;他们将训练从 150 万步延长到 200 万步)。
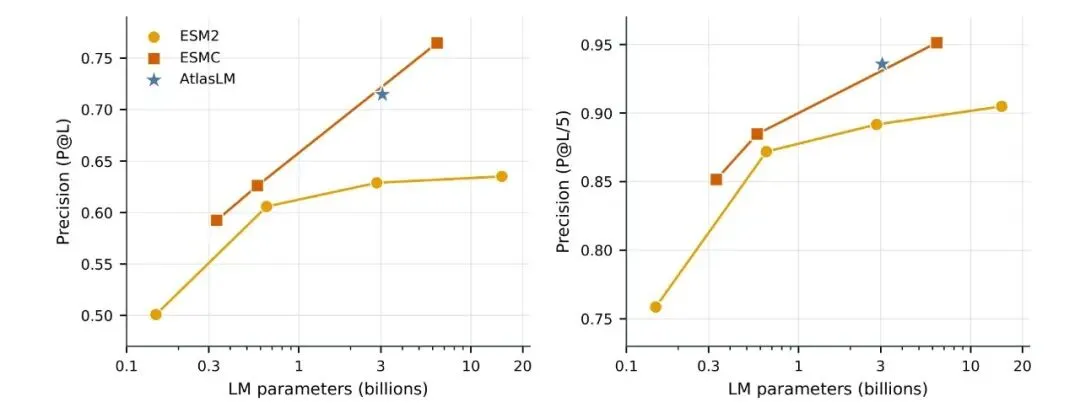
图2|无监督长程接触预测精度(ESM 结构超家族划分的 partition 4)。(a) P@L;(b) P@L/5。横轴为语言模型参数量。AtlasLM-3B 在同参数量级超过 ESM2-3B,也超过 ESM2-15B 与 ESMC-300M/600M
AtlasFold = AtlasLM-3B 的表征 + 一个"蛋白专用版"的 AlphaFold3 折叠主干。
具体做法(图 3):每个 recycling 迭代中,AtlasLM 从一条带 15% 掩码的输入序列重新计算 single / pair 表征;折叠主干把它们与回收的 single、pair 状态合并,经过 48 个 block 的 Pairformer 精修,最后由扩散头生成全原子结构。
与 AlphaFold3 的关键差别在于"做减法":
AlphaFold3 用通用分子表征,要兼容蛋白、核酸、修饰残基、配体;AtlasFold 只做蛋白单体,于是每个 token 恰好对应一个氨基酸,表征变均匀; 循环次数从 10 次降到 4 次,扩散步数改为长度自适应(≤512 残基 20 步,513–1024 残基 30 步,>1024 残基 100 步),而 AlphaFold3 是固定 200 步。
理由是团队发现:扩散采样才是单体预测的主要耗时瓶颈。
训练数据为 PDB 实验结构(2020-05-01 截断)加上约 1600 万个 MGnify 序列的 AlphaFold2 预测结构;分四阶段训练,crop 依次为 256/384/512/640 残基。
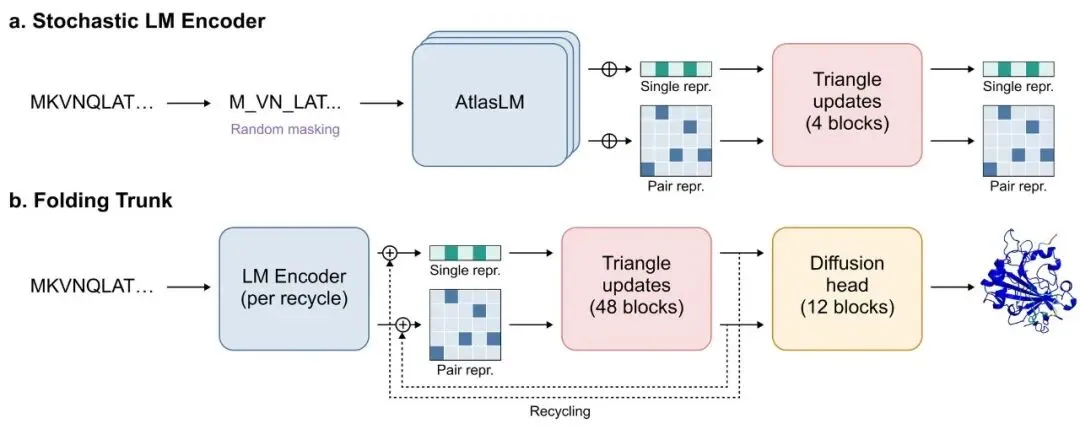
图3|AtlasFold 架构总览。(a) 每次 recycling 迭代中,AtlasLM 从新掩码的输入序列重算 single 与 pair 表征;(b) 折叠主干将语言模型表征与回收状态结合、精修,并由扩散头生成全原子结构
在 CAMEO22(n=183)、CASP14(n=70)、CASP15(n=56) 三个基准上,AtlasFold 都是纯语言模型路线的最好成绩:
- CAMEO22
:TM-score 均值 0.865(ESMFold 0.853、SimpleFold-3B 0.835),lDDT 0.838 反而是全场最高之一;而 MSA 路线的 AlphaFold2 是 0.879——基本打平; - CASP14
:TM-score 0.732(ESMFold 0.702、SimpleFold 0.716); - CASP15
:TM-score 0.701(ESMFold2 0.695、ESMFold 0.671)。
但差距也很清楚:CASP14/CASP15 上 AlphaFold2(0.844 / 0.751)依然领先,MSA 路线在"难靶标"上还是更稳。
置信度输出也做了校准(1 万个 2023 年后发布、与训练集序列同源性 <40% 的结构):残基级 pLDDT 与 lDDT-Cα 的皮尔逊相关 r = 0.829,pTM 与 TM-score 的 r = 0.909——即这两个分数可以放心用来挑结构。
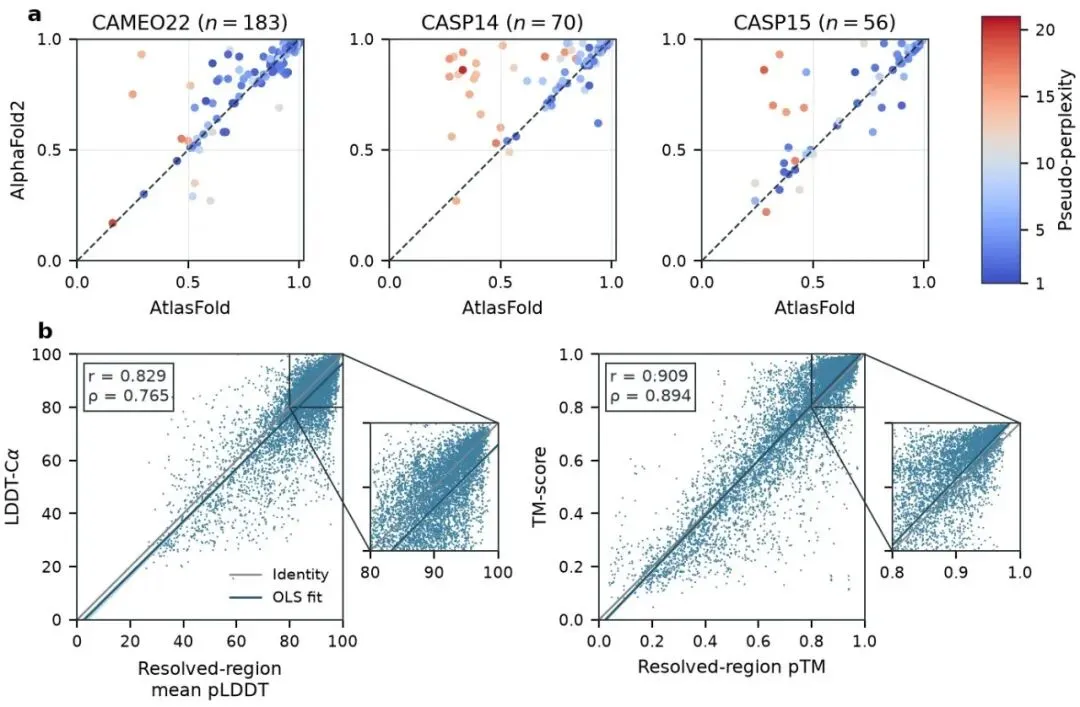
图4|AtlasLM 伪困惑度、结构精度与 AtlasFold 置信度之间的关系。(a) 三个基准上 AtlasFold 与 AlphaFold2 的 TM-score 对比,颜色表示伪困惑度——样本越"难",AlphaFold2 的优势越明显;(b) 置信度校准:pLDDT 对 lDDT-Cα(r=0.829)、pTM 对 TM-score(r=0.909)
把 AtlasFold 在蛋白复合物上微调 25,000 步,加上模板模块和 AlphaFold3 风格的置信度模块,就得到 AtlasFold-Multimer(AtlasFold-M)。
在 FoldBench 基准上(172 个抗体–抗原靶标 + 278 个蛋白–蛋白靶标,全部不使用模板),以 DockQ > 0.23 计成功率:
- 抗体–抗原
:AtlasFold-M 46.96%(图 5a 中 Top-1 为 47.0%),与 AlphaFold3(49.3%)、ESMFold2(48.6%)基本同档; - 蛋白–蛋白
:AtlasFold-M 63.36%,落后于 Protenix-v1(74.4%)、AlphaFold3(73.0%)、Boltz-1(71.1%)等。
团队没有回避短板:蛋白–蛋白上偏弱,可能源于 AtlasLM-3B 规模较小、且多聚体微调的规模有限。
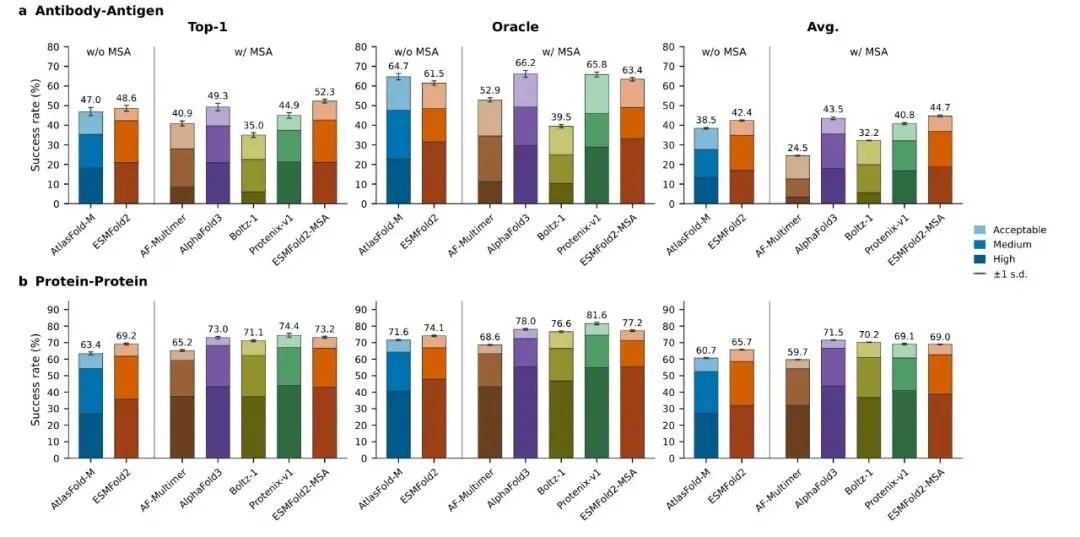
图5|FoldBench 上的复合物预测成功率。(a) 抗体–抗原子集;(b) 蛋白–蛋白子集。柱高为超过相应 DockQ 阈值的比例,分 Top-1、Oracle、Avg. 三种选择方式,误差棒为标准差
"只做蛋白"的取舍在推理效率上换回了实实在在的收益(单张 B200 GPU,不含 MSA 搜索):
- 单体
:1024 残基下,AtlasFold 生成 5 个结构耗时 11.57 秒;作为对比,AlphaFold2 1 个模型要 34.38 秒,ESMFold2 生成 5 个要 39.17 秒,SimpleFold-3B 单个要 88.01 秒; - 显存
:2048 残基时峰值 39.81 GiB,ESMFold2 需要 160.32 GiB; - 复合物
:1024 总残基下,AtlasFold-M 用 33.24 秒 / 16.05 GiB(5 样本、10 次 recycling、200 步扩散),对比 Protenix-v1 的 34.96 秒 / 22.00 GiB、ESMFold2 的 39.17 秒 / 45.24 GiB、Boltz-1 的 158.44 秒 / 32.63 GiB; - 批处理
:64 残基单体的吞吐从 0.775 提升到 9.663 条/秒(12.5 倍);256 残基复合物从 0.149 提升到 0.314 个/秒(2.1 倍)。
对需要大规模筛选的场景(比如上万个设计的自洽性复核),这组数字比精度榜上多一个百分点更实用。
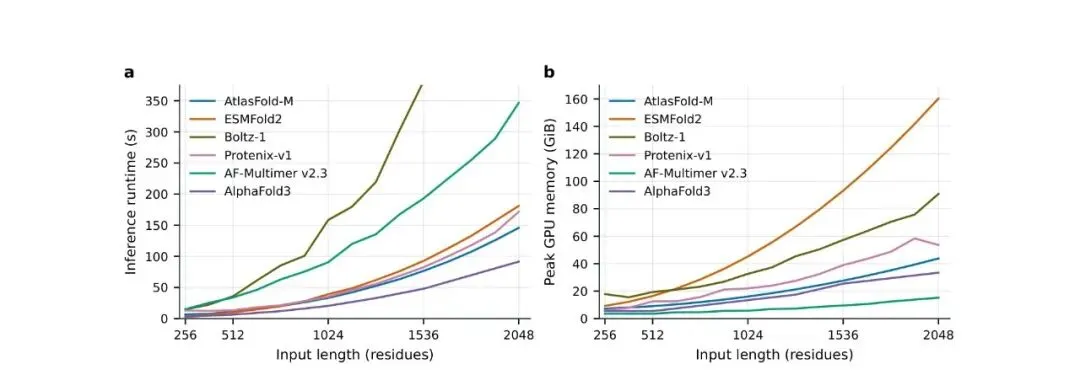
图6|单张 B200 GPU 上的推理性能。(a) 推理耗时随序列长度的变化;(b) 峰值显存随序列长度的变化。AtlasFold-M(蓝)在复合物预测中同时兼顾了速度与显存
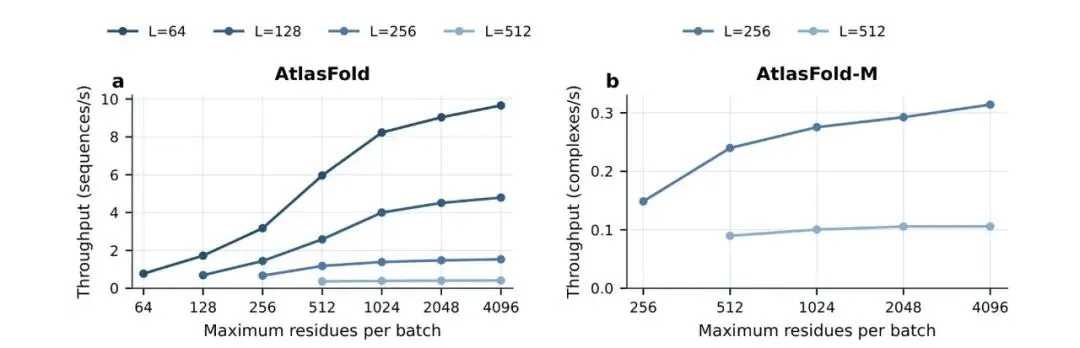
图7|批处理推理吞吐。(a) AtlasFold 单体的吞吐随每批最大残基数的变化;(b) AtlasFold-M 复合物的吞吐。扩散样本数为 5
AlphaFold3 论文曾把无序区里凭空出现的"有序结构"称为幻觉(hallucination)——这些区域通常置信度很低,但坐标却不像 AlphaFold2 那样呈延展的"飘带"状,而是挤成一团。
Atlas 团队复用了 AlphaFold3 分析中的两个例子(CAID2 靶标 DP02376 与 7F60 核孔复合物),结论是:
AtlasFold 在 DP02376 上更多保留了延展轨迹,只在预测的结构域附近有更多堆积; 但 ESMFold 也出现同样的假有序——它用的是不变点注意力结构模块,而非扩散式坐标生成器。说明这种幻觉并非扩散模型特有; 7F60 上,5 个 AlphaFold3 与 5 个 ESMFold2 样本全部出现假有序,AtlasFold-M 的 5 个样本中只出现 1 个(seed 1),且排序最高的那个不是有问题的样本。
团队的态度很克制:这些例子中低置信度堆积的现象在不同模型间有差异,不能简单归因于坐标生成架构。
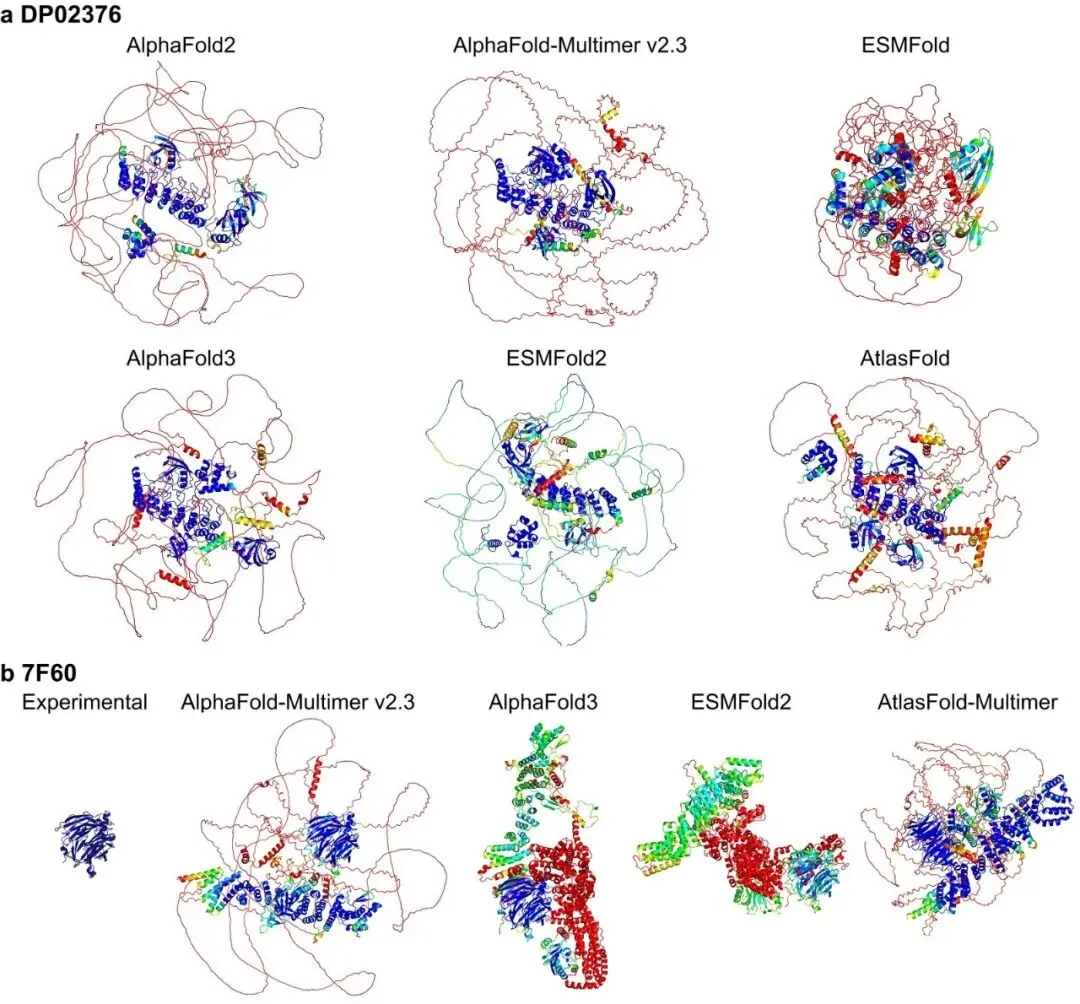
图8|低置信度无序区预测的定性比较,按 pLDDT 着色。(a) CAID2 靶标 DP02376;(b) 7F60 核孔复合物——实验结构中有 1,854 个残基未被解析
论文的"设计与训练观察"一节,比结果部分更值得读——作者把开发过程中的坑几乎全摊开了:
受 ESMFold2 启发去掉 triangle attention 后,训练在 3 万步附近反复梯度爆炸,只好恢复; 试过 ESMFold2 用的 AdamW,最终仍选 Adam(loss 下降更快、更少步数达到同等验证精度); 置信度模块最初沿用 AlphaFold3 的共享设计,加上 PAE 监督后反而损害了基于 pLDDT 的样本排序,于是拆成局部/成对两条独立路径并重新训练; 微调阶段引入 AlphaFold-Multimer 生成的同源/异源二聚体数据(同源二聚体采样率 8%、异源 2%)提升了蛋白–蛋白复合物预测,却让抗体–抗原性能下降,最终未采用。
而全文最有分量的一条,是关于语言模型路线的天花板:
团队把 ESMFold2 放到 CASP14 上评测——CASP14 就在它的训练集里。结果:ESMFold2 平均 TM-score 仅 0.736、GDT-TS 0.661,只比 AtlasFold 的 0.732 / 0.650 高一点点,仍远低于 AlphaFold2 的 0.844 / 0.784。
"见过答案"也没能抹平差距——这说明 PLM 路线的限制不只是泛化性,掩码语言建模学到的表征与三维结构预测之间,本身就不如 MSA 抽取的共演化约束来得直接。单靠把语言模型做大,未必能追上 MSA 路线。
但反过来,复合物预测上 ESMFold2(用 ESMC-6B)在 FoldBench 两个子集上都超过了 AtlasFold-M——说明在链间相互作用建模上,语言模型的规模优势仍然有意义。
开源部分(MIT 许可证):训练代码与数据、各阶段 checkpoint、模型权重,以及上面这一整套"踩坑记录"。这套组合的价值在于:AtlasFold-M 的路线证明了一个预训练好的单体折叠模型,只需 25,000 步微调就能拿到有竞争力的抗体–抗原精度——想研究共折叠的团队不必从零训练语言模型和折叠主干,门槛大幅降低。
已知局限(同样是团队自己写明的):
目前只支持蛋白,不支持配体、DNA、RNA——这部分留给后续工作 K-Fold; 蛋白–蛋白复合物精度落后头部共折叠模型,需要更大的语言模型骨架; 未做模板条件下的评测(尽管 AtlasFold-M 已内置模板模块); 与 ESMFold2 的对比受训练集重叠影响,部分基准上并非干净的"同台竞技"。
对做结构预测或蛋白设计的同学:你们现在的流程里,MSA 搜索占了多少时间?如果换成单序列模型能省下这一步,精度上你能接受多少损失?欢迎在评论区聊聊。
参考文献及代码:Seo S., Kim H., Moon S., Kim W.Y. AtlasFold: Protein structure prediction with metagenomic-scale language models. bioRxiv, 2026. DOI: 10.64898/2026.09.04.749352。代码:github.com/SeonghwanSeo/atlasfold