ARTICLE · 1019341
【AI笔记】用得越多,信得越少:84% 在用 AI,29% 信它

AI原生工作笔记 · 01 | 全文约 4500 字,建议阅读 11 分钟
一份挑不出毛病的制度,条款可能是编的
你有没有过类似的经验,让 AI 起草一份员工手册。它交出来的东西,从第一条排到最后一条,格式工整,条款齐整,看着挑不出毛病。
你通读一遍,没有语病,没有逻辑断裂,就这么放过去了。
只有一个问题:里面引用的法规依据、审批节点、部门权限,有相当一部分是编的。现实里没有那条规定,也没有那个审批环节。
你现在就可以试一次:翻出上一份让 AI 写的东西,挑三条带出处的表述,逐条核一遍。
这件事最吓人的地方不是 AI 编了,是它编得太像真的了。
语病和格式错误一眼就能看见,你马上就知道哪里不对。但"格式完美、内容虚构"的产出,很容易通过所有表面检查,只有真正熟悉这个方面的专家老手才看得出破绽——他知道哪条制度以前踩过坑、哪个流程该谁签、哪句话写下去会出事。
这不是知识问题,是判断力问题。它不理解你的组织,不理解后果,不理解"照着执行会怎样"。
合规审查、财务审计、人事决策、对外沟通,撞的是同一堵墙。训练数据覆盖不了你这家公司的边界条件。它不知道自己不知道。
用了,不等于用好了
来看一组更难堪的数字。
2023 年,全球最大开发者社区 Stack Overflow 的年度调查里,AI 编程工具的信任度是 40%。两年后,采用率从 70% 爬到 84%,信任度掉到 29%。
用得越多,信得越少。
先别急着说这是程序员的事。把同一个问题搬到你身上问一遍:你每天用 AI 写方案、改汇报、拟通知,信它的输出吗?比一年前更信,还是更不信?
通常一项技术是用得多了,熟了,信任自然上去。AI 反着来。
Stack Overflow 自己的分析给了一个精准判断:这是一条学习曲线,伪装成了信任问题。
这句话值得多想两分钟。
先看一个你身上就有的习惯。HR 期望同一份简历按同一套标准筛出同一个结论,律师期望同一条法规的检索结果稳定一致,医生期望同一组指标指向确定的诊断方向——大多数职业训练,整个建立在确定性上:同一个动作做两遍,得到同一个结果。
AI 把这条规矩打破了。同一个问题问两遍,两个答案、两种结构、两套取舍方案,都能跑。对习惯了确定性的人来说,这不是能力质疑,是一种更原始的不适:认知摩擦。
写代码的人最先撞上它,因为他们离确定性最近。但不是只有他们。
概率性系统闯进任何一份职业的地盘,先撞上的都不是"你行不行",是"我怎么跟你相处"。
96% 不信,48% 不查
更矛盾的行为数据在这里。
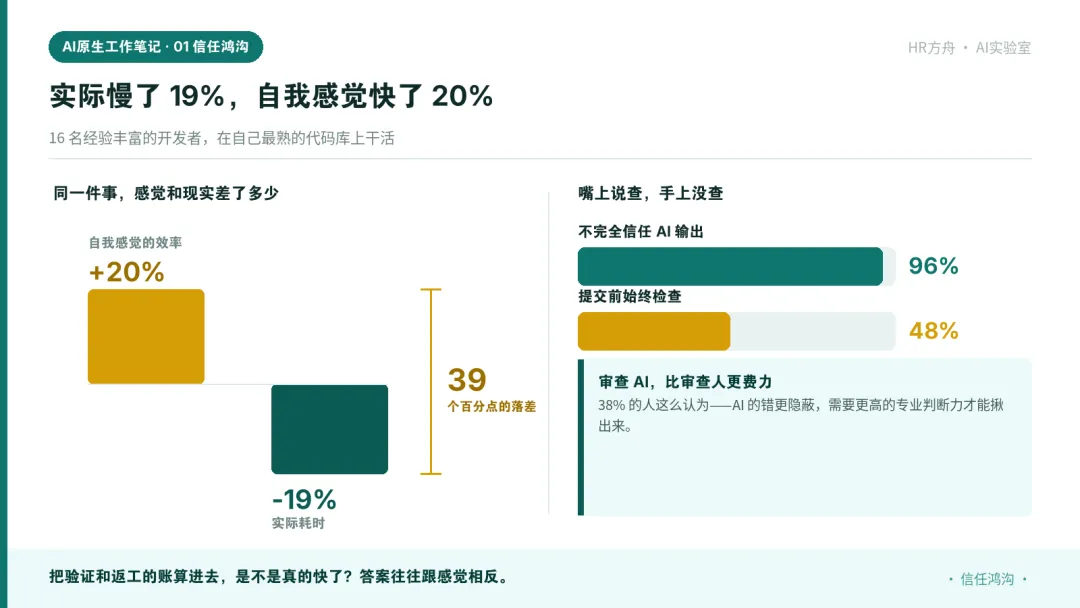
代码质量平台 Sonar 的调查:96% 的开发者不完全信任 AI 代码的功能正确性,但只有 48% 的人在提交前始终检查。
几乎所有人都说"我不信",一半人说完就点了提交。
这是一组针对开发者的数据。但那个动作模式,你在办公室里天天能看见:一份 AI 起草的方案、一张 AI 算出来的报表、一封 AI 拟好的对外通知——嘴上都说"这个得核一下",然后却实在懒得就这么发出去了。
为什么不查?不只是因为懒。38% 的开发者觉得审查 AI 代码比审查人类代码更费力。
为什么更费力?人类同事写错,通常错得比较明显。AI 写出来的是"看起来正确但不可靠"——不像语病那样直接暴露,而是把错误藏在一段读起来很顺的话里,需要更高的专业判断力才能揪出来。
这里藏着一个隐蔽的成本转移:AI 把"写"的工作量砍下来了,把"查"的负担顶上去了。查的成本一旦超出预期,人的反应不是更仔细地查,是不查了。
嘴上的不信任是安全的。手上的放行才危险。
更自信,但更差
比行为失控更麻烦的,是感知失真——你甚至不知道自己的判断已经偏了。
先说个你可能有的感觉:让一个做了十年的 HR,用 AI 处理他最熟的那块业务,他大概率会觉得快了不少。但把验证和返工的账算进去,是不是真的快了?答案往往跟感觉相反。
这不是印象,有实验数据。
斯坦福大学的一个研究团队做过一项随机对照实验:用 AI 助手的参与者,在多数安全编程任务中写出了更多不安全的代码。而写出不安全代码的那批人,对 AI 的信任评分反而更高。
你越觉得它帮了你,它越可能在坑你。
那经验丰富的老手能不能躲开?AI 安全评估机构 METR 在 2025 年做了另一个实验。16 名经验丰富的开源开发者,在自己贡献多年的代码仓库里干活,用的是前沿模型。
结果:实际慢了 19%,自我感觉快了 20%。
感知和现实之间差了 39 个百分点。
研究团队也指出了边界:在不熟悉的领域或简单任务上,AI 可能确实有帮助。但在高标准、复杂隐含要求的场景下,验证和整合 AI 输出的开销,很容易把速度收益吃回去了。
两种情况里,人们对自身表现的判断都偏向乐观。要么留下了带风险的产出,要么增加了人工检查,反而更慢。
失败之后的信任,比从未失败的更结实
那信任还能修吗?能,而且修好之后比原来更结实。
首尔国立大学做过两个实验,样本分别是 189 人和 294 人。他们发现信任不是一个静态指标,是一条有形状的曲线:
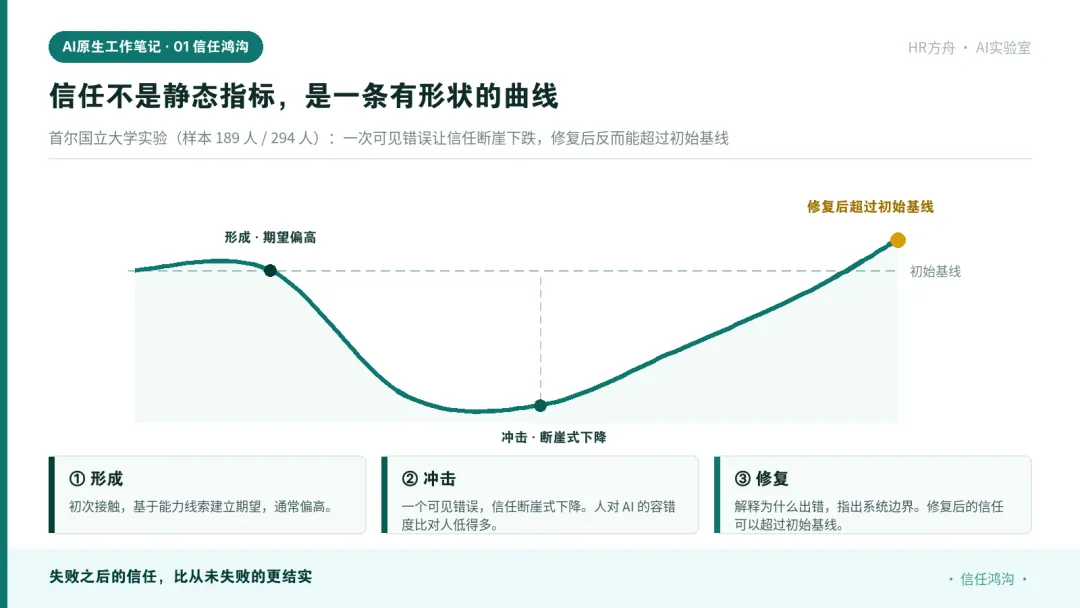
第一阶段,形成。初次接触,基于能力线索建立期望,通常偏高。
第二阶段,冲击。一个可见错误,信任断崖式下降。人对 AI 的容错度比对人低得多——研究者管这叫"完美自动化图式",你下意识觉得机器就应该是对的,有幻觉即不可用。
第三阶段,修复。解释为什么出错,指出系统边界,信任部分恢复。
意外的发现在第三阶段:修复后的信任可以超过初始基线。经历过错误并被正确解释的信任,比从未经历过错误的信任更结实。研究者叫它"信任加速悖论"。
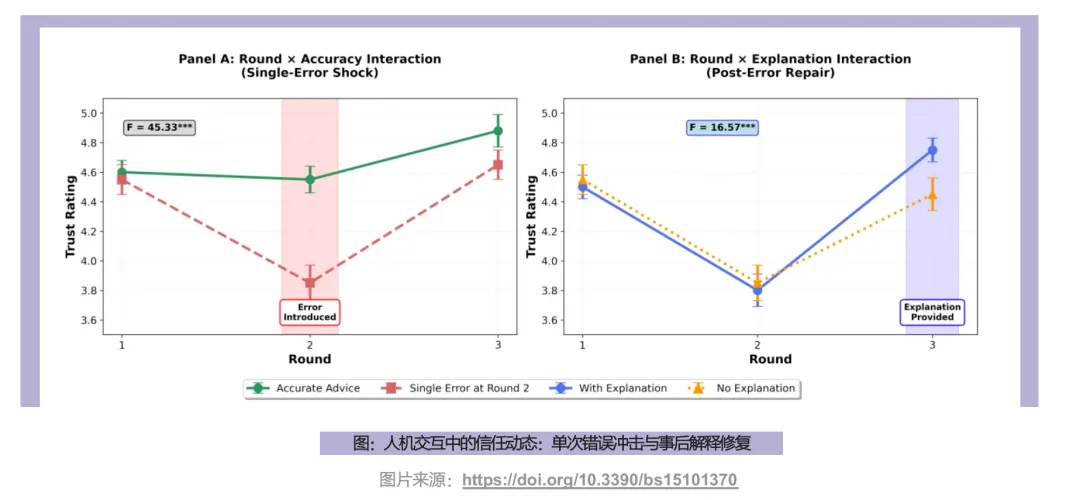
这个结论放到职场里一点都不陌生。
你信任一个医生,不是因为他从来没误诊过,而是因为你见过他发现误诊之后怎么纠正、怎么坦诚、怎么调整方案。
放到团队里,这条特别值钱:一个员工第一次用 AI 出了错,你的反应基本决定了往后的走向——压下去、只批评不修流程,他以后只会偷偷用,你再也看不见风险;把错摊开讲清楚、把边界定明白,他反而会主动告诉你他在哪儿踩过坑。
可靠不等于不出错。可靠是出错之后怎么处理。
所以该做的从来不是追求零幻觉、零失败,而是设计"可控失败 + 透明修复"的流程。让错误发生在能接住的地方,让修复过程被看见。
分寸在哪:依赖与控制
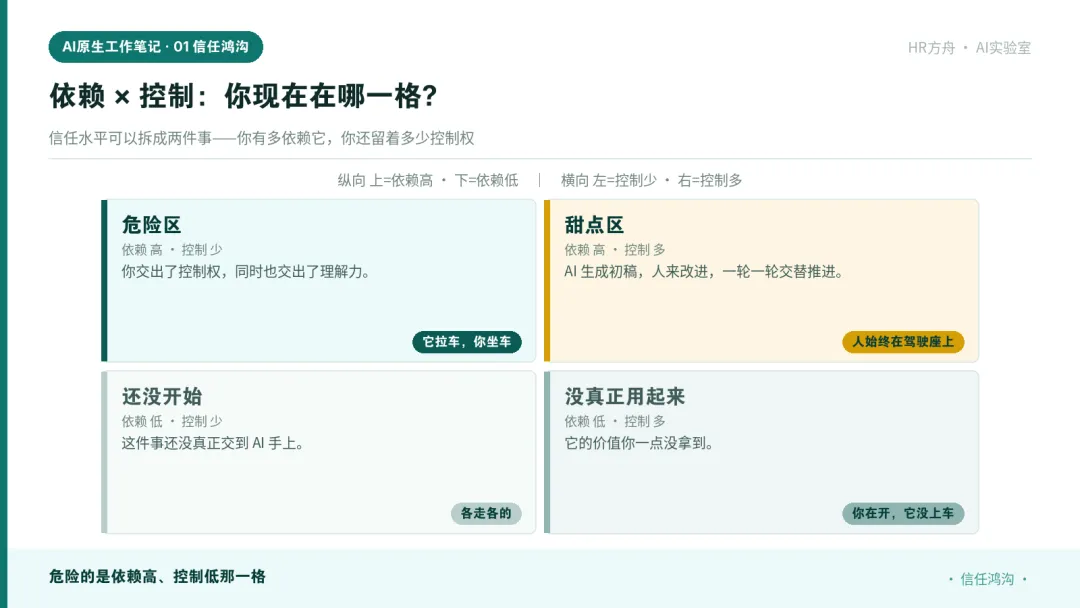
有一项访谈了一线使用者的研究,发现信任水平可以拆成两件事来看:你有多依赖它,你还留着多少控制权。
危险的是依赖高、控制低那一格。你交出了控制权,同时也交出了理解力。
控制高、依赖低,等于没真正用起来,它的价值你一点没拿到。
"甜点"在中间:AI 生成初稿,人来改进,一轮一轮交替推进,人始终在驾驶座上。
说到底就是两个问题——这件事 AI 能做几分?你愿意让它做几分?
工具形态也有讲究。有的场景需要在过程里持续审查、持续介入;有的场景对话式更友好、上手更快。工具没有高下,匹配你需要的控制程度就是对的。
配套的一项脑电实验还发现,长期依赖 AI 的人在神经和行为层面持续表现不佳,研究者管这叫"认知债务"。你以为在省力,其实在预支判断力。
过度依赖还有个副作用:人花时间琢磨怎么跟 AI 说话,而不是和同事讨论问题。跟机器对话多了,跟人对话就少了。
镜头拉远:组织层面的故事更难受
个体的学习曲线还没走完,组织这边已经出问题了。
MIT 斯隆管理学院的数据:95% 的企业 AI 试点没有产生可衡量的业务回报。88% 的组织在用 AI,但只有 7% 真正整合进了业务流程。
BCG 和哥伦比亚商学院发现了高管和员工之间的感知断层:76% 的高管认为员工对 AI 充满热情,实际只有 31% 的一线员工有此感受。42% 的高管层承认 AI 采用正在"撕裂公司",31% 的员工承认主动破坏 AI 推广。
最后这个数字值得停一下。将近三分之一的员工在主动破坏公司推的 AI 项目。
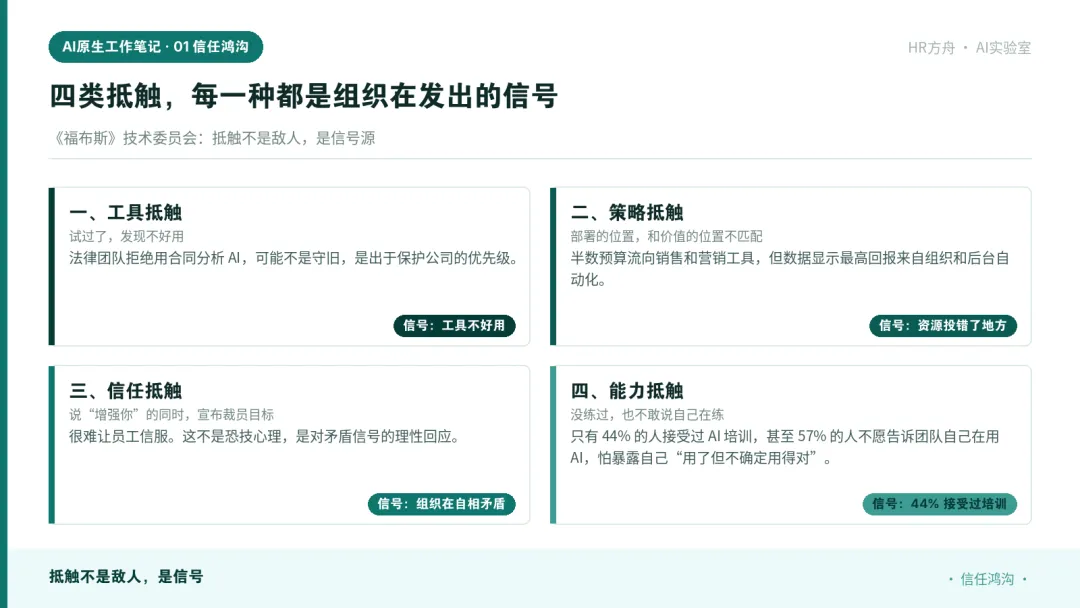
《福布斯》技术委员会给了另一个视角,四类抵触,每一种都是组织在发出的信号:
一、工具抵触:试过了,发现不好用。法律团队拒绝用合同分析 AI,可能不是守旧,是出于保护公司的优先级。
二、策略抵触:AI 部署的位置和价值位置不匹配。半数预算流向销售和营销工具,但数据显示最高回报来自组织和后台自动化。
三、信任抵触:领导层说"AI 是来增强你的",同时宣布裁员目标。很难让员工信服。这不是恐技心理,是对矛盾信号的理性回应。
四、能力抵触:只有 44% 的人接受过 AI 培训,甚至 57% 的人不愿告诉团队自己在用 AI,怕暴露自己"用了但不确定用得对"。
MIT 研究者的总结一语中的:规模化的核心障碍不是基础设施、不是监管、不是人才,是学习。
抵触不是敌人,是信号
推 AI 这件事,经验其实很朴素:提供一个安全的、持续的讨论空间,打消团队成员对 AI 的抵触情绪,帮助大家把握迭代方向——这比传授具体的 AI 技术更难,也更重要。
在团队里公开讨论 AI 的使用。不是搞培训,是坦诚的交流,同事之间,同事与 AI 之间。
信任不是培训出来的,是在透明的对话中长出来的。
这句话对 HR 和管理者的分量,比任何一条工具技巧都重。员工抵触,往往不是反对 AI,是在回应组织发出的矛盾信号——一边说增强你,一边算替代你;一边推工具,一边不给练习时间;一边要效果,一边不容许试错。
下次复盘,问这四个问题
信任鸿沟不是一个需要解决然后翻篇的问题。它会一直在那儿。这不是坏事。对一个概率性系统保持警觉,本身是健康的。
问题从来不是"你信不信 AI",而是——
你的信任是否经过校准。
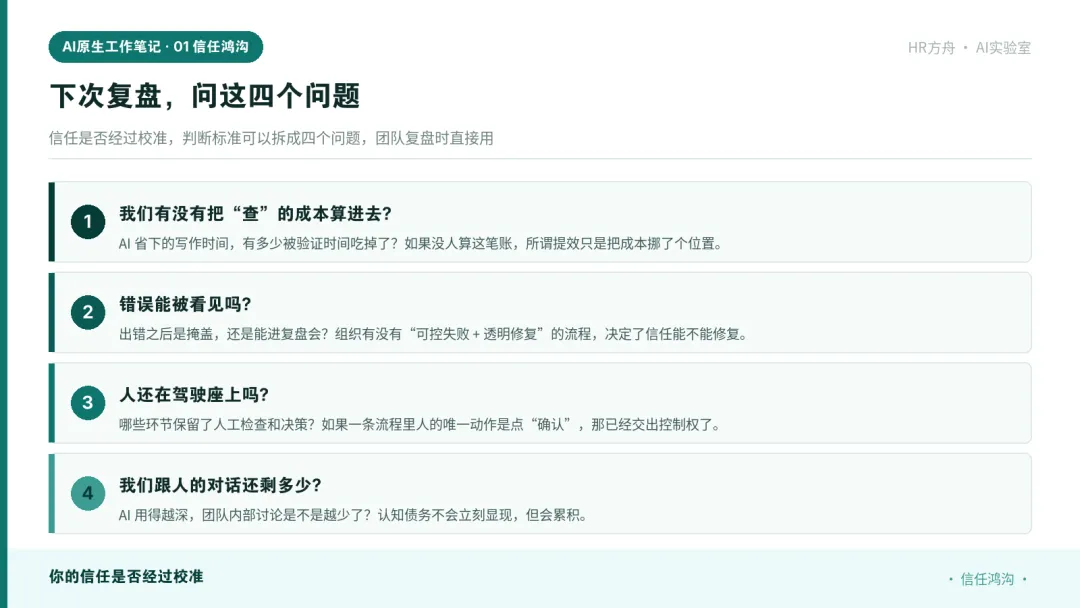
判断标准可以拆成四个问题,下次团队复盘时可以直接用:
1. 我们有没有把"查"的成本算进去?AI 省下的写作时间,有多少被验证时间吃掉了?如果没人算这笔账,所谓提效只是把成本挪了个位置。
2. 错误能被看见吗?出错之后是掩盖,还是能进复盘会?组织有没有"可控失败 + 透明修复"的流程,决定了信任能不能修复。
3. 人还在驾驶座上吗?哪些环节保留了人工检查和决策?如果一条流程里人的唯一动作是点"确认",那已经交出控制权了。
4. 我们跟人的对话还剩多少?AI 用得越深,团队内部讨论是不是越少了?认知债务不会立刻显现,但会累积。
【信源】
Stack Overflow《Mind the Gap: Closing the Developer AI Trust Gap》(2026-02-18);
Sonar《The AI Trust Gap: Why Code Verification Matters》(2026-01-22);
Perry N. et al.,《Do Users Write More Insecure Code with AI Assistants?》, ACM CCS 2023;
METR《Measuring the Impact of Early-2025 AI on Experienced Open Source Developer Productivity》(2025-07-10);
Han J.,《Trust Formation, Error Impact, and Repair in Human–AI Financial Advisory》, Behavioral Sciences 15(10), 2025;
Ferino S. et al.,《Towards an Appropriate Level of Reliance on AI》, FSE 2026;MIT Sloan;
BCG & 哥伦比亚商学院;Forbes Technology Council (2026-02-05)
👉
你的团队里
说"我不太信 AI 输出"的人
和真的会去逐条检查的人
是同一批吗?
欢迎在留言区里聊聊你的观察