ARTICLE · 1019583
AI 洞察 | 黄仁勋昨日站台Koa,模型层不再是护城河
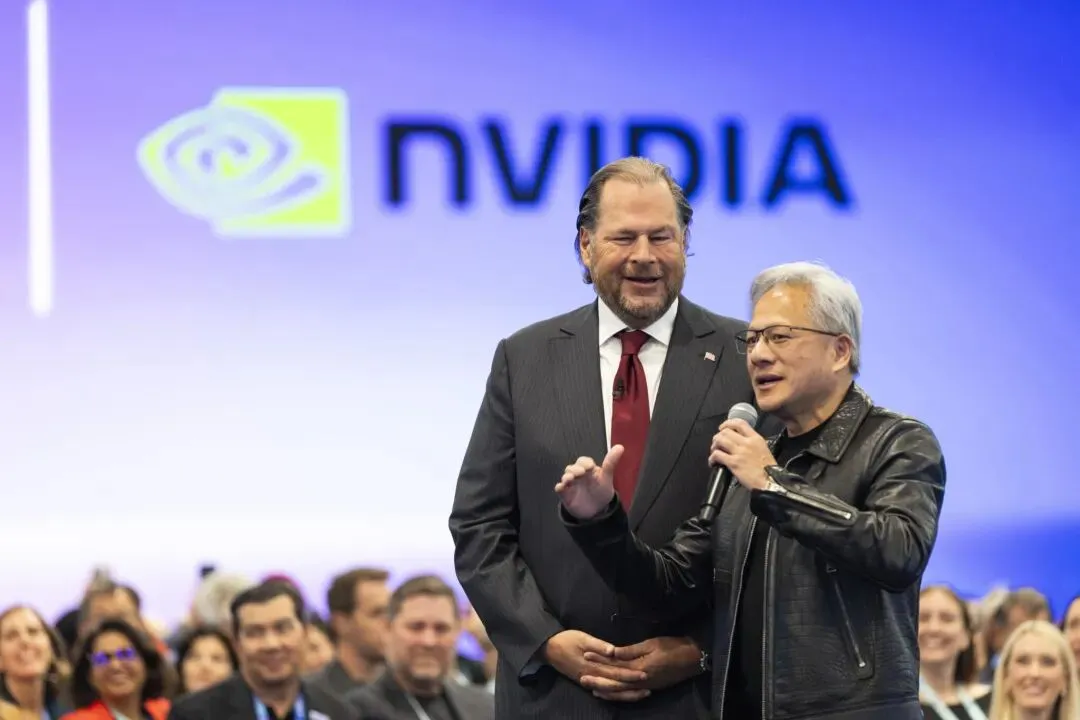
当地时间2026年9月15日,在旧金山举行的Salesforce Dreamforce大会上,英伟达CEO黄仁勋站上Salesforce Dreamforce的舞台,和Marc Benioff一前一后走进观众席,穿过人群。他在会上表示,AI行业没有必要出台任何新法律——这一观点使其与美国总统特朗普站在了同一阵营。同一天,Salesforce发布了自家第一个CRM推理模型Koa,底座是英伟达的Nemotron 3 Super。黄仁勋给这场合作配了句总结:电力时代能驱动一切,互联网时代能找到一切,AI作为基础设施铺满地球之后,“我们能知道一切,也能做一切”。
对创业者来说,这场发布的信号不在台上,而在台下的分工。Salesforce没有向OpenAI或Anthropic买模型,而是拿一个开放底座自己后训练,把权重、推理、数据全攥在自己手里。有三点值得重新算账。其一,企业软件正在从“调用大模型API”转向“自己造模型”,模型层不再是一道护城河,而是一层可以被巨头自建的成本项。其二,黄仁勋给出一个数字:开放模型在企业里的占比从去年初的30%涨到现在约70%,自建正在成为主流动作。其三,也是最该警惕的——当行业巨头把算力、模型、行业数据合成一个联合体,夹在中间的模型层和通用工具层会最先被挤掉。做这层生意的团队,要尽早想清楚自己站的位置。
全文 3032 字,预计阅读时间 6 分钟
O1
一场把模型搬进自家机房的发布
这场戏发生在Dreamforce的舞台上。黄仁勋没有只待在台上,他拿着麦克风走进观众席,Benioff跟在旁边,说了句“我们都跟着你,兄弟”,引来一片掌声。
发布的主角Koa,是Salesforce第一个CRM推理模型。它的做法很清楚:拿近三十年企业CRM部署积累的数据,做成合成数据集,对英伟达Nemotron 3 Super做后训练。底座是别人的,但喂进去的行业知识和最终权重是Salesforce自己的。Salesforce平台与工程总裁Rohan Kumar在介绍Koa时给出一句硬承诺:训练和推理过程里,“没有用到任何一个字节的客户数据”。
这套安排的关键在“开放”两个字。因为Nemotron是开放的,Salesforce可以在自己的基础设施里完成微调和运行,权重归自己,模型跑在自己机器上,客户数据不出门。对一家天天被企业客户追问数据合规的公司来说,这是能不能用AI的前提。
Koa的工程细节也不含糊。团队用监督微调配合强化学习来训练,工具是英伟达的NeMo RL、NeMo Gym和NeMo AutoModel。训练语料覆盖制造、金融服务、医疗、旅游等14个以上行业的合成企业场景。在Salesforce自己的CRM Bench上——一套包含更新商机、路由工单、安排跟进等真实任务的评测——Koa在CRM动作上的表现已经追平或超过领先模型,同时错误少了3倍。
落地节奏也给了出来:Koa已经在Salesforce内部跑起来,在Slack里驱动一个员工agent;10月进入客户试点,作为Agentforce里可选的模型,首批包括F1、UChicago Medicine、Baxter Credit Union、1-800Accountant、Engine、Xero;美国区域的正式商用预计在2026年冬季。
O2
巨头为什么突然都要自己造模型
发布会表面是产品,实际是一次立场表态。
先看英伟达的位置。黄仁勋反复讲一个判断:“每一家公司、每一家企业、每一个国家都会变成AI公司。它会是一个agentic enterprise(代理式企业)。”英伟达自己是这个判断的样板——它在销售、服务、市场、运营上都跑在Salesforce上,还在试点用Agentforce做客服工作流。芯片厂商用自己的业务给软件厂商站台,同时把Nemotron这个底座塞进对方的机房,一进一出,算力和模型都被绑进了同一个生态。
再看Salesforce的算盘。它选择开放底座而不是闭源API,本质是把“模型能力”从外部采购变成内部可控。这个选择有几个直接好处:成本上不按token付钱,数据上不出自家合规边界,产品上可以针对CRM动作做深度优化。Koa在CRM Bench上“错误少3倍”,就是这种深度优化的结果——通用模型再强,也不会专门为“更新一条商机”这种动作去调。
黄仁勋顺手给了一个能说明趋势的数字:开放模型在企业中的占比,从去年年初的30%,涨到现在约70%。他没有展开统计口径,但这个量级的变化和Salesforce的选择互相印证——企业正在把模型当成自建的基础设施,而不是租来的能力。
这里还有一层没被重点讲的动机:数据主权。企业客户最敏感的问题,是业务数据会不会被拿去训练别人的模型。Salesforce的办法是把模型搬进自家机房,用开放底座后训练,客户数据一个字节都不出训练和推理流程。Rohan在台上强调的这句话,不是技术炫技,是给企业客户的合规答卷。谁能解决数据不出门的问题,谁就能拿到最保守那批客户——而恰恰是这批客户,付费能力和续约稳定性都最强。
当巨头开始自己造模型,卖通用模型和通用工具的公司,会发现客户正在变成竞争对手。Salesforce有行业数据、有客户入口、有算力伙伴,缺的只是模型这一环,而这一环现在可以用开放底座补齐。补齐之后,它对通用模型的依赖会迅速下降。这条逻辑放到任何一家有存量数据的大厂身上,都成立。
O3
中间层正被两头夹空
这场合作最值得盯住的,是它对行业分层的影响。
往上看,算力层和模型底座层正被少数玩家把持。英伟达提供Nemotron这样的开放底座,看起来是“开放”,实际上把上层的微调、运行、工具链(NeMo系列)都收进了自己的体系。企业越是用开放底座自建,越是深地嵌进英伟达的软硬件栈。开放,成了一种更牢固的绑定方式。
往下看,有行业数据的企业正在自建模型。Salesforce拿三十年CRM数据训练Koa,这种数据壁垒是通用模型公司买不到的。医疗、金融、制造这些行业里,谁手里攥着高质量的业务数据,谁就有条件把模型做进自己的产品。Koa首批试点客户里有医院(UChicago Medicine)、有金融机构(Baxter Credit Union)、有会计师服务(1-800Accountant)、有车队管理(Engine)、有财税软件(Xero)、甚至有F1车队——这些行业数据一旦回流,模型会越用越准。
夹在中间的,正是那些既不掌握算力底座、也不掌握行业数据的通用模型层和通用工具层。往上,算力和底座被英伟达这类玩家收走;往下,行业数据和场景被Salesforce这类玩家自建。中间层的窗口,正在被两头一起关小。
对创业公司来说,这轮变化给出了两种活法。一种是往行业数据壁垒里钻——把某个垂直场景的数据做到别人拿不到,让模型离开你的数据就做不好。另一种是往应用和最后一公里钻——通用能力会被巨头拉平,但把一个具体工作流打磨到极致、把交付做扎实,仍有空间。最危险的,是留在中间:既没有独家数据,也没有场景深度,只靠“调用模型+套壳”,很容易被上下游同时替代。
回到Salesforce这个动作本身,它挑的切口很聪明。CRM里的动作——更新一条商机、路由一个工单、安排一次跟进——看起来琐碎,却是企业每天发生频次最高、最容易被量化收益的环节。Koa不去拼通用推理的榜单,只把这些高频动作做到错误更少,就能直接换算成销售和客服的人力节省。这种“不追最强、只追最贴业务”的打法,正是通用模型公司很难复制的——它们没有这些动作的真实数据,也没有动力为某一个行业把模型调这么细。
O4
一个正在收紧的窗口
Salesforce和英伟达的这次联手,目前信息主要来自英伟达官方博客和Dreamforce现场,Koa的真实表现还要等10月客户试点和2026年冬季商用之后才能验证。CRM Bench是Salesforce自己的评测,错误少3倍这个数字,缺乏第三方交叉验证。
但方向已经清楚:模型的竞争,正在从“谁的模型更强”转向“谁能把模型和自己独有的数据、场景、基础设施焊在一起”。Salesforce给出的答案是把模型搬进自家机房。黄仁勋给出的答案是开放底座加工具链,让所有人都按这套方式自建。
接下来值得盯的,不是Koa又涨了几个点,而是三个问题:会不会有更多行业巨头跟进自建模型,把“买API”彻底换成“自己训”;英伟达的开放底座会不会成为企业自建的事实标准,把整个行业锁进它的软硬件栈;以及那些被夹在中间的通用模型公司和工具公司,是往垂直数据里退,还是被挤到没有生意可做。窗口在收紧,但答案还没落地。
- END -
世界是被创造的,我们关注每一粒即将改变世界的种子,让创造不再孤单,wteam。
wteam每年招募100位大学生创业者,提供2年的陪伴成长周期。截至目前,wteam已汇聚400+创业者,覆盖近200所高校。wteam秋季招募进行中,戳下方立即申请加入!
梦想 | 坚韧 | 传承