ARTICLE · 1020282
当未发表的数学成果遇上AI工具:研究者凭什么信任OpenAI?
一项关于数学研究者是否敢把未发表成果交给OpenAI的讨论,牵出AI数据使用的信任难题。本文分析研究者的担忧所在、OpenAI的数据政策现状,以及科研场景下可信AI需要满足的条件。
数学研究者的未发表成果,是职业生涯里最脆弱的资产。一个尚未公布的证明,可能倾注了数月心血,一旦被抢先发表,所有努力付诸东流。因此,当有人开始认真询问“能否把未发表的数学问题提交给OpenAI”时,这个问题注定扎手。
数学家放在AI对话里的内容,到底算不算敏感数据?AI厂商会怎么处理这些输入?在AI能力越来越强的当下,这个疑问不再只是隐私洁癖者的担忧,而是关乎科研诚信和学术生态的现实命题。
未发表成果,比代码更需要保护
数学未发表成果和普通技术代码或商业机密有本质不同。一篇论文预印本一旦公开,核心思想和证明思路就进入公共领域,瞬间失去排他性。在正式出版或公开预印本之前,任何未经授权的泄露都相当于给竞争者递刀。
更棘手的是,数学问题的“答案”往往就是“证明过程”本身。你把一个猜想丢给AI,AI如果真能给出思路,那这个思路就属于你了吗?平台方有没有权利保留并用于后续训练?如果系统在未来回答另一个用户时“回忆”出类似方法,算不算泄露?这些都是清晰且现实的边界问题。
社区目前的普遍反馈是:数学研究者对AI工具的信任度,远低于对传统同行评审过程的信任。原因很简单,同行评审有保密协议约束,而AI平台的数据处理政策往往是一份数十页的条款,没人逐条读,更没人能验证执行情况。
OpenAI默认的数据使用逻辑是什么
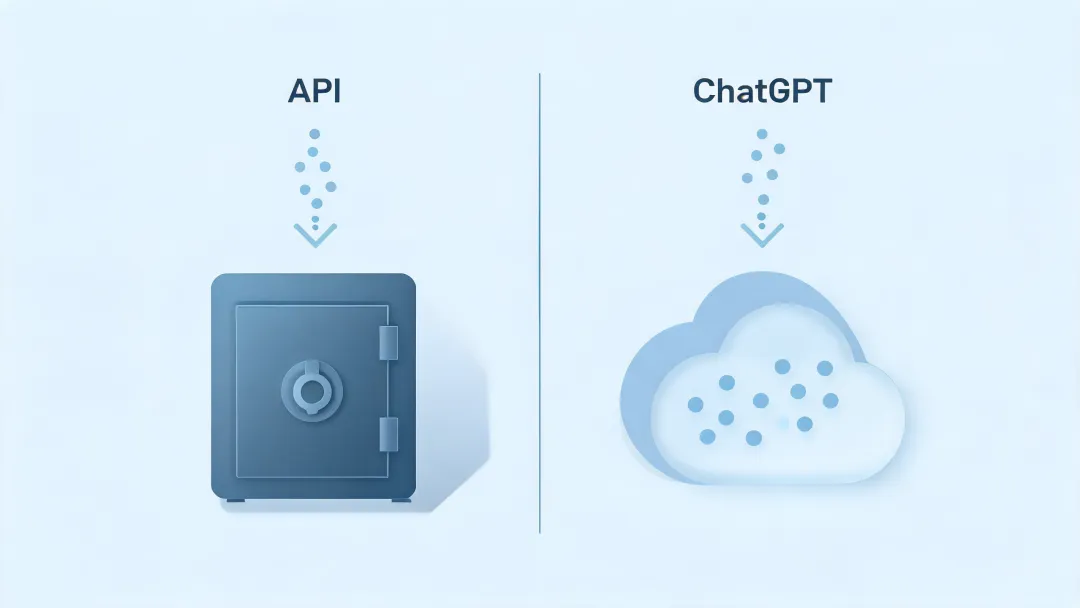
OpenAI的服务条款里写得很明白:通过API发送的数据,默认不会用于训练模型;但普通ChatGPT会话的输入,会被用于改进服务,除非用户主动关闭某个设置。这个差异,很多人一开始并不清楚。
即便有“不训练”的承诺,研究者依然面临几个现实问题。第一,平台内部是否完全隔离数据?员工能否访问对话记录?是否有第三方审计?这些透明度都有限。第二,即使数据不用来训练,服务器上会保留多久?删除机制是什么?在安全漏洞或法律传票面前,这些承诺是否站得住脚?
对于数学这种高价值、高持久性的智力资产,仅仅一句“不用于训练”远远不够。研究者需要的是可验证的承诺:比如保留期限明确、删除可审计、发生泄露时有清晰的责任划分。而目前,除了信任和口头保障,研究者手里几乎没有其他筹码。
研究场景为什么格外敏感
数学研究有一个特点:成果的价值随时间指数衰减。一个证明晚发表三个月,影响力可能大幅缩水。这就使得“数据使用期限”变得至关重要。即便AI平台承诺不训练,但若数据被内部人员查看、或被滥用于内部研究,同样会造成实质性伤害。
另一个容易被忽略的点是:AI模型的训练记忆是否等同于人脑记忆?人脑读过一篇预印本,之后独立想出类似证明,通常不构成抄袭。但模型如果从训练数据中学到了未发表证明的“模式”,它在输出时是否会无意识地重组、复现?这在法律和学术伦理上都是全新的灰色地带。
目前没有任何判例或明确法规来界定“AI模型的训练记忆是否构成发表行为”。研究者只能假设最坏情况:只要数据进了模型,就默认可被内化。在这种前提下,把核心未发表成果交给AI,风险和收益的权衡就变得非常微妙。
科研场景需要什么样的AI信任机制
要真正解决信任问题,单靠企业自律远远不够。科研场景需要一套可验证的机制,至少包含三项核心能力。
一是数据隔离认证。平台应该提供可审计的系统,让研究者能确认自己的数据在传输、存储、处理各环节都没有离开指定区域,且有第三方独立验证,而不是只给一个“承诺”。
二是训练记忆抹除。当研究者撤回数据后,模型是否真的“遗忘”?现在的机器学习领域,“机器遗忘”虽被广泛研究,但尚未成为任何主流产品的标准功能。如果做不到,就必须明确告知用户:你的数据参与了模型训练,无法单独删除。
三是法律追责路径。一旦发生泄露,研究者能通过什么渠道维权?目前,大多数AI条款都有免责声明,把数据安全责任推给用户或基础设施提供商,真正的责任主体很模糊。
给研究者的一条现实建议
在机制成熟之前,数学研究者使用AI工具时,应该做一次风险分层。
低风险操作:用AI做文献检索、检查论证格式、生成初稿背景部分,这类输入不包含核心证明,可以放心使用。
中等风险操作:让AI审查某个中间引理,但要对原始问题做脱敏和变形处理,不完整呈现全貌。
高风险操作:把未发表的完整证明喂给AI进行重构或验证。在没有任何保密协议和可审计保证的前提下,这类操作应当尽量避免。
可以期待的是,随着科研界对AI工具依赖加深,类似“科研专用数据开关”“学术数据租借协议”等模式会出现。但现阶段,自由研究者与其赌一把平台的道德,不如先把核心成果锁在保险柜里,只给AI看几个无关紧要的侧影。
如果未来某天,一家AI公司能向研究者展示一套经过审计的数据隔离日志,并承诺在模型更新时提供“遗忘”证明,那才是数学界真正信任AI的时刻。在那之前,所有未发表的数学成果,都值得被更谨慎地对待。
来源
More questions about whether researchers can trust OpenAI with unpublished math