ARTICLE · 1024469
别再学一堆AI工具了:真正会做视频的人,都在搭自己的“内容生产线”
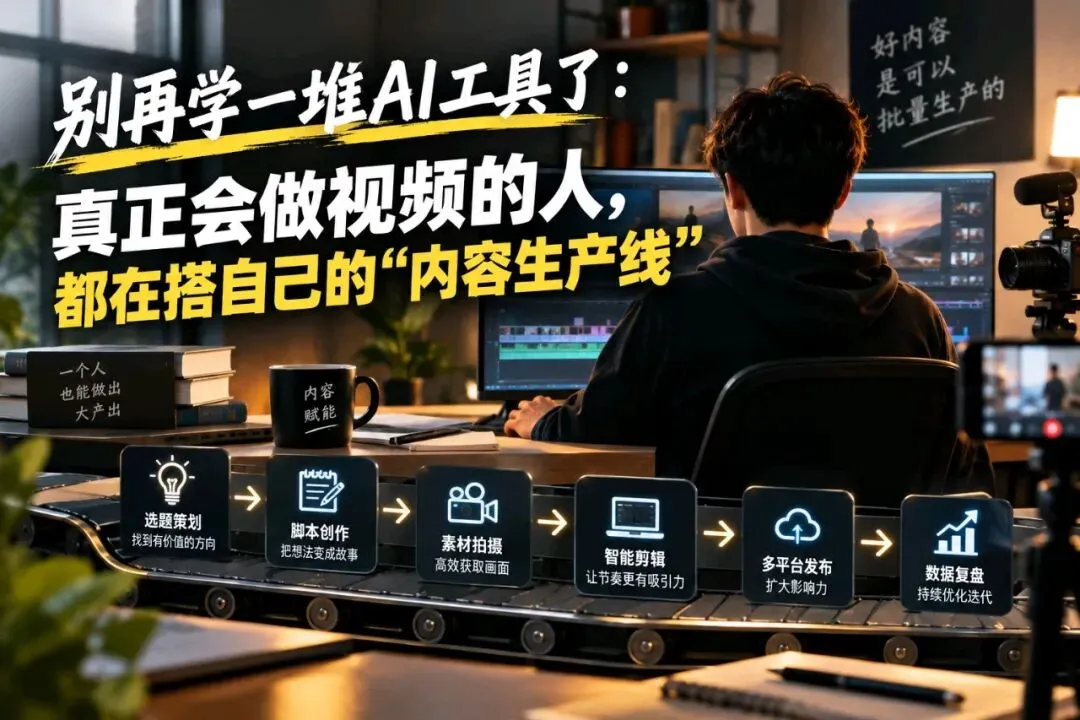
我以前也犯过一个很常见的错误。
看到一条抖音视频爆了,第一反应是:
怎么把它做出来?
于是开始找工具。
拆视频、改文案、换素材、配声音、做字幕,折腾几个小时,终于导出了一条成片。
画面没问题,声音也挺清楚。
可看完以后,总觉得差了点什么。
不像一个真正成熟的账号做出来的东西。
更麻烦的是,第二条视频来了。
一切从头再来。
重新找参考,重新写稿,重新找素材,重新调声音。
做到后来我才意识到:
AI确实可以替你干活,但如果你没有一套稳定的方法,它只会让你更快地重复劳动。
真正值得复制的,从来不是一条爆款视频。
而是它背后的生产逻辑。
先别急着做,第一步是把爆款拆明白
我之前用 Codex 和 Hyperframes 跑过一遍抖音图书号的视频制作流程。
原本以为,事情很简单:
找一条爆款,拆开,然后重新做一条。
真正动手以后才发现,一条30多秒的视频,里面藏着很多细节。
为什么第一句话放在这里?
为什么前几秒不是介绍产品,而是先抛一个问题?
旁白说到哪一句,画面发生变化?
字幕为什么偏偏在这个时间出现?
哪里需要停顿?
什么时候需要音乐变化?
这些东西如果不拆开,你看到的只是一条视频。
拆开以后,才会发现:
爆款不是一团灵感,而是一套被反复验证过的结构。
所以第一次做对标,我不会让 AI 直接“仿一条”。
而是先把它拆成时间轴:
前3秒负责什么。
中间怎么推进。
什么时候换画面。
字幕怎么出现。
最后怎么收。
然后整理成一张镜头施工表。
这一步看起来慢。
实际上是在给后面省时间。
旁白没定下来之前,不要急着做画面
很多人做 AI 视频,顺序刚好反过来。
先生成漂亮画面。
一个镜头接一个镜头。
等画面做完了,才发现旁白不顺。
于是改旁白。
旁白一改,时间轴变了。
时间轴一变,前面的镜头又得重做。
几个小时就这样没了。
所以我后来把顺序固定下来:
先定规格,再写旁白;旁白定了,再做声音;声音稳定以后,最后才做画面。
比如:
9:16。
30—45秒。
中文。
知识类。
确定这些以后,再写旁白。
旁白确定下来,再拆成几个段落,每一段对应一个画面任务。
这一段说什么。
持续几秒。
画面出现什么。
字幕放哪里。
需要什么素材。
把这些提前列出来,后面就不容易乱。
做视频其实很像施工。
没有图纸就直接开工,返工几乎是必然的。
声音,往往决定一条视频有没有“人味”
有些 AI 视频,画面已经做得很漂亮。
但听十秒,还是会觉得:
“这是 AI。”
问题往往不在字。
而在声音。
语速太平均。
停顿太机械。
重音没有变化。
一句话从头到尾像一条直线。
所以声音这一步,我反而建议慢一点。
先把最终旁白做出来。
试听。
调整语速、停顿和音色。
直到声音基本稳定,再去生成字幕。
字幕不要靠手工猜时间。
最终音频是什么节奏,字幕就应该跟着什么节奏走。
所以我的顺序一直是:
旁白定稿 → TTS → 试听 → 调整 → 最终音频 → transcript → 字幕时间轴。
很多所谓的“AI味”,其实并不是一句话写得不好。
可能只是声音停错了半秒。
也可能是字幕出现得太早。
这些小问题,观众不一定说得出来。
但他会本能地觉得:
不自然。
画面也别让 AI 一次性自由发挥
声音稳定以后,再进入画面。
这时候,把前面整理好的镜头表交给 Hyperframes 这样的执行工具。
但不要一句:
“帮我生成整条视频。”
然后等结果。
最好把镜头一个个说清楚。
比如:
Scene 01,0—3秒。
旁白是什么。
画面主体是什么。
字幕是什么。
需要什么素材。
Scene 02,3—8秒。
继续往下。
这样出了问题以后,你知道该改哪里。
字幕挡住人物?
改字幕层。
画面太乱?
改构图。
节奏太慢?
改镜头时长。
声音和字幕对不上?
重新根据最终音频生成 transcript。
所以第一次生成,不要急着 Render。
先 Preview。
看看字体。
看看字幕。
看看画幅。
看看画面有没有溢出。
看看镜头之间是不是一个风格。
确认没问题以后,再渲染最终版本。
这其实也是 AI 内容生产里很重要的一种习惯:
不要一次解决所有问题,而是把问题拆小。
但做到这里,你只是省了一次剪辑时间
这是后来我觉得最重要的一步。
如果你做完一条视频,把 MP4 保存下来。
然后第二条重新开始。
那 AI 只是替你省了一次劳动。
真正有价值的是:
把这一条视频里那些“不变的东西”留下来。
比如:
Hook怎么开。
旁白怎么推进。
镜头怎么变化。
字幕怎么放。
视觉风格怎么统一。
最后可以把它整理成五个东西:
Hook模板、旁白模板、镜头模板、字幕规则、视觉规则。
假设一条视频最终验证下来,它的结构是:
3秒痛点 → 反常识观点 → 3个解释 → 一个案例 → CTA。
下一条就没必要重新设计结构。
换主题。
换案例。
换信息。
换表达。
这时候你做的就不是一条又一条完全不同的视频。
而是在同一条生产线上,更换内容。
真正应该保存的,不是上一条成片,而是上一条成片背后的方法。
同一篇内容,为什么值得做3个开头?
因为 AI 最大的价值之一,不是让你第一次就做对。
而是让你有能力低成本地试错。
同一篇正文,可以先做三个版本。
一个从结果开场。
一个从痛点开场。
一个从反常识开场。
主体尽量不动。
然后发布,看数据。
如果前3秒流失严重,先看 Hook。
如果首帧吸引力不够,测试首帧。
如果中段开始掉,看看是不是解释太长。
如果完播还可以,但互动少,再研究 CTA。
一次只改一个变量。
否则改完以后,你甚至不知道到底是什么产生了变化。
很多人看到数据不好,第一反应是:
“这条不行,重做。”
其实没必要。
内容优化不是推倒重来,而是找到最值得修改的那个地方。
真正开始批量生产以后,素材也会变成资产
做到几条以后,你会发现另外一个问题:
每次找素材,太浪费时间。
人物、产品、场景、截图、背景、音效、BGM……
所以最好单独建立一个素材池。
文件名也别再叫:
IMG_4837。
你下个月打开它,自己都不知道是什么。
直接写:
“办公室—焦虑—近景”。
“城市夜景—推进”。
“书封—主视觉”。
“电脑屏幕—操作”。
下一次做新视频时,先让 AI 根据镜头表匹配已有素材。
能复用就复用。
缺什么再补什么。
还有一个细节特别重要:
账号的视觉要有连续性。
今天写实摄影。
明天3D卡通。
后天突然换成电影质感。
每个镜头单独看都不错,拼起来却像几个 AI 拼在一起。
所以我更喜欢一个简单的原则:
大部分元素保持稳定,小部分元素负责试验。
字体可以稳定。
人物风格可以稳定。
主色可以稳定。
字幕位置可以稳定。
剩下的空间,再用来测试新的 Hook、新的镜头、新的表达。
批量生产真正要解决的,不是“怎么做得更多”。
而是:
怎么不用每次从零开始。
跑通三五条以后,再把经验做成 Skill
我反而不建议第一条视频刚做完,就急着追求全自动。
先手动跑几条。
三条。
五条。
把过程中遇到的问题记下来。
哪些地方最容易返工?
什么样的旁白听起来最自然?
哪些镜头经常出问题?
什么样的 Hook 数据更好?
然后再把这些经验整理成 Skill。
以后输入:
赛道。
受众。
主题。
时长。
语气。
视觉风格。
输出就可以固定下来:
爆款结构。
多个 Hook。
旁白。
镜头时间轴。
素材清单。
字幕规则。
检查清单。
这时候才真正发生了一次变化。
以前是:
你会做视频。
现在是:
你有一套方法,可以让 AI 按照你的方法做视频。
看起来只差了一步。
实际上,效率已经完全不同。
但还有最后一个环节:把数据喂回来
自动化最危险的一点,是它能非常快地重复一个错误。
如果你的方法本身有问题,AI不会自动替你纠正。
它只会帮你生产更多内容。
所以真正的闭环应该是:
先做5条 → 发布 → 看数据 → 找问题 → 修改 Skill → 再做下一批。
前3秒掉得快,就改 Hook。
首帧表现不好,就改首帧。
中间流失严重,就检查信息密度和镜头节奏。
评论不少,但转化弱,再看 CTA。
每一轮只解决一个最明显的问题。
跑几轮以后,你会越来越清楚:
哪些东西应该坚持。
哪些东西只是偶然。
哪些东西看起来漂亮,实际上没有效果。
到了这一步,你的 Skill 才不再是一个普通的 AI 生成器。
它开始慢慢变成:
真正属于你自己的内容生产系统。
如果今天从零开始,我会这样做
我不会先去研究十个工具。
先找自己赛道里的3条视频。
找那些结构容易复用的,不要找高度依赖明星、真人或者独家素材的内容。
选一条。
把它按时间轴拆开。
看它怎么留人,怎么推进,怎么切画面,怎么结束。
然后换成自己的主题。
先写30—45秒旁白。
旁白确定以后做声音。
声音确定以后生成 transcript。
再根据真实音频做镜头表。
先 Preview 一小段。
检查字幕、字体、画幅和节奏。
再做最终渲染。
同一篇正文做3个 Hook。
发布。
看数据。
修改。
再跑下一条。
等连续几条都跑顺了,再开始固化 Skill。
最后才考虑批量和自动化。
顺序不要反。
写在最后
以前做内容,我们经常问:
“这条视频怎么做?”
后来我觉得,更应该问:
“它为什么这样做?”
再往后,还要问一句:
“如果下个月让我再做20条,我今天学到的东西能不能留下来?”
工具会变。
今天是 Codex,明天可能换成另外一个 Agent。
今天是 Hyperframes,之后也可能出现更顺手的执行工具。
但有些能力不会那么容易过时:
拆解内容的能力,提炼结构的能力,测试变量的能力,以及把经验沉淀下来的能力。
以前,一个人做内容,靠的是灵感和经验。
以后,真正重要的也许是:
你能不能把自己的经验,变成一套可以重复运行、不断修正的系统。
AI真正替你省下来的,可能从来不只是几个小时的剪辑时间。
而是让那些原本只存在你脑子里的经验,第一次有机会变成一条真正可以运行的生产线。