ARTICLE · 1024516
AI科研Skills清单,3个工具查文献和整理引用
查到一篇论文以后,接下来通常还要找全文、补引用,再把读到的发现整理进笔记。任务做着做着,浏览器里已经开了不少页,能回查出处的记录却没留下几条。
K-Dense-AI/scientific-agent-skills 这个开源项目里,有几项正好处理这些工作。本篇选三项,给出各自的获取入口和调用方法,再用“单细胞数据整合”做一份小范围文献练习。
前两项适合先连着试。第三项另有检索、制图等依赖,可以等需要做综述时再准备。
先让 Claude Code 找得到 Skill
主宿主用 Claude Code。已经能让它读取本地文件的,可以直接新建一个 research-demo 练习目录;尚未安装的,从官方上手页获取。桌面端需要支持 Code 的订阅,登录后打开 Code,选择 Local 和练习目录。
Claude Code 官方安装与桌面上手
https://code.claude.com/docs/en/desktop-quickstart科研 Skills 仓库
https://github.com/K-Dense-AI/scientific-agent-skills先只取 paper-lookup 和 citation-management 两个完整目录。文件夹里的 references 放接口说明,scripts 放运行脚本;只复制一份 SKILL.md 的话,执行时可能找不到它要读的文件。
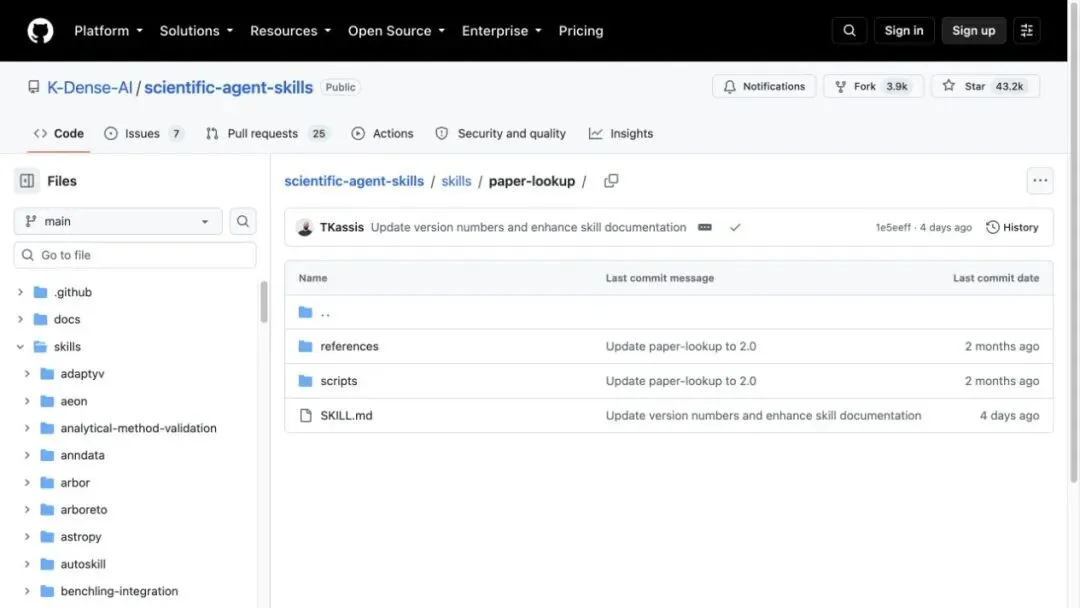
paper-lookup 的真实仓库目录,说明文件、参考资料和脚本需要一起保留。
可以把下面这段交给 Agent 处理安装。
从 K-Dense-AI/scientific-agent-skills 获取 paper-lookup 和 citation-management。 只在当前练习项目接入这两项,保留各自完整目录。 按 Claude Code 当前技能规则放入 .claude/skills,已有中央源码则链接到原位置。 先检查来源、脚本和依赖,再检查 Python 3.11 以上及 requests 是否可用。 重载后列出识别到的两项 Skill,并分别调用,报告实际结果。 不要全量安装其他 Skill;不改全局配置。这里要分别看两个结果。技能列表里出现名字,说明宿主找到了它;任务生成了能打开的文件,才说明这次调用完成了。本次用已安装的 Claude Code 命令行及本机既有的 DeepSeek 配置跑练习,两项 Skill 均已被发现和调用。这张卡实际跑出的证据卡长什么样,第六节有实物。
找论文和开放全文,用 paper-lookup
入口
https://github.com/K-Dense-AI/scientific-agent-skills/tree/main/skills/paper-lookup它把不同学术数据库的接口与常见失败情况整理成了可调用流程。查生物医学相关文献可以选 PubMed 或 Europe PMC,查计算机预印本可以选 arXiv;有 DOI 时,也可以直接查元数据。首次任务只选与问题有关的数据库就够了。
本篇走 Europe PMC,所用接口不需要额外申请密钥。输入从一个明确对象开始,例如查 Harmony 论文的 DOI,并获取开放全文。
使用 paper-lookup 查 DOI 10.1038/s41592-019-0619-0。 核对标题、作者与年份,获取可以访问的全文。 保存原始响应、正文和来源地址,整理一张证据卡。 卡片写研究对象、方法、主要发现与局限,并给原文节或段的位置。 如果只取得摘要,就明确写摘要证据,不推测全文结果。这项 Skill 带的 jats_to_text.py 会检查 XML 里有没有正文。数据库返回了一个页面,甚至状态码是 200,也可能只有标题和摘要。这个检查能帮你区分“找到了记录”和“拿到了全文”。
先查一篇还有个好处,你很容易抽查。文件中的题目是否对应 DOI,证据卡写的那句话能否在原文找到,都有明确的对照对象。
已经有论文,交给 citation-management 理引用
入口
https://github.com/K-Dense-AI/scientific-agent-skills/tree/main/skills/citation-management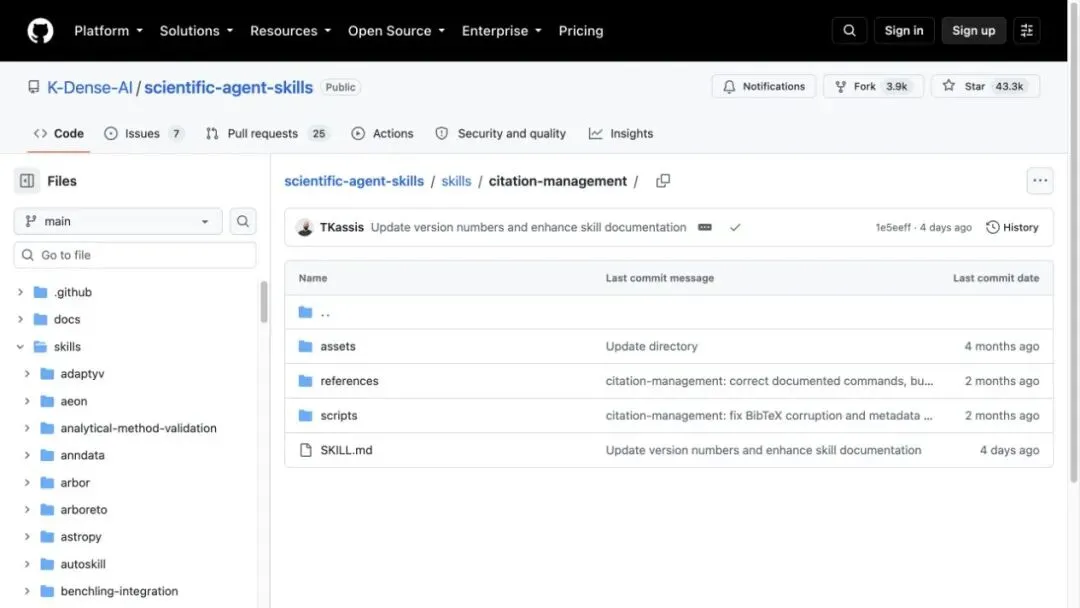
citation-management 的真实仓库页面,目录中包含 references、scripts 与 SKILL.md。
这项适合手上已经有一串 DOI、PMID 或论文链接时使用。它能查询元数据,生成 BibTeX,再检查字段与重复条目。BibTeX 是常见的参考文献文本格式,文件后缀是 .bib,可以继续交给论文写作工具。
它需要 Python 和 requests;Google Scholar 搜索另需 scholarly。这次走数据库接口与 DOI 核对,首次体验没有安装 Scholar 相关依赖。
使用 citation-management 处理 paper-lookup 查到的论文。 按 DOI 查询题目、作者、期刊、年份与卷页信息,输出 references.bib。 检查重复、缺字段和 DOI 与题目不符的记录。 对不完整条目查原始来源补齐;查不到的字段写进检查报告。 保存格式化后的引用与 validation.json,不要只在聊天里贴结果。这次实际生成的 references.bib 里,Harmony 那条摘录出来是下面这样。
@article{korsunsky2019fast, author = {Korsunsky, Ilya and Millard, Nghia and Fan, Jean and ...}, title = {Fast, Sensitive and Accurate Integration of Single-Cell Data with {Harmony}}, journal = {Nature Methods}, year = {2019}, doi = {10.1038/s41592-019-0619-0} }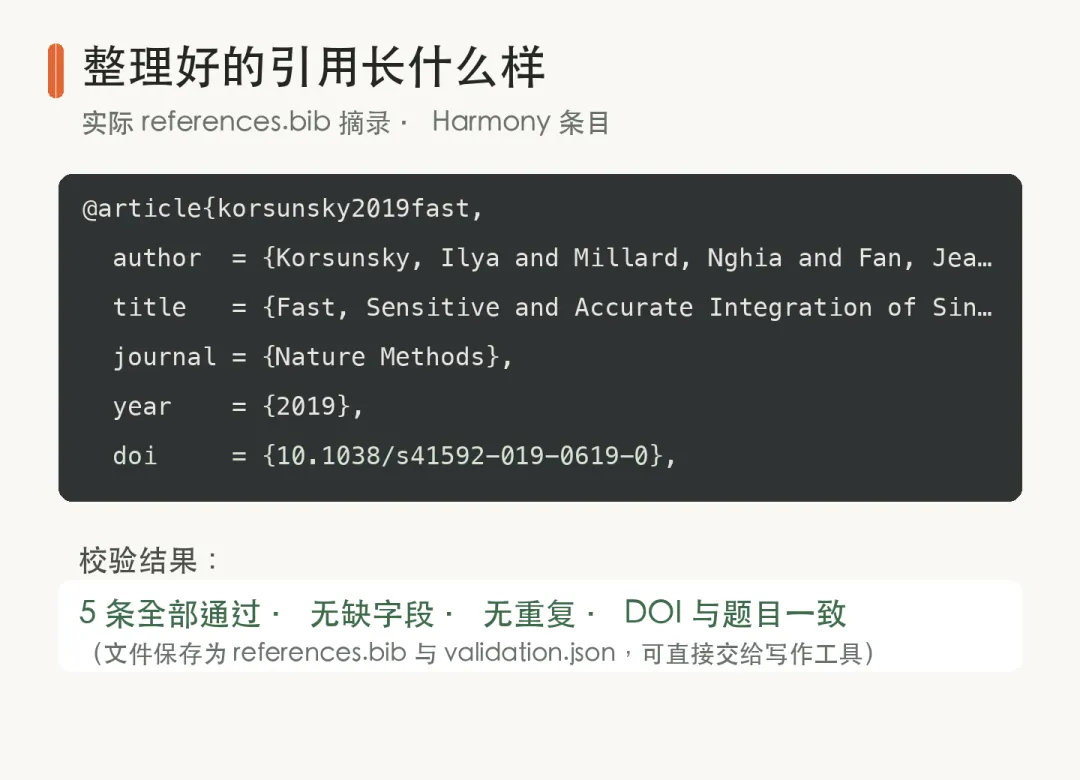
实际生成的 references.bib 摘录与校验报告,5 条全部通过,无缺字段、无重复。
每个字段都能回到来源。同一批还生成了检查报告,5 条引用全部通过,没有缺字段,没有重复,DOI 与题目一致;报告以 validation.json 保存,方便下一次复核。
BibTeX 格式正确,只能说明文件能按这种格式解析。它不能证明论文支持了你的判断。引用字段的检查交给工具,涉及研究发现的那句话还要沿证据卡回到原文。
准备进阶综述,再看 literature-review
入口
https://github.com/K-Dense-AI/scientific-agent-skills/tree/main/skills/literature-review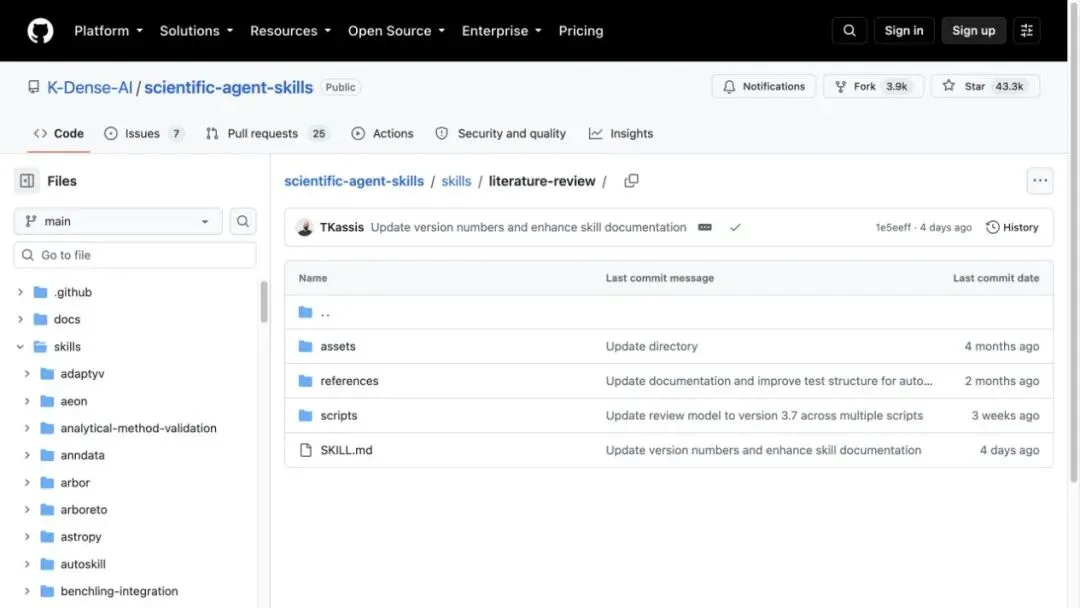
literature-review 的真实仓库页面,完整目录包含 assets、references、scripts 与 SKILL.md。
当任务变成“梳理一个方向的研究”,这项会进一步要求记录研究范围、检索式和筛选过程,再组织证据与引用。它适合继续做综述;前面两项更适合先找几篇、把材料整理好。
它当前以 parallel-web 作为主要网页检索工具,完整流程还关联 scientific-schematics 制图;导出 PDF 又涉及 Pandoc 与 LaTeX。安装时让 Agent 按要交付的文件检查这些条件,相关服务的登录与费用另看实际配置。
这张卡先给一个独立的小样例。把同一篇 Harmony 文献重复放进输入,它的结果聚合脚本会按 DOI 去重,两条相同记录进来,出去只剩一条,去重前后的文件都保存了下来。
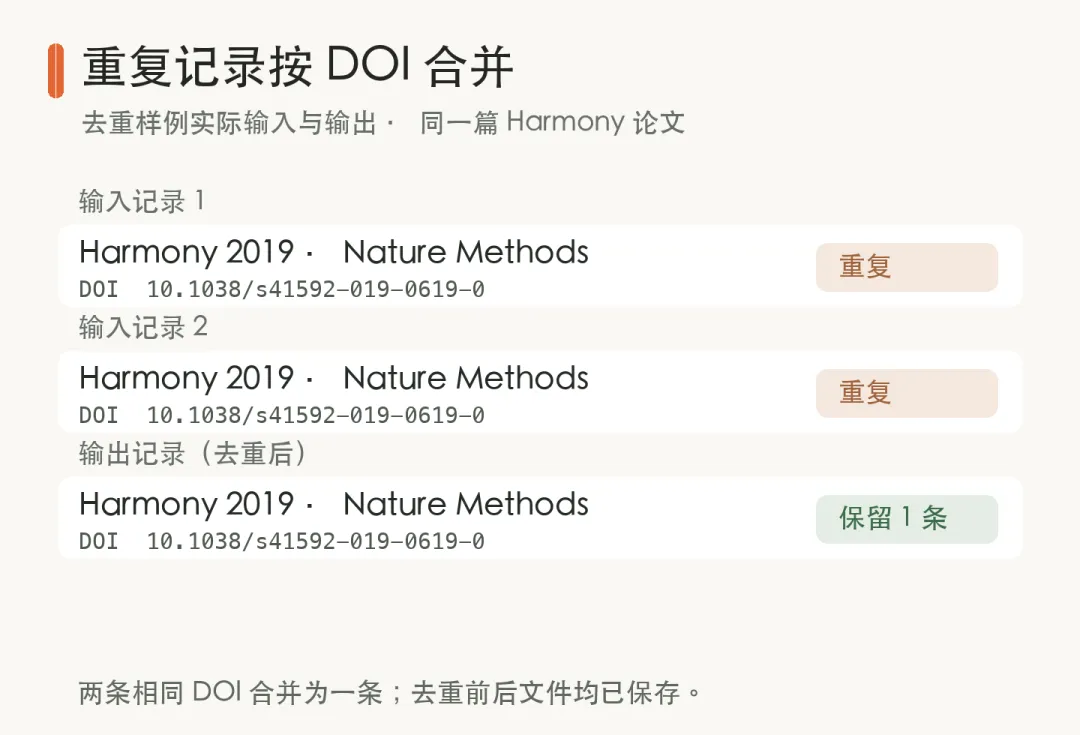
去重样例实际输入两条、输出一条,按同一 DOI 合并。这个样例验证了整理步骤,完整综述流程尚未实跑。
使用 literature-review 为“单细胞数据整合方法”制定检索方案。 先交纳入与排除条件、数据库选择和可执行检索式。 说明 parallel-web、制图与 PDF 导出分别需要哪些依赖。 再用我提供的文献记录演示去重,并保存排除原因。 准备完整综述前,先让我确认范围。把范围确认放在这里很实用。你可以先检查它有没有把方法论文、评测和具体应用研究混在一起,再决定是否继续扩大检索。
把前两项连起来,实际会留下什么
练习把范围限定为 2018 至 2022 年的单细胞数据整合方法与基准评测,最多选 5 篇,先从 Europe PMC 搜索,再补查已知论文的 DOI。它是一份便于抽查的小样本,不能拿来判断这个方向一共有哪些研究。
使用 paper-lookup 和 citation-management。 查找2018至2022年单细胞RNA-seq数据整合方法与基准评测,最多选5篇。 保存检索式、原始响应、去重与排除原因,获取可访问全文。 生成 papers.csv、references.bib、evidence.md 和 excluded.csv。 每张证据卡写研究对象、方法、发现、局限、DOI及原文位置。 再增加条件,只保留2020至2022年的论文,生成第二版,保留第一版不改。实际留下的第一版包括 Harmony、Seurat v3、Tran 的基准评测、iMAP 和 Luecken 的图集评测,五篇都取得了含正文的 XML。其中两篇由 Europe PMC 全文接口返回失败,改从 PMC 作者手稿取得,来源也记录在文件里。
新增年份条件后,2019 年发表的 Harmony 和 Seurat v3 被排除,第二版保留三篇。第一版排除的七篇也都各自留了原因,例如“在范围内但无开放全文”“应用型研究论文而非方法论文或方法基准评测”,写在 excluded.csv 里,换一个方向时照着改条件就行。
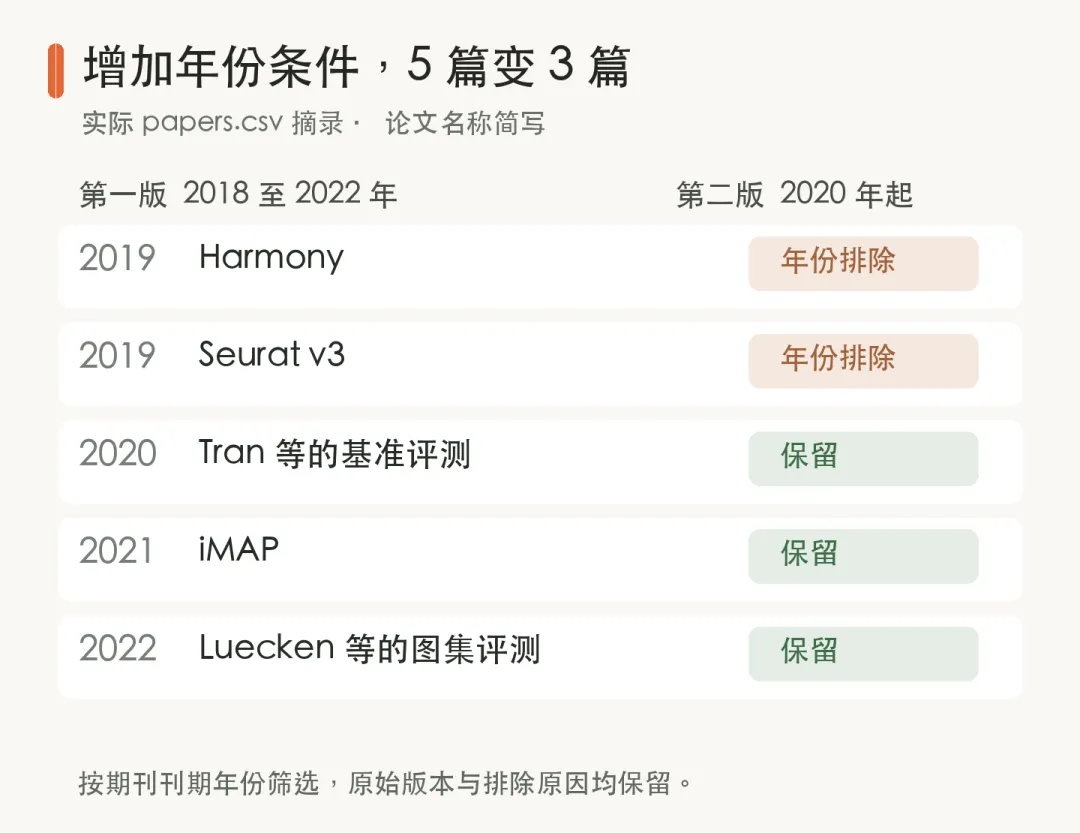
两版 papers.csv 的结果重排,论文名作了简写。
引用核对中还发现了一次 DOI 记忆错误,输入本想找 scVI,返回的题目却是一篇 CRISPR 回应信。Crossref 和 Europe PMC 对应的是同一篇回应信,错误来自输入。能打开 DOI,不能代替核对论文标题。
证据卡则要继续往原文走。以 Harmony 为例,讨论部分说明它不直接改写单个基因的表达值,差异表达分析仍建议采用考虑批次的模型。把这条局限留下来,后续写方法说明时就有具体依据。
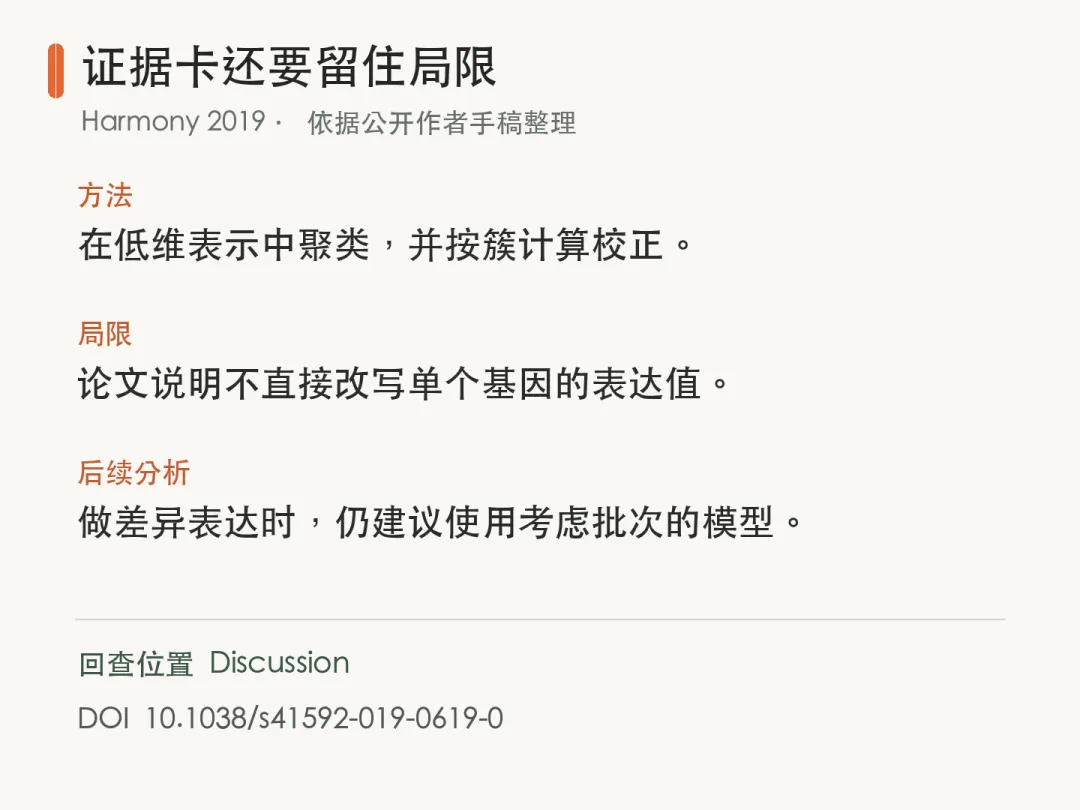
依据公开作者手稿整理,回查位置为 Results 与 Discussion。
下次换成自己的方向,先给一个明确年份范围和一篇已知论文,让 Agent 查完后带你回到原文中的一条局限。