ARTICLE · 1025505
ISCA'26:基于文档注意力分解的RAG存内计算架构
检索增强生成(Retrieval-Augmented Generation,RAG)通过在推理过程中引入外部知识,提升大语言模型输出的事实性与知识时效性。近年来,已有系统通过离线预计算并缓存文档KV,避免对长检索文档进行重复编码,从而降低重复预填充开销。然而,这种中心化的文档KV复用范式也带来了两方面关键瓶颈:其一,大规模文档KV需要驻留在主机内存等高容量存储介质中,并在查询时传输至计算设备,导致高昂的片外数据传输开销;其二,由于用户查询通常较短,预填充阶段的计算容易退化为低计算强度的细长型GEMM,而解码阶段则主要表现为受内存带宽限制的GEMV,造成计算资源利用不足。针对上述问题,本文提出Meridian,一种基于文档注意力分解的RAG存内计算架构。Meridian的核心思想是将文档侧K、V矩阵分片存放于具备存内计算能力的PIM内存模块中,由各设备在本地分片上独立完成注意力计算,并生成用于全局聚合的紧凑局部结果,随后通过轻量级全局聚合得到最终结果,从而显著降低片外KV传输开销。进一步地,Meridian围绕这一机制协同设计了PIM加速架构与跨设备调度机制,在设备内高效支持GEMV、细长型GEMM及非线性操作,在设备间提升并行协同效率。实验结果表明,与现有先进方案相比,Meridian在吞吐率、延迟和能效等关键指标上均取得了显著提升。
该成果“Meridian: In-Memory Acceleration for RAG with Document Attention Decomposition” 已被第53届计算机体系结构国际研讨会(The 53rd Annual International Symposium on Computer Architecture, ISCA 2026)录用。ISCA是计算机体系结构领域最具影响力的国际学术会议之一,是中国计算机学会(CCF)推荐的A类国际学术会议。
论文链接:https://doi.org/10.1109/ISCA66397.2026.00041
背景与动机
检索增强生成通过在大语言模型推理过程中引入检索得到的外部知识,有效缓解模型幻觉和知识陈旧问题。与标准大语言模型推理相比,RAG不仅需要处理用户查询,还需要融合检索得到的相关文档信息,因此在线推理开销显著增加。为降低首词元延迟,已有工作采用文档KV预计算机制,将文档侧KV离线缓存,并在服务时直接与查询相关计算结合,从而避免对静态长文档的重复编码。
在引入文档KV预计算之后,如图1所示,RAG生成阶段的主要开销可归结为两个方面。首先,需要将所需文档KV传输至参与推理的设备;其次,需要在设备端完成相关的注意力计算以及后续前馈网络计算。换言之,生成阶段的整体开销主要由通信与计算两部分构成。
尽管文档KV预计算减少了重复计算,现有以计算设备为中心、按需加载文档KV的中心化执行方式仍面临两个核心系统瓶颈。首先,文档KV规模通常远超设备端存储能力,因而必须保存在主机内存等高容量存储介质中,并在推理时通过PCIe等带宽受限互连传输至计算设备,由此带来显著通信开销,并在多设备部署下进一步限制系统扩展性。其次,由于RAG查询通常较短,预填充阶段中的矩阵乘法往往表现为低算术强度的细长型GEMM,而解码阶段则主要由内存受限的GEMV主导,导致整体计算资源利用率持续偏低。这些特征使得现有面向标准LLM推理的异构PIM设计难以直接适配采用KV预计算的RAG场景。
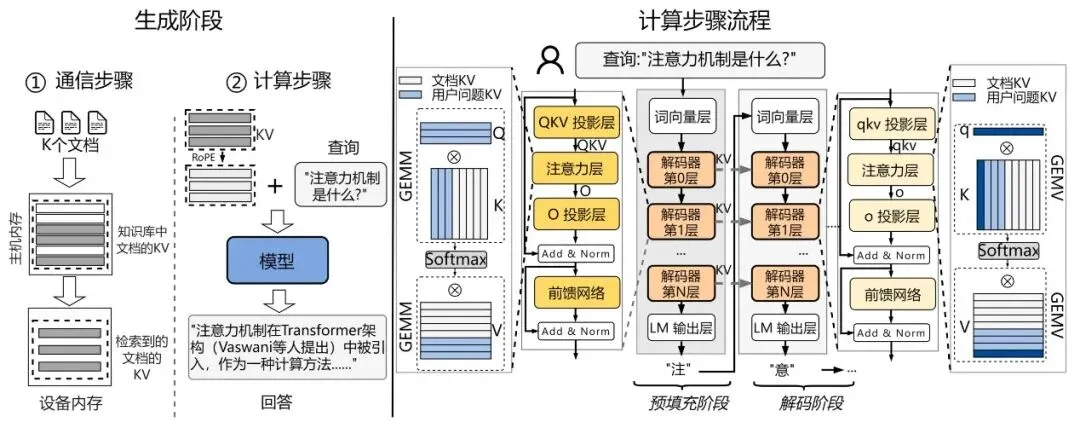
图1 检索增强生成的生成阶段执行流程
为克服上述两类瓶颈,本文提出了一种基于文档注意力分解的去中心化执行模式。针对片外通信开销过高的问题,本文将文档侧K、V矩阵分片存放到多个具备存内计算能力的PIM内存模块中,使每个设备能够直接在本地KV分片上执行文档注意力计算。各设备仅生成用于全局聚合的紧凑局部结果,随后通过一次轻量级全局聚合得到最终结果,从而显著减少片外KV数据传输。
然而,仅有去中心化注意力执行仍不足以充分解决设备内计算效率低下的问题。去中心化执行不仅改变了计算位置,也重塑了跨设备协同方式,由此带来两方面关键的体系结构挑战。
首先是设备内硬件设计挑战。现有多数面向LLM推理的PIM架构采用混合执行模式,即将GEMV放在内存侧执行,而将GEMM、激活函数和归一化等操作卸载到外部计算引擎,从而引入额外的数据传输开销。然而,在去中心化RAG推理中,为避免高昂的数据传输代价,注意力计算必须直接作用于驻留在内存中的文档KV分片。这就要求系统在严格的面积和功耗约束下,仍能够在DRAM内部高效支持细长型GEMM和非线性函数,因此如何高效实现这些操作成为关键的硬件设计问题。
其次是设备间协同挑战。去中心化执行虽然消除了中心化计算节点,但同时引入了更强的跨设备依赖关系。每个设备只能生成部分注意力结果,而后续层计算又依赖于全局聚合后的输出。若缺乏精心设计的调度机制,这些依赖将导致执行停顿,使部分设备处于空闲状态,并限制整体并行效率。因此,如何消除这类协同瓶颈,是充分发挥去中心化执行优势的关键。
设计与实现
为此,本文提出了Meridian,一种基于文档注意力分解的RAG存内计算架构。Meridian的核心包括两方面设计:其一,提出文档注意力分解机制,将文档侧K、V参与的注意力计算从原始集中式执行流程中分离出来,并直接在文档KV驻留位置完成计算;其二,围绕该执行模式,设计面向生成阶段的PIM硬件架构与跨设备调度优化机制,以同时提升单设备执行效率和多设备扩展能力。
在执行模式层面,Meridian将文档侧键值缓存以分片形式分布存放于多个PIM设备中,使每个设备仅在本地KV分片上执行文档注意力计算,并生成用于后续全局聚合的局部中间结果。随后,系统通过一次轻量级全局聚合得到最终注意力输出。借助这一机制,如图2所示,Meridian将原本依赖完整文档KV集中传输的执行流程,重构为仅交换查询相关输入与局部结果、并由分布式本地计算和轻量级全局聚合协同完成的去中心化执行流程。进一步地,在实际部署中,文档KV沿注意力头维度切分并映射到多个PIM设备,每个设备仅负责一组互不重叠的注意力头,并返回对应的输出切片。由于每个设备只处理其本地头分片,单设备通信量可随设备数量增加而近似按比例下降,因此该机制在多设备扩展下仍具有较好的通信可扩展性。考虑到典型RAG场景下检索文档通常远长于用户问题与生成回答,Meridian能够显著减少由文档KV引起的片外传输开销,并在多设备规模扩展下持续保持这一优势。
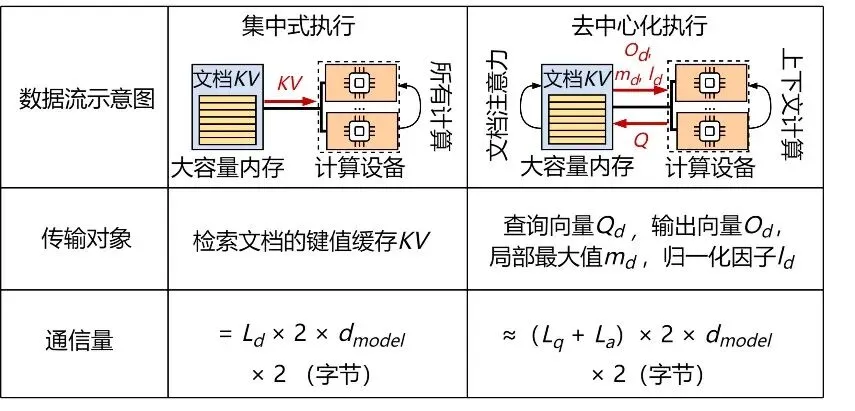
图2 执行模式对比
在硬件组织层面,Meridian基于CXL构建,由多个同构PIM设备通过CXL交换机互连,以提供可扩展的存储容量和存内计算能力。如图3所示,系统中的PIM设备在逻辑上划分为两类集群:文档注意力集群负责文档KV上的注意力计算,上下文执行集群负责查询与回答相关的注意力计算、全局结果融合以及前馈网络等其余算子。由于两类集群采用同构硬件实现,系统可根据运行时负载动态调整资源分配,从而在吞吐率、延迟和资源利用率之间取得更优平衡。
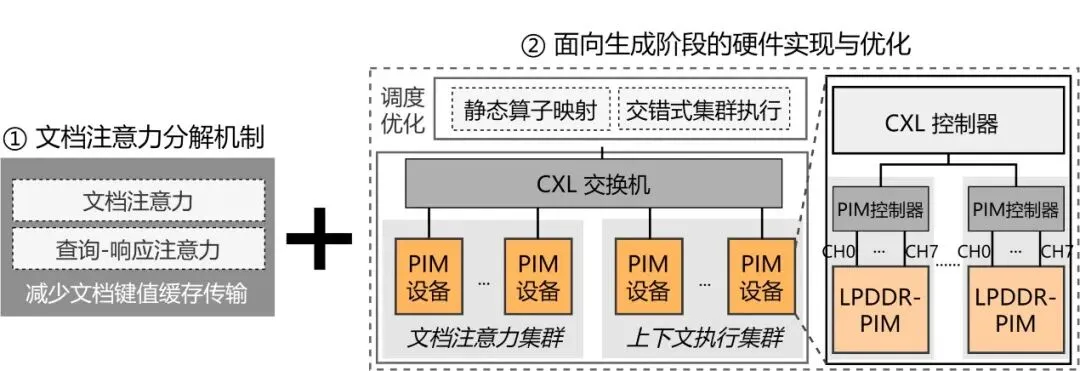
图3 Meridian架构硬件组织与优化
在设备内部实现上,Meridian针对生成阶段的关键算子设计了专用执行单元。对于GEMV,系统在Bank级部署乘加单元,以支持高并行度的本地计算;对于细长型GEMM,Meridian通过扩展缓冲资源而非重复部署算术逻辑,在严格面积与功耗约束下提升吞吐并减少行切换开销;对于GELU等非线性运算,则采用分段线性近似,将复杂函数映射为区间定位、参数查表和乘加操作。如图4所示,Meridian的存内计算单元由两部分组成:一部分是部署在每个Bank旁的PIM单元,负责Bank级本地计算;另一部分是集成在PIM控制器和CXL控制器中的控制器侧单元,负责跨Bank归约、跨设备协同以及整体执行控制。
系统采用全Bank并行访问机制,通过广播命令触发多个Bank对相同行列位置并行访问,从而提升设备内部并行度和带宽利用率。每个PIM单元从其Bank接收输入数据,并集成比较器、乘法器和加法器等核心计算资源;其中加法器可在归约树和逐元素加法两种模式之间重构,以适配不同算子需求。此外,每个PIM单元配备缓冲区,用于暂存输入和中间结果,而非线性函数所需的区间信息与参数则存储于内存阵列中,以减少额外片上存储开销。
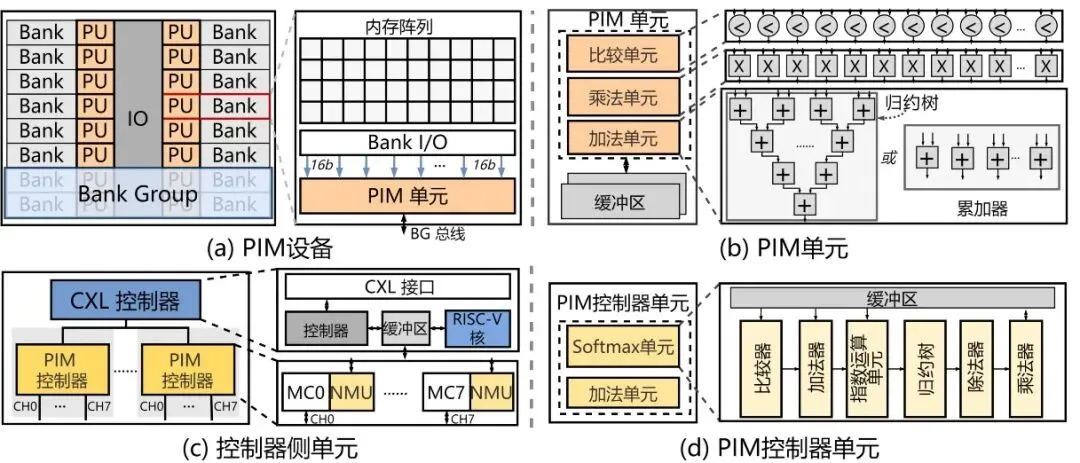
图4 Meridian存内计算单元硬件实现
尽管PIM单元能够高效完成Bank级本地计算,生成阶段仍需要支持跨Bank结果聚合、跨设备协同以及部分不适合完全在存内实现的运算。为此,Meridian在设备内部进一步引入两类控制器侧单元:其一,PIM控制器单元负责通道内局部结果归约,并集成专用Softmax单元,以高吞吐方式完成Softmax计算;其二,CXL控制器中集成轻量级RISC-V核,用于跨通道、跨设备的结果聚合,并承担更灵活的轻量级控制与计算任务,从而在控制硬件开销的同时提升整体灵活性。
针对去中心化注意力带来的集群间负载不均问题,Meridian进一步提出交错式集群执行机制。在运行过程中,空闲的集群可提前处理后续推理批次,使文档注意力计算与上下文相关计算在时间上重叠推进,从而减少设备空闲时间,提升流水线利用率和系统整体吞吐。
我们在多种配置下对Meridian进行了系统评估。结果表明,与现有代表性的面向大语言模型推理的存内计算方案相比,Meridian的吞吐率平均提升3.74倍,延迟平均降低2.94倍,并显著减少跨设备通信开销,表明所提出的去中心化存内计算架构能够有效支撑RAG生成阶段的高效执行。
详细内容请参见
Chaoqiang Liu, Yu Huang, Haifeng Liu, Yi Zhang, Qihang Qiu, Xueqi Li, Long Zheng, Xiaofei Liao, Hai Jin, Jingling Xue, "Meridian: In-Memory Acceleration for RAG with Document Attention Decomposition", In Proceedings of the 53rd Annual International Symposium on Computer Architecture (ISCA 2026) , June 27–July 1, 2026, Raleigh, NC, USA, pp.387-401.
https://doi.org/10.1109/ISCA66397.2026.00041