ARTICLE · 1025549
文档扔进去就能问?腾讯这个开源知识库神器做到了
点击下方【无聊猫科技】关注,每天推荐一个开源好工具
上班或者读书的时候,谁手里没攒下一堆文档呢。项目方案躺在网盘里,产品手册存在桌面上,会议纪要散在各种聊天群里,真要用的时候,搜索框里输半天关键词,翻出来的还是那份连标题都对新不上的旧文件。市面上的知识库产品不少,好用的要么按人头收费,要么文档得传到别人的服务器上,公司里的东西总觉得不敢全放上去。
其实这套「文档进去、答案出来」的能力,自己搭一份并不难。今天要说的这个开源项目,是腾讯拿出来开源的一套知识库框架,名字叫 WeKnora。它把文档解析、语义检索、大模型问答这些环节全给串好了,你把文档喂进去,之后就可以像聊天一样问问题,它回答的时候还会告诉你答案是从哪份文档哪一段抄来的,有据可查。
更让人意外的是它的发布节奏。这个项目 2025 年 7 月才建仓,一年多时间 star 就涨到了两万五以上,版本号已经迭代到 v0.8.0,写稿前两天还在提交代码。腾讯自家的微信对话开放平台,用的也是它这套技术框架,等于官方自己就在生产环境里天天跑。
这套东西适合谁?手上资料多的个人研究者是一个,团队更是一个。部门里那些只有入职三年以上的老人才找得到的方案文档,新同事问一句就有答案;客服团队把产品资料灌进去,回答口径统一,还不用怕人离职把经验带走;就算只是家里囤了几百份菜谱和说明书,想问「空气炸锅烤红薯几分钟」,它也能给你翻出原文。
一、这是什么
一句话说清楚:WeKnora 是一个开源的大模型知识库框架,专门干「把文档变成能对话的知识」这件事。你上传 PDF、Word、网页、表格,它负责解析、切块、建索引,之后无论是直接问答、让 AI 帮你干活,还是把整堆文档整理成一本互相链接的 Wiki,它都能接住。
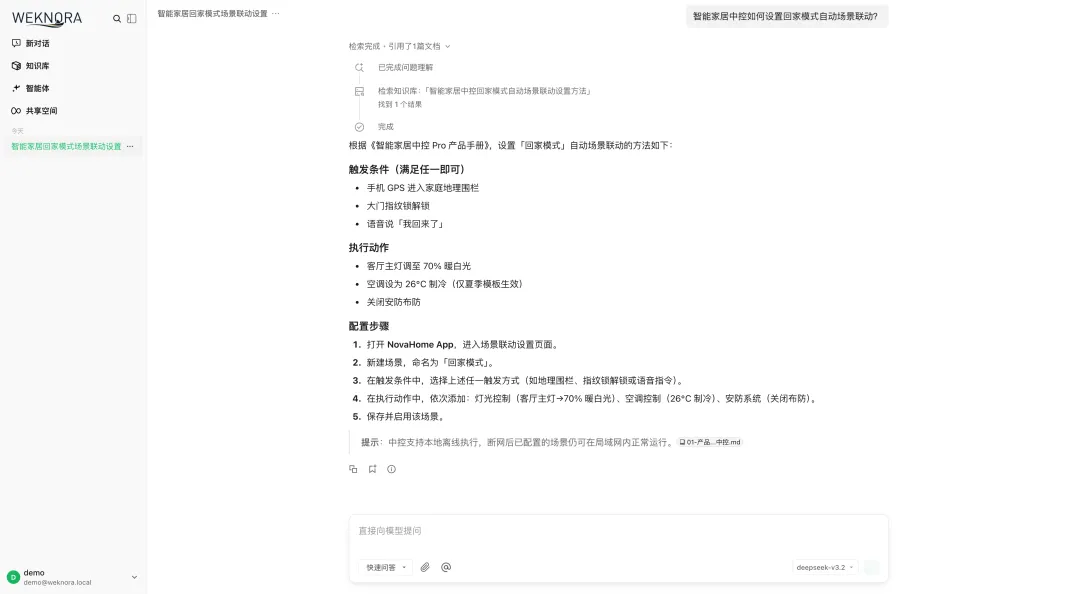
▲ WeKnora 智能问答界面,答案带原文引用
项目由腾讯开源,采用 MIT 协议,代码全部放在 GitHub 上。写稿时仓库有 25,232 个 star,最新版本 v0.8.0 是 2026 年 9 月初发布的,几乎每隔几周就有一个新版本。它还是微信对话开放平台的核心技术框架——你在微信里见过的不少问答机器人,底层跑的就是这套东西,只是那时候它没开源而已。
看它这一年的更新轨迹,能感觉到是照着真实需求一路长出来的。早期版本先把 RAG 问答和 Agent 模式做稳,接着接入企业微信、飞书这些 IM 渠道;v0.5 把 Wiki 模式做正式,文档自动变知识页;v0.6 补上企业要的多工作区权限管理;v0.7 上线了几十页的官方文档站和分块版本历史;v0.8 又把技能沙盒和跨会话长期记忆补齐。每一版都在往「能放心给团队用」这个方向挪,不是那种发布一次就吃老本的项目。
二、能干什么
- 知识库问答:文档喂进去,直接开问,回答带原文引用,点开能看到出处
- Wiki 模式:让 AI 把原始文档自动整理成互相链接的 Wiki 页面,还带知识图谱
- Agent 干活:接入沙盒和工具,能检索资料、跑脚本、生成 Word 和 PPT 文件
- 多渠道接入:企业微信、飞书、钉钉、Slack、Telegram 等十来个 IM 都能接
- 多源同步:飞书、Notion、语雀、GitLab、RSS 里的内容能自动同步进知识库
- 随换模型:DeepSeek、Qwen、混元、OpenAI、Gemini、Ollama 等 20 多家模型随便挑
- 私有部署:Docker 一条命令拉起来,数据全在自己机器上,也支持离线部署
三、上手体验
玩法一:把文档喂进去,直接开问
装好之后第一件事是建知识库。它支持文件夹上传,保留你原本的目录结构,左边是文件夹树,右边是文档列表,跟用文件管理器差不多。PDF、Word、Excel、图片、XMind 思维导图,十多种格式都能直接丢进去,解析完自动切块、打标签、生成索引。
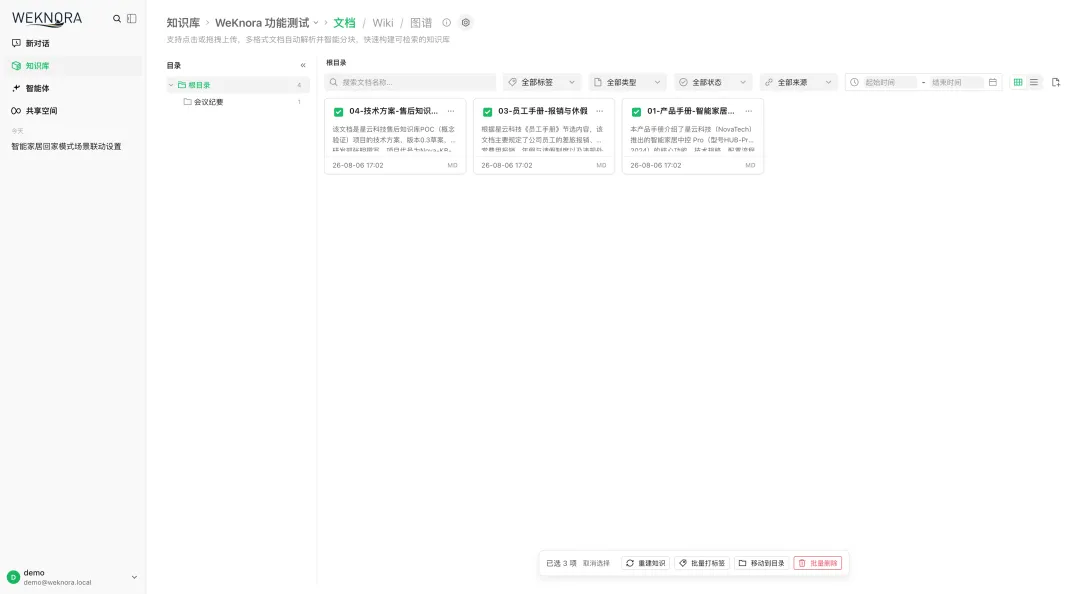
▲ 知识库文件夹树与文档列表
然后就可以提问了。它在回答之前会先去知识库里检索,把相关的段落找出来,再组织成答案,回答末尾带着引用,点一下就能跳回原文核对。截一张实际问答的图你们感受一下:问一个产品手册里的操作问题,它把触发条件、执行动作、配置步骤列得清清楚楚,末尾还标注了答案出自哪份文档。
提问体验上也有不少贴心的小设计。系统会根据知识库内容自动生成推荐问题,不知道该问什么的时候点一下就能开始;回答完还会给出追问建议,顺着问下去不用自己重新组织问题;聊天途中临时发一张图片或者一份文档,它也能异步解析后用于这次回答,不用专门传进知识库。回答是从知识库来的还是从网络搜索来的,界面上会分开标注,来源清清楚楚。
玩法二:让 AI 把文档写成一本 Wiki
这是它最有意思的功能。原始文档往往又长又乱,Wiki 模式会让 AI 把它们重新组织成一篇篇结构化的知识页面,页面之间互相链接,还有一张可视化的知识图谱,能看出哪些概念和哪些文档有关联。点开图谱上的一个节点,右边直接显示对应的页面内容。
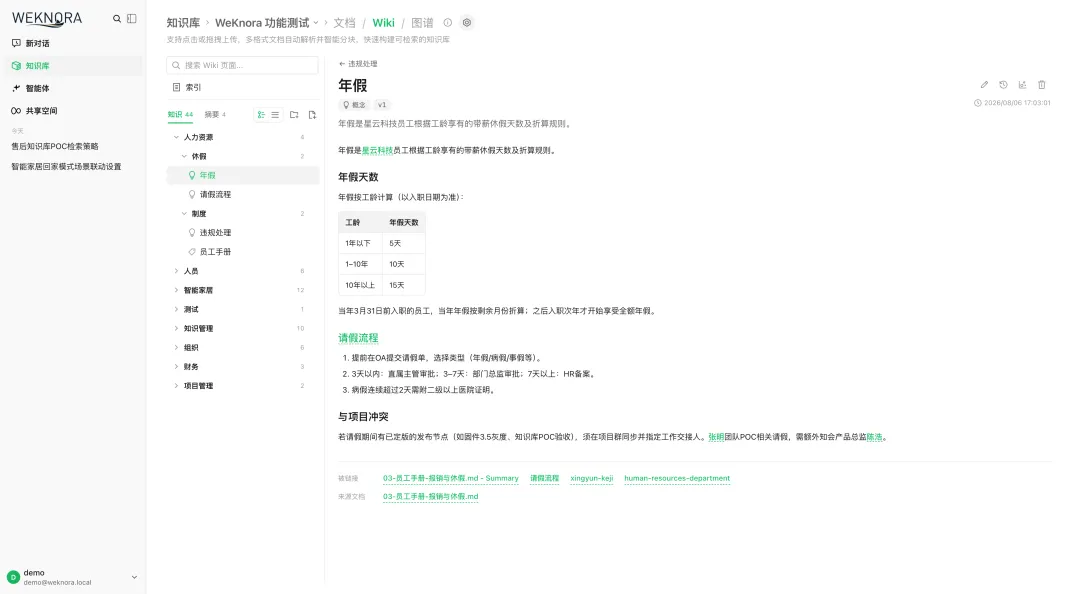
▲ Wiki 浏览器,AI 自动生成的知识页面
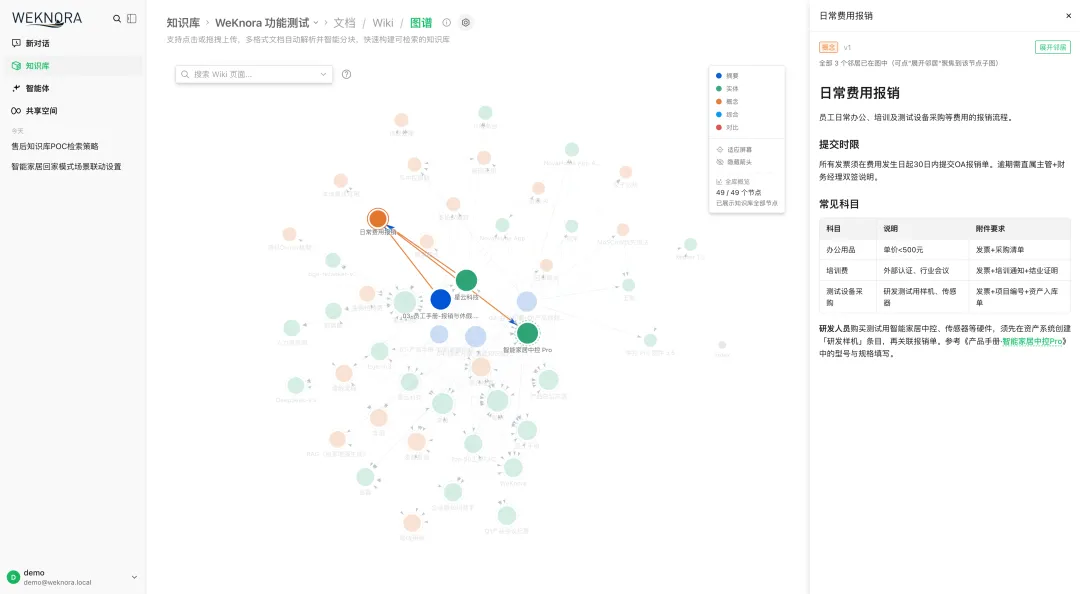
▲ Wiki 知识图谱,节点就是知识点
更实用的是版本管理。AI 生成的页面可以人工编辑,每次改动都有版本记录,不满意一键回滚。这就把「AI 生成内容不可控」这个大问题解决了一半:它先给你打个底,你在这个基础上改,改坏了随时退回去。
玩法三:让 Agent 真的帮你干活
从 v0.8.0 开始,它带上了技能沙盒。你可以在技能目录里安装现成的技能,比如处理 Word、PPT、PDF 的工具,装好之后 Agent 在对话里就能调用。所有技能都跑在隔离的沙盒里,Docker、E2B、Cube 三种后端随选,不影响宿主机。
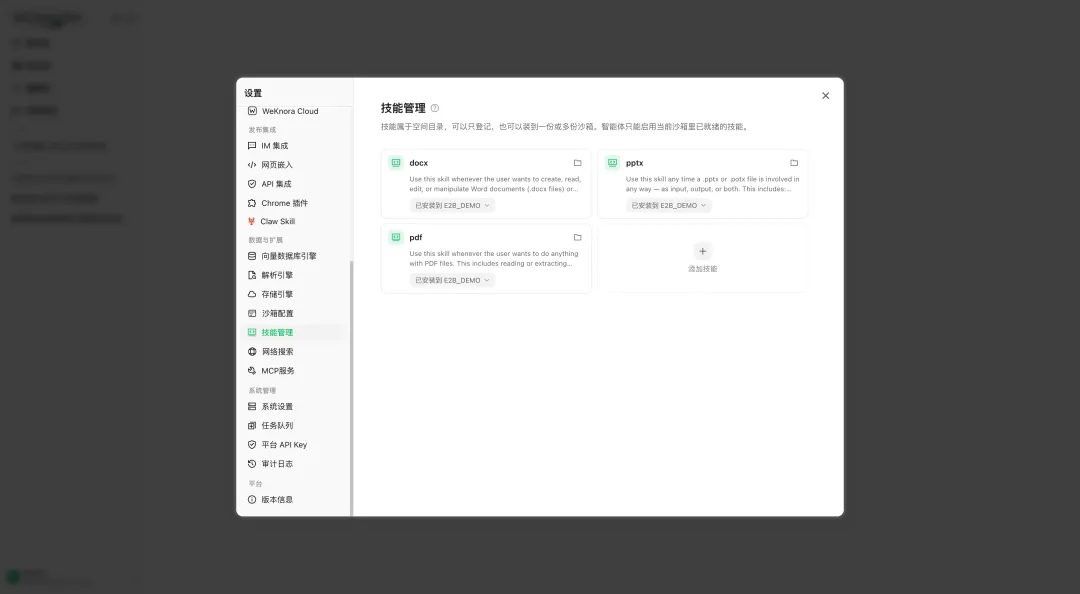
▲ 技能目录,一键安装到沙盒
实际用起来是什么样的?我在文档里问一个开放性的问题,它先去知识库检索,发现光靠检索答不全,就自己调技能起了个沙盒,把资料整理成一份带格式的 Word 文档,写完直接给你下载入口。整个过程不用你写一行提示词,它自己安排步骤。
还有一样容易被忽略的能力是跨会话长期记忆。它会把你的身份、偏好、常问的任务类别记下来,下次提问不用从头自我介绍,重要的记忆条目会先让你确认再入库,不想要随时删。对固定场景的用户来说,这个功能用几天之后差异就很明显——它慢慢变得像是熟悉你业务的同事,而不是每次都要重新认识的客服机器人。
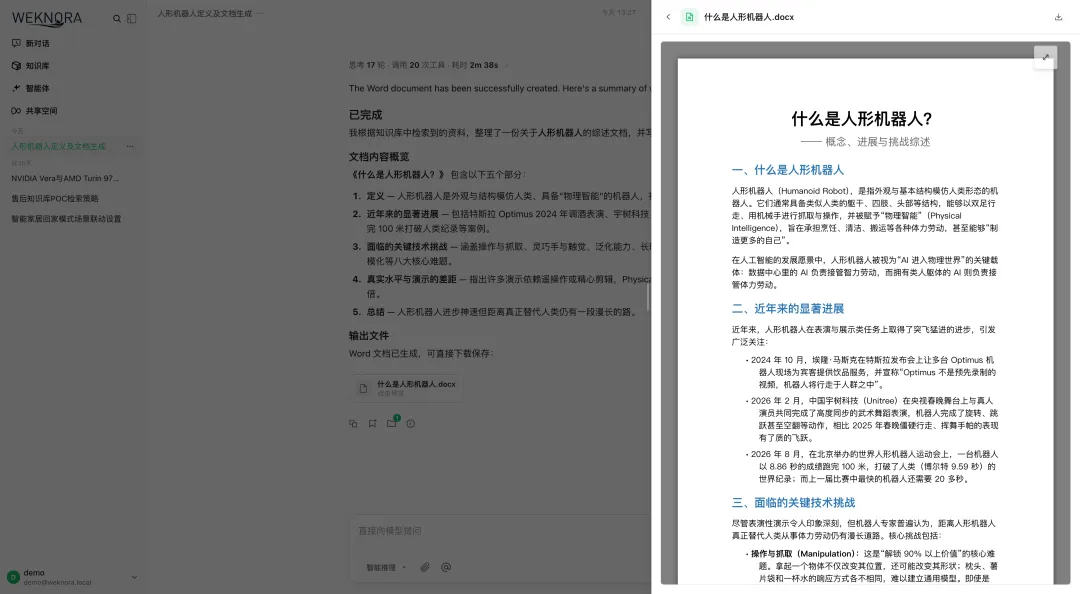
▲ Agent 检索、读技能并生成 Word 文档
四、快速上手
需要一台装了 Docker 的机器,三条命令跑起来:
git clone https://github.com/Tencent/WeKnora.git cd WeKnora cp .env.example .env # 按需编辑 .env,文件里有注释 docker compose pull # 拉取最新镜像 docker compose up -d # 启动核心服务 # 启动成功后浏览器打开 http://localhost 就能用了 配置文件里主要填两样东西:模型服务的 API Key 和向量数据库的连接信息。没有付费模型也不慌,把 .env 指向本地的 Ollama,用本地模型照样能跑,数据一步都不出门。想加知识图谱、对象存储、链路追踪这些功能,启动时加一个 profile 参数就行,官方文档写得明明白白。
五、检索这块下足了功夫
知识库产品好不好用,八成取决于检索准不准。WeKnora 的检索是混合式的:关键词召回走 BM25,语义召回走向量检索,开了知识图谱还能走 GraphRAG 路线,三路结果再统一排序。文档切块也讲究,支持父子分块——先用大块保住上下文,再用小块保证命中精度,检索的时候两边配合。
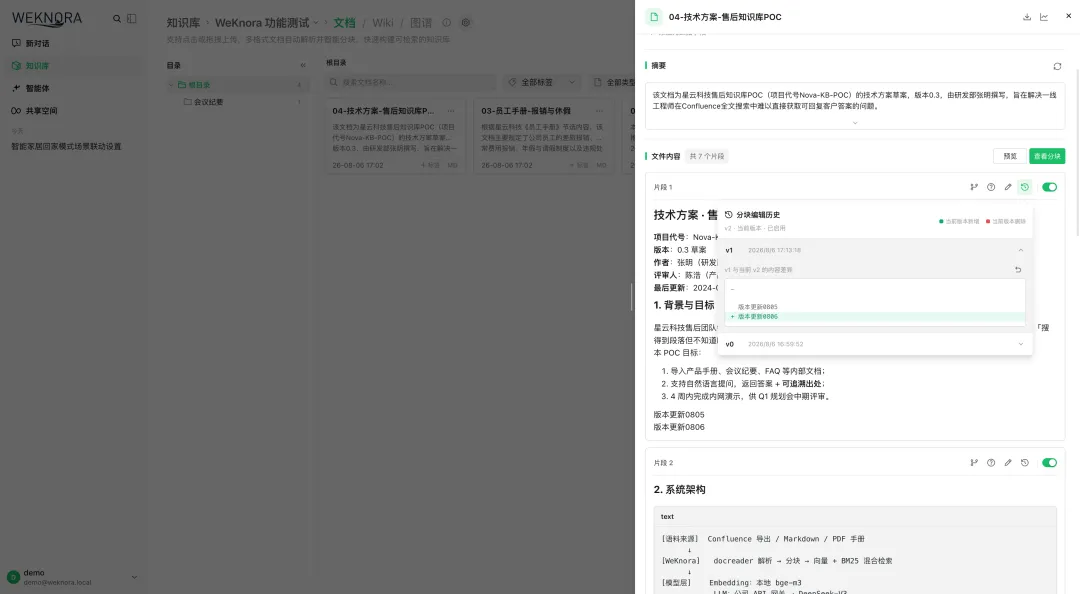
▲ 分块编辑与版本历史
它还有一个别的产品少有的设计:检索用的分块可以直接在界面里编辑。AI 切得不合理的地方,你手动改,每一版都留快照,能对比差异、一键回滚,改完自动重建索引。对于想把知识库质量一点点磨出来的团队,这个功能比多接十个模型都实在。
文档解析这一环也值得单独说。PDF、Word、Excel 这些常见格式有内置的多引擎解析,Office 文件能进程内直接处理;图片走视觉模型识别,音频有语音转写,XMind 思维导图也能拆。解析进度是可视化的,一篇大文档传上去,每个阶段处理到哪一步、卡在哪,界面上有时间线可以看,出错还能单独停止重试,不用对着一个转圈按钮干等。
六、架构:模块化,组件都能换
看一眼它的架构图就知道这个项目想走多远。输入端有 Web 界面、IM 机器人、网站嵌入、MCP 服务、浏览器插件、命令行等七八个入口;核心引擎分成文档处理和 RAG 与 Agent 两大块;存储层的向量数据库支持 pgvector、Milvus、Elasticsearch、Qdrant 等八种后端,对象存储也有八家可选。
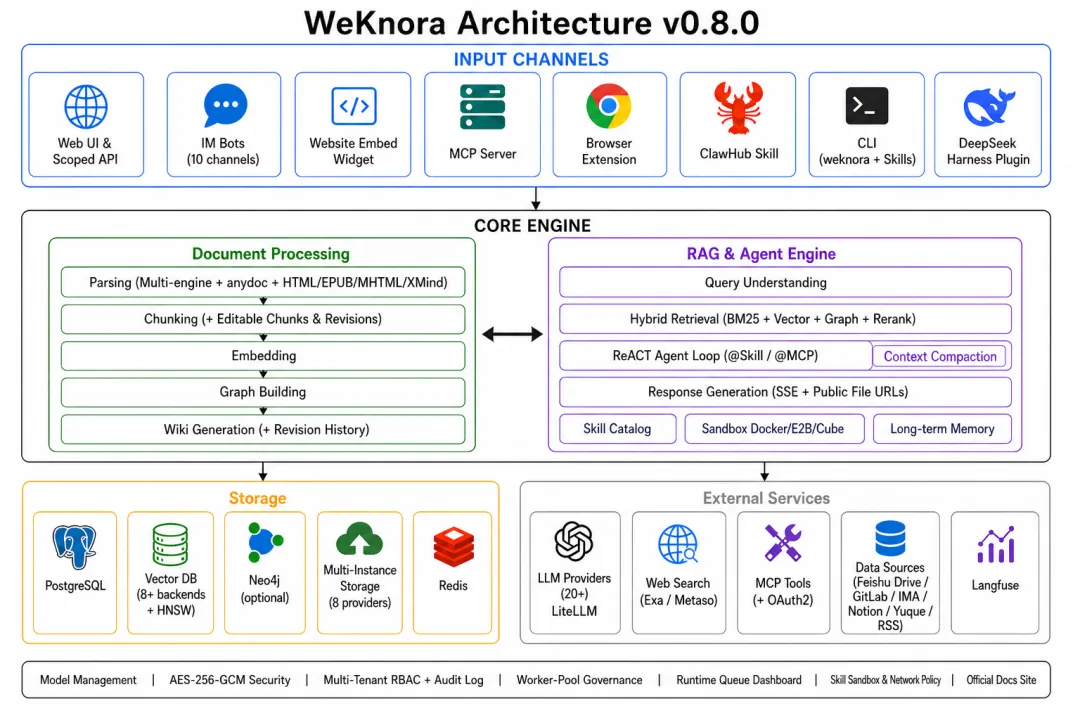
▲ WeKnora v0.8.0 架构图
模块化的好处是每一层都能按自己的情况替换。公司已经有 Milvus 就接 Milvus,模型想用自己私有化部署的就填 Ollama 地址,敏感数据出不了内网的场景也有离线部署方案。权限这块做得也细,工作区里有四级角色矩阵,每个知识库可以单独设归属,操作都记审计日志,企业里多人协作不会被权限问题卡住。
七、和同类比一比
Dify:同样是热门开源项目,Dify 的重心在「搭 AI 应用」,把模型、工作流、知识库编排在一起做一个应用出来;WeKnora 则是把「知识库」这一件事做深,从解析、检索到 Wiki 生成一路打通。想快速搭各种 AI 应用选 Dify,想把文档管明白选 WeKnora,两者不冲突。
RAGFlow:专精文档理解和检索的开源引擎,文档解析能力很强。WeKnora 的检索能力不弱,但额外多出了 Wiki 模式、Agent 沙盒和 IM 接入,更像一个完整的产品,开箱就能给团队用。
按人头收费的 SaaS 知识库:胜在省心,注册就能用。但文档放在别人服务器上,公司资料多了总归不踏实,而且费用按人头涨。WeKnora 部署在自己机器上,数据不出门,人数再多也不多花一分钱,代价是要自己维护一套 Docker 服务。
怎么选其实不难判断。就一个人用、资料也不多,随便一个笔记软件自带的 AI 问答就够了;想给团队搭一个正经的知识底座,又对数据归属有要求,WeKnora 这种能私有部署的开源方案就是更对路的那个选择。先拿一台测试机跑起来试试检索质量,合适再迁到正式环境,试错成本几乎为零。
八、要花多少钱
软件本身完全免费,MIT 协议,商业使用也没问题。真正的成本有两块:一块是跑服务的服务器,官方推荐 Docker 部署,一台普通的云主机或者公司内网的一台机器就够起步;另一块是大模型的调用费,接哪家模型就付哪家的钱,用 Ollama 跑本地模型的话这块费用是零。
配置要求不高,核心服务一套 Docker Compose 就能拉起,向量数据库用默认的 PostgreSQL 加 pgvector 方案就行。团队规模大了再考虑上 Milvus、加 Langfuse 追踪这些进阶组件,官方文档里每一步都有对应说明,不至于摸黑折腾。
运维上的设计也算周到。任务队列是异步的,文档解析、Wiki 生成这些都走后台队列,管理面板能看到队列深度、失败任务,出了问题可以单独重试;API Key 和各类凭据在存储层做了加密,密钥在界面上返回时会自动脱敏;升级版本会自动做数据库迁移,跟着官方节奏走基本不用手工折腾数据。
小提示:第一次部署先把 .env 里的模型配置填对再启动,别上来就改其他参数;文档解析质量直接决定问答质量,重要资料建议用 PDF 或 Word 原件,别用扫描模糊件;知识库建好后先拿十个自己最常问的问题测一轮,检索不准就回到分块编辑里手动调。
⭐ 觉得有用?三连支持一下
📌 点右上角收藏,需要时随时回看👀 关注【无聊猫科技】,每天推荐一个开源好工具📤 分享给身边需要的朋友,帮他们少走弯路
项目地址
项目地址(开源免费):https://github.com/Tencent/WeKnora
官网:https://weknora.weixin.qq.com
写在最后。文档越攒越多这个问题,靠意志力整理是治不好的,大部分人缺的只是一个「问一句就有答案」的入口。WeKnora 把这个入口的门槛降到了三条命令,模型可以换、数据不出门、代码随便看,想给团队或者家里那堆资料找个归宿的话,值得一试。
喜欢这类开源好工具的话,关注【无聊猫科技】,每天给你挑一个能上手用的。