ARTICLE · 1025921
《我的 PDF 解析器崩了三次,才学会“永不丢弃文件”》
1. 背景介绍
一句话前情:这是一个把电气 PDF/Word 变成“问它就答,答案带页码”的本地 RAG 问答系统,总览见系列第一篇;今天分享的是入库的第一站——PDF 解析
一份 PDF 交到解析器手里,它必须回答三个问题:
第一:这一页有没有文字层? 有,直接抽文字;没有,说明是扫描件——整页都是图,一个字都抽不出来。
第二:抽出来的字,够多吗、全吗? 表格有没有碎成一列乱码?双栏有没有串行?页眉页脚有没有混进正文?
第三:OCR 该什么时候出手? 整本都 OCR,30 页的文件要等好几分钟;不 OCR,扫描件又全军覆没。
这三个问题,每一个都让我的解析器在真实资料面前崩过一次
第一崩:扫描件,一个字都抽不出来,或者引擎崩了
我第一次灌入第一批资料,其中有一份老规范是扫描件。结果后端直接抛异常:解析后没有可用文本块
诊断过程,我也明白一件事:文字版 PDF 和扫描件是两种东西;文字版 PDF 里有一层隐形的文字层,解析器抽的是它;扫描件整页就是一张图,文字层压根不存在——解析器没坏,是它要找的东西不在;而且还在测试的时候发现:环境型崩,docling 本身挂了(中文路径、代理拦网),但是好在我有三层兜底,内容型和环境型我都接下来了
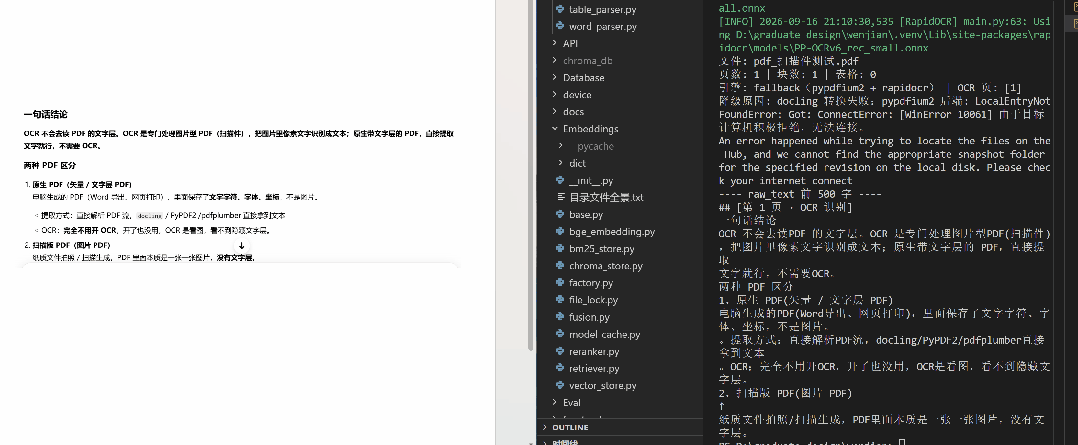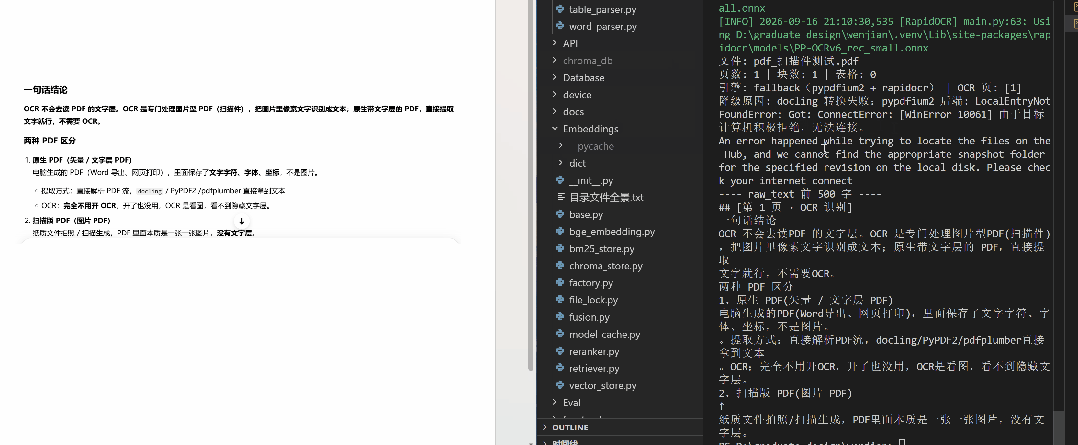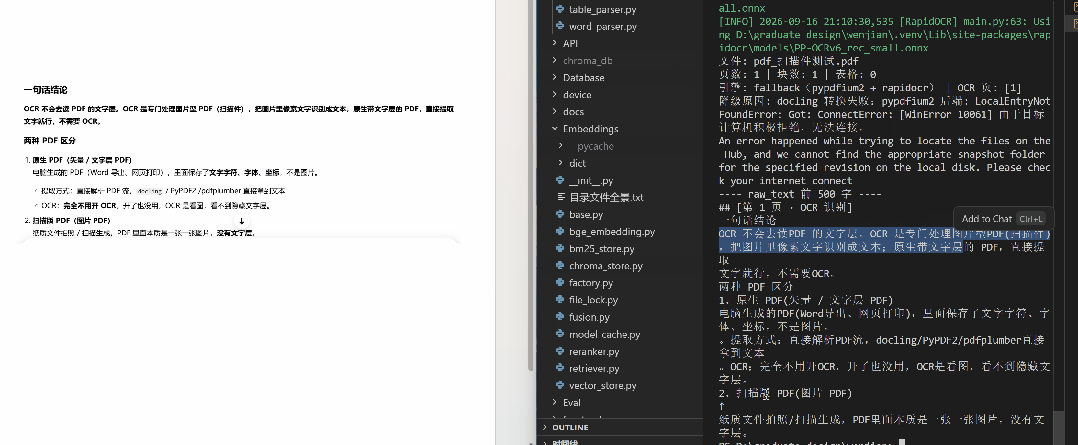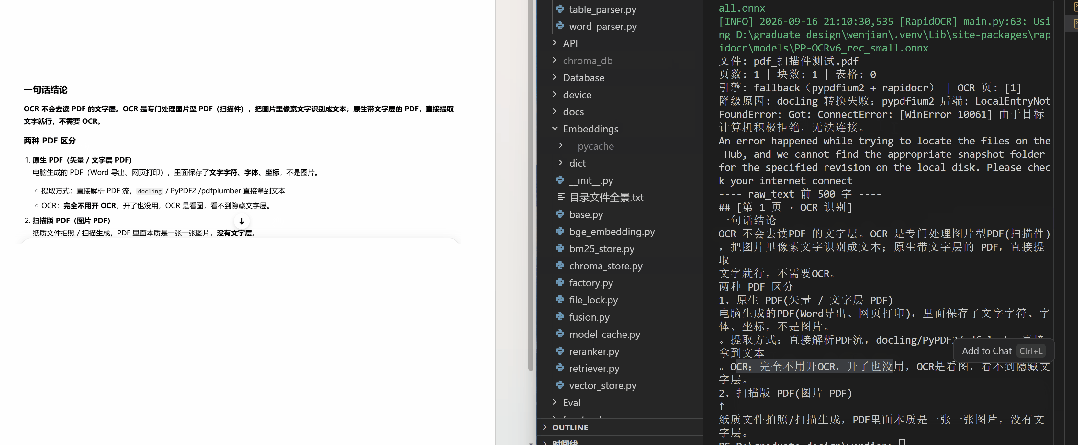
我是怎么兜底的?
先让 docling 自带 OCR 试,失败就换后端再试,还不行就用 pypdfium2 把页面渲染成图、RapidOCR 纯离线识别,结果只填空页不覆盖,全程不抛异常、不丢文件,哪些页是 OCR 来的会在 metadata 里记账(成功记来源,失败记原因)
裁判:逐页归并,只补缺口、绝不覆盖
if len(docling_text) >= self.min_text_chars: # 量的是 docling 的产物page.text, page.source = docling_text, "docling"# ② docling 这页空,但有文字层 → 用文字层elif len(layer) >= self.min_text_chars: # 量的是 pypdfium2 的产物page.text, page.source = layer, "text-layer"# ③ 连文字层都没有 → 图片页,排队等 OCRelse:need_ocr.append(page_no)OCR 结果比页面残存文字更长才采纳 —— 宁可保留零碎原文,不让空结果顶掉if len(ocr_text) > len(page.text.strip()):page.text, page.source = ocr_text, "ocr"
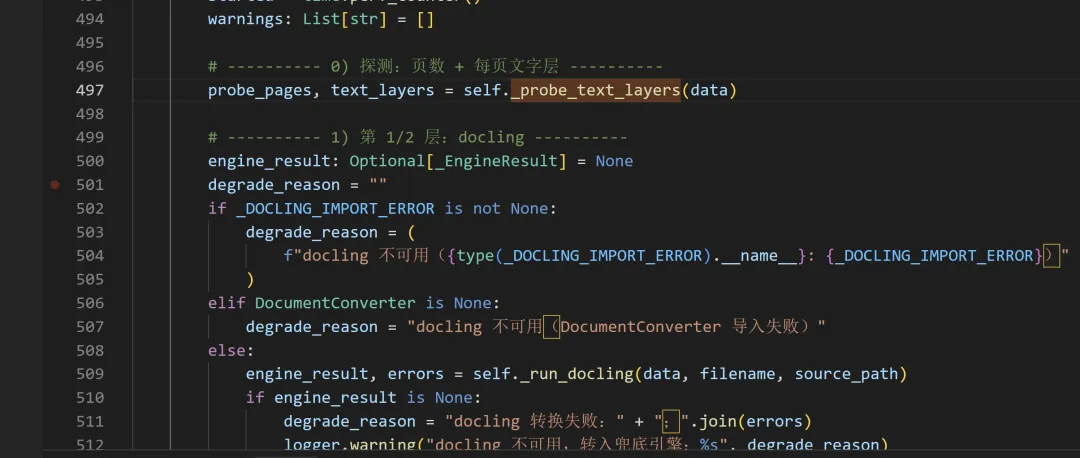
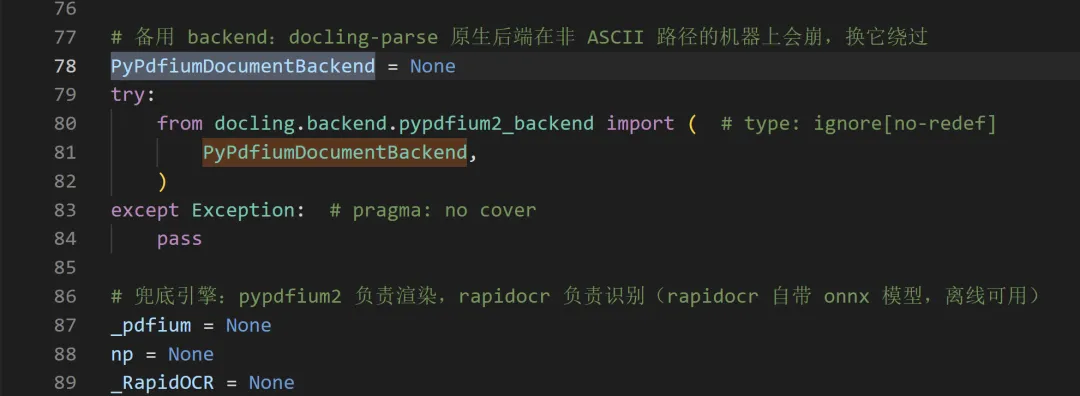
裁判不关心内容是从哪来的,最先跑用 pypdfium2 廉价地探:总共几页、每页有没有文字层——产出 text_layers 这个字典;第二个就是:docling 的备胎后端,位置在第 2 层 PyPdfiumDocumentBackend产出 engine_result(另一份输入)
pypdfium2①侦察 → 裁判(_resolve_pages) 拿着①和docling②的产物做决策│▼ 判定"这页要OCR"pypdfium2③渲染成图 → RapidOCR 认字 → 裁判复核(更长才采纳)
干活:整页渲染成图 → RapidOCR 离线识别
pdf = _pdfium.PdfDocument(io.BytesIO(data)) # 整个文件只开一个句柄,批量页复用for page_no in wanted:image = self._render_page_image(pdf, page_no - 1) # 页面渲染成图recognized = engine(image) # RapidOCR 纯离线识别out[page_no] = "\n".join(...) # 单页失败记空串,不炸整个文件
判归判,活总要有人干;干活的这段只有四步:打开 PDF(整个文件只开一个句柄,批量页复用,不开 N 次)→ 把缺字的页渲染成图片(文字抽不出来,就把它当图看)→ 交给 RapidOCR 逐页认字(纯离线,断网也能跑)→ 结果按页码装袋返回;且注意最后一行:单页失败记空串,不抛异常——一页坏了,坏的是那一页,不是整个文件。
第二崩:
1.抽出来的字够多吗?→ 每页记账,抽少了看得见
_resolve_pages:每页必留 source 标记(docling / text-layer / ocr),metadata 统计 ocr_pages;
• 页面空到不够 min_text_chars=8 就不算“有内容”,宁可排队 OCR 也不装作抽到了;
• 上面的gif实测就是证据:页数: 1 | OCR 页: [1]——哪页是谁抽的,账上一清二楚。
2.表格碎成乱码?→ 表格根本不走正文切分器
chunks.append({ # _attach_tables"content": markdown, # 表格以完整 markdown 整体进库"type": "table", # 独立成块,独享 index})
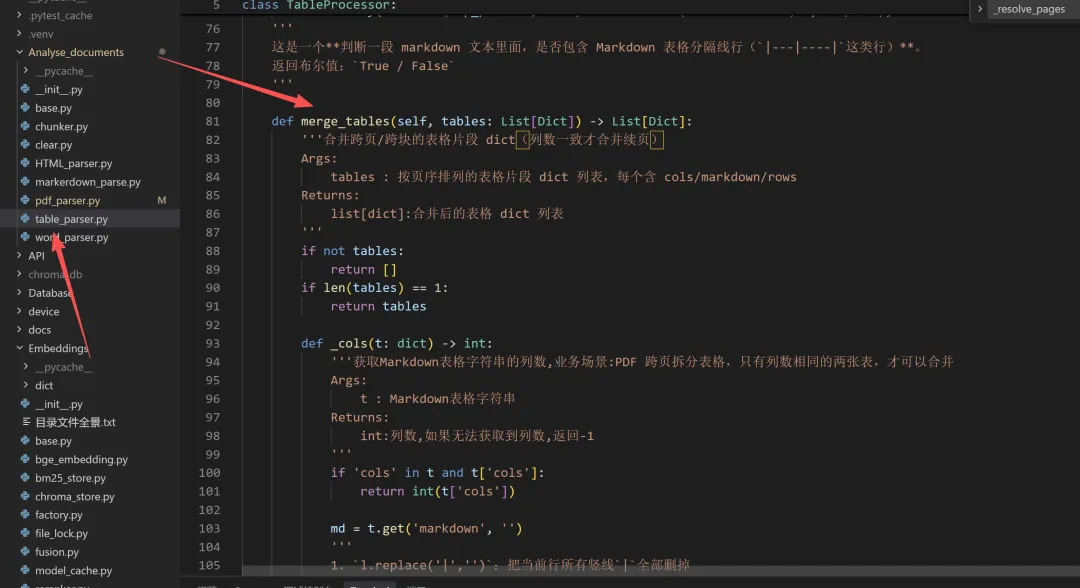
外加 merge_tables 跨页合并(列数一致才拼)——三道防线:结构化导出(docling TableFormer)→ 跨页拼合 → 独立成块,表格从头到尾没经过段落切分器,没机会被切碎。
3.关于最重要的一点就是双栏串行
目前我的代码还只能实现“半能”状态,这是不足一点,具体体现在:
第一种:数字版 PDF(有文字层)能
但不是我的代码的功劳,不是我解决的;双栏数字版走 docling 路径,阅读顺序由 docling 的版面分析模型(layout model + reading order)处理——它先识别“这是两栏”再按栏输出,所以不串行
我的体现方式是选了它并吃它的结构化输出,而不是抽裸文本流
什么是裸文本流:
裸文本流 = 不管版面,按存储顺序把字符全捞出来
用 PyPDF2 / pdfplumber 这类库,拿到的是一锅粥:
额定电流 (A) 极数 3P 2.5 施工要求 详见 250A 第3章 断路器型号 ...表格行和正文句子混在一行(表格只是“恰好排在一起的字”); 双栏按存储顺序(可能先存完左栏再存右栏,也可能交错)
什么是结构化?
先看懂版面,再按“阅读逻辑”给你;docling 的版面模型先识别“这块是标题、这块是双栏、这是个 3×4 表格”,然后交给你
第二种:扫描件(走 OCR 兜底的页):不能,会串
看 _ocr_pages 的这行:
out[page_no] = "\n".join(str(t).strip() for t in texts ...)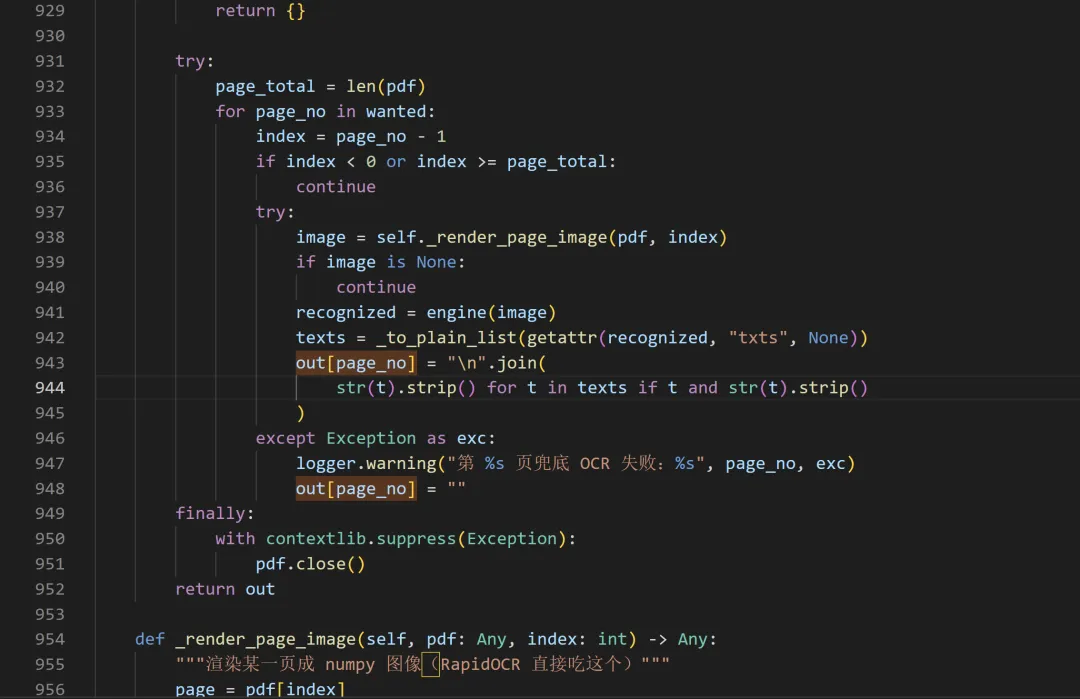
4.怎么确定页眉页脚有没有混进正文?抽得少,不如不抽
页眉页脚是检索的慢性毒药:每一页都来一遍“XX电气设计手册”"1 / 5",这些行在检索时会变成高频无意义 token,直接污染 BM25 的打分。它们混进正文块里,等于给每条查询都喂了一勺噪声。
我的解法是两道防线,各管一种页眉页脚
第一道:内容特征清洗(clear.py)
特征长得像版式噪声的,逐行正则剔除:
r'^\s*\d+\s*' # "第 3 页"r'^\s*\d+\s*/\s*\d+\s*' # 行尾带页码:"公司机密 未经许可不得外传 1 / 5"
但这道防线有两个盲区就是: 文字型页眉(比如每页顶部的书名)长得和正文一模一样,正则抓不到;而且删了什么、删了几行,它不记账——出了问题没法回溯。
第二道:跨页重复检测(_strip_repeating_header_footer)
页眉页脚的本质特征其实不是内容,是位置和重复性:同一段文字固定出现在多数页面的顶部/底部——不管它写的是什么
# 每页取顶部/底部各 3 行作候选区,统计每行出现在几个不同页min_occurrences = max(2, math.ceil(0.5 * len(pages_with_text)))suspects = {k for k, c in zone_counter.items() if c >= min_occurrences}# 命中的行从候选区移除,metadata['header_footer_removed'] 记账可回溯
不依赖内容、不依赖坐标,docling 路径和 OCR 路径都有效。
防误杀的护栏比检测本身还重要,我加了四道:
页数 < 3 不判——两页构不成统计信号; 短页(非空行 ≤ 6)整页跳过——候选区会覆盖全页,必然误杀正文(这是测试用例逼出来的 bug); 长度 < 4 的短行不参与判定——防"3"这种行号被误删; 整页会被删空的页放弃移除——宁可保留也不产生空页
两道防线的分工是实测出来的:我造了一份 5 页、带页眉页脚的 PDF 跑解析;
由于文件大小的限制,我这里不展示,文件在gif文件夹,有意向可以查看;另外需要区别理解的就是:
单元测试故意用假数据,是因为它要快、稳定、可控——真 PDF 每次跑要 30 秒还依赖网络兜底,测不出“短页保护”这种构造出来的边界情况
第三崩:OCR 该什么时候出手?按页决定,而不是按文件决定
我的解法是把决策粒度从“文件”降到“页”;简单理解就是:
第一步:先用最便宜的方式侦察一遍
pypdfium2 探明总页数和每一页有没有文字层——不解析、不 OCR,几毫秒的活:
text_layers = self._probe_text_layers(data) # {页码: 文字层内容}第二步:逐页三分支,OCR 是最后一张牌。
# ① docling 抽到了 → 直接用(版面/表格最准)# ② docling 空,但文字层够长(≥8字符)→ 用文字层# ③ 连文字层都没有 → 图片页,才排队等 OCRif self.enable_ocr and self.enable_fallback_ocr:need_ocr.append(page_no)
第三步:攒一批再跑:
判定完不是逐页开 OCR,而是把 need_ocr 攒成队列,一次打开 PDF 句柄批量渲染识别——30 页里只有 3 页是扫描的,就只为这 3 页付 OCR 的时间
两道加速护栏:OCR 引擎全局单例(初始化要 1~2 秒,只付一次);
fallback_ocr_max_pages 限制兜底页数上限——几百页的纯扫描件不会把接口卡死,宁可少认几页也不能让系统没响应。
一句话总结这道设计:OCR 在我的系统里不是功能开关,是逐页兜底的最后一环——能用便宜的(文字层)绝不走贵的(看图认字),必须走贵的也只走必要的那几页
三次崩溃,其实是同一件事
1.兜底不是备胎思维,是默认思维:
三层引擎、逐页 OCR、正则清洗——每一层都假设上一层会死。文件不会按你预期的方式到来,这是解析层的第一公理。
2.降级必须留痕:
每一次“没走主路”都被记进了 metadata:ocr_pages、degrade_reason、header_footer_removed。系统可以降级,但不能降级得不明不白——不然你连“它今天表现好不好”都回答不了。
3.决策粒度决定成本:
“整本 OCR”是文件级决策,“这页要不要 OCR”是页级决策——把粒度切细,成本就只在必要处发生。页眉页脚同理:按特征删、按位置判,比“一刀切”便宜且准。
系列到这里,解析层的PDF算是解决了,下期分享我是怎么解决markdown的解析,仓库同第一篇