ARTICLE · 1027087
AI-Native 软件工程:03. MVP后的疯狂与失控
在软件工程领域,MVP 是 Minimum Viable Product 的缩写,中文通常翻译为 “最小可行产品”。
它指的是一个产品的最初版本,只包含核心功能,足以让早期用户使用并给出反馈,但还远不完整。
来,让我们请出版本控制界的神:Git 和 worktree ,这玩意儿让你不用奇异博士的魔法也能进入不同的平行世界,在不显山不露水之间掌控全局。
你是否遇到过 MVP 终于跑起来以后,看到不满意的半成品,脑中的文思泉涌,让AI一顿改,然后,对,就没有然后了,你已经对着AI的输出结果骂街了...
回到我们们的虚拟场景:错题应该隔几道再出现;题目难度应该跟着孩子的表现变化;答对以后最好让孩子解释思路;家长还需要一张学习报告。
是的,有时候想法太多也不是什么好事。
错题应该隔几道再出现;题目难度应该跟着孩子的表现变化;答对以后最好让孩子解释思路;家长还需要一张学习报告。
过去,这些想法会被开发成本挡住。现在,你只要同时打开几个 AI 编程任务,它们就会一起开工。
上午还是一个能用的 MVP。下午,三个 Agent 已经改了状态结构,两个 Agent 动过同一个页面,还有一个顺手重构了你根本没让它碰的代码。
每个任务单独看都像有进展。合在一起,应用却打不开了。
AI 把开发速度提高以后,混乱也会以同样的速度增长。
所以,MVP 之后真正的问题不再是“AI 能不能做”,而是:
怎样允许十个想法同时发生,又不让任何一个想法直接伤到现在能用的版本?
在第一篇里,我们用 Context 和 PRD 告诉 AI:为什么做、为谁做、哪些原则不能猜。
戳这里AI-Native 软件工程:01. Context & PRD
第二篇,我们补上 Verification 和 State:什么才算完成、证据在哪里、下一轮从哪里继续。
戳这里AI-Native 软件工程:02. Execution & Verification
但当多个任务同时发生,新的矛盾出现了。
你可以把每个任务都写得很清楚,也可以让每个 Agent 都认真测试。可如果它们同时在同一份目录里修改代码,依然会互相覆盖、互相污染。
Agent A 正在改错题队列,Agent B 把题目数据结构换了;Agent C 为了做难度自适应,又重写了同一套状态管理。三个人都正确地完成了自己的局部任务,组合起来却可能完全不成立。
这时再靠一个人不停提醒“别改那里”“先等另一个任务结束”,很快就会成为新的瓶颈。
真正的并行,不是让更多 Agent 同时敲键盘,而是让每个 Agent 都拥有一个互不干扰的实验空间。
这正是 Git 和 worktree 开始接管全局的地方。
很多新手第一次接触 Git,把它理解成一种更麻烦的云盘:代码改坏了,还能找回旧版本。
这当然没错,但只看到了它最浅的一层。
Git 真正珍贵的地方,是它允许同一个产品同时拥有多个可能的未来。
官方的《Pro Git》把分支描述为一个指向提交记录的轻量指针。创建和切换分支的成本很低,因此 Git 鼓励开发者频繁地分支和合并,甚至一天发生多次。
翻译成人话:
main:当前已经被验证、随时可以回去的现实。
branch:一个尚未被证明的产品假设。
commit:一次有名字、可比较、可回退的实验快照。
diff:这次实验究竟改变了什么的审查界面。
merge:让一个被验证的未来,正式进入现实。
这样理解以后,Git 就不再只是“代码坏了怎么办”。
它开始回答更重要的问题:
我们现在同时在验证哪些假设?
每个假设改动了什么?
哪一个已经通过测试?
哪一个应该保留、推迟,或者直接扔掉?
分支不是代码的复印件,而是一张写着“如果这样做,会发生什么”的实验单。
分支解决了“多个未来如何被记录”,但还没有完全解决“多个 Agent 如何同时工作”。
如果所有分支都挤在同一个项目目录里,你每次只能把其中一个版本摆到桌面上。切换分支时,尚未提交的改动还可能挡住你。多个 Agent 同时写同一目录,更是灾难。
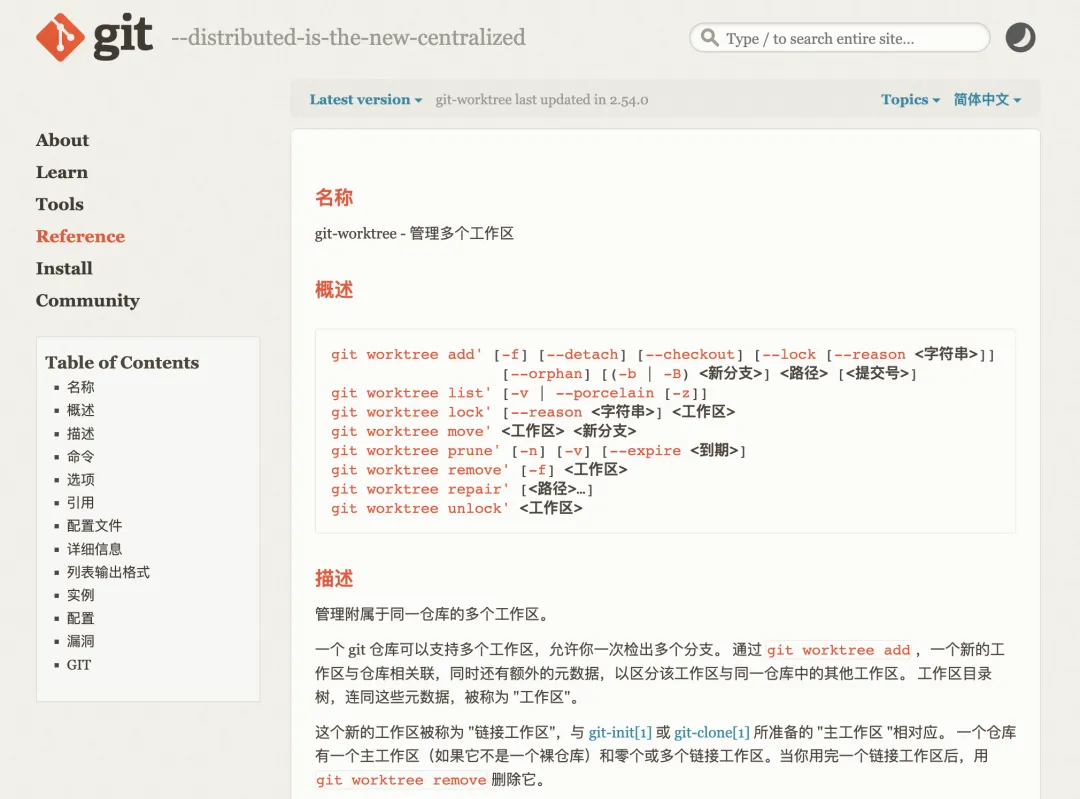
worktree 做的事情看起来很小:它让同一个 Git 仓库同时拥有多个独立的工作目录,并让不同分支分别出现在这些目录里。每个 worktree 有自己的工作文件、HEAD 和暂存状态,同时共享同一个仓库里的历史与对象。
它像是给每个实验分了一间独立实验室:
实验室 A:只实现错题延迟重现。
实验室 B:只验证难度自适应。
实验室 C:只尝试“让孩子解释思路”的交互。
主实验室:继续保持 MVP 的稳定版本,随时可以演示和使用。
现在,四个目录可以同时打开,四个 Agent 可以各自运行、测试和提交。A 改坏了,不会把 B 的页面一起拖垮;C 的思路失败了,直接丢掉那间实验室即可,主线不需要跟着回滚。
这和复制四份项目文件夹不同。手工复制会产生四套互不认识的历史,最后很难说清每份改了什么,也很难把好结果准确带回来。worktree 仍然属于同一个 Git 仓库,变化可比较、可审查、可合并。
Git 让未来分叉,worktree 让这些未来同时落地。
这不是为了把 Git 玩得更花。
2026 年,OpenAI 分享了一个内部团队如何用 Codex 构建真实产品的实验。他们发现,当代码产出速度迅速提高以后,最先撞上的瓶颈不是生成能力,而是人的验收时间。
于是,他们让应用可以在每一个 Git worktree 中独立启动。每次改动都有自己的应用实例,Agent 可以自己打开页面、复现问题、操作界面和验证修复;日志、指标和追踪数据也跟着这个 worktree 临时存在,任务结束后一起销毁。
这一步非常关键。
因为 worktree 只隔离了文件,还没有自动隔离运行环境。如果三个应用都抢同一个端口、共用同一份本地数据库、把日志写进同一个目录,它们仍然会互相踩脚。
OpenAI 真正做的,是让每个 worktree 都成为一个完整、可观察、可销毁的任务环境:
ONE CHANGE, ONE WORLD
一项改动,一条分支,一个 worktree,一套可独立运行的应用,一份只属于它的验证证据。
OpenAI 目前也把内置 worktree 和云端环境作为 Codex 多 Agent 并行工作的重要基础。
所以这里真正值得抄的,并不是“多开几个 Agent”。
而是先把隔离、运行、观察和回收做好,再谈并行。
新手不需要复制大公司的整套设施。只要守住下面六步,就能让 AI 快速跑,而自己不用追在后面收拾残局。
这里有三个容易被忽略的细节。
第一,分支名要写假设,不要写人名。“exp/spaced-review”比“eason-test-2”更能告诉下一位接手者:这里到底在验证什么。
第二,提交要小到可以判断。不要让 Agent 攒一千行以后一次提交。一次提交最好只表达一个有意义的变化,并带上相应测试。
第三,合并不是搬运,是晋级。不是“Agent 做完了就合”,而是验收证据通过、与最新主线组合后仍然通过,才进入 main。
如果你的工具不会自动创建 worktree,最小操作其实只有几行:
# 从稳定主线创建一个独立实验室 git worktree add -b exp/spaced-review ../math-spaced-review main # 查看现在有哪些实验室 git worktree list # 实验结束后回收工作目录(分支会继续保留) git worktree remove ../math-spaced-review重点从来不是记住命令,而是形成“一项实验,一个空间,一份证据,一次晋级”的纪律。
有了 worktree,很容易走向另一个极端:既然互不影响,那就同时开十个 Agent。
但文件隔离,不等于逻辑独立。
错题重现和难度自适应都要改题目状态模型;学习报告又依赖前两者生成的数据。如果三个任务从同一个旧版本同时出发,它们可能各自通过,最后却在合并时互相冲突。
所以,决定并行度的不是你能开多少 Agent,而是任务之间有多少共享状态。
适合并行:互不依赖的测试补充、独立页面、文案调整、不同方案的探索性原型。
谨慎并行:同时修改同一个核心模块、数据库结构、公共接口或全局状态。
不要并行:后一个任务必须依赖前一个任务结果,但它们却从同一个旧基线出发。
在数学应用里,更合理的顺序是:
先让“错题重现”和一个纯视觉优化在两个 worktree 中并行,因为它们几乎不共享逻辑。
错题重现通过并合入 main 后,再从新的 main 创建“难度自适应”实验,因为它依赖更新后的学习状态。
家长报告最后做,因为它消费前面两个功能产生的数据。
你不是在管理 Agent 的忙碌程度,而是在管理变化进入系统的顺序。
这就是“不显山不露水地掌控全局”。
你不需要盯着每一行代码,也不需要成为所有技术细节的专家。你只需要守住稳定基线,切清任务边界,知道哪些可以并行,要求每个实验留下证据,并决定合并顺序。
第一篇,我们把意图交给 AI。
第二篇,我们让结果接受验证。
第三篇,我们终于可以让多个变化同时发生,却不丢掉对产品演进的控制。
真正的快,不是每条路都冲到底,而是可以同时探索很多条路,只把正确的那条接回主线。
关注 AI星期五
继续拆解 AI-Native Engineering:怎样把 AI 从一次性的生成工具,变成可持续工作的工程系统。
Git, Branches in a Nutshell 与 Branching Workflows。关于轻量分支、主题分支和频繁分支合并。 Git,git-worktree Documentation 关于一个仓库关联多个工作目录,以及各 worktree 独立的 HEAD、index 与工作文件。 OpenAI,Harness engineering: leveraging Codex in an agent-first world, 2026-02-11。关于应用按 worktree 独立启动,以及为每项改动隔离日志、指标和验证环境的实践。 OpenAI,Codex。关于内置 worktrees、云端环境与多 Agent 并行工作。