ARTICLE · 1027244
还在手动啃几百页 PDF?试试这个开源工具
上周帮一个做科研的朋友整理资料,他丢给我一个 347 页的 PDF 论文合集,说"把里面的表格和公式都提取出来,我要建知识库"。
我打开第一页就头大了——双栏排版、密密麻麻的公式、嵌套表格,还有几页是扫描件。这种文档,复制粘贴出来的东西根本没法用,格式全乱,公式变成乱码,表格散成一堆文字。
以前遇到这种情况,我只能要么手动敲,要么用那些在线转换网站,传上去等半天,下载下来发现还是得人工修。
直到前两天我发现了 Marker v2。
以前处理PDF就像这样——乱成一锅粥
Marker v2 是什么?
一句话说清楚:它是一个开源的文档解析工具,能把 PDF、图片、Word、PPT、Excel、HTML 甚至 EPUB 电子书,全部转成结构清晰的 Markdown。
GitHub 上已经 37000+ 星标了,Datalab 团队做的,7 月份刚做了个大版本重写,代号 Marker v2。
支持 90 多种语言,中英文混排完全没问题。
代码开源,Apache 2.0 协议,商用也没问题。
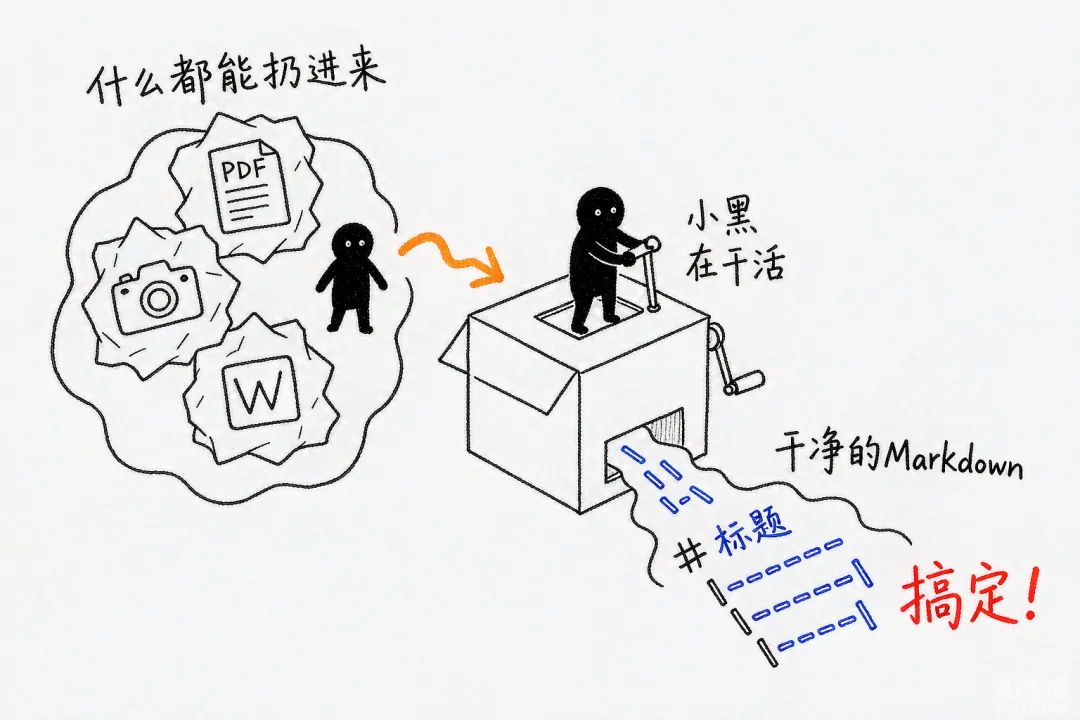
什么格式的文档扔进去,出来的都是干净的Markdown
为什么推荐它而不是别的工具?
市面上的 PDF 转换工具一大堆,我为什么专门说这个?
三个原因:准、快、省。
先说准。Marker v2 在 olmOCR-bench(Allen AI 出的第三方权威基准测试)上拿了 76.0% 的总分,在"原生数字 PDF"这个分类上更是到了 83.5%。同场竞技的 MinerU 拿了 72.7%,Docling 拿了 50.3%。数据摆在这,不多解释。
再说快。同样一块 GPU(B200),Marker v2 每秒处理 2.9 页,MinerU 的管道模式只有 0.54 页/秒。差了 5 倍多。这得益于它的架构设计——多个轻量 CPU Worker 共享一个推理服务器,并发效率拉满。
最后说省。它有三种运行模式,你可以根据自己的硬件和精度需求选:
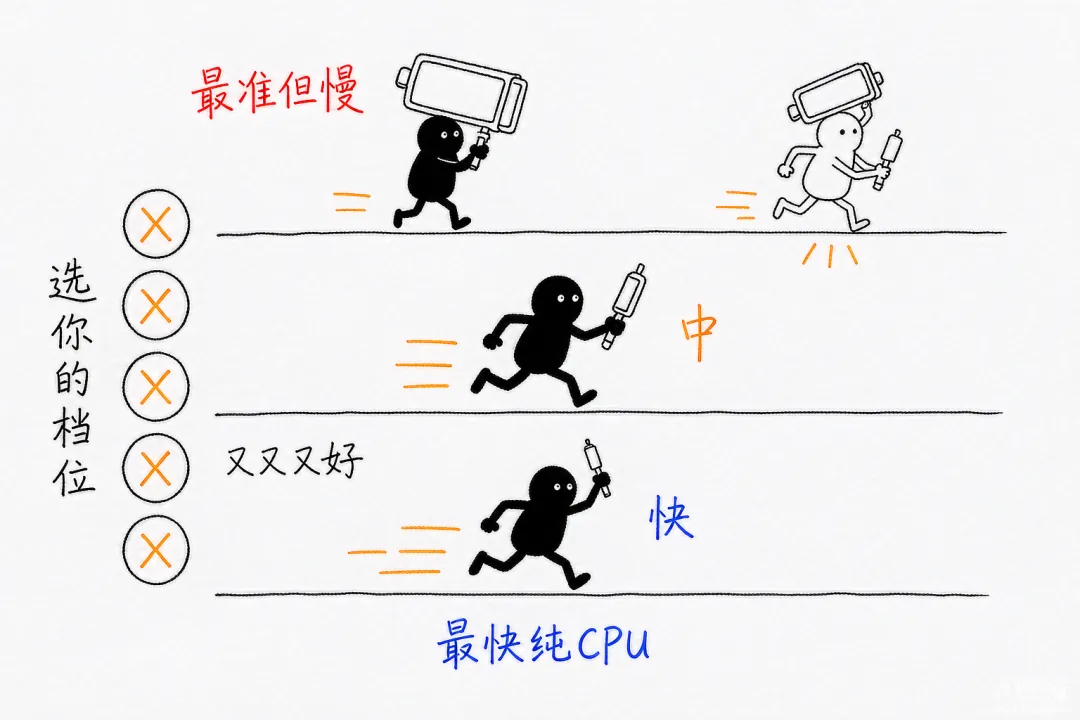
三种模式,按需选择你的档位
看到没有,就算你没有显卡,纯 CPU 也能跑,每秒 23 页。虽然精度低一些(只提取文本层,不 OCR),但处理大量普通文档够用了。
它到底能干什么?
别被"文档转换"四个字局限了,实际能做的事挺多的:
1. PDF / 图片 → Markdown
这是核心能力。不管是双栏学术论文、扫描件、还是截图,扔进去就出 Markdown。表格保留结构,公式转成 LaTeX,代码块自动识别,连图片都会单独提取出来保存。
2. Word / PPT / Excel → Markdown
对,不只是 PDF。docx、pptx、xlsx 全都支持。你收到一份 PPT 想要里面的文字内容?直接转。一份 Excel 表格想变成 Markdown 格式?也行。
3. 批量处理
如果你有一整个文件夹的文档要转换,一条命令搞定:
marker /path/to/your/folder --output_dir ./output它会自动遍历文件夹里所有支持的文件,多进程并发处理。单机多显卡的话设置环境变量 VLLM_GPUS=0,1,2,3 就能调用所有 GPU。多台机器的话还支持分片并行。
4. 当 Python 库用
不想用命令行?直接在代码里调:
from marker.converters.pdf import PdfConverter from marker.models import create_model_dict from marker.output import text_from_rendered converter = PdfConverter(artifact_dict=create_model_dict()) rendered = converter("你的文件.pdf") text, _, images = text_from_rendered(rendered) print(text) # 这就是转换好的 Markdown 文本5. 自带可视化界面
不想写代码也不想敲命令?它有个 Streamlit 写的 GUI,装完之后输入 marker_gui 就能在浏览器里拖拽上传、实时预览结果。
怎么安装?三行命令的事
前提:Python 3.10 以上,装了 PyTorch。
# 基础安装(PDF 转换) pip install marker-pdf # 完整安装(支持 PDF/图片/Word/PPT/Excel 等) pip install marker-pdf[full] # 启动可视化界面 pip install -U streamlit streamlit-ace marker_gui装完就能用。转换单个文件:
marker_single 你的文件.pdf --output_dir ./output就这么简单。
实际效果怎么样?
我拿那个 347 页的论文集测了一下。
用 balanced 模式(GPU),大概两分钟处理完。输出的 Markdown 里,双栏内容正确合并了阅读顺序,表格基本完整,公式变成了可渲染的 LaTeX 格式,参考文献列表也很规整。
有几页扫描件的 OCR 效果出乎意料的好,Surya OCR 2 这个 6.5 亿参数的模型确实有点东西。
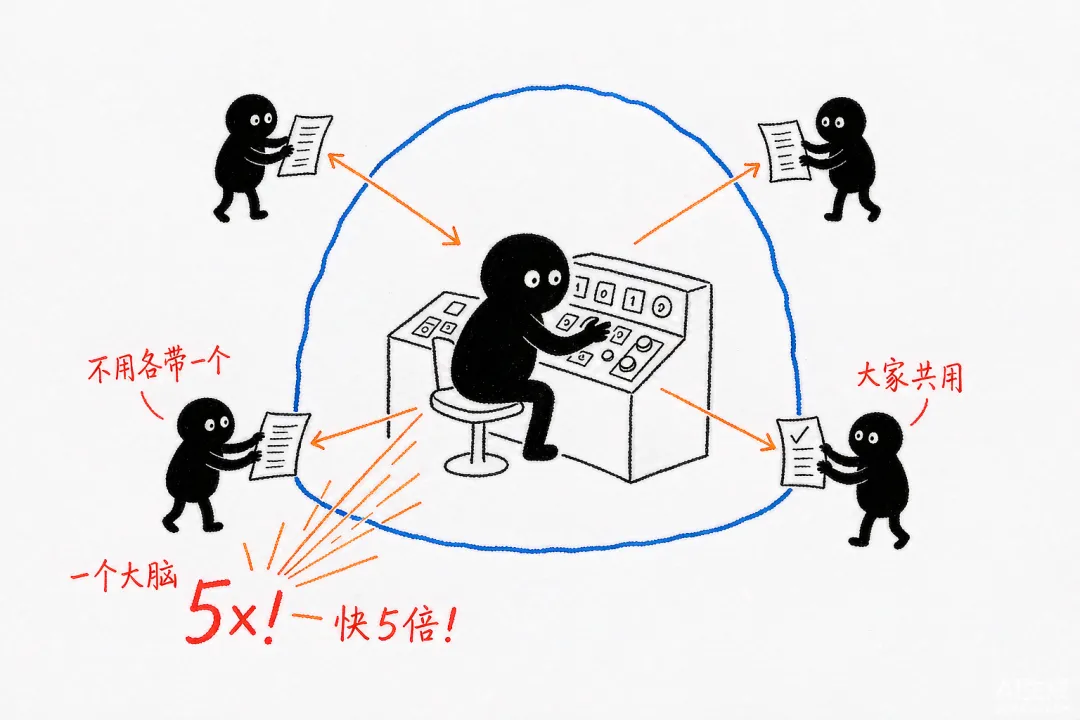
多个Worker共享一个推理服务器,这就是快5倍的秘密
当然也不是完美的。复杂的三线表偶尔会出错,极个别数学符号识别有偏差。但跟以前用过的工具比,已经好太多了。而且它还在快速迭代,7 月才发布 v2,9 月已经在持续更新 bug 和优化。
谁适合用?
我觉得这几类人可以重点关注:
做学术/科研的 —— 论文、报告批量转 Markdown,建知识库、喂 RAG,效率直接翻倍
搞 AI 开发的 —— 训练数据预处理、文档向量化,它是很好的上游工具
需要归档大量文档的 —— 合同、报告、手册,统一转成结构化文本方便检索
纯粹想偷懒的 —— 别手动复制粘贴了,让机器干这活
最后说句实在话
工具再好,也是拿来用的,不是拿来收藏的。
如果你手头正好有一堆 PDF 要处理,今天就可以装一下试试。三行命令,五分钟上手,不好用你再卸掉也不亏。
🔗 github.com/datalab-to/marker
点个 star 支持一下开源作者
觉得有用的话,收藏起来,下次遇到 PDF 转换的需求翻出来照着做就行。