ARTICLE · 1029213
如何用AI进行量化因子挖掘
很多人第一次把AI用到量化研究时,往往从一句很直接的指令开始:
AI很快会给出一串听起来合理的词:估值、动量、盈利质量、情绪、资金流……再进一步,它还能拼出公式、生成代码、批量跑回测。效率的确提高了,但真正的难题没有消失:这些因子为什么可能有效?它们在当时真的可获得吗?漂亮结果是规律,还是搜索太多后的巧合?
用AI做因子挖掘,最有价值的姿势不是“让它替你找圣杯”,而是把它放进一套可追溯、可反驳的研究流程里。下面这套五步框架,适合从零搭起自己的AI因子研究台。
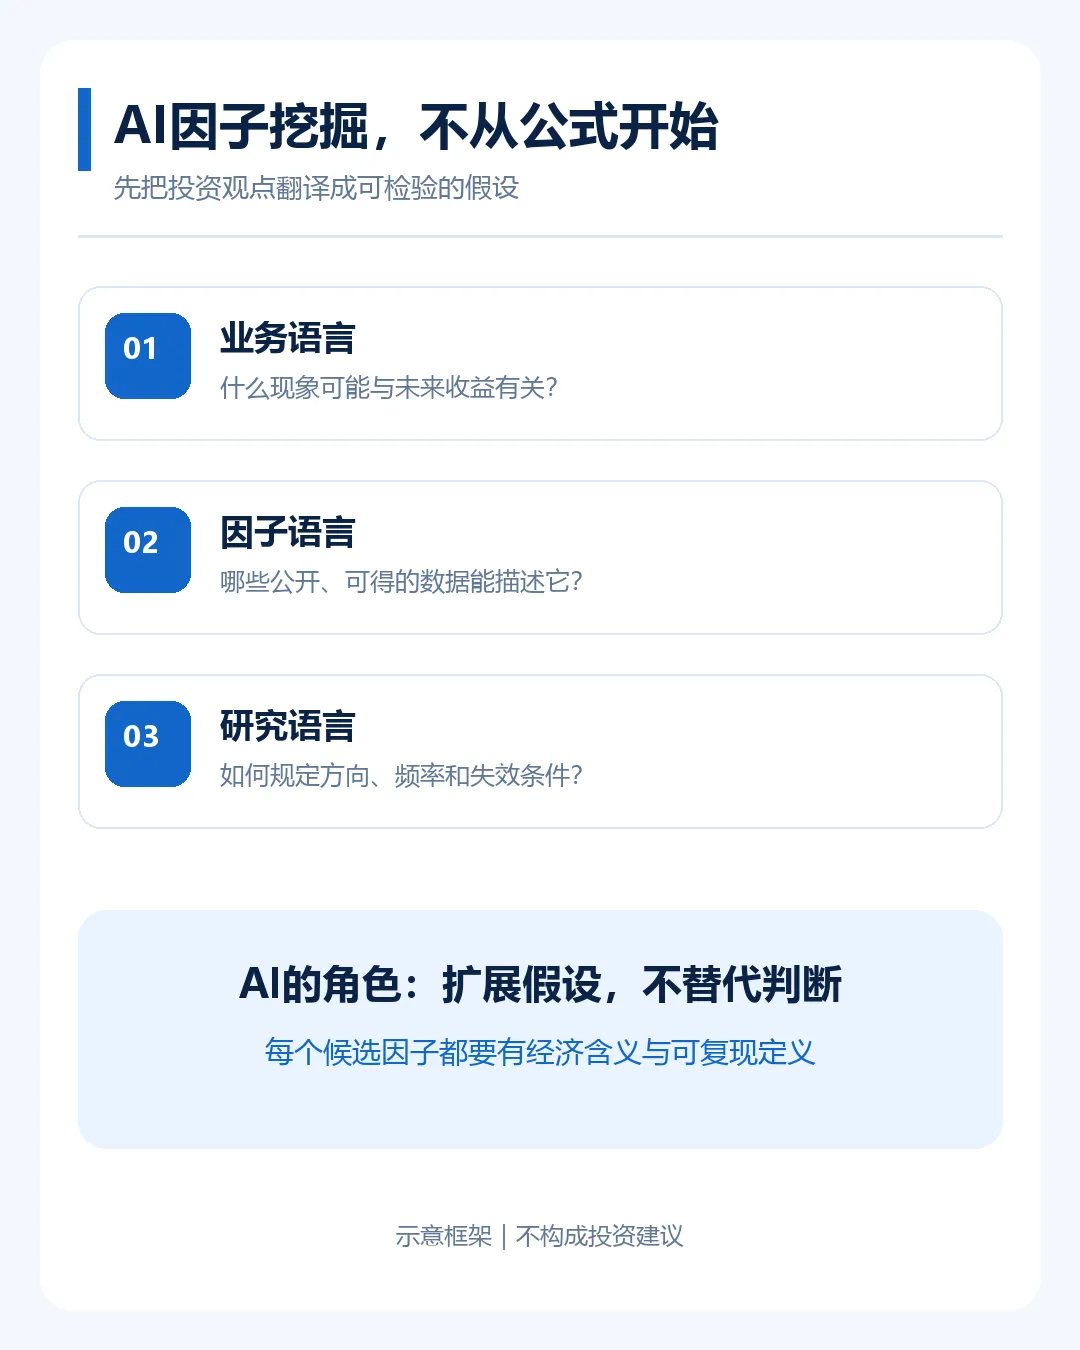
因子不是一个华丽公式,而是一个关于未来收益或风险的、可以被数据检验的假设。好的起点通常来自现实观察,例如:市场是否会对信息反应不足?盈利改善能否持续?拥挤交易是否会放大波动?
把这类问题交给AI时,不要只要答案。可以要求它完成三件事:列出可能的传导路径;提出可观测变量;同时写出让假设失效的反例。
例如,“盈利改善”不应立刻等于某个利润增速公式。AI可以先拆成收入、利润率、现金流、预期调整等不同维度,再说明各维度的发布时间、频率和潜在混杂因素。这样得到的是候选清单,而不是未经审视的指标堆。
一个实用提示词是:
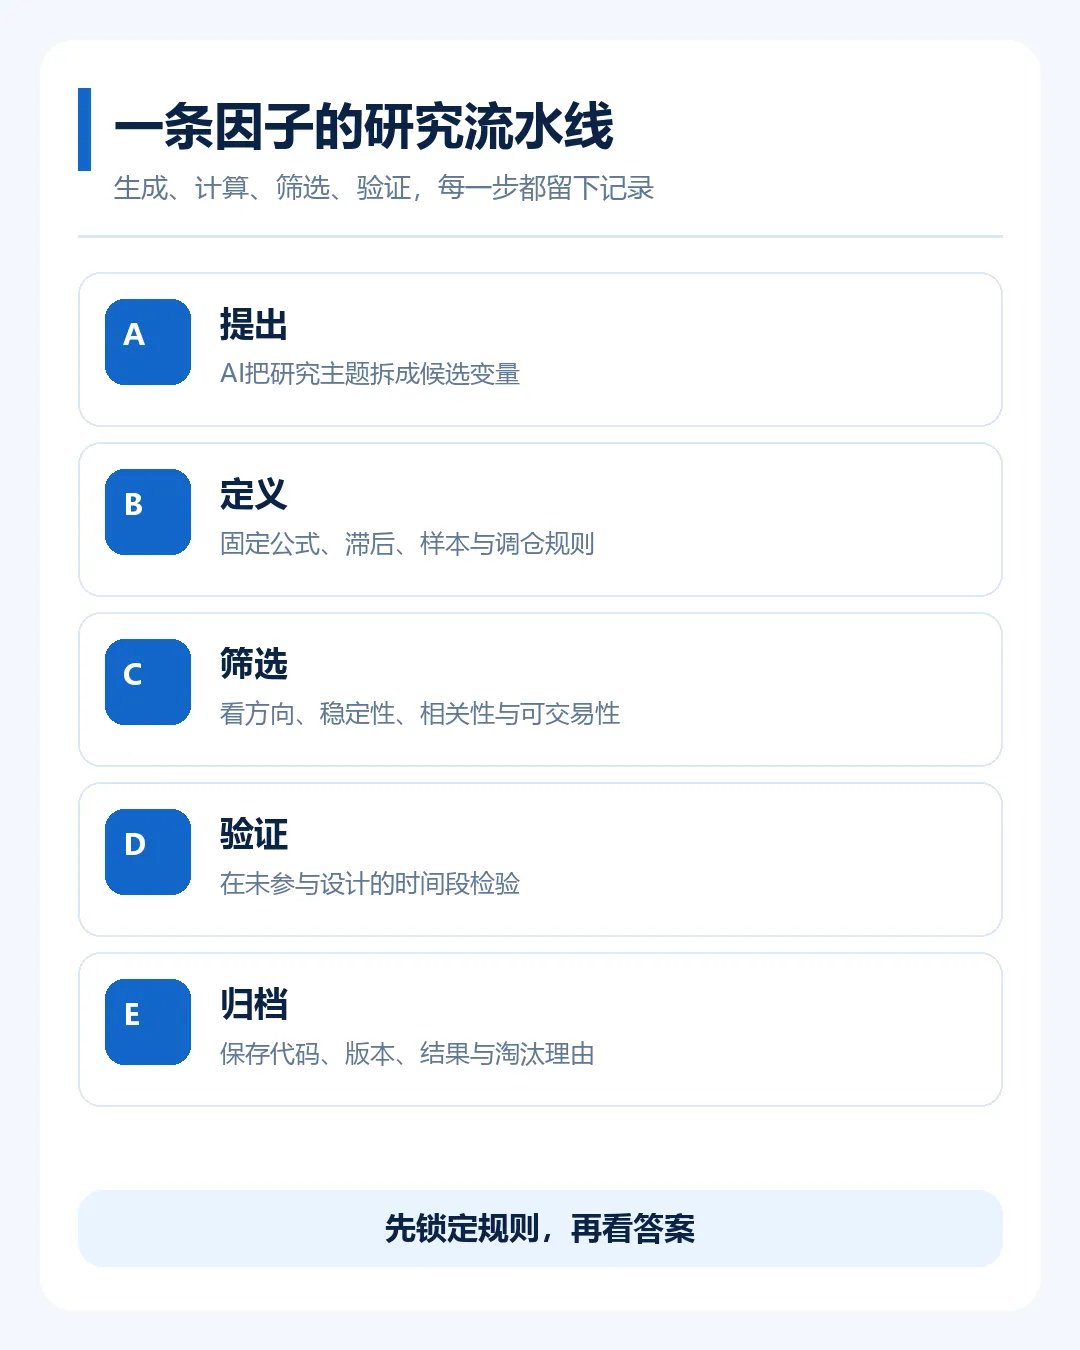
AI最擅长把模糊的研究意图变成结构化规格。你需要它输出的不是一句“用ROE和营收增速”,而是一张因子定义卡:
- 公式是什么? 用哪个字段、如何标准化、是否做行业和市值中性化。
- 数据何时可用? 使用披露日,而不是报告期末;需要时加入保守的滞后。
- 适用于谁? 股票池、流动性门槛、停牌与新股处理规则都要写清。
- 怎样变成持仓? 排序方向、分组方法、调仓频率与价格假设必须固定。
这一步看似琐碎,却决定研究能否复现。特别是财务、公告和另类数据,最容易把“后来修订过的数据”误当成当时已知的信息。研究平台也把这一点列为前视偏差的核心来源:应使用时点数据;若没有,就设置合理的信息滞后。
当定义卡准备好后,AI可以成为高效率的“研究助理”:根据限定的变量库生成变体、写计算代码、自动出描述统计,甚至将同一逻辑改写成不同公式表达。
关键在于,先限定搜索语法,再开始搜索。 比如只允许使用过去N期的算子;限制公式深度;不允许出现无法解释的嵌套;每个候选必须附上经济含义和版本号。这样做会牺牲一点“灵感数量”,却能保住后续审计和排错的能力。
原因很朴素:在足够多的变量、参数和样本切分中,总能偶然挑出好看的结果。关于“因子动物园”的研究指出,学术文献中已发表的因子数量庞大,数据挖掘和多重检验会放大幸运发现的风险。
因此,给AI的任务不应是“找表现最好的100个因子”,而应是“在限定空间内提出候选,并完整记录被测试的全部版本”。被淘汰的公式也要留下来——它们能告诉你,结果是否只是从大量尝试中挑出来的幸运儿。
单看一个IC、年化收益或夏普比率,远远不够。更稳妥的筛选顺序是:
- 方向与稳定性: 不只看全样本平均值,也看不同年份、不同市场状态下方向是否频繁翻转。
- 横截面独立性: 与已有因子的相关性有多高?它带来的是否只是同一暴露的重复表达?
- 组合可实现性: 流动性、换手、价格冲击和交易成本会吃掉多少边际优势?
- 样本外验证: 把一段从未用于公式选择和参数调整的时期留出来,最后才打开结果。
AI可以为每个因子自动生成“研究档案”:定义、参数、数据版本、筛选结果、失败场景和图表。但决定是否保留的标准,必须预先写下,不能看完结果再倒推规则。
市场环境会变,单一历史区间的优异表现并不等于未来可用。相比在全样本上找一组最优参数,更接近现实的做法是滚动训练与检验:只用当时之前的一段数据选择规则,再把它应用到后续未见期间,循环向前推进。
这种“走步式”检验不能保证因子有效,但它能把一个关键问题摆到桌面上:如果当时不知道未来,研究者还能做出同样的选择吗? QuantConnect 对走步优化的说明也强调,参数通常依赖训练区间,频繁调整带来适应性与过拟合之间的取舍。
对于AI生成的公式,还应增加两道门:一是代码审阅,防止滞后、分组、缺失值处理悄悄改变含义;二是语义审阅,确认公式仍与最初的经济逻辑一致。AI能写出“像样”的表达式,不代表它解释的是同一个现象。
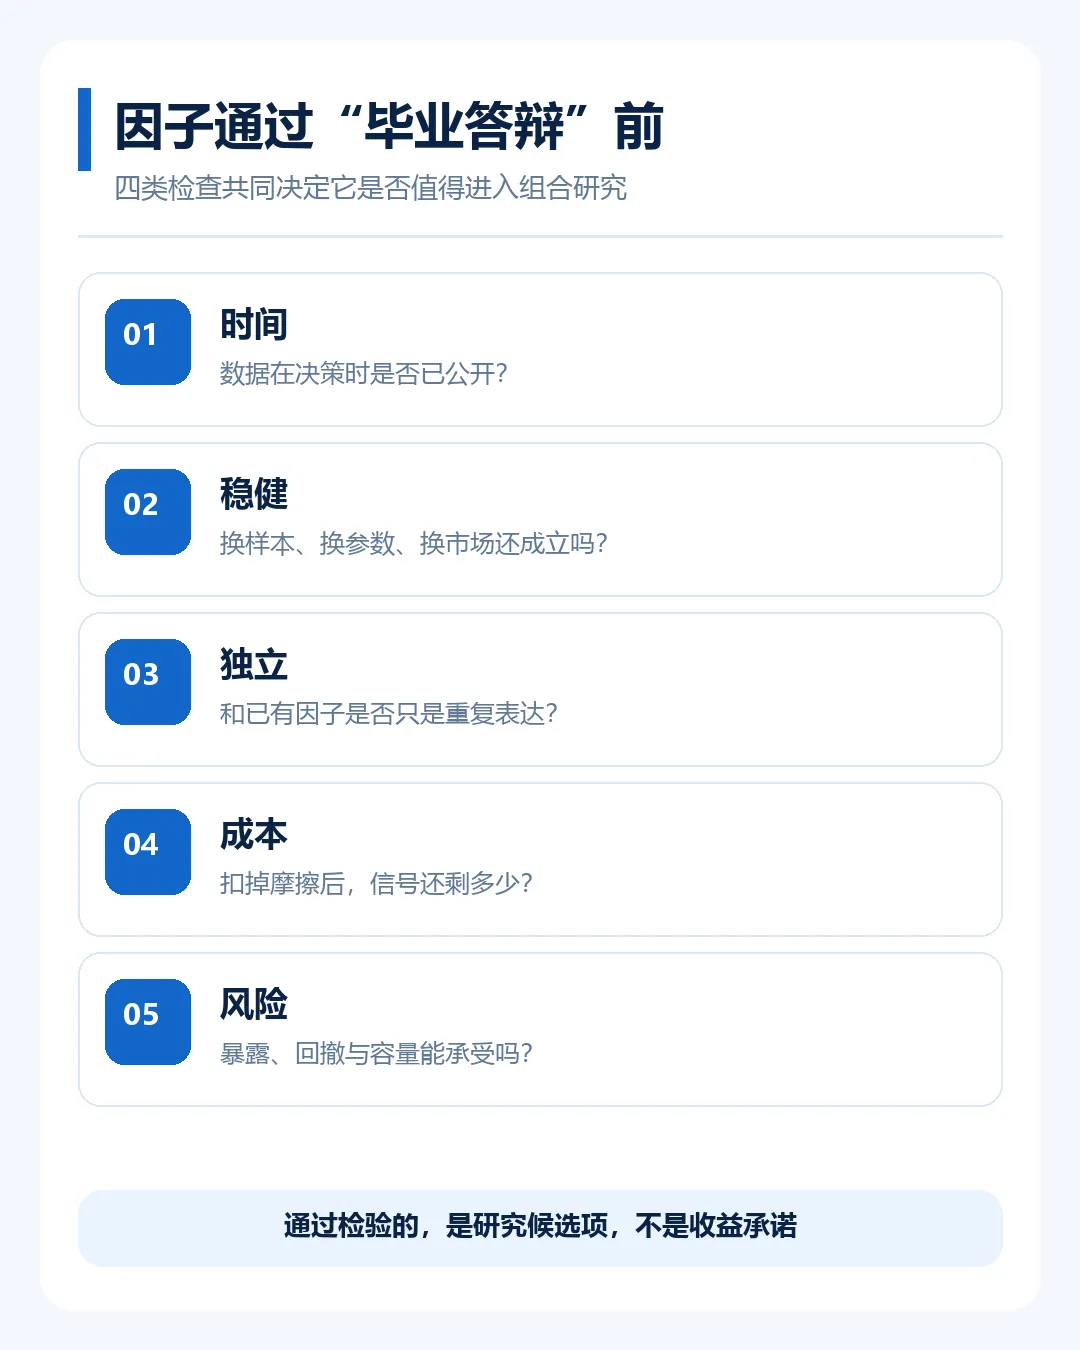
当一个候选因子准备进入组合研究时,逐项追问:
- 时间对吗? 每个输入在交易决策之前真实可得吗?
- 定义清楚吗? 公式、方向、股票池、调仓规则是否可由别人复现?
- 稳健吗? 换区间、换合理参数、换市场状态后,结论还成立吗?
- 独立吗? 它是否只是已有因子的改名或线性组合?
- 能交易吗? 扣掉合理成本和冲击后,是否仍值得继续研究?
- 能解释吗? 如果结果反向,原有经济逻辑是否仍说得通?
AI正在降低因子研究的表达、编程和试验成本。这是好事:个人研究者终于可以把更多时间放在问题定义、数据质量和结果解释上。
但效率提高也意味着更容易批量制造幻觉。真正值得珍惜的不是AI一次生成了多少个公式,而是你能否说清一个因子从哪里来、在什么条件下会失效、经过了哪些未见数据的检验。
把AI当成提出假设、整理实验、挑战反例的伙伴;把时间可得性、样本外验证、交易摩擦与风险约束当成不可谈判的门槛。这样挖到的,也许不是最快出现的“神因子”,却更接近一条经得起复查的研究线索。