ARTICLE · 1029598
AI越大越聪明?中国团队换了个办法:让两个模型分工干活
让一个AI找新材料,到底是在考它什么?
背得出化学知识还不够。它得查数据、选工具、填对参数,算完以后还要判断:这个结果值得继续追,还是该换条路?
这有点像开餐馆。懂菜谱,还得买对菜、备好料、控制火候。厨房忙乱时,光给厨师再塞一本更厚的菜谱,恐怕不够。
9月10日,中国科学院深圳先进技术研究院公布了一个新办法:材料科研智能体MatBrain,把科学分析和工具执行交给两个专门训练的模型。这项成果发表于《自然·机器智能》。[1]
它想解决的,不只是AI知道多少,而是知道以后能不能把事做下去。
我觉得,这比又一个“参数更大”的故事更值得聊。因为从聊天窗口走到实验室,中间隔着的并不只是一道知识问答题。
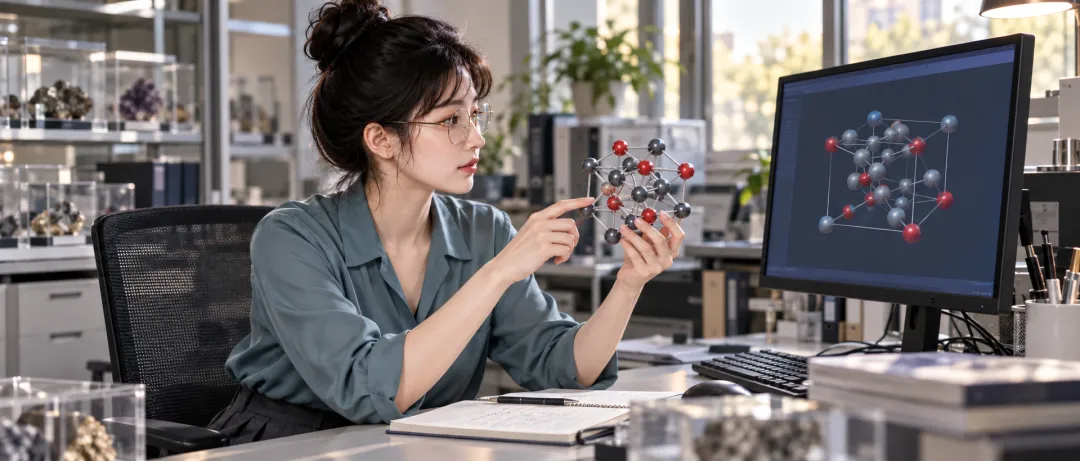
晶体结构的分析,需要把模型判断与具体数据相互核对
● ● ●
会答题,不等于会完成任务
假设我们想找一种更合适的电池材料。这只是理解流程的例子,不是说MatBrain已经替你造出一块新电池。
一个聊天模型可以列出一串材料名称,还能解释每种材料可能的优缺点。但接下来怎么办?结构从哪里来?该调用哪个计算工具?输入格式错了谁来修?算出的性质符合要求,却不够稳定,又该不该留下?
这些问题,靠一段漂亮回答接不上。
研究团队把工作分给两个角色:Mat-R1负责材料知识、科学分析和结果判断,参数规模为300亿;Mat-T1负责组织和执行工具调用,规模为140亿。[2]
名字不用记,分工值得记。
可以把前者理解成审方案的人,后者理解成会调动工具的执行者。但这只是类比,它们没有人的责任意识,也不会因为互相讨论就自动保证正确。
“轻量化”同样是相对说法。几百亿参数仍需要相应的计算资源,不是手机随便装个软件就能原样运行。
● ● ●
分开以后,关键是能接回来
两个模型分别工作,会不会变成两个互相甩锅的同事?
如果只是让它们各写一份报告,确实未必有用。MatBrain更重要的设计,是把执行结果交回分析环节,再根据判断决定是否继续调用工具。
项目公开代码里的流程很直观:执行模块先工作,分析模块读取执行历史;信息不够时发出下一步要求,够了则整理答案。系统还设有迭代次数上限,不是让两个模型无限聊下去。[3]
这里的工具调用,也不是AI说一句“我查过了”就算完成。它需要把请求交给数据库或计算程序,拿到实际返回,再处理这些结果。
这让我更关心一个问题:报告里的结论,是模型凭语言接出来的,还是有可追查的数据和计算支撑?
工具也会出问题。数据库可能缺数据,计算方法可能用错场合,输入还可能填错。多一个分析角色,是多了一次检查的机会,不是多了一张保票。
分工的价值,在于让任务有机会被检查和修正。
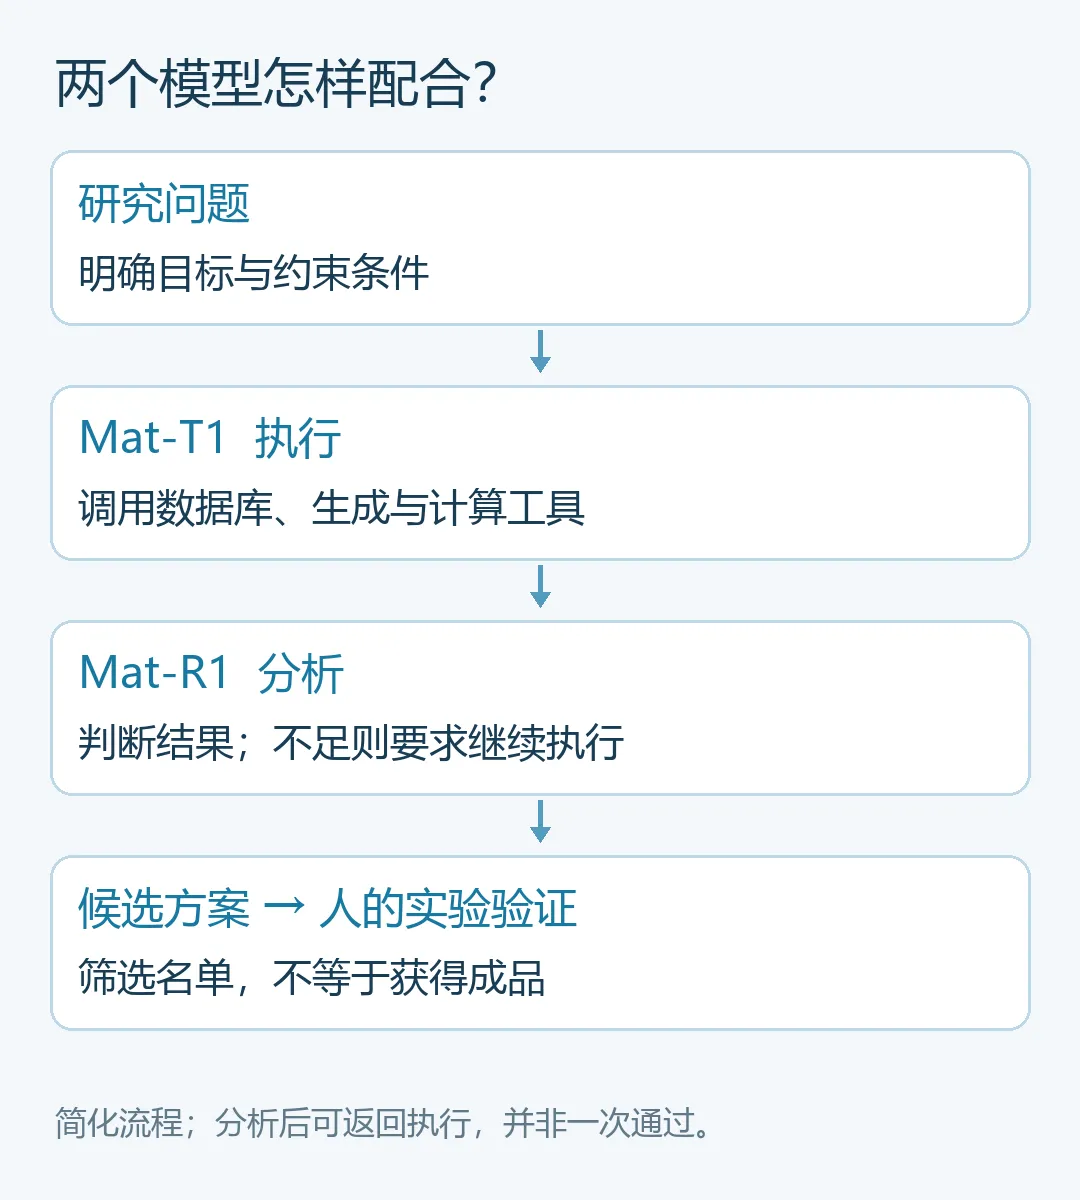
执行结果交回分析,必要时补充计算,再进入实验验证
● ● ●
从3万个缩到38个,比一句“发现新材料”更具体
材料发现为什么难?一种元素组合,可以有不同的原子排列;纸面上看着合理的结构,也可能不稳定、难合成,或根本不具备想要的性能。
把每个想法都送进实验室,代价太大。
在团队报告的催化剂案例中,MatBrain生成了3万个候选结构,经过多阶段筛选,在48小时内得到38个有希望的候选材料。[1][2]
看到这里,很容易顺手写成:“AI两天发明38种新材料。”
我不愿这样写。
公开预印本交代得更具体:研究人员从候选中选出CoV₄S₈开展实验验证,随后进行合成、结构表征和性能测试。选择与验证没有从故事里消失。[2]
候选名单不是产品目录,计算预测也不是实验结果。
我看重的是另一件事:如果一个系统能帮研究人员排除不值得追的路线,把实验机会留给更有希望的方向,就已经可能节省时间。
这和在网上找到一万个菜谱,却仍不知道今晚做什么,很不一样。有价值的不只是“想得多”,还有筛掉哪些、为什么筛掉,以及留下的方案怎么验证。
这种帮助与普通人的距离,藏在材料里。电池、催化剂、电子器件的性能,都离不开材料研发。但从某次科研任务做得好,到工艺稳定、成本合适,再到产品上市,还有一段路。不能把实验室里的候选名单,直接写成明年的购物清单。
● ● ●
“准确率提升66%”,先看它比的是什么
机构介绍中有两组很醒目的数字:在所评估的材料任务中,预测准确率相较主流模型提升66%,硬件部署成本降低95%以上。[1]
它们值得关注,也需要带着口径读。
66%说的是这项工作的材料任务比较,不是所有问题上的通用智力排名,更不能读成提高了66个百分点。公开预印本展示了多类材料任务的比较;但我没有从可获取材料中独立复算出新闻稿所说的66%汇总值,因此只将它作为团队报告的结果,不拿来做标题。[1][2]
95%的限定词则是“硬件部署”。预印本比较了约60万美元的集群方案与约1.5万美元的工作站方案。这是特定配置的估算,不等于训练、数据整理、科研软件、实验耗材和人工等全部费用,都一起缩到原来的二十分之一。[2]
还有一个容易被跳过的细节:截至本文核查时,项目公开仓库提供了智能体实现、工具服务和部分数据等内容,但明确说明,模型权重和完整内部训练数据不在这次发布之中。[3]
所以,有公开代码,与任何人都能完整复现同一套性能,也不是一回事。
● ● ●
真正值得学的,是别让一个模型包办一切
这项研究证明“大模型没用了”吗?没有。
专门训练的数据、可调用的工具、分工方式与模型能力,都在共同影响结果。不能把成绩全部归到“两个比一个强”,更不能拿它为任何多智能体产品背书。
但它提供了一个很实在的思路:遇到复杂任务,除了问能不能换个更大的模型,还可以问——这件事能否拆成不同工作,每份工作需要什么证据,结果又由谁检查?
对于中国的材料科研,这种探索的意义在于,把AI放进具体的研究过程,而不只停留在知识问答。深圳先进院这次选择的,是让专业分析与科研工具互相配合。[4]
能把候选筛出来,再把不确定性带到实验台上接受检验,比一份自信满满的答案更接近科学。
下一次听见“AI发现了新材料”,不妨多问一句:它给出的是一个名字、一份计算结果,还是一块已经接受过实验检验的材料?
差别就在这里。
参考资料
[1] 深圳先进院:MatBrain研究与发布介绍,2026-09-10。
[2] 研究团队公开预印本:双轻量模型协作开展晶体材料研究。与期刊最终版本应分别对待;本文未独立复现实验与基准测试。
[3] MatBrain项目公开仓库及发布范围,核查日期2026-09-17。
[4] 中科院英文研究介绍,2026-09-14。