ARTICLE · 1029754
告别插件死锁!Claude Code 自动化评测落地
告别插件死锁!Claude Code 自动化评测落地
Claude Code v2.1.269 正式上线 plugin eval 原生评测套件与 Bash 文件差异追踪,引入双臂消融对比与确定性打分器,推动智能体插件迈入量化单元测试与工程化验收时代。
▲ 封面:Claude Code 原生自动化评测体系与 Agent 插件测试套件
🧪 【新版实验室 · 专栏引言】
追踪主流语言、开发框架与 AI 大模型重磅发版。剥离通稿滤镜,呈现一手权威信息、精炼核心变动要点,深入底层机制与潜在暗礁展开硬核实测与深度解读。
⚡ 30秒省流看板 / 核心决策卡片
v2.1.269 | ||
claude plugin eval 与双臂消融(Ablation Baseline),量化净收益;新增 bashEditDiffEnabled 实时文件审计 | ||
--max-cost-usd 成本硬顶 |
01. 官方发布速递
📋 发版档案:
- 发布时间
: 2026-09-11(核验日期:2026-09-17) - 发布主体/官方维护团队
: Anthropic / Claude Code 核心工程团队 - 正式版本号
: v2.1.269 - 官方一手信源
:Anthropic 官方技术文档:Plugin Evaluation Suite | GitHub Release Tag v2.1.269 - 一句话定位
:业内首个主流 CLI Agent 官方内置的插件级单元测试、基线消融评测与 Shell 变更透明审计套件。
北京时间 2026 年 9 月 11 日,Anthropic 官方团队正式发布了 Claude Code 的全新版本 v2.1.269,带来了原生插件评测体系 claude plugin eval 以及针对系统命令执行的 bashEditDiffEnabled 实时差异追踪,官方一手 Release 与文档现已上线。
随着自主智能体(Agent)从单纯的单轮问答演变为具备数十种插件、技能(Skills)与 MCP 工具的多步编排中枢,开发者社区普遍遭遇“智能体工程化危机”:开发者手搓的插件与自定义指令随着模型微调或上下文增长,极易引发非预期行为;过多插件导致 Prompt 上下文严重膨胀,有效工具调用(Tool Call)信噪比断崖式暴跌,甚至陷入无限重试死锁、错误修改生产代码。
v2.1.269 的发布,标志着 Agent 工具开发正式告别“靠肉眼抽查提示词”的玄学阶段,全面迈入标准化测试驱动开发(TDD)与工业化回归测试时代。
02. 本版更新要点
要点一:claude plugin eval 原生评测脚手架与隔离测试套件
变动概述:提供一键初始化与自动化评测命令,可在完全无状态、隔离的子进程中批量运行用例,杜绝上下文污染。
直观对比:从过往手动单轮验证,升级为标准的测试驱动目录体系:
# 初始化生成测试用例与打分器骨架 claude plugin eval init # 执行完整自动化测试与基准比对 claude plugin eval . --threshold 0.85evals/ ├── eval_config.json # 评测全局运行配置 ├── case-01-basic-query/ # 独立测试用例目录 │ ├── prompt.md # 注入 Agent 的测试输入与上下文约束 │ └── graders/ # 打分器断言集合 └── results/ # 自动化测试产物与可视化 HTML 报告要点二:双臂消融基准(Ablation Baseline)量化插件净贡献
变动概述:测试用例并非孤立打分,而是默认强制双臂并行比对:同时在“挂载插件(WITH)”与“纯净原生(W/OUT)”双环境下运行同一任务,计算得分增量、Token 开销增量与耗时增量。
机制对比:
- 过去
:单次执行打分 0.85 分,误以为插件表现优异,实则全是基础模型自带常识,插件净贡献为 0 甚至徒增上下文负担; - 现在
:计算 Δscore = Score_WITH - Score_W/OUT,客观甄别插件究竟是真正提效,还是造成“插件越加 Agent 越蠢”的负资产。
要点三:bashEditDiffEnabled 实时文件变更审计
变动概述:彻底终结 Bash 工具修改文件时的“黑盒”问题。当 Agent 调用 sed、awk 或自定义编译脚本修改磁盘文件时,终端工具块实时捕获并输出着色 Unified Diff。
轻量配置:
// settings.json { "bashEditDiffEnabled": true }# 亦可通过最高优先级环境变量全局强制开启export CLAUDE_CODE_BASH_EDIT_DIFF=103. 深度技术分析
3.1 底层机制解密
1. 打分器引擎(Graders Engine)双轨架构
评测引擎的核心在于对 Agent 轨迹进行客观裁决。Anthropic 将打分器严谨解耦为两类六种标准形态:
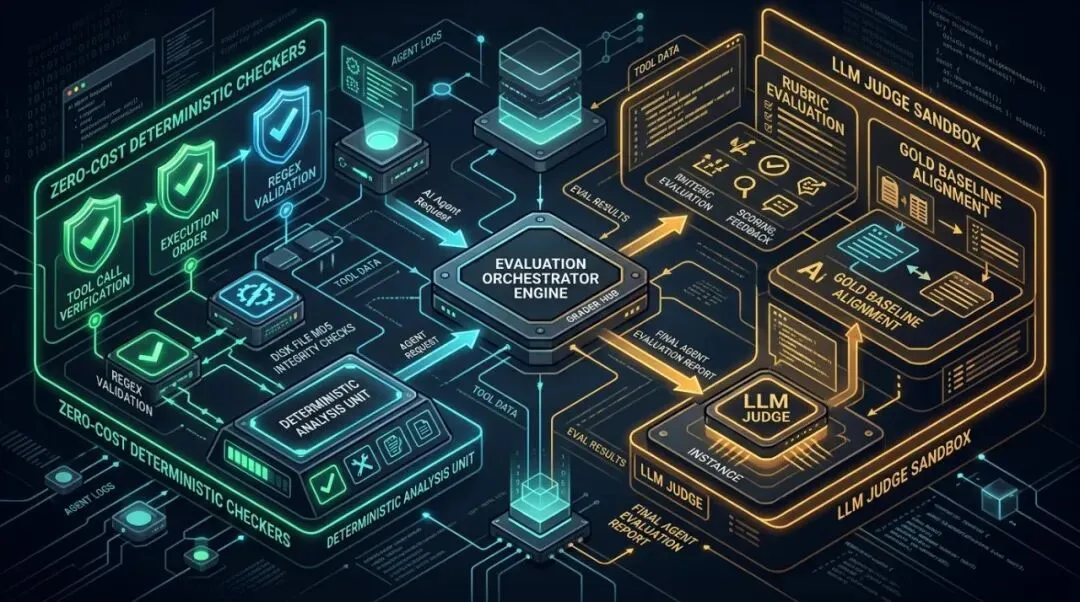
▲ 图 1:Claude Code 双轨打分器引擎(确定性打分器 vs LLM 裁判)架构图解
- 确定性打分器(0 Token 成本 / 毫秒级断言)
: tool_used:断言目标工具是否被真实触发 tool_order:断言工具调用的前后执行时序 regex:正则校验最终输出与结构键值 file_exists:物理检验磁盘生成文件与 MD5
- LLM 裁判打分器(API 计费 / 复杂语义裁判)
: llm:独立 Judge 模型依据自然语言 Rubric 裁决 baseline:黄金参考答案(Gold Reference)语义对齐
确定性打分器(Deterministic Graders)直接读取 Agent 的 Tool Call Transcript 轨迹与本地文件系统,不发起任何模型 API 调用;而 LLM 裁判打分器(Model-Based Graders)则由独立沙箱的 Judge 模型根据评测准则给出的 0.0 ~ 1.0 得分与评语。
2. 双臂消融对比算法
系统在单次评测中执行严格的隔离对照实验:单一测试用例在挂载插件(WITH)与原生基线(W/OUT)双轨执行下,计算得分增量、Token 增量与耗时增量。
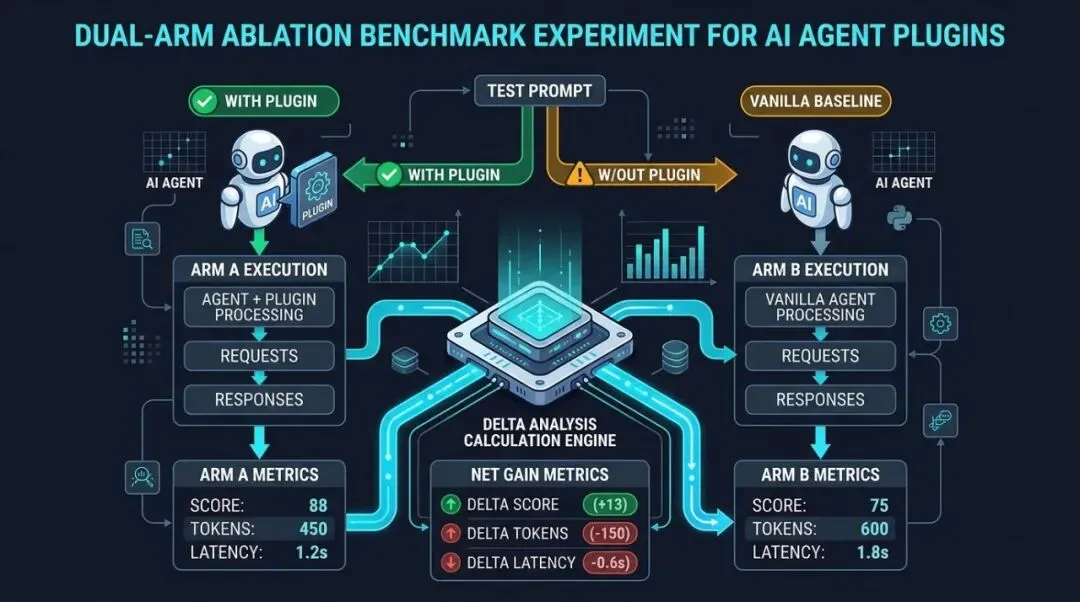
▲ 图 2:Claude Code 双臂消融基线对照实验与净增益量化算法图解
通过这一公式,开发者可一目了然识别插件的真实生产价值:
- 有效正向资产
: Δscore > 0且 Token 增量可控; - 无效冗余插件
: Δscore ≤ 0但Δtokens > 0(说明插件声明污染了上下文窗口,稀释了模型的泛化注意力)。
3. 官方评测终端实测客观还原
运行 claude plugin eval . 后的终端对照表输出客观展现了不同用例的表现分化:
CASE WITH W/OUT DELTA (Δ) TOKENS (Δ) COST (USD) STATUS ──────────────────────────────────────────────────────────────────────────────────── 01-auto-commit-msg 1.00 0.40 +0.60 +380 t $0.014 PASS 02-rebase-conflict 0.80 0.80 0.00 +1,250 t $0.038 WARN (No-Op) 03-syntax-recovery 0.60 0.90 -0.30 +2,100 t $0.065 FAIL (Degrade) ──────────────────────────────────────────────────────────────────────────────────── OVERALL SCORE: 0.80 0.70 +0.10 TOTAL COST: $0.117从还原的测试结果可见:用例 02 表现为“零增益(No-Op)”,模型自带常识即可完成任务;用例 03 表现为“负增益(Degrade)”,插件引入的 Prompt 偏见反而使成功率从 0.90 劣化至 0.60,这类用例在 CI 门禁中会被直接阻断。
3.2 破坏性变更与兼容性事实
- CLI 命令与版本兼容性
: claude plugin eval与bashEditDiffEnabled仅在 v2.1.269 及以上版本受支持。旧版运行将直接报错unknown command: eval。 - 环境变量隔离断层
:评测子进程处于完全无交互隔离环境,开发者当前终端未持久化的临时内存环境变量不会穿透至评测沙箱,测试前需在 eval_config.json或prompt.md的 Frontmatter 中明确配置。 - CI/CD 自动化门禁集成
:支持通过轻量命令行参数直接接入 GitHub Actions 或 GitLab CI 流水线: claude plugin eval . --threshold 0.85 --max-cost-usd 2.00 --json evals/results/summary.json--threshold 0.85,CLI 将直接返回非零退出码,阻断不可靠插件合并;--max-cost-usd设定 API 计费安全阀,避免评测死循环导致账单失控。
3.3 技术边界与适用条件分析
- 评测成本放大效应(Financial Overhead)
:双臂消融机制意味着每个用例天然需要 2 次独立模型推理;若再大量配置 llm裁判打分器,单次全量评测消耗的 Token 可达到日常单次调用的 3~4 倍。选型建议:日常高频本地回归统一采用 0 成本的确定性打分器(tool_used、regex、file_exists);主干发布或 PR 合并门禁时再开启大模型智能裁判。 - macOS 沙箱文件写入权限边界
:自 v2.1.251 强化沙箱隔离后,测试用例若试图在外部全局敏感目录执行 Mock 状态写入,可能触发系统 Operation not permitted拦截。测试 Fixture 必须严格限制在插件自身目录或/tmp/claude-eval/安全沙箱中。 - 多模态与高交互式场景局限
:当前评测体系聚焦于系统命令、代码文件修改与文本结构化数据流;针对需要复杂浏览器动态渲染(如 Puppeteer 页面行为)或人工交互确认的插件,自动化 Grader 规则编写成本极高,仍需辅以人工沙箱抽检。
💬 互动讨论 / 评论区交流
在自主智能体(Agent)和 Skill 生态快速膨胀的今天,你是否也曾遭遇过“加了新插件反而改废老代码”或“Token 莫名翻倍”的窘境?
面对确定性打分器与大模型裁判,你在日常测试中更倾向哪种验证方式?你认为双臂消融(Ablation Baseline)能否成为未来 Agent 工具发布的强制标准?欢迎在评论区留下你的实战观点!
参考资料
Anthropic: 《Claude Code: Plugin Evaluation Suite Documentation》(2026-09-11) Anthropic: 《Claude Code Settings Reference: bashEditDiffEnabled Configuration》(2026-09-11) Anthropic / Claude Code Team: 《Claude Code v2.1.269 Release Changelog and Release Tag》(2026-09-11)