ARTICLE · 1030125
会自己长本事的 AI 智能体,离工程行业还有多远?
会自己长本事的 AI 智能体,离工程行业还有多远?
一个尴尬的事实:大多数企业部署的 Agent,在上线一年后和第一天一模一样。权重冻结、系统提示冻结、工具清单冻结。唯一在积累的是日志,而日志通常在看板上过一次,就消失了。
人类工程师不是这样工作的。老师傅做完一个项目,会把踩过的坑记下来;下一次遇到类似情况,直接绕开。这就是"经验",也是当前 AI 智能体最缺的东西。
2026 年,一批研究正在把"越用越聪明"从口号变成可训练、可验证的系统。
一、五条代表性路线 图 1 最务实的路线:把交互轨迹沉淀为可复用的技能,循环回灌
工作 | 核心机制 | 关键结果 |
EvoDS | 自主技能获取(合成 → 验证 → 缓存 → 扩展,频率阈值3次才永久入库);自适应上下文压缩,把上下文管理当成可学习的控制问题 | 相对同量级基线提升28.9% ,且参数更少;超25K token的失败降为0 ;跨任务技能复用率69% |
EvoCUA-1.5 | 从离线经验学习扩展到在线强化学习:步级策略优化、动态三自适应课程、带陈旧度控制的异步训练基础设施 | OSWorld-Verified成功率63.2% ,超越同量级32B/35B开源权重基线 |
ARISE-RL | 任务与评分规则生成器、推理求解器通过评分规则协同进化;只在记忆带来实测收益时才蒸馏回自身 | 在全部评测基准上稳定达到最优 |
Skill-Evo4GUI | 把交互轨迹与评估反馈转成持久化、带版本的技能库;每轮在冻结快照上执行, 不改模型参数 | 四个应用域均值提升5.7到18.6个百分点 |
新一代Agentic RL系统(蚂蚁、港科大、清华) | 不提新算法,只提一个判断:瓶颈不在模型也不在算法,而在 " 管道 " | 提出三大支柱:步级轨迹数据协议、企业级数据代理、统一进化控制面 |
二、三条值得记住的结论
第一,不改模型参数,也能变强。 Skill-Evo4GUI 的路线最值得工程行业关注:它把交互轨迹和评估反馈沉淀成一个持久化、可版本管理的技能库,模型权重一动不动,四个应用域平均提升 5.7 到 18.6 个百分点。这意味着——没有算力、没有标注团队,也能让 Agent 进步。
第二,技能入库要设门槛。 EvoDS 的做法非常工程化:技能要经过"合成、验证、缓存、扩展"四阶段,而且只有出现频次达到阈值(3 次)才被永久纳入动作空间。为什么要设门槛?因为一次性噪声会污染整个动作空间。 这个规则几乎可以直接抄走。
第三,三种升级杠杆的成本差两个数量级。当 Agent 表现不佳时,你手里的选择是:改提示词、加技能、刷新记忆,或者重训模型。前三者便宜,最后一个贵得多。而"该拉哪根杠杆"这件事,今天几乎完全靠人的直觉判断。蚂蚁、港科大与清华那篇论文把这个问题正式提了出来——他们主张需要一个统一的"进化控制面",根据轨迹统计自动决定更新哪个层次。
那篇论文还提出了一个很清醒的判断:当前企业级自进化智能体最大的瓶颈,不是缺少更强的模型,也不是缺少更好的强化学习算法,而是缺少一套能把已部署经验转化为可治理、可归因、可回放学习材料的系统底座。 执行记录每天都在产生,却没有合适的格式承载;等不来更好的模型,等来的应该是一条还没建起来的数据管道。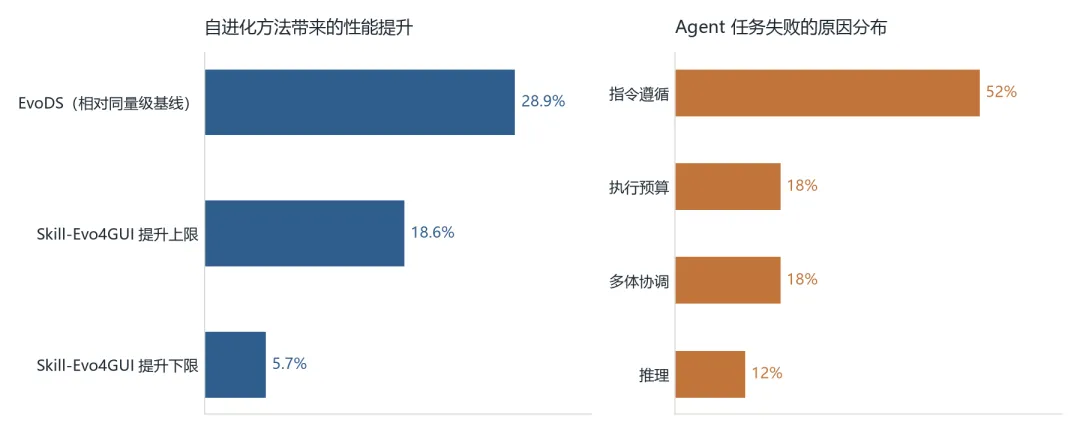 图 2 自进化方法的性能提升与 Agent 失败原因分布
三、国外:研究领先,但离工程现场还很远
优点集中在研究端。论文密度高、迭代快;评测基准是公开的(如 OSWorld),可以横向比较;强化学习基础设施由大厂先行投入,异步训练、陈旧度控制这类工程细节已经有成熟方案。
缺点同样明显。
一是预印本占多数,尚未经同行评议,数字需要谨慎对待。二是成本门槛高。以 EvoDS 为例,训练使用 4 张 A800 起步——这不是工程单位能随手复现的资源。三是迁移性存疑。这些工作大多在通用桌面环境评测,与真实工程软件(专业 CAD、结构计算工具)的操作差距很大。四是失败分布暴露了短板:有分析显示,失败案例中指令遵循占 52%,执行预算占 18%,协调占 18%,推理仅占 12%。也就是说,卡住 Agent 的往往不是"不够聪明",而是"没按规矩办事"。这对强调规范性、程序性的工程行业,是一个重要提示。
四、国内:数据优势用不上,但有一条低成本路线
国内的处境很有特点:数据不能出内网,所以走不了重训模型这条路;但业务闭环紧密,反而最适合走技能库这条低成本路线。
优点有三条。
一是工程规范天然就是评分标准。国外论文费很大劲去构造"评分规则"(rubric)来自动评估 Agent 的输出,而工程行业的规范条文、验收标准、强制性条文,本身就是一份现成的、可枚举的检查清单。这是工程行业独有的结构性优势。
二是场景明确、反馈闭环短。图纸对不对、算量准不准、方案能不能过审,结果当场就能判断,学习信号质量高。
三是技能库路线的实施成本低。不需要算力集群,不需要标注团队,只需要纪律。
缺点有三条。
一是缺少公开基准与评测方法,不同方案只能自测,容易自我说服。二是重训路线基本走不通,只能依赖开源权重的本地化部署,能力上限受制于人。三是技能库很容易变成没人清理的垃圾堆——这是最现实的风险。没有入库门槛、没有版本管理、没有淘汰机制,技能库积累到几百条之后,检索质量反而下降。
五、对工程行业意味着什么
第一,先建轨迹,再谈进化。 要把每次任务执行记录按步骤粒度留存。关键不是"结果对不对",而是"十步操作里是哪一步走歪了"。这是学习的信号载体,也是今天绝大多数单位完全缺失的一环。
第二,技能库是性价比最高的一步。拆图规则、命名规则、图层标准、审核要点——这些既有的隐性知识,恰好对应四层记忆里的"程序记忆"。把它们结构化沉淀下来,配上门槛与淘汰机制,就能让 Agent 在不改参数的前提下进步。
第三,规范条文可以直接当评分标准用。 这是国内工程行业的独特机会:不必等国外把评测体系做出来,手里已经有一份现成的检查清单。
第四,警惕"指令遵循"这个失败大头。既然 52% 的失败来自没按规矩办事,那么约束 Agent 行为的工作流设计,比提升模型能力更紧迫。
六、未来展望
轨迹数据协议会走向标准化。目前最大的缺口是没有一个标准容器,能以步骤粒度承载学习信号、跨异构的 Agent 范式通用。这件事一旦解决,自进化的门槛会明显下降。
进化控制面会出现。根据轨迹统计自动决定"改提示词、加技能、刷记忆还是重训模型",把今天靠直觉决定的事变成可计算的事。这可能是未来两年最有价值的一类基础设施。
自进化会从"改模型"转向"改上下文"。行业正在意识到一个更朴素的道理:对绝大多数企业来说,Agent 的进步不来自参数更新,而来自知识与技能的积累。
七、给工程从业者的四条建议
从记录开始。把 Agent 的执行过程按步骤存下来,包含每步的输入、动作和结果。这是所有后续能力的地基。
给技能设门槛。照搬"验证加频次"的规则:只有被验证过、且反复出现的技能才正式入库。一次性经验不进库。
定期清理。 技能库要有淘汰机制。半年不用、从不命中的技能,果断删掉。
先问"该拉哪根杠杆"。表现不好时,别上来就想着换模型。先看是提示词的问题、缺技能的问题,还是记忆脏了的问题——这三种情况的修复成本,比换模型低两个数量级。
工程行业从来不缺经验,缺的是把经验留下来的机制。这一点上,人和 Agent 面临的是同一个问题。