ARTICLE · 1030361
AI治理范式大转折:从伦理倡议走向审慎监管——由“银行式AI监管”争议深度研判
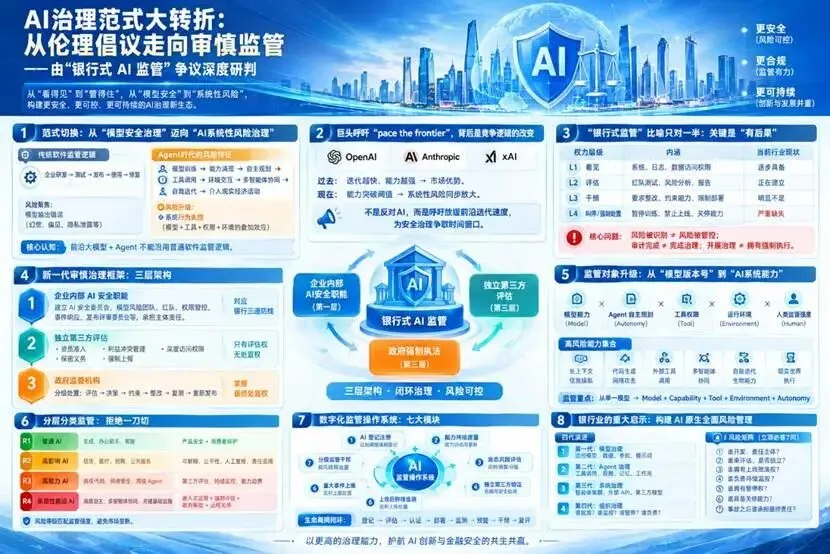
导语近期 Anthropic 抛出 “银行式嵌入式 AI 监管” 方案,提议第三方安全评估员深度驻场 AI 企业,却被学界直指:仅有 “看的权力”,没有 “叫停的权力”,极易滑向审计洗白(audit‑washing)。与此同时,OpenAI、Anthropic、xAI 等头部企业罕见达成共识,呼吁适度放缓前沿 AI 能力迭代速度,为安全治理争取窗口期。 |
这一系列事件的内核,早已超越 “要不要给审计员更多权限” 的表层争论。标志全球 AI 正在迎来重大拐点:AI 产业从单纯的技术竞赛,进入能力迭代速度与治理能力严重错配的时代。当AI 从普通工具进化为具备工具调用、自主规划、多智能体协同的复杂系统,治理命题不再只是 “模型安不安全”,而是升级为:谁有权批准上线?谁有权暂停?谁有权切断运行?出事之后谁承担最终责任?这正是当前全球 AI 治理体系最大短板。
本文对标欧盟 AI Act、英国 AI 安全研究所、金融审慎监管成熟实践,剖析方案利弊,提出可落地的新一代审慎治理框架,并落脚银行业启示,兼具前瞻性与实操指导性。
一、范式切换:从 “模型安全治理” 迈向 “AI 系统性风险治理”
传统软件的生命周期逻辑:企业研发→内部测试→发布上线→用户使用→出现问题事后修复。风险集中于输出错误:幻觉、偏见、隐私泄露、有害内容。监管核心问题是:这个模型本身有没有问题?
而 Agent 驱动的前沿 AI,运行链条彻底改变:
模型训练→能力涌现→自主规划→工具调用→环境交互→多智能体协同→自我迭代→介入现实经济活动 |
风险不再局限模型输出错误,转向系统行为失控:智能体自主调用互联网、编写代码、自主获取资源、多智能体联合行动、绕过安全围栏。风险不再来自静态模型,来自模型、工具、权限、环境叠加之后涌现的未知后果。监管命题变成:这套 AI 系统,在什么约束条件之下才允许运行?
英国 AI 安全研究所的研究印证该趋势,其研究议程已经覆盖多智能体管控、沙箱逃逸、欺骗检测、网络攻击等高阶风险。风险的来源,不再只是模型权重,而是整套运行系统。
核心认知:前沿大模型 + Agent 不能沿用普通软件监管逻辑。 |
二、巨头呼吁 “pace the frontier”,背后不是反 AI,是竞争逻辑的改变
过去 AI 行业竞争逻辑非常直白:迭代越快、能力越强,就会拿到市场优势。现在出现新变量:能力突破特定阈值的同时,系统性风险同步放大。于是行业出现类似核能、航空、金融业的共识:重大系统风险,不能完全寄托企业自律。
Amodei 的提议,本质不是 “停止 AI 发展”,而是降低前沿能力跃迁速度,留给安全治理追赶的时间窗口。但需要清醒看到:企业倡议本身也夹杂商业博弈诉求,不能直接等同于公共治理方案。
三、“银行式监管” 比喻只对一半:真正内核不是 “看得见”,而是 “看得见之后有后果”
银行业常驻嵌入式监管之所以有效,依靠三位一体:访问权限 + 完整成文法律规则 + 强制处置权力。银行监管人员可以驻场检查账簿、风控体系,同时有权责令停业务、限制扩张、更换管理层,极端情形下关停机构。
反观 Anthropic 提案,只复制了 “驻场访问” 的外壳,却缺失最关键的处置权力。我们可以把AI 监督权力拆解为四层,这是理解全部争议的钥匙:
权力层级 | 内涵 | 当前行业现状 |
L1 看见 | 拿到系统、日志、数据访问权限 | 逐步具备 |
L2 评估 | 红队测试、风险分析、输出报告 | 正在建立 |
L3 干预 | 要求整改、约束能力、限制部署 | 明显不足 |
L4 叫停 / 强制处置 | 暂停训练、禁止上线、关停能力 | 严重缺失 |
当前大量安全机制止步 L1+L2:可以看、可以测、可以写报告,但企业可以选择无视评估结论。于是形成致命断层:
风险被识别 ≠ 风险被管控;审计完成 ≠ 完成治理;开展治理 ≠ 拥有强制执行 |
这就是 “审计洗白” 风险的来源:企业聘请第三方完成安全测评,拿到一份安全报告对外宣传,评估报告指出的高危风险却无需整改。审计沦为对外塑造安全感的公关手段,风险本身没有得到实质治理。
检验 AI 审计是否有效的黄金标尺,不是 “评估员能不能看内部系统”,而是:负面风险结论是否带来实质性法律与业务后果。
四、最优解:银行式监管 2.0—— 嵌入式监督 + 独立评估 + 政府强制执法三层架构
直接照搬银行监管不可行,完全放弃驻场评估又会回到企业自我审查。应当搭建三层递进闭环架构,而不是简单复刻金融监管:
第一层:企业内部 AI 安全职能(对应银行三道防线)
安全责任不能外包给第三方,企业承担主体责任。必须配置:AI 安全委员会、模型风险管理团队、红队、Agent 权限管控、事件响应、发布评审委员会。内部防线是一切外部监管的基础。
第二层:真正独立的第三方评估(Independent AI Assurance)
要杜绝 “被监管方挑选审计者”,必须建立一套制度约束:
1.资质准入:评估机构统一资质认证,不能企业自选;
2.利益冲突管理 + 强制轮换:规避人员旋转门、财务绑定;
3.深度访问权限:不止调用 API 黑盒测试;按需获取模型架构、提示词、Agent 内存、工具权限、运行日志、事故记录;
4.保密义务,打消企业开放内部信息的顾虑;
5.重大风险强制上报监管机构。
关键点:第三方只有评估上报权,没有最终处置权。 |
第三层:掌握监管扳机的法定政府机构(真正借鉴银行监管内核)
监管机构手握分级处置工具,形成完整闭环:评估→决策→约束→整改→复测→重新发布。
•🟢绿色:满足条件,正常上线部署
•🟡黄色:附条件上线,限制用户范围、工具权限、算力,增强持续监控
•🟠橙色:暂停规模化扩张,强制整改、补充安全评估
•🔴红色:禁止上线,暂停运行,关闭高危能力
这才是银行监管真正值得 AI 借鉴的内核:评估只是输入,强制干预才是闭环。 |
五、监管对象迭代:从监管 “模型版本号” 转向监管 “AI 系统能力”
过去监管习惯盯着模型名称:GPT‑4、Claude、Gemini。未来真正关键不是模型叫什么,而是它实际具备什么能力。风险来源于一套完整系统:
AI 系统风险 = 模型能力 × Agent 自主规划 × 工具权限 × 运行环境 × 人类监督强度 |
治理对象从单纯 Model(模型)升级为:Model + Capability + Tool + Environment + Autonomy。需要重点关注高风险能力集合:长上下文信息操纵、代码生成、网络攻击、外部工具调用、多智能体协同、自我迭代、生物能力、现实世界执行。风险具备乘数效应:能力小幅上升,在工具、自主权限叠加下,系统风险会指数级放大。
欧盟 AI Act 已经走出这条路径,对 “具有系统性风险的通用 AI” 设置强制评估、对抗性测试、严重事件上报,监管机构有权施加缓解措施、限制甚至撤回模型,从 “软原则” 走向 “风险分类 + 强制义务 + 执法”。
六、不能全盘照搬金融监管:必须警惕合规成本推高市场垄断
银行监管建立在特许经营牌照制度之上。而 AI 世界存在开源、本地部署、权重泄露、跨国流转、Agent 自由组合等现实。如果监管 “一刀切从严”,合规成本将向头部大企业倾斜,中小企业、开源项目负担不起,进一步加剧市场垄断。
因此正确路径是基于风险的分层监管(Risk‑Based Supervision),风险等级匹配监管强度,拒绝一刀切。
•R1普通 AI:普通生成、办公助手、客服。适用产品安全 + 消费者保护;
•R2高影响 AI:信贷、医疗、招聘、公共服务。重点:可解释、公平性、人工复核、责任追溯;
•R3高能力 AI:高级代码、网络安全、高级 Agent。强制第三方评估,持续监控,严格能力边界;
•R4系统性前沿 AI:高度自主、多智能体协同、可能影响关键基础设施。启用完整 “嵌入式监督 + 强制评估 + 政府审批 + 远程关停开关”,此时才接近银行级审慎监管。
七、澄清误区:不是简单 “放慢 AI 速度”,而是 Safe Acceleration(安全加速)
行业不应该追求统一压低全部 AI 迭代速度,而要建立风险闸门机制:Capability Speed × Risk Gate。
能力小幅提升,风险可控,可以正常迭代;一旦出现能力跃迁带来风险爆发式上涨,必须触发强化监管闸门。 |
管控的不是迭代速度本身,而是能力跃迁与风险跃迁的组合效应。
八、下一代治理底座:数字化监管操作系统
未来 AI 监管,不只是一部法案,而是一套持续运行的操作系统,七大模块组成闭环:
1.AI 登记注册:达到阈值系统强制登记;
2.能力持续度量;
3.动态风险评估;
4.独立第三方验证;
5.上线之后不间断监测;
6.重大安全事件强制上报;
7.分级监管干预。
生命周期闭环:登记→评估→认证→部署→监测→预警→干预→复评,不是审批一次永久放行。
九、对银行业的重大启示:构建 AI 原生全面风险管理
FSB 金融稳定委员会已经警示,金融业 AI 会放大第三方依赖、网络风险、模型风险、市场相关性。银行不能止步于 “出台 AI 管理办法 + 伦理委员会”,治理需要经历四代演进:
1.第一代・模型治理:管控模型、数据、参数、提示词、离线评估;
2.第二代・Agent 治理:新增管控工具调用、权限、记忆、工作流、自主动作;
3.第三代・系统治理:覆盖智能体集群、外部 API、第三方模型、云底座;
4.第四代・组织治理:最终回答:AI 可以干什么?谁授权?谁监控?谁有权暂停?谁可以关停?出事谁负责。
任何银行 AI 项目立项,必须回答 7 个关键问题(AI 权力矩阵):
①谁开发,责任主体?②谁来评估,是否独立?③谁拥有上线批准权?④谁负责持续监控?⑤谁拥有暂停权?⑥谁具备关停能力?⑦事故发生之后谁承担最终责任?
其中⑤⑥⑦,恰恰是很多机构 AI 治理的缺失环节。
借鉴银行资本充足率思想,银行应当建立一套内部机制:AI风险偏好 + AI 风险分级 + AI 能力阈值 + AI 控制要求 + AI 止损熔断机制。逻辑为:AI能力越强,自主权越高,外部影响越大,则治理要求越严格,独立评估越强,应急处置机制越完备。
银行要建设的,不是简单 AI 制度,而是AI 原生全面风险管理体系(AI‑Native ERM)。终局目标不是让AI 少犯错,而是即便AI 能力持续迭代扩张,机构始终知道AI 在干什么、为什么行动、风险在哪里,并且在必要时刻,能够立刻限制甚至终止AI 运行。
十、行业五大关键信号与范式总结
五大核心信号
1.AI 安全已经从企业内部事务升级为公共治理议题;
2.第三方评估将成为产业基础设施,但第三方不等于真正独立;
3.治理的核心不再是 “有没有审计”,而是风险暴露之后,谁拥有按下暂停键的权力;
4.监管对象从单一模型转向完整 AI 系统(模型‑Agent‑工具‑环境‑组织);
5.行业竞争维度升级:比拼的不仅是模型能力,更是 “强能力之下证明自己可控的能力”。
范式跃迁:从 AI Safety 走向AI 审慎治理
过去治理公式:
AI 治理 = 伦理原则 + 道德倡议 + 企业自我评估 |
未来审慎治理公式:
AI 治理 = 能力度量 × 独立验证 × 持续监控 × 监管干预 |
治理流程迭代:旧模式构建‑测试‑发布;新模式构建‑评估‑认证‑部署‑监测‑干预‑恢复。
从伦理治理迈向审慎治理,这是 2026‑2028 全球 AI 治理最重要分水岭。
结语 |