ARTICLE · 1052368
每个孩子都需要真正的AI教育:家长和老师不能再回避的一堂课——读懂UNESCO学生能力框架
AI × YOUTH OBSERVATORY · ARTICLE 03
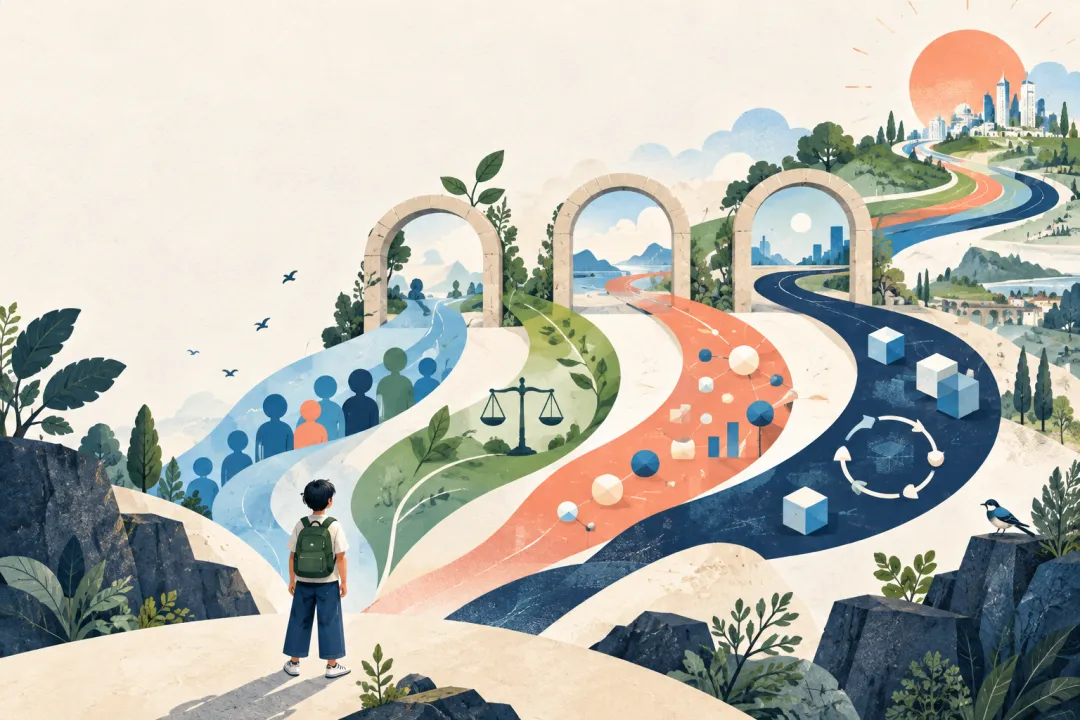
面对 AI,孩子需要的不是唯一一条技术跑道,而是一张关于人、伦理、技术与设计的能力地图。
2024 年,联合国教科文组织(UNESCO)发布了《学生人工智能能力框架》。这份文件讨论的,并不是怎样写出更厉害的提示词,也不是怎样让孩子更快地用 AI 完成作业。它提出了一个更根本的问题:
换句话说,AI 教育的目标,不能只是培养熟练的工具使用者。它还需要培养能够理解 AI、负责任地应用 AI,并参与塑造 AI 的未来公民。
一张“4×3”的 AI 能力地图
UNESCO 把学生的 AI 能力分为四个相互关联的面向:
以人为本的思维:人是否仍然拥有决定目标、作出判断和承担后果的主体性; AI 伦理:如何处理公平、隐私、安全、包容和环境影响; AI 技术与应用:是否理解数据、算法和模型的基本原理,并能恰当地使用工具; AI 系统设计:能否从界定问题出发,参与设计、测试和改进 AI 系统。
这四个面向,又分别贯穿三个递进的层级:理解、应用、创造。
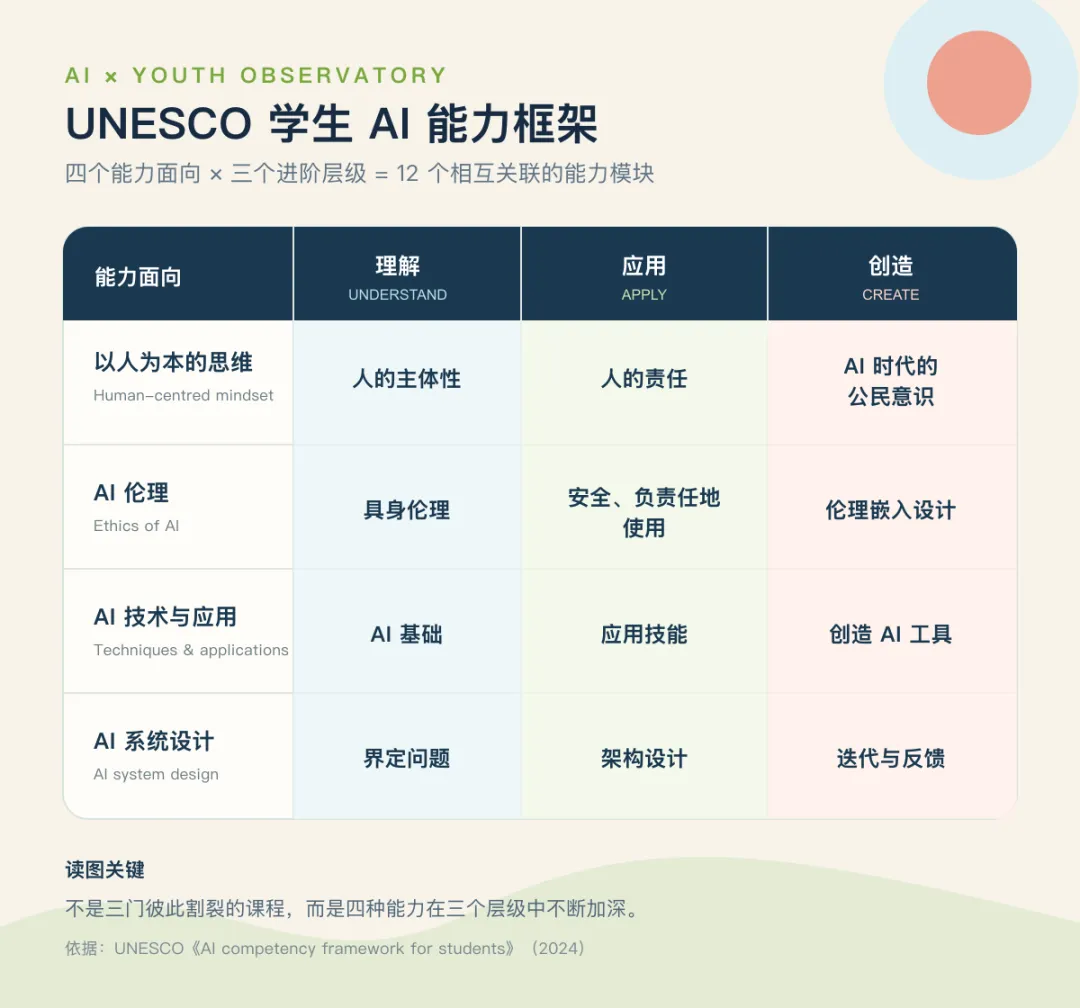
四个能力面向穿过三个进阶层级,共同组成 12 个相互关联的能力模块。依据:UNESCO《AI competency framework for students》(2024)。
如果沿着“理解—应用—创造”这条主线往下看,就会发现它并不是一套悬在空中的理论,而是在回答三个非常具体的问题:
孩子能不能看懂 AI 背后发生了什么? 能不能在真实任务中作出负责任的选择? 能不能进一步参与设计一个更值得信任的 AI 系统?
第一层:理解——先打破 AI 的“魔法感”
孩子第一次看到 AI 在几秒钟内写出文章、生成图片,或者模仿某个人说话时,很容易觉得它像一种魔法。
而“理解”层首先要做的,就是把这种魔法感拆开。
UNESCO 在建议的教学方法中,提到了一种看起来很朴素的方式:暂时离开屏幕,通过纸笔、讨论和角色扮演,理解 AI 系统的运作过程。
不碰电脑,也可以学 AI
想象一堂课:学生不打开任何 AI 工具,而是在一张大纸上画出一个 AI 系统从开始到结束的过程:
人类决定收集哪些数据; 数据如何被筛选和整理; 算法根据什么目标进行学习; 模型如何产生结果; 最终又是谁使用这个结果作出决定。
画完以后,老师不急着解释技术名词,而是继续追问:
在这条链条上,哪些决定是人作出的? 哪些环节可能出现错误或偏差? 如果人把判断完全交给系统,谁来承担最后的后果?
纸笔活动的意义,就在于暂时剥掉 AI 酷炫的外壳,让孩子看见:AI 不是凭空出现的智慧。它的背后始终有人在选择数据、设定目标、设计规则和决定使用方式。
一场关于“AI 监考官”的庭审
理解 AI 也不只是理解算法,还包括看见技术背后的价值判断。
比如,学校安装了一套摄像头系统,通过识别学生的面部表情,判断他们上课是否“专心”。
这时候,可以让学生进行一次“AI 庭审”。
一部分学生扮演系统开发者,一部分扮演学校、家长和被监测的学生,其他人则组成陪审团。大家需要追问:
凭什么认定某种表情就代表“不专心”? 不同文化背景、性格和身体状况的学生,表达专注的方式一样吗? 系统收集了哪些面部数据?这些数据会被保存多久? 如果系统判断错了,谁来解释,谁来负责? 学校真的需要用 AI 解决这个问题吗?
这样的讨论会让孩子明白:AI 输出并非天然客观。训练数据如何收集、系统优化什么目标、工具被放进什么情境,都可能影响最后的判断。
AI 的偏差也不一定来自某个“坏人”。它可能来自不完整的数据、未经检验的假设,或者一个看似合理、实际上过于简单的目标。
第二层:应用——会用,还要会选择、验证和负责
当孩子知道 AI 大致如何工作之后,下一步才是把它放进真实任务中使用。
但在 UNESCO 的框架里,“会用”不是按下按钮、得到结果就算完成。应用层更看重的是:孩子能不能判断这个工具是否适合当前的问题,能不能检查它的结果,以及是否愿意为使用它产生的影响负责。
历史课上的“苏轼聊天机器人”
例如,在一堂历史课上,学生尝试配置一个能够模仿苏轼回答问题的聊天机器人。
这项活动最重要的,并不是让机器人写出多么漂亮的诗,而是让学生处理一系列真实问题:
它应该参考哪些资料? 如果只给它一种历史记载,它会不会把某一种观点当成唯一真相? 它生成的内容哪些来自史料,哪些只是模型根据语言模式作出的推测? 如果机器人非常自信地编造了一段苏轼从未说过的话,学生能不能发现?
孩子需要比较不同来源、检查回答中的事实,并清楚标出哪些内容是史料支持的,哪些只是 AI 生成的演绎。
到了这一步,AI 不再是一台交作业的机器,而变成了一个需要被审查、被验证的研究工具。
“杀鸡焉用牛刀”:算 1+1,需要调用大模型吗?
应用层有一个重要但经常被忽略的概念:比例原则。它问的是:使用某种 AI 工具带来的收益,是否与它的风险和代价相匹配?
最简单的例子是:如果只是计算“1+1 等于几”,我们当然可以调用一个拥有数十亿参数的大模型。但心算、计算器,甚至两块积木,都能更快、更准确地解决这个问题。
通常来说,规模更大、计算更复杂的模型也需要更多计算资源,并带来相应的能源和用水成本。孩子需要学习的,不是拒绝技术,而是看见便利背后的代价。
这并不是说大型模型不应该使用,而是要先问:
这个问题真的需要 AI 吗? 需要多复杂的 AI? 使用它带来的便利,是否值得我们付出算力、能源、隐私或对工具产生依赖的代价?
同样,面对涉及儿童、健康或个人隐私的信息,即使某个 AI 工具功能强大,我们也要判断:是否有必要把这些数据上传到外部系统?能不能用更简单、更安全的方法完成任务?
第三层:创造——从使用工具,到参与设计系统
进入“创造”层,并不意味着每个孩子都必须成为程序员。
更重要的是,孩子开始参与定义问题、设计规则、测试影响,并根据反馈改进系统。
他们不再只是接受别人提供的 AI 工具,而是尝试回答:
我们究竟想解决什么问题? 什么样的系统才算真正有效? 哪些伦理要求应该从一开始就被写进设计里?
从混乱的数据开始
在一些进阶项目中,学生可能会尝试收集公开网络资料,并把它们整理成可供分析的数据。
现实中的数据很少像课本里的表格一样干净。网页里可能夹杂着广告、乱码、重复信息、错别字;有些群体留下了大量数字记录,另一些人的声音却几乎没有进入数据库。
学生需要决定:
哪些数据应该保留? 哪些记录可能不可靠? 谁的声音被过度代表? 谁又在数据中消失了? 清理数据的规则会不会同时删掉一些“不典型”但重要的信息?
亲自经历这个过程之后,他们会发现:数据并不是现实本身,而是现实经过收集、筛选和整理之后留下的痕迹。每一次清理和分类,都可能包含人的判断。
为什么 99% 的准确率也可能没有意义
系统完成之后,还需要测试。
假设每 100 个人中只有 1 个人患有某种疾病。如果一个 AI 面对所有人都回答“没有患病”,它仍然可以得到 99% 的表面准确率。
但那个真正患病的人,却会被它完全漏掉。
这说明,只看一个漂亮的数字,可能远远不够。
学生需要进一步观察:系统漏掉了什么?错误主要发生在哪些人身上?不同类型的错误会带来什么后果?真实用户的反馈是否会改变系统的设计?
随着学习深入,他们可能会接触精确率、召回率、F1 分数或 ROC 曲线等评价方法。但最重要的并不是背下这些术语,而是理解:
任何评价指标都代表了一种取舍。我们选择衡量什么,也就在决定什么样的错误更值得被重视。
创造层真正训练的,因此不只是“把模型做出来”,而是建立一个持续循环:
界定问题—设计系统—测试结果—听取反馈—重新修改。
伦理也不再是产品做完之后贴上去的一张警告标签,而应该从问题定义、数据选择到测试和发布,一开始就进入设计。
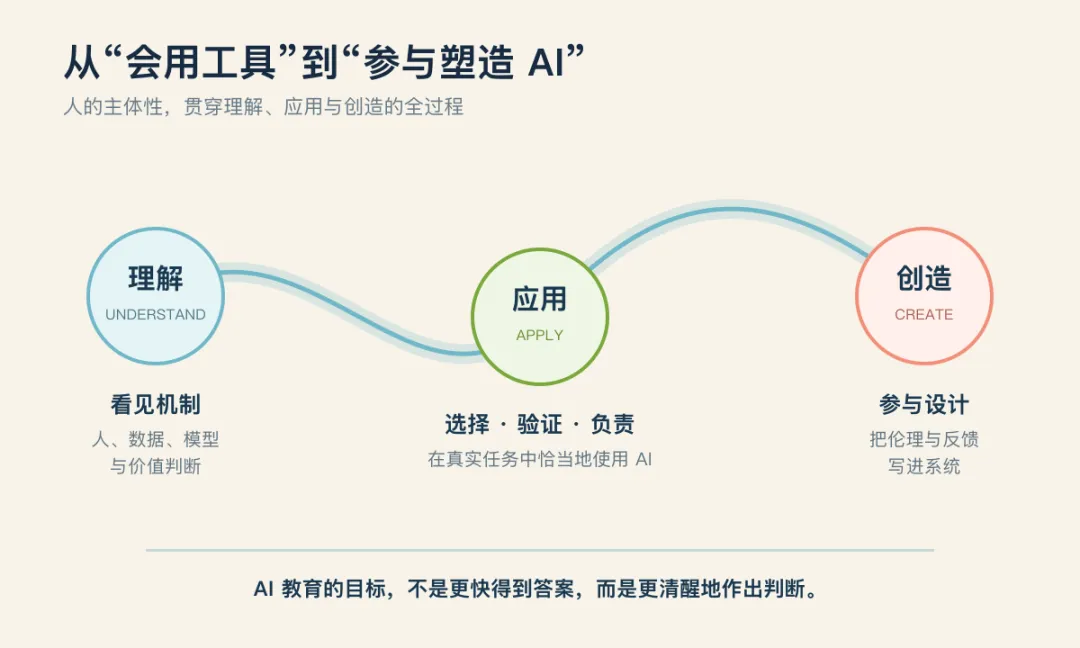
从看见机制,到负责任地使用,再到参与设计;人的主体性始终贯穿其中。
这套框架真正改变了什么?
UNESCO 的这套框架提醒我们,AI 教育不能只围绕某一种热门工具展开。
工具会更新,界面会变化,今天流行的提示词技巧可能很快过时。但有些能力不会那么容易过时:
面对 AI 给出的答案,知道继续追问依据; 面对看似客观的数据,知道检查谁被遗漏; 面对方便的自动化功能,知道判断它是否真的必要; 面对一个已经可以运行的系统,仍然愿意问它会影响谁、由谁负责; 不只是适应别人设计的 AI,也能够参与决定 AI 应该成为怎样的技术。
所以,未来 AI 教育最大的挑战,或许不是怎样让孩子把 AI 用得更熟练。
而是当 AI 越来越擅长给出现成答案时,孩子是否仍然能够保留自己的问题、判断和选择。
资料来源:UNESCO, AI competency framework for students, 2024。https://www.unesco.org/en/articles/ai-competency-framework-students
AI × YOUTH OBSERVATORY