ARTICLE · 1135979
一个不写一句话的 AI,凭什么让整个圈子刷屏?
往期精彩:
对比实测:为什么 JitWord 是目前最适配商用的 Web Word 编辑器?
先说件事。
9 月 15 号,一家叫 TypeSafe AI 的公司发了个模型,说了句很狂的话:"LLM 的时代该翻篇了。"
这个模型叫 Jev。最近几周,我公众号后台被问爆了:"它到底是不是炒概念?""跟 LLM 什么关系?""要不要学?"
我把官方博客翻了一遍,把社区第一手的独立测试数据扒了一遍,自己上手跑了 Demo,然后花了一周,把它拆成了 5 章,放进了我写的AI实战小册。
今天不聊参数、不站队,就聊三件事:Jev 到底是什么、它跟 LLM 差在哪、作为 AI 从业者,为什么应该现在就搞懂它。
先给大家一个认知锚点:AI 正在分化成"两种大脑"
诺奖得主卡尼曼把人的思维分成系统一(快、直觉、不费力)和系统二(慢、推理、烧脑)。过去三年我们用的所有 LLM——GPT、Claude、Gemini——干的都是系统二的活:一个字一个字地推理、生成。
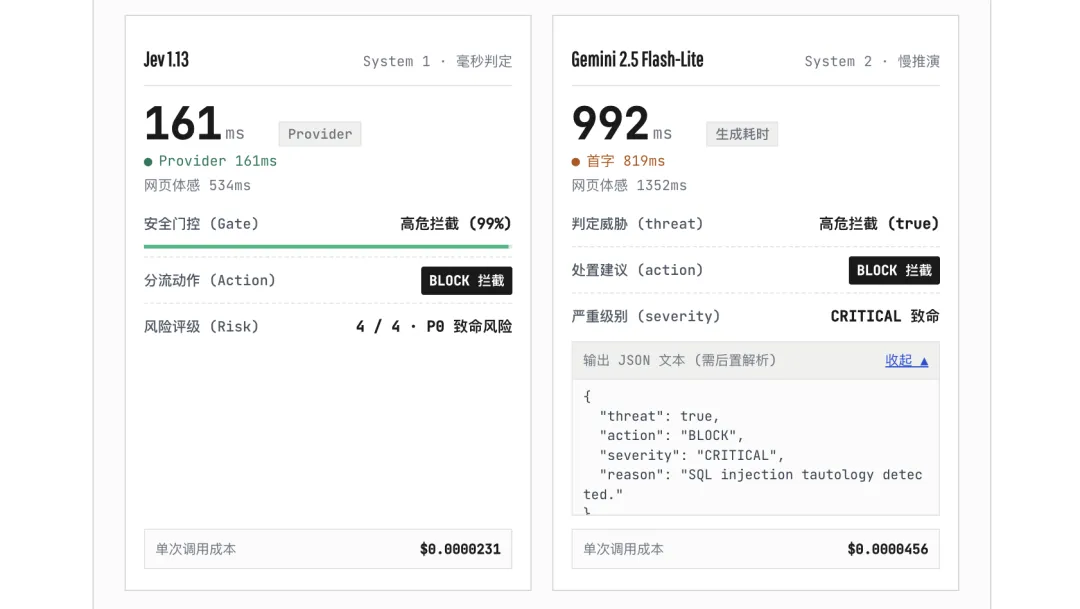
而 Jev 是第一个自称"系统一"的模型:不生成一个字的文本,只输出带置信度的类型化决策。
什么概念?就好比我们问 LLM"这条工单该转哪个部门",它要先"写一段话"再让你解析——慢、贵、还可能给你编一个不存在的部门(幻觉)。我们问 Jev 同样的问题,它 70~500 毫秒直接返回一个结构化的枚举值 + 置信度,格式上不可能出错,因为它压根不写自由文本。
40-200x
比 LLM 快的决策速度
$0.042
每百万 Token 输入成本
92%
高置信决策准确率*
* 第三方预注册独立测试:置信度≥0.9 的决策,92% 准确,覆盖 73% 的请求量
再给大家算笔账。一个日均百万次调用的分类/路由/风控场景,用旗舰 LLM 做,一个月账单五位数美金起步;换成 Jev,输入 $0.042/百万 Token,输出免费——对,没看错,输出不要钱,因为它的"输出"就是几个字节的结构化结果。
这不是"便宜一点",这是把一大类原本"用不起 AI"的高频场景,变成了用得起。模型起名 Jev,一半致敬卡尼曼的系统一,一半来自杰文斯悖论:效率越高,用得越多。这名字把野心写在脸上了。
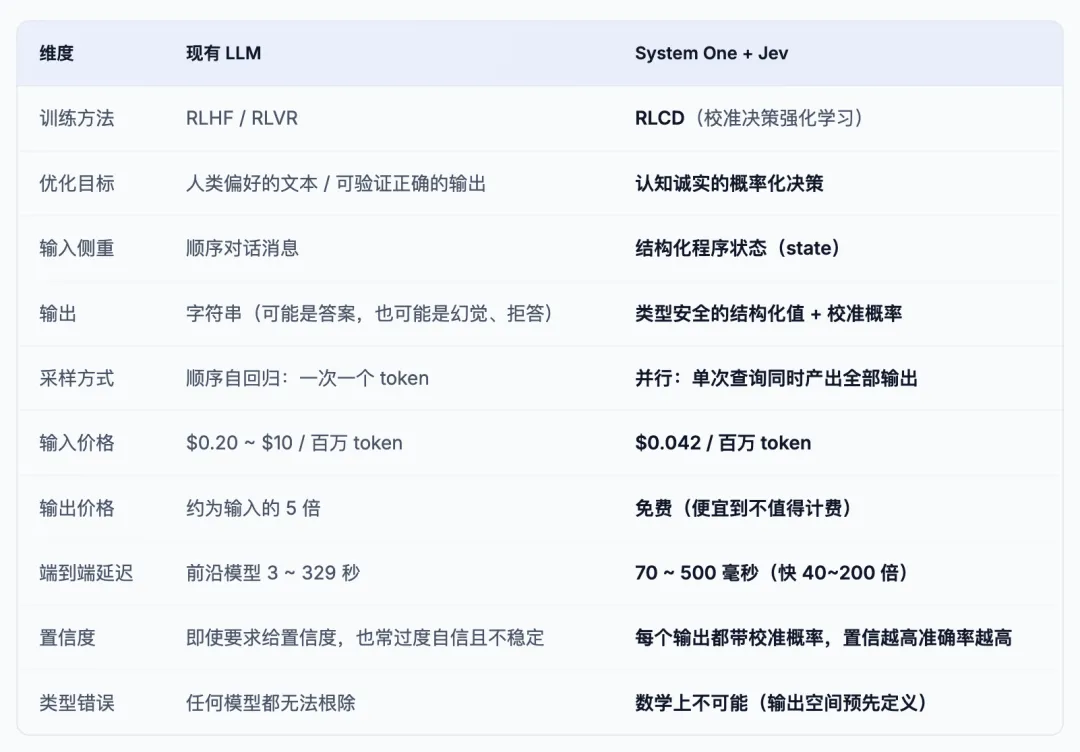
下面我做了一个详细的对比表格,方便大家参考对比它和LLM模型的差异:
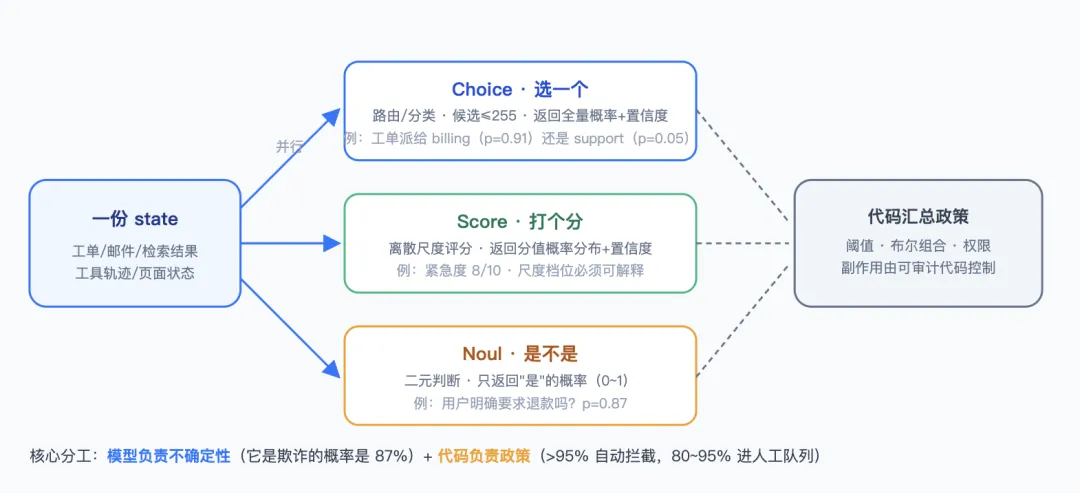
Jev 的全部能力,就三个原语
简单到一页纸能画完,但组合起来能覆盖海量工程场景
Choice · 从候选集里选一个
分类、路由、打标、意图识别。候选最多 255 个,返回值必然在你给的集合里——从机制上杜绝了 LLM"编造一个不存在的选项"这种事故。
Score · 打一个 0-100 的分
线索评分、内容质量分、风险分。以前你得设计复杂 Prompt 让 LLM"扮演评委",还要跟它的评分漂移作斗争;现在一个原语搞定,且带置信度。
Noul · 带置信度的是/否判断
这是最有意思的一个:它直接告诉你"这个判断我有多大把握"。独立测试里 Noul 的校准误差只有 0.012——它说 90% 把握,就真的对 90%。LLM 的自我评估可做不到这一点。
为什么"置信度"是真正的分水岭?
因为置信度校准之后,我们就能理直气壮地做分流:高置信 → 机器自动执行;中置信 → 升级给更强的模型复核;低置信 → 转人工。
这套"三段式决策通道",就是 Jev 章节里我最推荐的生产架构——它把 AI 系统从"祈祷它别出错",变成了"出不出错都在我的设计之内"。模型负责不确定性,代码负责政策。这句话,值得每个做 AI 工程的人贴在工位上。
生产级混合流水线(章节内附完整架构图与代码)
这次更新的 5 章,我是这么设计的
前 2 章所有付费用户都能看,后 3 章是 Plus 专属——因为后 3 章才是真正"值钱"的部分
① Jev 是什么:System One 模型的崛起
从"LLM 顺序生成 vs Jev 并行决策"的架构对比讲起(配了一张一眼看懂的 SVG 对比图),把 TypeSafe AI 这家公司、RLCD 训练路线、以及"为什么输出免费"的底层逻辑一次说清。看完这章,你就有能力和别人聊 Jev 而不露怯。
② 三大决策原语详解:Choice / Score / Noul 与 RLCD 原理
每个原语的 API 请求体长什么样、返回结构怎么解析、什么场景用哪个,全部用真实代码演示。还包括一个大多数人会忽略的细节:三个原语的校准误差差了一个数量级(Noul 0.012 vs Score 0.254),这直接决定我们在生产里该怎么用它们。
③ 应用场景实战:七大典型用法与混合流水线架构 PLUS
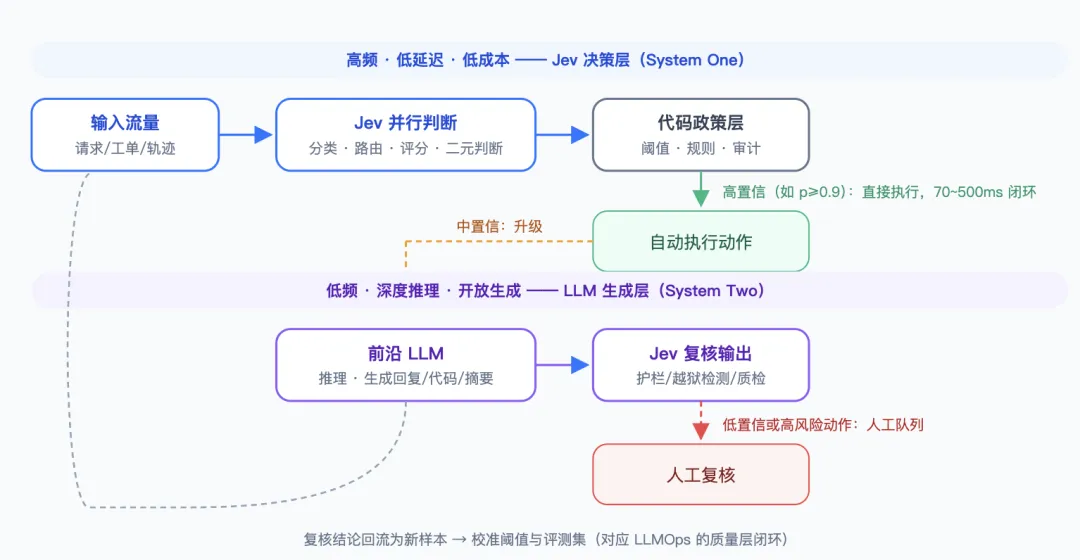
智能路由、实时风控、内容审核、销售线索分级、Agent 工具选择……七大场景逐个拆,最后落到一套"Jev 决策 + LLM 生成 + 人工复核"的三层混合流水线,附完整架构图。这不是"未来展望",这是我们现在就能照着搭的方案。
④ 工程化最佳实践:从 Playground 到生产系统 PLUS
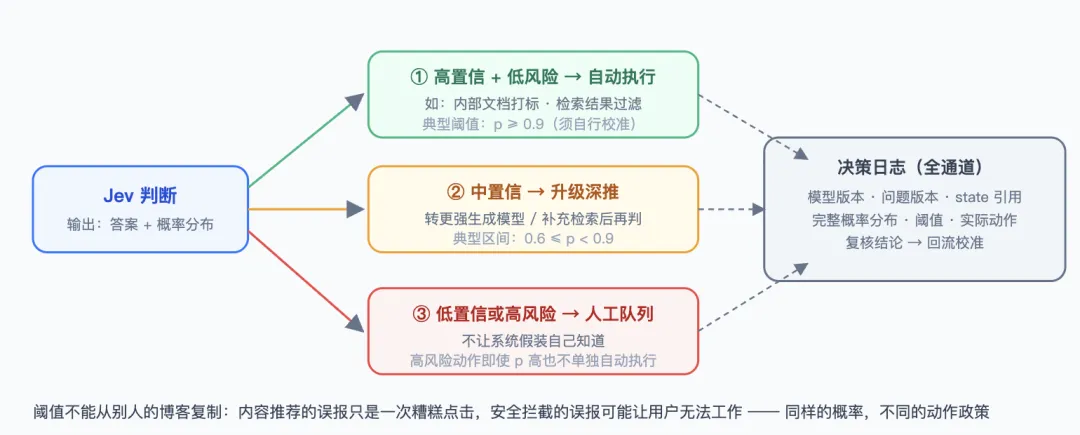
三段式决策通道的阈值怎么定、怎么用我们自己的数据做置信度校准、决策日志必须记的七个要素、成本和延迟怎么测算。这一章是按"你明天就要上线"的标准写的,全是工程细节,没有一句正确的废话。
⑤ 边界与冷思考:Jev 不能做什么,它是新范式吗 PLUS
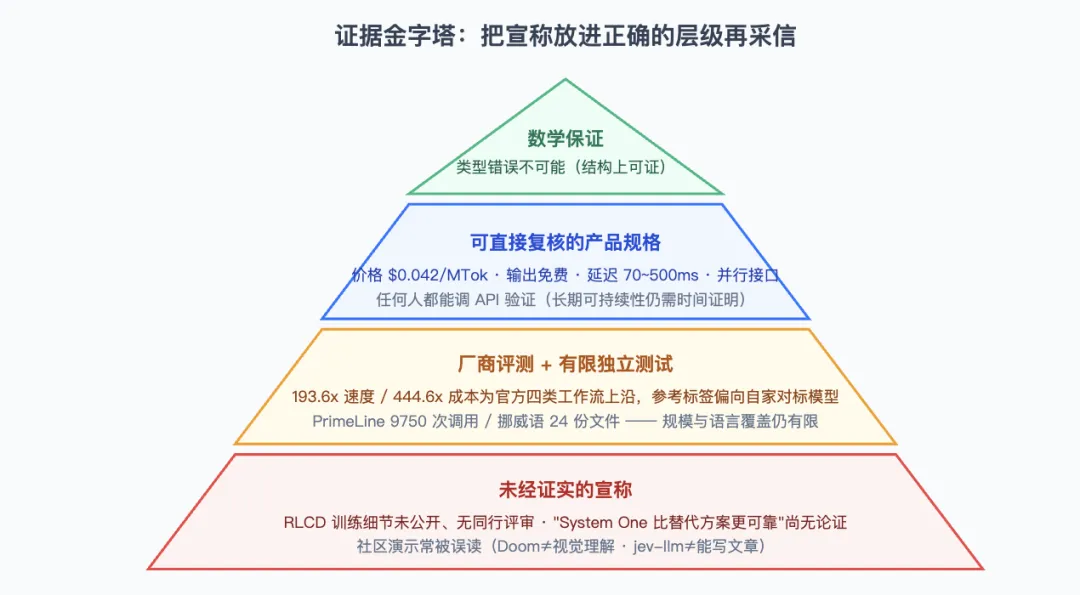
全网吹捧的文章很多,泼冷水的很少,这章就是冷水:RLCD 训练细节未公开、没有同行评审、纯文本模型不支持图像、英文场景最强、单一供应商的锁定风险……最后给你一张"证据金字塔"——哪些是数学保证、哪些是厂商宣称、哪些有独立验证,一图分清。能帮你避开坑的内容,比帮你兴奋的内容更值钱。
对 AI 从业者,这意味着什么?
我判断 Jev 这类模型短期内不会取代 LLM——它连一段话都写不了。但它会取代"用 LLM 硬扛高频决策"的那一大块 workload,以及那块 workload 背后的账单和延迟。我认为它对三类人影响最直接:
AI 工程师——技能栈从"Prompt 工程"扩展到"概率决策 + 不确定性管理"。会写 Prompt 的人很多,会设计"置信度分流系统"的人,接下来两年是稀缺品;
架构师 / 技术负责人——成本模型要重算了。原来因为"太贵太慢"被毙掉的实时 AI 功能(每条消息过风控、每次点击做推荐决策),现在有了可行性。谁先算清这笔账,谁先拿到预算;
产品经理——"格式幻觉"这个老大难(LLM 输出 JSON 偶发解析失败)在决策场景可以直接划掉。产品交互能围绕"置信度"设计新体验:把握大就自动执行,把握小就让用户确认。
我的观点是:Jev 不是 LLM 的替代品,它填的是"规则引擎太死板、LLM 太贵太慢"之间那道巨大的空白。这道空白里,藏着大量以前做不了的生意。
写过 RAG、写过 LLMOps、写过 LLM Wiki 之后,我发现现代 AI 应用的完整版图是四个引擎:RAG 是检索引擎,LLM Wiki 是知识引擎,LLM 是生成引擎,Jev 这类模型是决策引擎。
AI小册前面已经把前三个引擎写透了,这次把最后一块——决策引擎——补上了。四块拼齐,帮助大家对 AI 应用架构的理解就是完整的。
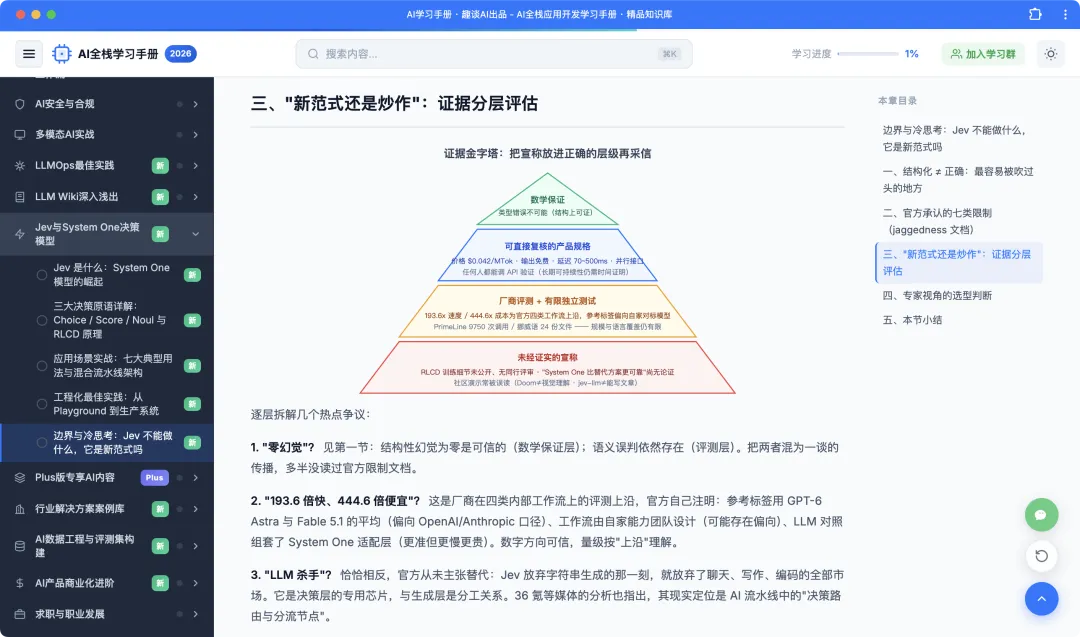
老规矩:
· 已订阅的用户(Pro / 标准 / Plus)免费解锁本次更新,登录就能看
· 前 2 章所有Pro用户都能读;后 3 章(场景实战 / 工程化 / 冷思考)是 Plus 专属
· Pro 用户随时补差价升 Plus,解锁全部 35 大模块 + 5 个项目源码
AI 编程实战手册 · Jev 决策模型专题已上线
35 大模块 · 166 精品章节 · 5 个完整实战项目 · 持续更新
👉 aibook.mvtable.com
或点击文末「阅读原文」直达
— 每一次更新,都对得起大家的信任 —
JitKnow V2.0.0:从可视化知识库到企业级AI中台