ARTICLE · 1153955
AI 已经去给开源软件找漏洞了,而且不收钱
QUOTE
发现漏洞和修好漏洞,是两件事。这份新服务想压的,正是中间那段最耗人的路。
—— Sunwing
开源软件有个不太被外界注意的特点:它撑着大半个互联网,却常常由很小的团队甚至志愿者在维护。
所以当 Anthropic 在 10 月 8 日宣布 OSS Scanner 时,值得注意的不是"AI 又能干什么",而是它切进了一个长期缺人的位置——在漏洞被人利用之前,先把它们翻出来。
29000+
过去六个月在重要开源项目中发现的候选漏洞
约 6000
其中人工复核过的数量
90% 以上
公司预期的真阳性率(属预期,非独立测量)
OSS Scanner 是一项免费、自愿报名的服务:符合条件的关键开源项目,可以定期收到由最强模型生成的安全报告。这次发布是 Anthropic 的 Cyber Mission 计划的一部分,同时推出的还有面向关键基础设施的防御项目。
每份报告里包含三样东西:漏洞如何被利用的复现步骤、问题说明,以及在可用时附上的修复建议。
这篇会回答
01
半年 29000 个候选漏洞,为什么人工只复核了 6000 个
02
报告不经过人工复核,"更快"和"更准"之间怎么权衡
03
报名要交一个 Dockerfile,这是为什么
这半年,它先找出了 29000 个
先把数字摆清楚。
过去六个月,在重要开源项目中发现超过 29000 个候选漏洞
人工团队只来得及复核其中约 6000 个
向主动索要报告的维护者,发出了近 5000 份未经验证的报告
截至 10 月 2 日,这些报告累计产生了 584 份安全公告
这组数字最有信息量的部分,是第一项和第二项之间的落差。发现的速度,已经明显快过人工能处理的速度。光是这半年积压下来的候选报告,就够这个团队忙上很久——而这还只是已经被翻出来的那一部分。
值得注意的是用词:29000 个是"候选漏洞",不是"已确认漏洞"。候选、复核、公告,是流水线上的不同阶段,把它们合并成一个总数,会高估证据强度。
于是这个瓶颈自然就被推到了台前:当发现不再是问题,处理才是问题。
报告不经过人工:快了,也可能错
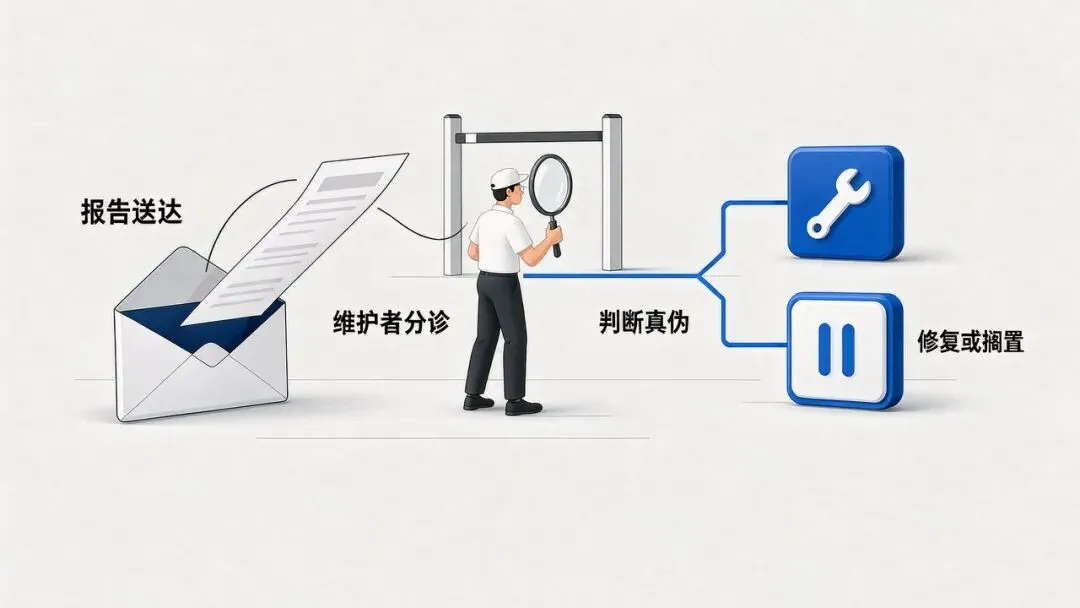
OSS Scanner 的设计里,最需要留意的一条是:报告完全由模型生成,不做例行人工复核和分诊。
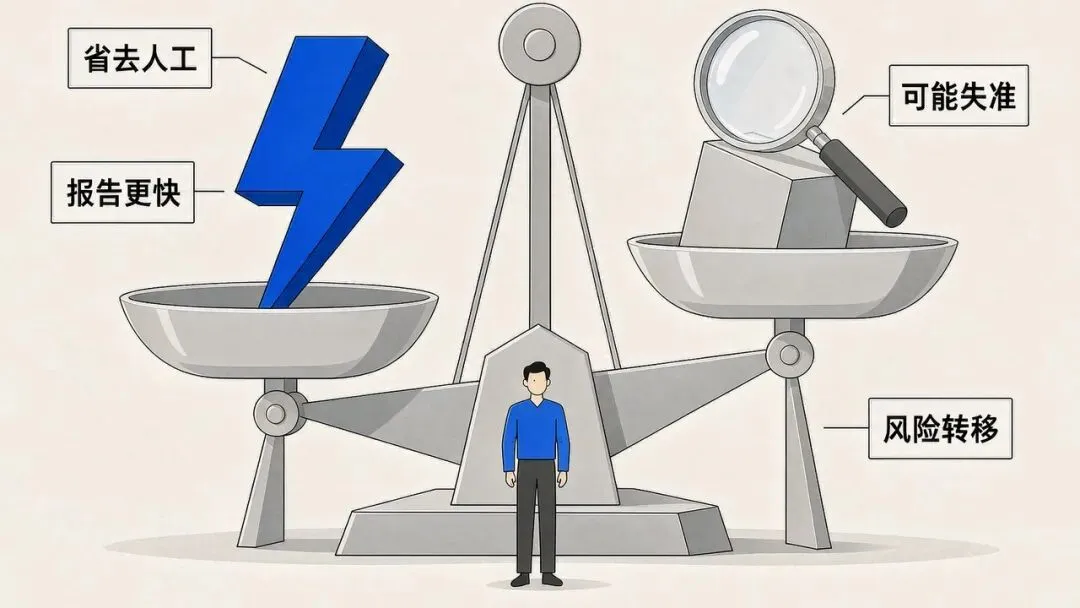
这样做的直接好处是快。维护者不用等人工过一遍,报告就已经发到邮箱。代价同样明确——公司自己提醒,部分报告可能不准确,包括严重性评级判断有误。也就是说,省下来的那道人工关口,被转移到了维护者自己身上。
速度和质量,在这里被摆到了一张天平的两端。
公司给出的预期
OSS Scanner 的真阳性率预计在 90% 以上,公司表示会持续改进准确率和修复质量。需要说明的是,这是发布方的预期,不是第三方独立复现的测量结果。
那么,这个"90% 以上"到底有没有支撑?有一组小规模的抽样值得看。
88% 这个数字,是怎么算出来的
抽样范围
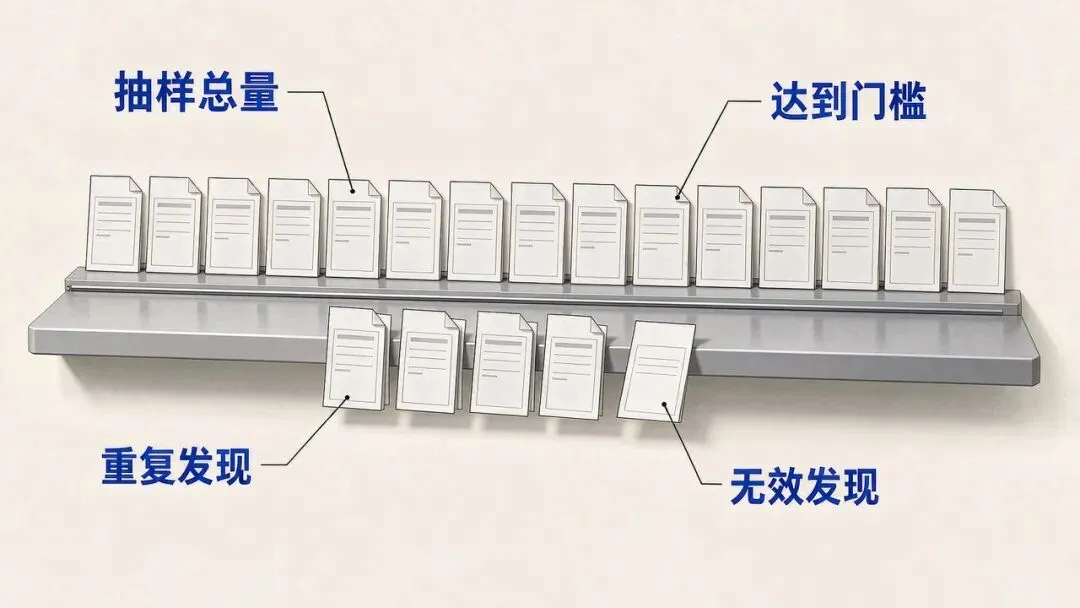
48 个项目里的 97 项严重和高危发现
专家复核
由专业渗透测试人员逐项审阅
结果
85 项达到公司协同披露流程的门槛,占 88%
这是公司自己的抽样。
这组数据需要连着口径一起读。88% 衡量的是"是否够格进入某套披露流程",不等于"每一份报告都指向真实问题"。剩余 12 项里,11 项被描述为真实但与已有发现重复或重叠,1 项被判为无效。也就是说,误报接近 0,但重复不算少——而重复的报告,同样要占用维护者的时间。
另一组背景数据来自 CyberGym 基准:模型在开源代码中发现漏洞的能力,从去年初的不到 20%,提升到今年的超过 85%。
把这两个数字放在一起看,这项服务的定位就清楚了:它的目标不是"取代人工审代码",而是把最容易漏的那一类问题先筛一遍,把人工的注意力留给真正需要判断的部分。
能力曲线陡了,可真正决定这项服务好不好用的,是它落到维护者手里之后的事。
报名的方式,很"工程师"
接入方式很能说明这项服务的性格。
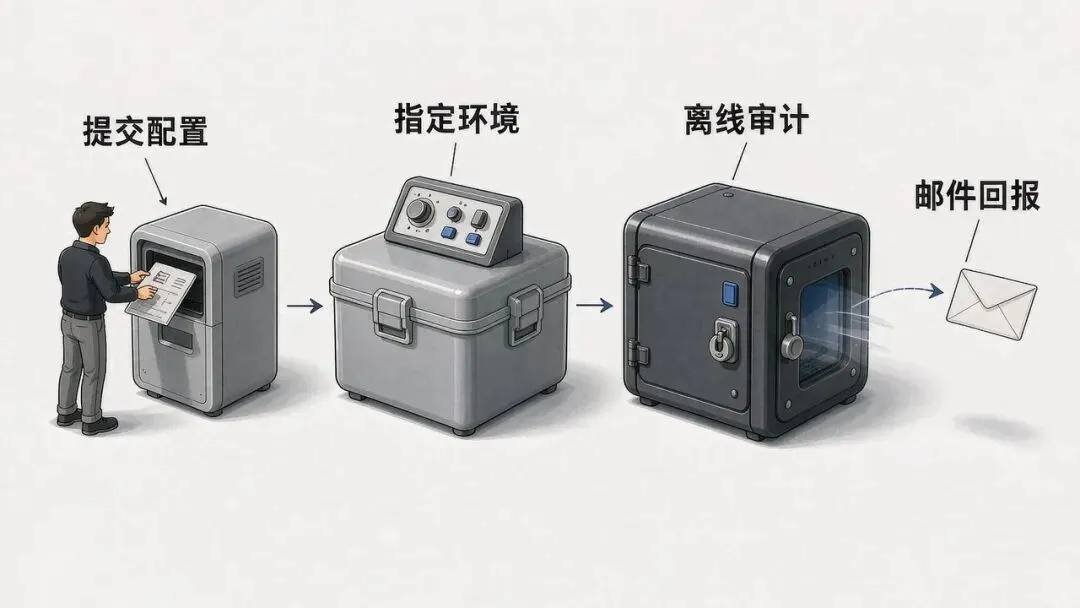
项目核心维护者向 OSS Scanner 的 GitHub 仓库提交一个拉取请求,附一份 YAML 配置
配置里要写明仓库链接、主联系人邮箱,以及一个 Dockerfile 的相对路径
Dockerfile 负责在容器里装好依赖并构建项目,扫描智能体随后在无联网的加固沙箱里完成审计
门槛设在这里,是有原因的。
它把"能不能跑起来"变成了"能不能被验证"——扫描依赖项目本身能构建成功,这一步由提交方自己保证。
为什么要一个构建文件的路径?因为它把"能不能把项目跑起来"这件事,从模型猜测变成了可复现的工程条件。项目在真实依赖下构建成功,扫描才有意义;回报则以邮件发送,附上复现步骤和可用时的补丁。
还有一处细节写在流程里:扫描在离线的加固沙箱中完成,整个过程不对外联网。这也解释了不少维护者愿意把代码交出去的前提——它停在一台不与外界通信的机器里,而不是被上传之后去向不明。
可选配置里还有几项:GPG 公钥用于加密邮件、威胁模型文件、以及一个可以随时关闭报告接收的开关。项目也可以退出。
服务设计得再周全,也要面对一个更现实的问题:找到的东西,谁来修。
修不完的漏洞,和另一条消息
修不完,是常态。
公司给出的类比是:就像招了一位不知疲倦的初级安全分析师——他能读代码、能写出测试用例,但交付的东西直接送到工程师桌上。工程师仍要判断这是不是真问题、在当前假设下严不严重、改了会不会破坏别的东西。这道判断,AI 目前替不了。
维护者的担忧也很具体:严重性评级可能被抬高,威胁模型可能被理解偏。一份看起来紧急的报告,处理成本并不低——要读、要复现、要判断、要决定改不改;已经有不少报告让维护者疲于分诊。
对维护者来说,最实际的问题还是容量。一个已经被问题压满的项目,如果再被大量报告淹没,未必会更安全。公司也表示,对没有精力处理这些报告的项目,会继续沿用人工验证后的披露方式。
一项安全服务的成败,不看它生成多少份报告,而看有多少报告被真正改掉。
同一周还有另一条消息:美国政府宣布新的 AI 安全事件强制报告要求,AI 公司在发生安全事件后须立即上报,并由专门的特别工作组监督执行。一边被派去替别人查漏洞,一边被要求交代自己的事故,这两件事出现在同一周,并不矛盾。
发现
半年 29000+
候选漏洞数,非已确认数
处理
人工只复核约 6000
发现速度已快过人工处理速度
口径
90% 是预期
88% 衡量的是进入披露流程的合格率
如果一份 AI 生成的漏洞报告发到你手上,你会先信它,还是先自己复现一遍?
留言区 · 今天想问你一句
你觉得 AI 做安全,"找得快"和"找得准",哪个更难做到?欢迎在留言区聊聊。
—— Sunwing