ARTICLE · 1203323
单月4万篇AI灌水冲垮arXiv!35年学术圣地紧急限流:每人每月只准投2篇
2026年10月1日,全球科学界的“中央车站”拉下了紧急制动闸。
这一天,统治物理学、数学与计算机科学界整整35年的预印本平台 arXiv,在官网挂出了一道史无前例的铁令:即日起,每位提交者每个日历月最多只能提交2篇新论文,同时处于处理队列中的“活跃稿件”不得超过3篇。
没有缓冲期即刻生效
▲ arXiv官方账号发布全站限流通知,明确每月最多2篇新提交、最多3篇活跃提交
把这群平日里温和儒雅的科学家逼到墙角的,是一场史诗级的“AI学术泔水(AI Slop)”海啸。
就在刚刚过去的2026年9月,arXiv单月涌入了40,363篇论文,创下建站以来的最高纪录。与此同时,后台积压了近9,000张催促与申诉工单。
负责守门的近300名志愿审核员彻底被淹没了。如果不踩下这脚急刹车,这座人类开放科学的灯塔,将被机器批量生产的文字垃圾活活撑爆。
01.35年不设防的“科学广场”,撞上工业级印钞机
很多人可能没听过 arXiv(读作 archive),但在理工科世界里,它就是空气和水一样的基建。
按传统规矩,科学家写完一篇论文,要投给《自然》《科学》这样的期刊。编辑找同行盲审,来回修改、扯皮,见刊往往是一年以后的事。但在一日千里的前沿科学,尤其是人工智能领域,等一年,黄花菜都凉了。
于是,1991年诞生的 arXiv 成了全世界的“学术抢发公证处”。研究者写完手稿,先往 arXiv 上一贴,打上精确到秒的时间戳,全人类免费阅读。谁先贴出来,科学发现的“优先权”就归谁。
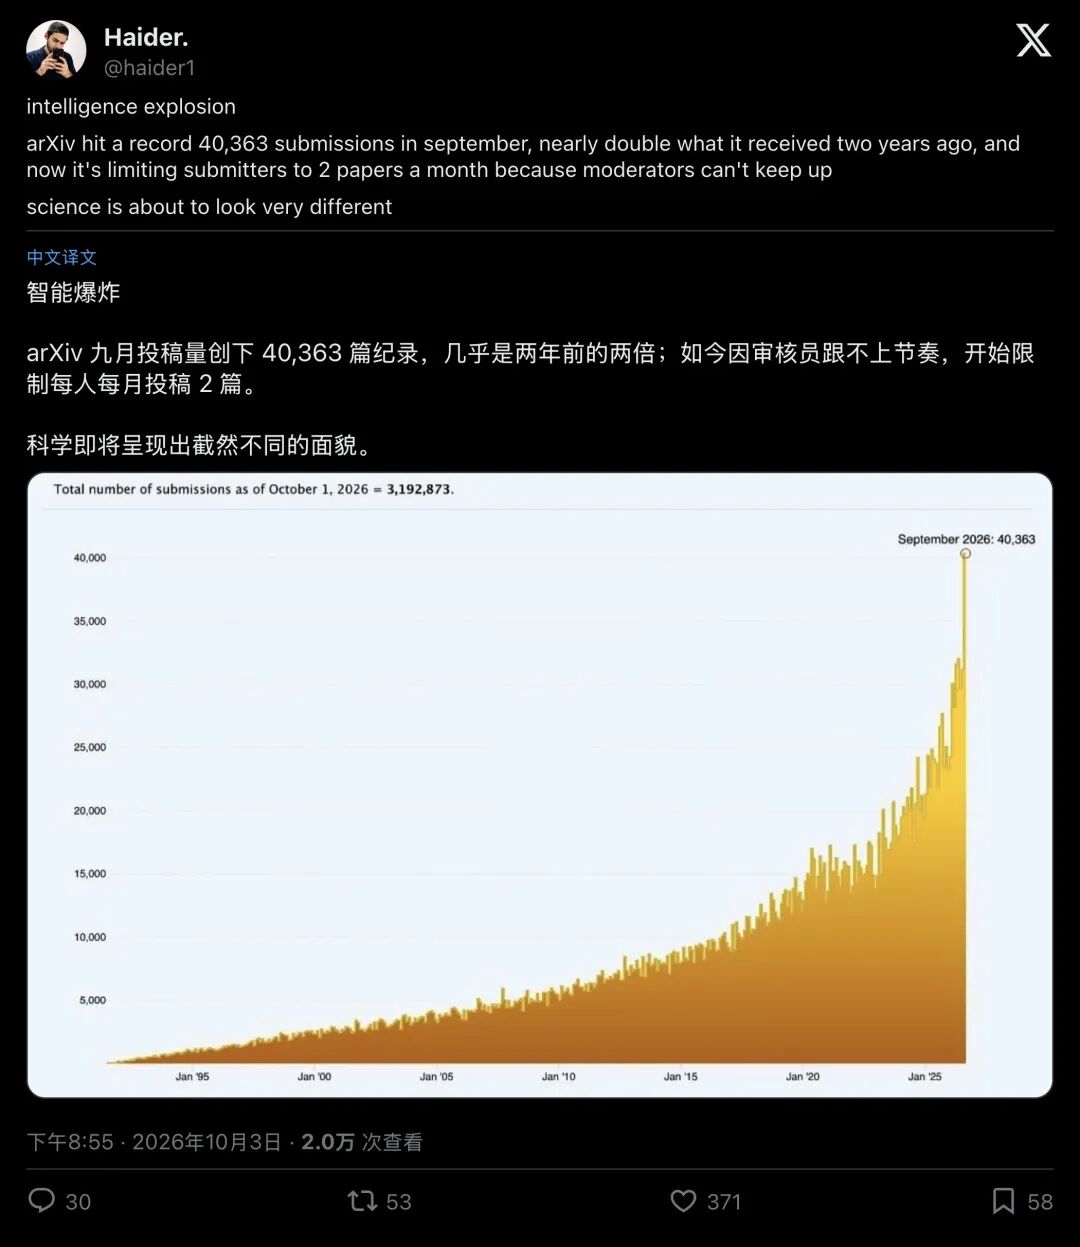
▲ 社区分享的arXiv月度投稿量陡升曲线,2026年9月一举突破4万篇大关
过去三十多年,这座大门几乎是不设防的。
arXiv 并不属于传统学术期刊,也省略了漫长的同行评审。它依靠全球近300名志愿学者担任审核员,每天像安检员一样快速扫视稿件:只要格式符合学术规范、学科分类无误、排除明显荒谬的内容,通常隔天就能上线。
这套松散的“君子协定”之所以能平稳运转35年,全靠一条心照不宣的自然法则:人类写论文,是有生理极限的。 查文献、做实验、推公式、熬夜码字,哪怕是高产的天才,一年能正儿八经憋出几篇硬核论文,就已经要掉一层皮了。
直到大语言模型进化成了全自动论文印钞机。
看看这组触目惊心的数字对比:2016年9月,arXiv 收到 9,869篇 稿件;2024年9月,这个数字涨到 20,569篇;而到了2026年9月,直接飙到了 40,363篇,两年翻了一倍,十年翻了四倍! 其中,计算机科学下的人工智能板块(cs.AI),投稿量在短短两年内暴涨了6倍以上。
arXiv 科学主任、天体物理学家 Steinn Sigurðsson 向《自然》杂志吐露了后台的惨状:近300名志愿者每天满负荷运转,合计能审约1,000篇稿子。但限流令出台时,队列里依然死死卡着近4,000篇待审论文。
海量老实本分的学者,因为少数人的疯狂灌水,被迫在排队通道里苦等数周。
02.一块肉切十刀:一个月狂投42篇的“萨拉米香肠”
堵死通道的到底是什么东西?
10月1日,arXiv 社区参与经理 Kat Boboris 在官方博客《公平审核、平等获取与AI》中,罕见地撕下了客套的面纱。紧接着,arXiv 编辑顾问委员会主席、俄勒冈州立大学荣休教授 Thomas G. Dietterich 连发多条推文,向外界揭开了审核员每天面对的荒诞图景。
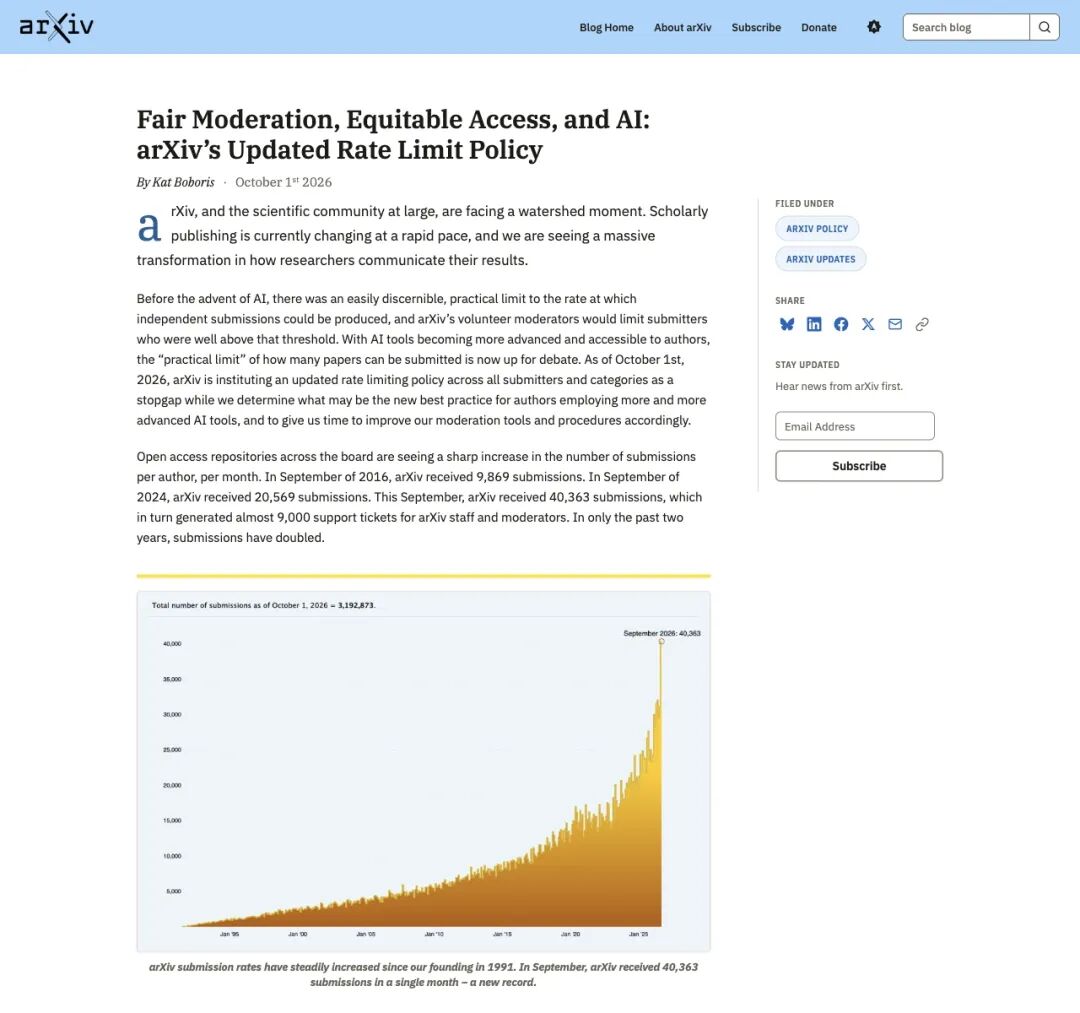
▲ arXiv官方博客由Kat Boboris发布的限流政策长文首屏
“有些人每个月要提交几十篇论文!” Dietterich 在推文中写道。
在生成式AI的加持下,学术圈滋生出了一套流水线式的“灌水刀法”:
第一种叫 “薄论文(Thin papers)”。只改了一丁点网络结构,或者只多跑了一组微不足道的消融实验,相当于做红烧肉时只多放了一克盐,就靠大模型扩写出洋洋洒洒十几页、充斥着密集学术黑话的独立论文。
第二种叫 “萨拉米切香肠(Salami slicing)”。原本一个完整的研究项目,被作者像切香肠一样剁成七八片“最小可发表单元”,每一片都单独投一次稿,把引用率和发表数量刷到飞起。
▲ 《自然》新闻以“arXiv对抗AI灌水:限制预印本提交管用吗?”为题进行深度报道
其实,arXiv 与 AI 灌水的交锋早已开始。
翻开过去一年的交锋记录,平台的防线一直在节节后退:
- 2025年11月
,因为大批由大模型低成本拼凑的“综述论文”和“立场论文”泛滥,计算机科学板块被迫收紧规则,要求此类文章必须先过同行评审才能上传; - 2026年5月
,平台发现大量稿件里出现了大模型凭空捏造的“幻觉参考文献”,宣布对不核验AI生成内容的作者处以禁投一年的重罚; - 2026年10月1日
,个案封堵彻底失效,全站硬性配额终于落地。
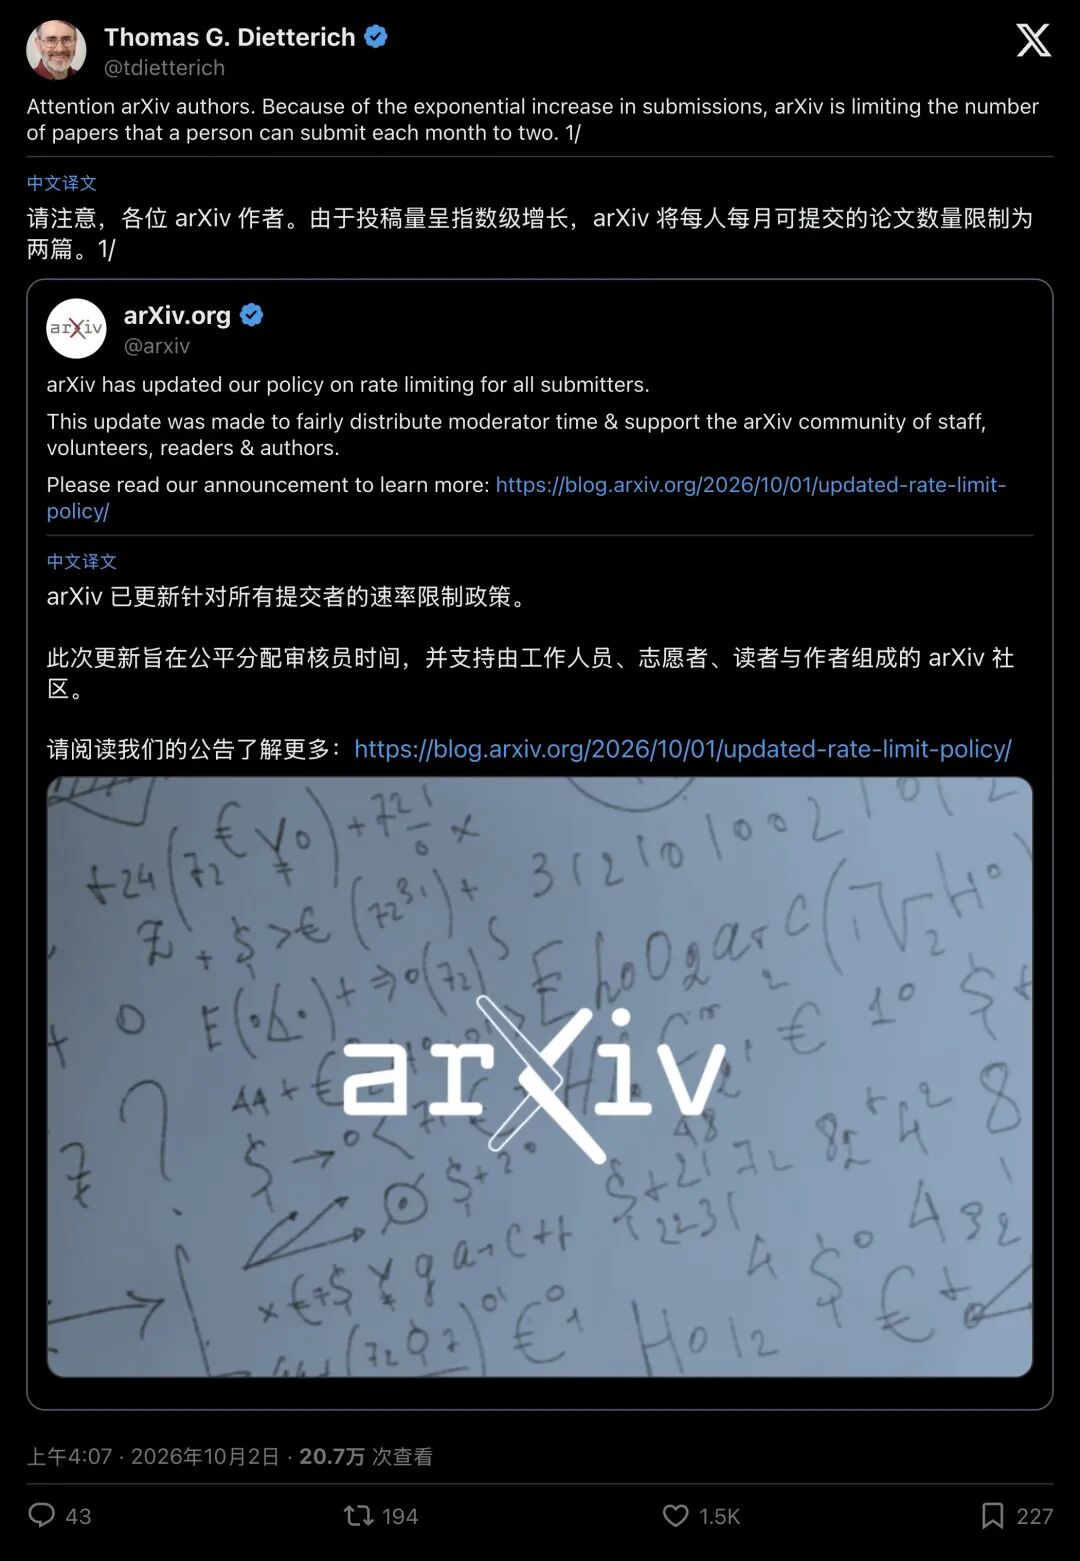
▲ arXiv编辑顾问委员会主席Thomas G. Dietterich发文解释因指数级增长被迫限流
新规在计费逻辑上也极具杀伤力根据官方 FAQ,每月2篇的额度只认“点击提交按钮的人”,跨所有学科合并计算。最让投机者肉疼的一条是:哪怕你的稿件被审核员当场拒稿,同样直接扣掉当月1次额度!
这一设定的初衷很清晰:消耗志愿者精力的,正是“按下提交键”这个动作本身。
03.为什么医学没垮,唯独计算机成了风暴眼?
同样面对大模型普及,为什么同为预印本平台,搞生命科学和医学的 bioRxiv 与 medRxiv 没有被冲垮?搞社会科学的 SocArXiv 为什么每周限投一两篇就能风平浪静?
把不同学科的底牌摊开对比,你会发现一个极其毒辣的真相:计算机科学,尤其是人工智能,掉进了自己挖的“硅基闭环”里。
先看医学和生物学由冷泉港实验室、耶鲁大学和《英国医学杂志》运营的 bioRxiv 与 medRxiv,天生自带一道“湿实验(Wet-lab)物理防火墙”。
你要发一篇生物医学论文,光靠嘴皮子溜没用。你得交出伦理委员会批件(IRB)、临床试验注册号;你得有细胞培养记录、小白鼠实验数据、生化试剂批号,还得贴上真实的电泳图和测序数据。ChatGPT 和 Claude 再聪明,也没法在显卡里给你凭空孵出一只小白鼠的肝脏。 加上专职筛查员与学者的双层审查,AI灌水在医学门口直接撞上了铜墙铁壁。
再看社会科学研究往往依赖长达数月甚至数年的田野调查、入户访谈或历史档案考证。SocArXiv 主任 Philip Cohen 对《自然》直言,社科领域短时间连续投稿几乎就是 AI 灌水的铁证,设个每周限额,正常学者根本无感。
唯独人工智能领域,是一个彻底脱离物理世界的“纯硅基闭环”。
在机器学习圈子里,数据集是现成开源的(比如 ImageNet),算力是云端租的。现在,大模型不仅能帮人写论文正文,还能自动写代码、自动微调模型参数、自动跑实验、自动把结果画成精美的折线图。
从实验设计到成文排版,全链路都在硅基芯片里跑通了,边际成本趋近于零!再加上 AI 圈子极度焦虑的“抢发占坑文化”,只要跑出哪怕 0.1% 的性能提升,作者恨不得当晚就塞进 arXiv。当零成本的自动化生产遇上300名血肉之躯的志愿审核员,系统崩盘只是时间问题。
04.学界吵翻天,与一则刺穿灵魂的“2030预言”
这剂猛药一下,迅速在国际学术界激起轩然大波。
支持者拍手称快罗格斯大学数学家 Alex Kontorovich 直接转发官方公告硬刚:“我其实很喜欢这项政策。我可不打算去读你这个月写出来的42篇论文。挑两篇,挑你最顶尖的两篇!” 哥伦比亚大学流行病学家 Siddhesh Zādéy 也认为,正常学者一个月能写出两篇扎实的手稿已经累得够呛,限流根本算不上扼杀生产力。
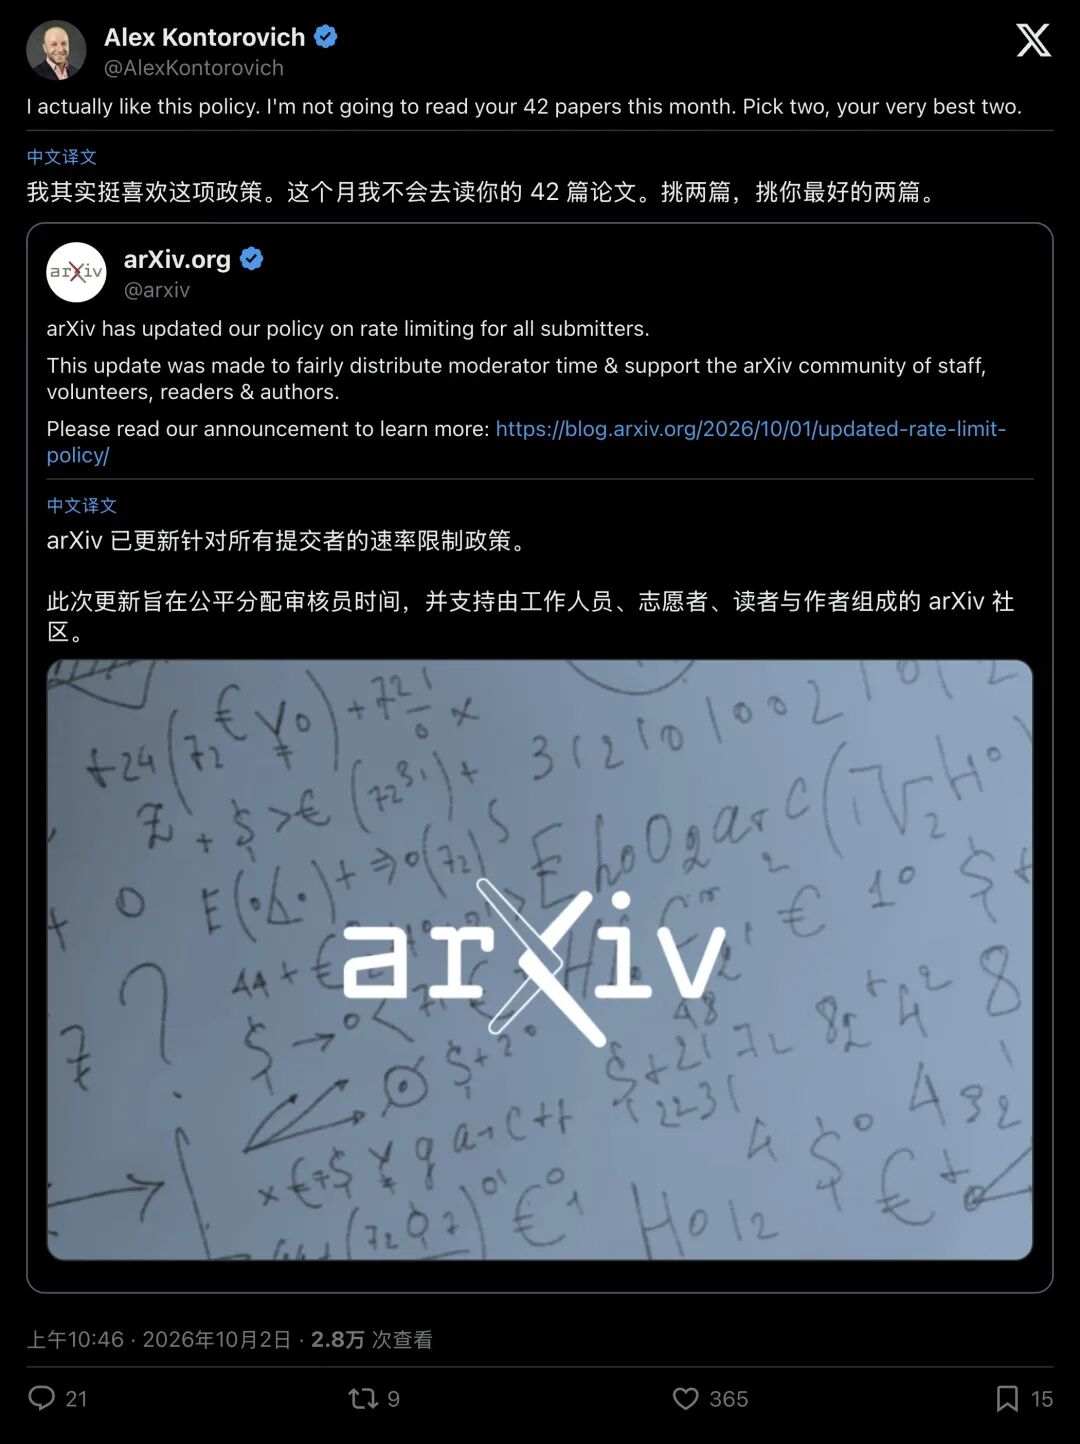
▲ 数学家Alex Kontorovich直言没人会读某人一个月发出的42篇论文
但反对派的质疑同样刀刀见血
哈佛商学院教授、市场设计学者 Scott Kominers 连发长文批评:作为在 arXiv 投稿近20年的老用户,他认为平台找错了靶心,“arXiv 应当设法减少审核负担,同时保护正常的学术探索与产出。” 为什么不建立类似“学术信用分”的白名单,给声誉优良的资深学者开辟免审通道,反而用一刀切的限额波及那些高产且严谨的顶尖团队?
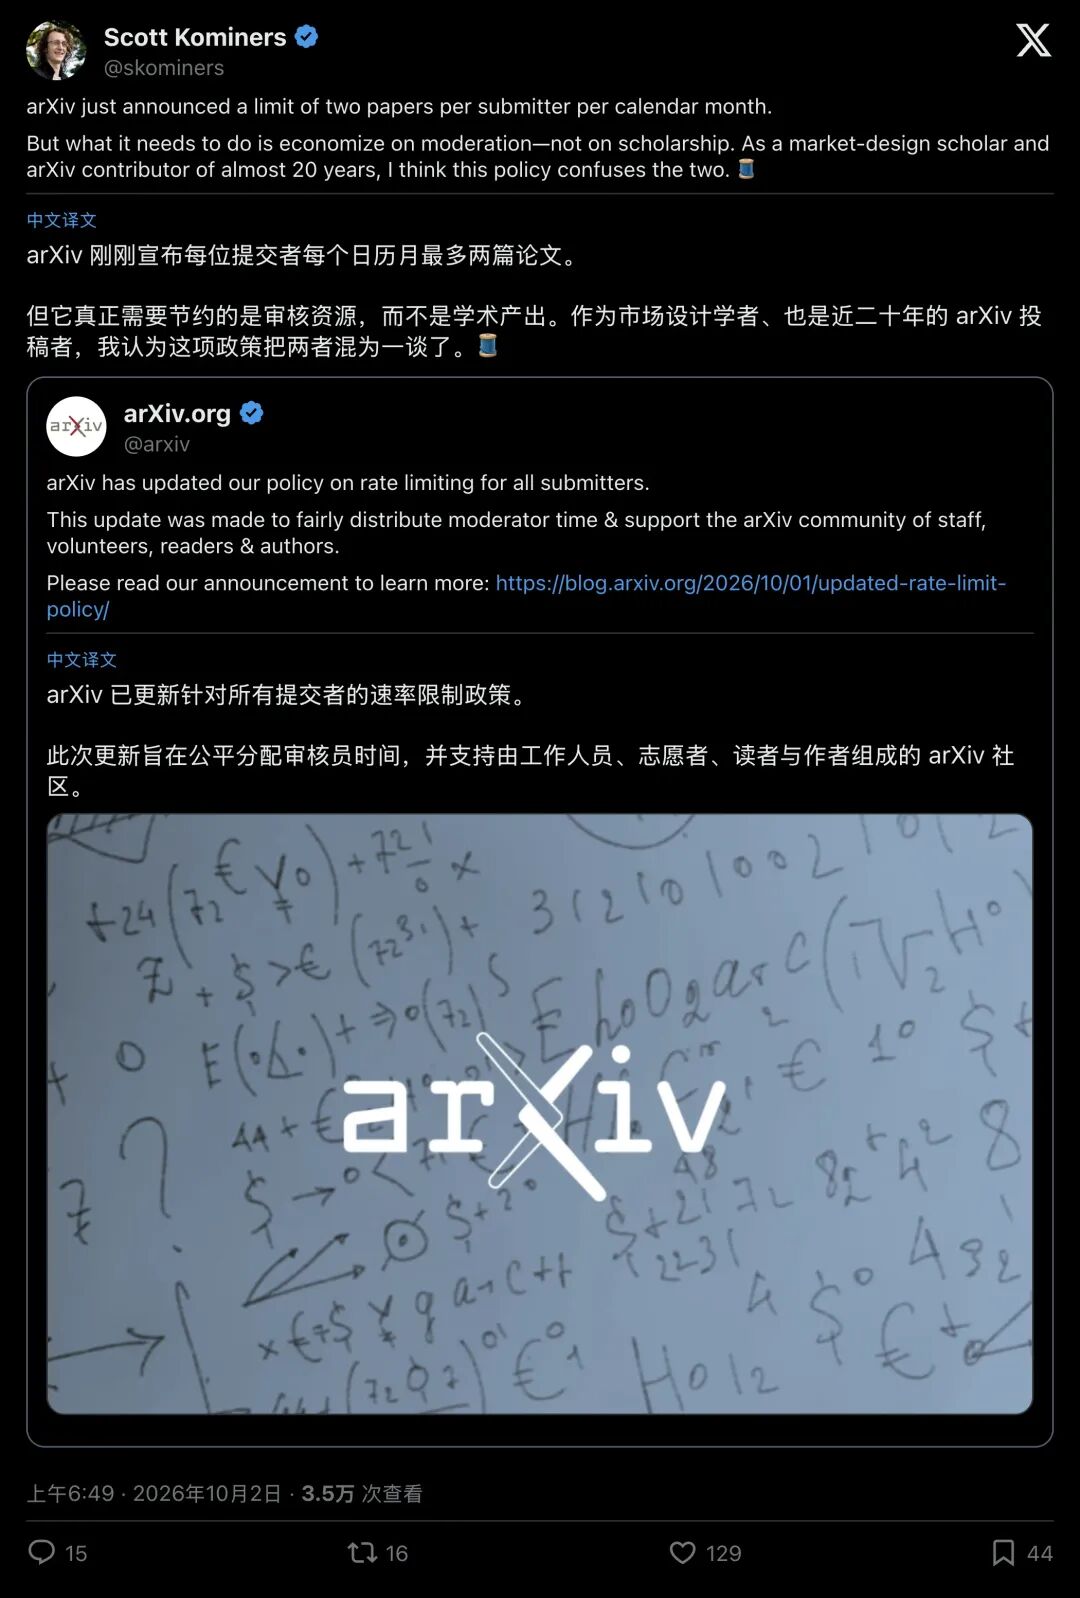
▲ 哈佛商学院市场设计学者Scott Kominers批评该政策混淆了节约审核与限制学术
规则的漏洞也很快被聪明人看穿马里兰大学理论物理学家 Victor Galitski 指出,既然限额只绑定“点击提交的人”,那么拥有几十号学生的大实验室,完全可以通过共同作者轮流注册账号点提交,轻松绕过封锁。物理学家 Sabine Hossenfelder 则冷冷抛出一句预言:“接下来,arXiv 上的单篇论文篇幅要显著变长了。”
在这场大混战中,网友 askar(@anpr1m)在官方评论区写下的一段“2026,2030未来编年史”,成了全网疯传的黑色幽默神作:
2026年:9月4万篇投稿,审核员自从 GPT-5 发布后就没合过眼。紧急开会:“要不……咱们少让人投点?”每人每月两篇,问题解决!2027年:cs.AI 还是暴涨6倍。现在每篇论文都有30个共同作者,其中29个是用来凑提交额度的工具人账号,Claude 被列为通讯作者。2028年:一线研究人员被迫转战个人博客与社交平台长文。但引用链接有一半指向了已删除的帖子。2029年:arXiv 每天刷出400篇标题全都叫《迈向(Towards)……》的论文,甚至出现了《迈向一个关于“迈向”的框架》。博士生早上打开页面,默默关掉,回去读1990年代的物理老论文。2030年:研究生问导师 arXiv 以前是干嘛的。“那是你把论文放上去、好让大家都不用读的地方。”“那不就跟现在一样?”“不,那时候至少还有人会读一下摘要。”
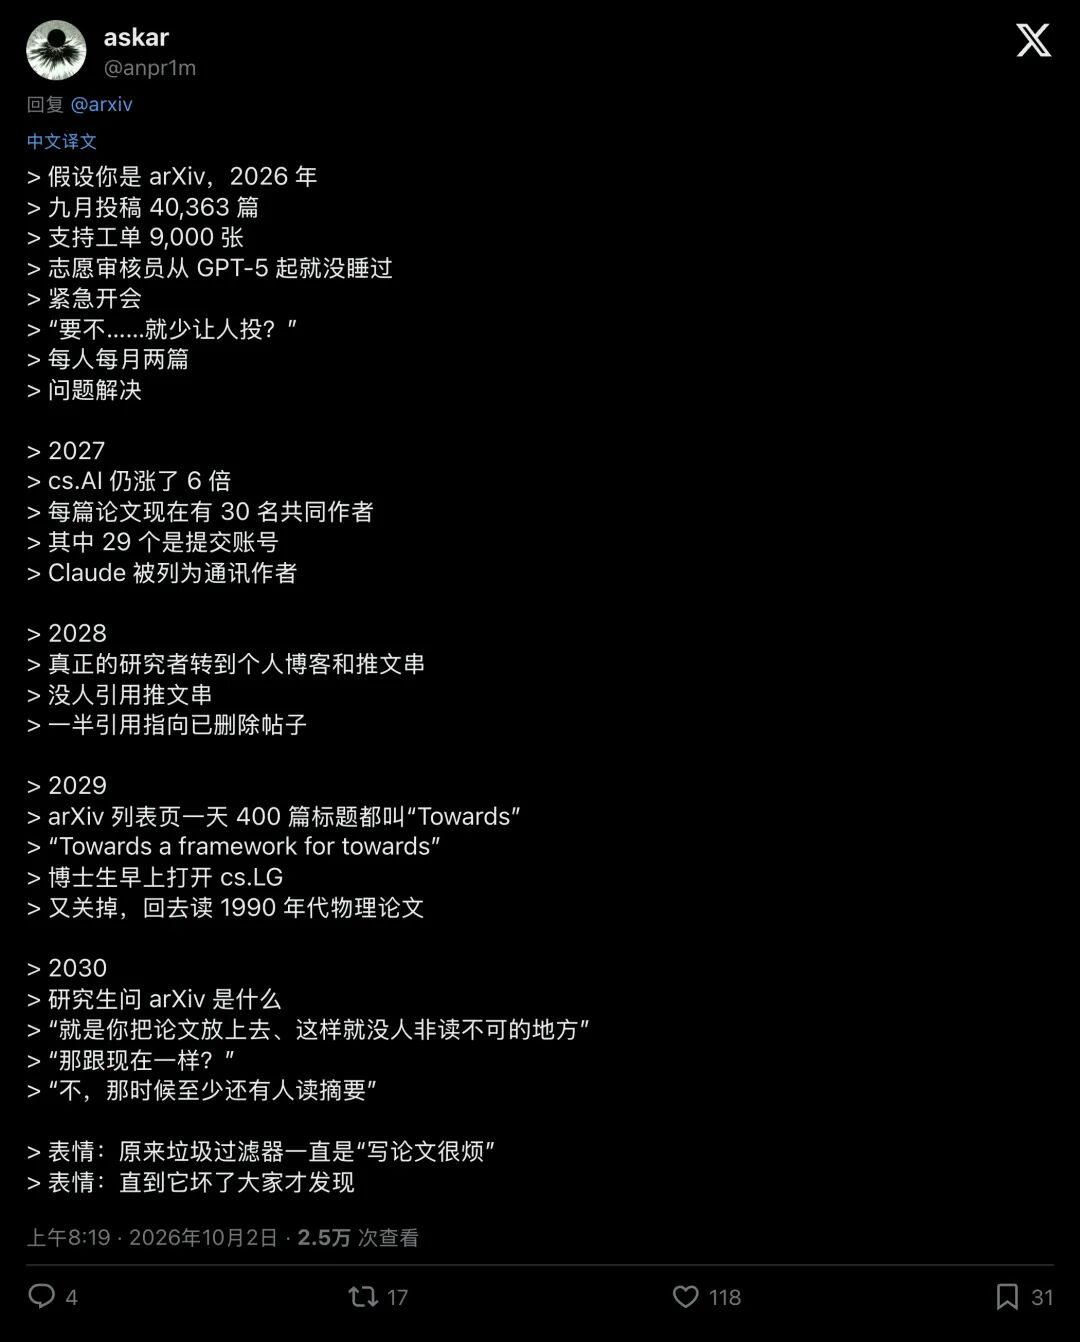
▲ 网友askar用编年体段子调侃限流后的未来乱象,结尾一针见血
这段黑色幽默的结尾引发了全网科研人的强烈共鸣:
“原来过去几十年,这套体系天然的防垃圾过滤器,一直都是‘写论文太费劲了’。”“直到这层防线被大模型击穿,大家才意识到它的价值。”
05.当制造文字失去门槛,什么才是稀缺资产?
荒诞的闭环已经在现实中上演
帝国理工学院数学家 Kevin Buzzard 对《新科学家》感叹,arXiv 恐怕挺不过这场冲击了。因为他自己现在每天已经根本看不过来新增的论文,为了在垃圾堆里淘金,他不得不反过来依靠 AI 工具,帮自己筛选每天该读哪篇论文。
一边是用 AI 狂发论文的作者,一边是被迫用 AI 过滤论文的读者,中间夹着300名快要累趴下的人类审核员,正如网友所嘲讽的,这是一场“用 AI 对付 AI、毫无产出的无尽死循环”。
Dietterich 坦言,“每月2篇”只是权宜之计(stopgap),是为了给平台升级审核工具、给学术界建立 AI 时代的新规范争取喘息时间。
但 arXiv 在2026年秋天踩下的这脚急刹车,注定会写进科技史。它戳破了一个长久以来的幻觉:过去人类社会的许多开放基础设施,无论是开源代码库、维基百科,还是免费的预印本服务器,能够长期维持高水准运转,核心全在于“生产合格内容”本身存在巨大的天然物理与智力摩擦力。
如今,生成式 AI 把制造文字、代码和图表的摩擦力直接抹平到了零。而人类大脑阅读、审视、辨别真伪的带宽,依然停留在石器时代。
当任何人都可以在一夜之间批量生成几十篇格式工整的论文时,“发表”本身的含金量已然稀释。往后最宝贵的资产,变成了同行愿意为你停下目光、花上十分钟认真审视与理解你的智力成果。