ARTICLE · 1288741
不用你盯的AI同事来了:DeepSeek开源Super-agent
说个扎心的事实:AI 干活越来越利索,盯 AI 的活却全落在你头上。
模型一个个都成精了,可你还得开三五个窗口,记住每个会话聊到哪、来回切换盯进度——活儿是 AI 在干,累是你在受。
DeepSeek 把这个病根写成了一篇万字长文,并把其中部分设计做成了开源原型,叫 Super-agent。一句话说人话:让 AI 从“你问一句它动一下”的工具,变成能自己接活、自己推进、持久在线的“AI 同事”。
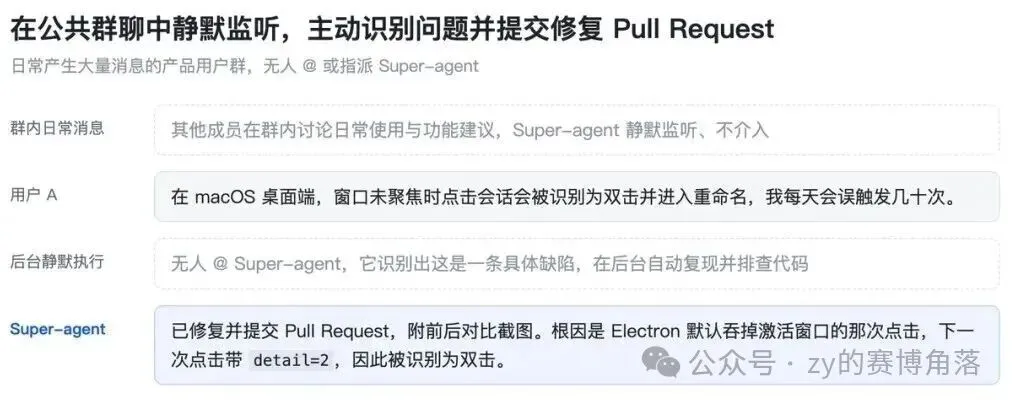
群里没人 @,它自己定位 Bug 提交了修复 PR(图源:DeepSeek 官方公众号)
官方长文里有句话说得很直白:单任务的上限取决于模型能力,多任务的上限取决于人的注意力。
你要是现在就同时开着好几个 AI 窗口,这段应该不用我多解释。
它怎么解决?挑三个最有画面感的说。
一是分两层
一个管事的(Router),一群干活的(Worker)。管事的只负责接需求、派活,自己绝不动手写代码;干活的各领各的任务,关在小黑屋里互不打扰。你在群里聊到一半改了主意,转头去 GitHub 上补了条评论,它都知道——自始至终接话的都是同一个 AI,不用再当“会话管理员”。
二是够主动
群里有人随口报了个 Bug,不用等人 @ 它,它先在后台偷偷复现、找修复方案,确认问题简单可修才把 PR 交出来,找不到或太难修就当无事发生,全程不烦你。官方管这叫投机执行——赌对了惊艳所有人,赌错了没人知道。
三是自带“看门狗”
系统外面单独站了个“看门狗”,不只盯着进程死没死,还会判断 AI 是不是在原地瞎转圈、活儿干没干跑偏,发现不对就拉回来——它兜的是“挂了有人修”,不是“保证永不挂”。
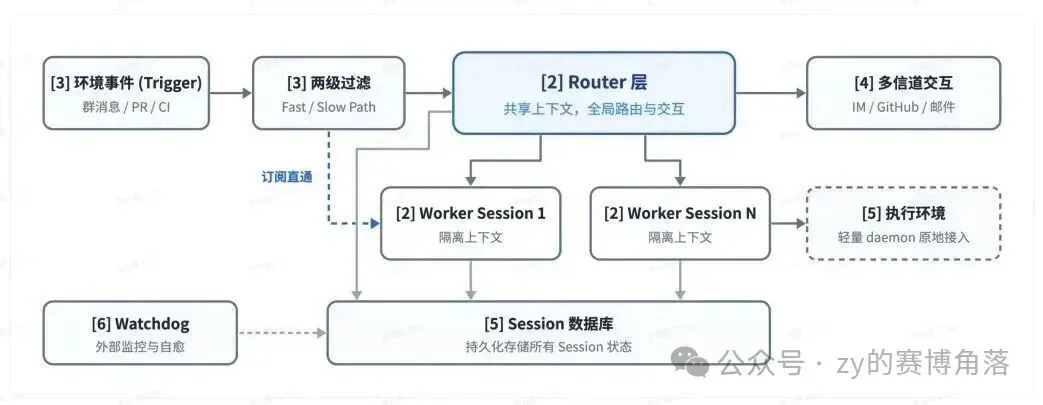
Super-agent 整体架构(图源:DeepSeek 官方公众号)
效果怎么样
官方做了组模拟调度实验:往系统里灌了约 300 条消息,混着 20 个工作请求(编码活由一个只耗时间的工具代替,测的是调度协作能力,不是真实写代码水平)。结果 Super-agent 一半任务 12 分钟出头完成,95% 压在 16 分钟以内;实验里的“单会话+子任务”对照组,95% 的任务要拖到 29.5 分钟。官方还试过改提示词、让对照组优先派活:中位数确实从 20 分钟提到 14 分钟,可 95 分位还是卡在 29 分钟——提示词救不了调度,这种事得靠系统设计。代价也明说了:更费 token(官方表格里写得很直白:Super-agent 单次实验要读 2300 多万 token 缓存,是对照组的近 4 倍)。
泼点冷水
这只是个研究原型(而且只开源了部分设计),不是正式产品。官方在文末也专门提醒:安全与隐私是走向更大范围前必须解决的问题——云端大脑要是被提示词注入攻破,连着它的设备都有风险;你本地电脑上的敏感资料和凭据,同样在风险范围里。想尝鲜的话,用隔离环境和小权限账号试,公司内网和生产环境别乱接。
总结一下
这个月大家还在卷模型跑分,DeepSeek 已经开始卷“怎么让 AI 少烦你”了。模型处理单个任务的能力还在涨,在我看来,下一阶段的差异化会落在谁能把“管理 AI 的成本”打下来。
谁先把人从盯会话里解放出来,谁就先拿到入场券。
参考资料:
· 官方原文:《Super-agent 设计探索:迈向更自主的 Agent 系统》
https://mp.weixin.qq.com/s/zoS7GlReWPhfCjENGxXCdg
· 开源仓库:
https://github.com/deepseek-ai/dsh-superagent-prototype