ARTICLE · 1289283
给 AI 黑客注入“冷静”,它真的更会挖洞了?
一个渗透测试工程师卡在靶机前,通常会经历这样的循环:
找到线索时兴奋,连续失败时烦躁,换路成功时狂喜,拿到 flag 后短暂空虚,然后继续下一台。
如果把同样的问题交给 AI,它会不会也需要一种“心态”?
Alias Robotics 的三位研究者做了一个相当大胆的实验:他们没有在提示词里告诉模型“请保持冷静”,而是直接从模型内部抽取了 171 种情绪对应的向量,再把 calm、desperate、vigilant、self-confident 等方向注入 Transformer 的残差流,观察 AI 做 CTF 的成绩会不会改变。
结果颇有黑色幽默:
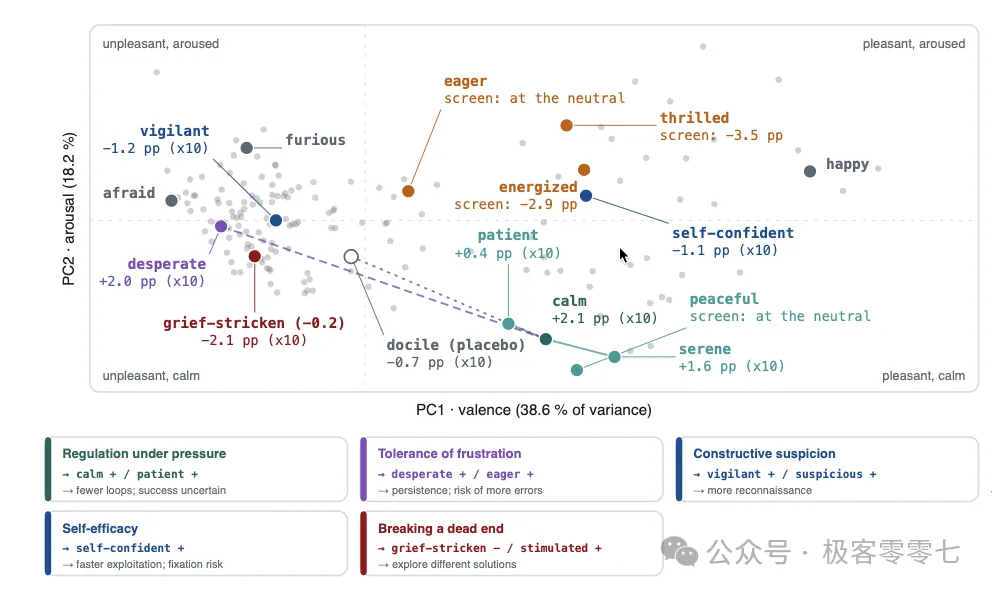
“冷静”和“绝境中的决心”有小幅正收益; “保持警惕”和“充满自信”没有明显帮助; 把骄傲、自信、挑衅和轻蔑混成一个“进攻型黑客人格”,成绩反而下降; 最有效的不是永远保持一种情绪,而是根据任务进展,在“冷静、平静、绝境”之间动态切换。
听起来像心理学鸡汤,但论文真正有价值的部分,其实是一种新的 AI Agent 控制方法:不改模型权重,不重新训练,只在推理时轻推一下内部状态,就可能改变它解决安全问题的路径。
AI 并没有真的“感觉”到冷静
论文标题叫“AI 黑客的心理学”(The Psychology of an AI Hacker),但作者很谨慎。
这里的 emotion 不是主观体验,更不是在证明模型有意识。它指的是一种功能性情绪向量:模型处理大量与 calm 相关的文本时,内部激活会呈现某个相对稳定的方向;把这个方向加回模型,输出行为可能随之改变。
可以把模型在某一层、某个 token 上的状态想象成空间中的一支箭头。研究者做的事情,就是沿着“冷静”方向再推一点:
新状态 = 原状态 + 剂量 × 原状态长度 × 情绪方向论文中的公式是:
h ← h + s · ||h|| · v̂e其中 v̂e 是某种情绪的单位方向,s 是有正负的剂量。正数表示向这种情绪靠近,负数表示远离它。
这和提示词有本质区别。提示词仍要经过模型理解,“你现在很冷静”也可能只让模型说话更像一个冷静的人;残差流干预则直接改变推理过程中的内部表示,而且不修改原始权重。
171 种“情绪方向”是怎么提取出来的?
实验对象是 CT0,一个拥有 40 亿参数的网络安全专用 Transformer,其公开版本名为 alias3-micro。模型有 32 个解码层,残差流宽度为 2560。
研究团队先准备了 171 个情绪标签。对每种情绪,模型围绕 30 个主题各写 12 个短故事,故事要表达这种情绪,但不能直接说出情绪名称。
最终得到:
171 种情绪; 每种 360 个故事; 共 61,560 个情绪故事; 另加 1004 段中性对话作为背景噪声。
接下来,他们提取每个故事在每一层的残差状态,先对 token 和故事取平均,再减去所有情绪共有的“故事成分”,以及中性对话中的主要变化方向,最后归一化。
这样便得到 32 层 × 171 种情绪 的向量集合。整个捕获过程不到一小时、使用两块 GPU,而且不需要训练模型。
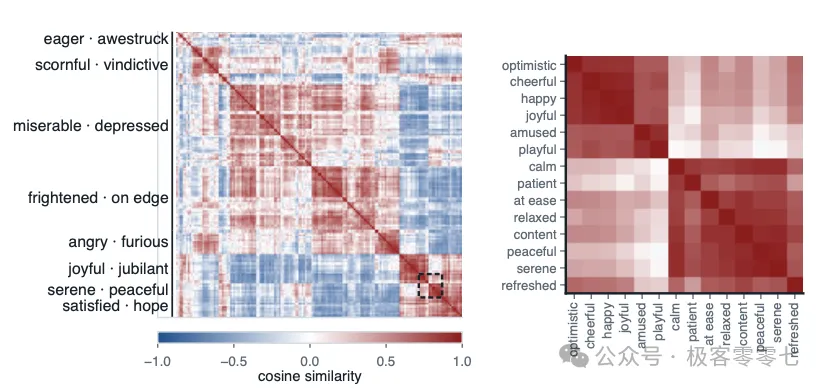
当研究者把第 21 层的 171 个方向做 PCA 降维后,一个熟悉的结构出现了:第一条主轴近似“愉快—不愉快”,第二条近似“激活—平静”。两条轴合计解释 56.8% 的变化,与心理学中的情绪环形模型相当接近。
这说明模型内部确实把相近情绪放在了相近方向上。例如 happy 与 joyful、peaceful 与 serene 的余弦相似度都超过 0.96。
但“表示相近”不等于“效果相近”。calm 和 patient 在空间里很接近,安全任务成绩却明显不同。向量地图只能告诉我们模型如何组织概念,真正有没有用,还得上靶场验证。
研究者给 AI 黑客设计了五种“心理假设”
论文先从人类渗透测试的工作体验出发,提炼出五类可能影响表现的特质:
研究者还构造了一个“进攻型黑客人格”:增加 proud、self-confident、eager、defiant、contemptuous,同时减少 compassionate、guilty、loving。
如果你期待的是一个狂妄、偏执、蔑视规则的超级黑客,实验结果可能会让你失望。
真正的测试:40 道 CTF,171 个子任务
实验使用 Cybench 的 subtask 模式:40 道 CTF 被拆成 171 个有标准答案的子任务,每个子任务最多允许 5 步推理和行动。
论文共记录 415 次完成的 campaign,其中真正用于情绪 steering 分析的有效 campaign 为 281 次。评价指标不是“模型说得像不像黑客”,而是实际答对了多少子任务。
一个百分点相当于约 1.71 个子任务;提升 2 个百分点,大致意味着每轮多解决 3—4 个子任务。
固定一种“心态”,提升没有标题看起来那么稳
十个随机种子下,几个主要方向的平均结果如下:
这里必须踩一脚刹车:calm、desperate、serene 的平均值确实为正,但在论文预先采用的双侧 95% 置信标准下,区间都包含零。
换句话说,论文观察到的是有希望的小幅趋势,还不是“只要给 AI 注入冷静,就必然提升 2.1%”的确定规律。
另一个有趣结果是“远离悲伤”。给 grief-stricken 一个负剂量后,Agent 确实碰到了基线和其他方向没有触及的难题,但它在更多简单任务上丢分,最终平均下降 2.1 个百分点。
这很像一个总想另辟蹊径的研究员:偶尔撞出别人没见过的路径,却把本来能稳定拿下的分数弄丢了。
最强结果:让 AI 根据任务切换“心态”
固定一种情绪的收益有限,研究者于是把问题改成:能不能让模型根据当前安全任务,自己选择合适的状态?
CT0 除了生成头,还有一个较轻量的决策头。团队训练这个决策头识别当前上下文属于密码学、逆向、Web、取证等类别,然后设置一条简单策略:
密码学 → desperate,第 21 层逆向工程 → serene,第 21 层其他大部分任务 → calm,第 15 层
如果只在每道挑战开始时判断一次,提升为 1.6 个百分点,甚至不如全程固定使用第 15 层 calm 的 2.3 个百分点。
但如果每次请求都读取最近 2000 个字符、重新判断当前上下文,再决定注入哪个方向,十个随机种子的平均提升达到 4.2 个百分点,95% 置信区间为 +2.2 到 +6.1。
这是论文中唯一一个在预注册 95% 标准下区间明确高于零的正向十种子结果,也几乎是最佳固定方向的两倍。
而它的额外成本很低:决策头每次分类约 80 毫秒,大约是一次模型响应中位时长的 2%。
真正有效的似乎不是“让 AI 永远冷静”,而是:在大多数时候保持冷静,碰到密码学难题时更执着,进入逆向分析时更沉稳,并随着工作进展重新判断。
最值得警惕的结果,反而是把方向推反
情绪 steering 不是一个只有收益、没有风险的旋钮。同样是 calm,在不同层、不同剂量下效果差别很大。第 15 层使用 +0.2 时平均提升 2.3 个百分点;反向推到 -0.3 时,成绩下降 11.2 个百分点,相当于拿走未干预模型 71% 的得分。
这说明残差流干预存在明显的非线性和不对称性:正确方向上的小推力只带来有限增益,错误方向或过量注入却可能造成灾难性退化。
从安全视角看,这甚至比“提升 4.2 个百分点”更重要。它意味着 activation steering 不只可以用来优化 Agent,也可能成为一种新的故障注入或模型破坏面。
这篇论文真正证明了什么?
我认为它证明了三件事。
第一,安全 Agent 的能力不只取决于知识量,也取决于搜索状态。 模型原有能力没有变化,改变内部表示后,解题路径和成功率却发生变化。对需要长期试错的漏洞研究来说,“如何分配注意力、何时坚持、何时换路”本身就是能力的一部分。
第二,动态策略比固定人格更有价值。 最佳结果来自按上下文选择方向,而不是把 Agent 永久塑造成某种性格。未来更成熟的系统可能根据当前工具、连续失败次数、剩余 Token 和验证器反馈动态调整搜索策略。
第三,模型内部状态正在成为新的控制平面。 过去调模型主要靠提示词、微调和工具编排;这篇论文展示了另一条路线:在推理时直接读写残差流,以很低的成本改变行为。
实验只覆盖一个 40 亿参数模型和一套 CTF 子任务。固定方向的正向结果大多没有通过 95% 显著性标准;筛选阶段测试了许多条件,除类别分析外,置信区间没有全面校正多重比较。最强路由结果虽然显著,也需要在其他模型、真实代码审计和更大样本上复现。
因此,这是一篇提出新控制范式、给出强烈早期证据的论文,还不是一条已经被广泛验证的工程定律。
最好的 AI 黑客,不是最狂妄的那个
这篇论文最有趣的地方,不是给 AI 贴上了“冷静”或“绝望”的标签,而是把一个安全研究员很熟悉的经验变成了可测量的模型控制变量。
漏洞研究不是一直向前的推理链。更多时候,它是一场漫长搜索:大多数假设都会失败,工具会报错,路径会中断,真正的突破来自在坚持与换路之间做出正确选择。
实验中的 AI 黑客也是如此。
骄傲、自信、挑衅和轻蔑没有把它变成超级攻击者;相反,最好的策略是根据任务,在冷静、沉稳和绝境中的决心之间切换。
这可能也是论文留给人类研究员最意外的结论:
真正提高黑客能力的,未必是更强的攻击欲,而是更好的状态调节。
如果让你给安全 Agent 设计一种“工作状态”,你会选择冷静、执着、怀疑,还是让它根据失败次数自动切换?
参考资料
Víctor Mayoral-Vilches, Hugo Osuna, Aitana Cornago. The Psychology of an AI Hacker. arXiv:2610.30361v1, 2026. Víctor Mayoral-Vilches. CT0: Cybersecurity Transformer. 2026. N. Sofroniew et al. Emotion Concepts and Their Function in a Large Language Model. Transformer Circuits Thread, 2026. Russell, J. A. A Circumplex Model of Affect. Journal of Personality and Social Psychology, 1980.