ARTICLE · 1289820
AI 概念学习 · 第 4 期 · 基础篇 | AI 是怎么"学会接龙"的:下一词预测与上下文窗口
长川投研 · AI 概念学习
AI 概念学习 · 第 5 期 · 基础篇
AI 是怎么"学会接龙"的:下一词预测与上下文窗口
2026 年 11 月 1 日 · 约 3400 字 · 阅读 9 分钟
上期回顾:第 4 期认识了两个新词——大语言模型(LLM)是读遍互联网文本、参数上千亿的神经网络,本事是"文字接龙";Token是它眼里的文字积木块,先切块、再编号、才能进网络,还决定了计费、速度和"一次能读多少"。
但当时留了两个悬念:接龙的本事是从哪儿练出来的?还有,为什么 AI 聊得越久,越容易"忘"掉开头说过的话?这一期就补上这两块拼图:下一词预测、上下文窗口——看完你会发现,AI 最神秘的"智能",练习方式朴实得让人意外。
1下一词预测 Next-Token Prediction · 用整个互联网出题的训练法
准确释义下一词预测(Next-Token Prediction)是大语言模型的核心训练任务:把海量文本中每个位置上真实出现的下一个 Token当作标准答案,让模型根据前文给所有候选 Token 打分,再用预测与答案之间的差距(损失)通过梯度下降调整参数。因为文本本身就是答案,不需要人工标注,所以这类训练也叫自监督学习。用这个任务在超大规模语料上完成的训练,叫预训练(Pre-training)——GPT 这个名字里的 P 就是它(Generative Pre-trained Transformer)。第 4 期说的"接龙本事",就是这样练出来的。
大白话解释想象一个学生刷完形填空,但他的题海是整个互联网:
▸ 出题:随手抽一段文章,遮住下一个词——"黄河入海 __"——这就是一道题;
▸ 猜答案:模型给候选词打分:流 78%、舟 9%、水 5%……
▸ 对答案:原文里那个词就是标准答案,是"流";
▸ 改错:猜错了就拧旋钮(第 3 期讲的梯度下降),下次猜得更准一点。
这样的题,一刷就是几万亿道。妙处在出题环节:根本不需要人出题——随便一句话,砍掉后半句,后半句就是现成的标准答案。数据自己带着答案来,这叫"自监督",也是 AI 能吃下整个互联网的根本原因。刷完题海,模型记住的不是某篇文章,而是"话该怎么说"的规律,所以能接住它从没见过的句子。
🌰 举个例子:"白日依山尽,黄河入海 __",模型猜"流"的把握最大——猜对,参数微调一下;换成它没读过的句子"房贷利率又 __ 了",它也能凭规律接出"降"或"涨",而不是抓瞎。其实你天天在用最原始版的下一词预测:手机输入法的联想词(打出"生日快乐"自动蹦出"🎂")、邮箱的自动补全,都是同一套思路的简陋版——只是没练过几万亿道题,接得没那么神。
实际应用场景今天所有叫得出名字的大模型,第一阶段都是这么刷题刷出来的,这一步就叫预训练。新闻里说"某模型用了 15 万亿 Token 训练",翻译过来就是:刷了 15 万亿道完形填空——题海规模直接决定模型底子。预训练完的模型只是个"接龙高手",还不太会"聊天",得再经过一轮调教(这叫微调,第 10 期细讲)才变成你常用的助手。所以业内的行话是两步走:先预训练打底子,再微调学规矩。下次看到"某某公司发布新一代大模型",你就知道:大概率是题海又刷大了一轮。
与已学概念的关联第 2 期那个"猜 → 对答案 → 改"的训练小循环,今天放大了几万亿倍、闭环了:下一词预测就是它的超大规模版本。第 3 期的两个词也都用上了:拧旋钮靠梯度下降,刷题刷得起靠算力与 GPU——几万亿道题,每道都要过上千亿参数的神经网络好几遍,没有几千张 GPU 齐步算根本烧不动。第 4 期说 LLM 的本事是"给下一个 Token 打分",现在你知道这本事是怎么练成的了;而每道题的单位,正是那期讲的 Token。前三期的概念,在这一期全部串成了一条线。
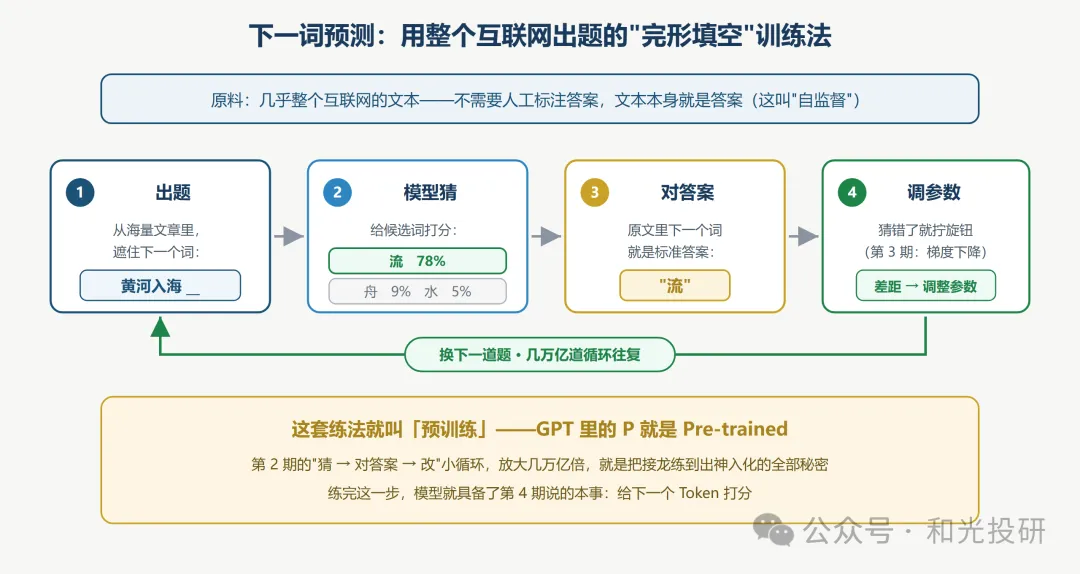
图 1:下一词预测——用整个互联网出完形填空,第 2 期的训练循环放大几万亿倍
2上下文窗口 Context Window · AI 一次能带进考场的草稿纸
准确释义上下文窗口(Context Window)是大语言模型一次处理所能"看到"的最大 Token 数量,包括你输入的全部内容加上它自己生成的内容。模型预测下一个 Token 时,只参考窗口以内的内容,窗口之外的一概看不见。窗口大小以 Token 计量,常见的有 8K、128K、1M 等——128K 就是约 12.8 万个 Token,相当于十几万字。窗口是一道硬上限:超过它的内容,不是"记得模糊",而是物理上无法访问。
大白话解释把 AI 想成一个在考场里答题的考生,上下文窗口就是他桌上那张草稿纸:
▸ 你说的每句话、它答的每句话,都要抄在草稿纸上,因为接下一个词时,它只看纸上的东西;
▸ 纸就那么大,写满了怎么办?最前面写的先被擦掉,腾地方给新内容;
▸ 所以聊得越久,开头的内容越先"掉出纸外"——AI 不是忘了,是那张纸上已经没有了,它根本看不见。
这也顺手解释了一个常见误会:很多人以为 AI"聊得越多越懂你",其实窗口是滑动往前的——它永远只盯着最近那一摊,最早的交情是被挤出去的。
🌰 举个例子:你有没有遇到过——跟 AI 聊了一大段之后问"我最开始说的那个问题是什么",它答不上来或者答错?不是它装傻,是开头那段已经滑出窗口了。再比如你把一本 30 万字的书丢给它说"帮我总结",如果窗口只有 128K(十几万字),这本书根本塞不进去,要么被截断、要么它只读到一部分。"AI 聊着聊着忘了你交代的设定""总结到后面忘了前面",全是这同一张草稿纸在起作用。
实际应用场景上下文窗口是挑 AI 产品时的硬指标:宣传页上的"8K / 128K / 1M 上下文"就是草稿纸的尺寸——想让它读长合同、整本书、一大摞代码,窗口太小就玩不转。很多产品宣传的"AI 长期记忆"功能(记住你的偏好、上次的对话),本质上是绕开窗口限制的手段:把重要内容做成小抄存起来,下次对话再塞回窗口里——因为窗口外的它永远看不见。后面第 9 期要讲的 RAG(检索增强生成),也是同一思路的高配版:与其让它背下整个图书馆,不如先查资料、把查到的塞进窗口再回答。这里先埋个伏笔。
与已学概念的关联第 4 期讲 Token 时说过它决定三件事:计费、速度、还有"一次能读多少"——最后那件,就是今天这个上下文窗口,计量单位正是 Token 积木块。它也接住了第 4 期的"接龙"比喻:接龙时能看到的上文长度,就是窗口的大小。再呼应一句第 4 期反复强调的"它不是答案库":窗口外的东西它真的不知道——不是不想说、也不是故意装傻,是草稿纸上压根没有。以后再遇到 AI"忘事",你就能一眼看穿机制,还能顺手把它安慰好:把关键信息重新贴一遍草稿纸就行。
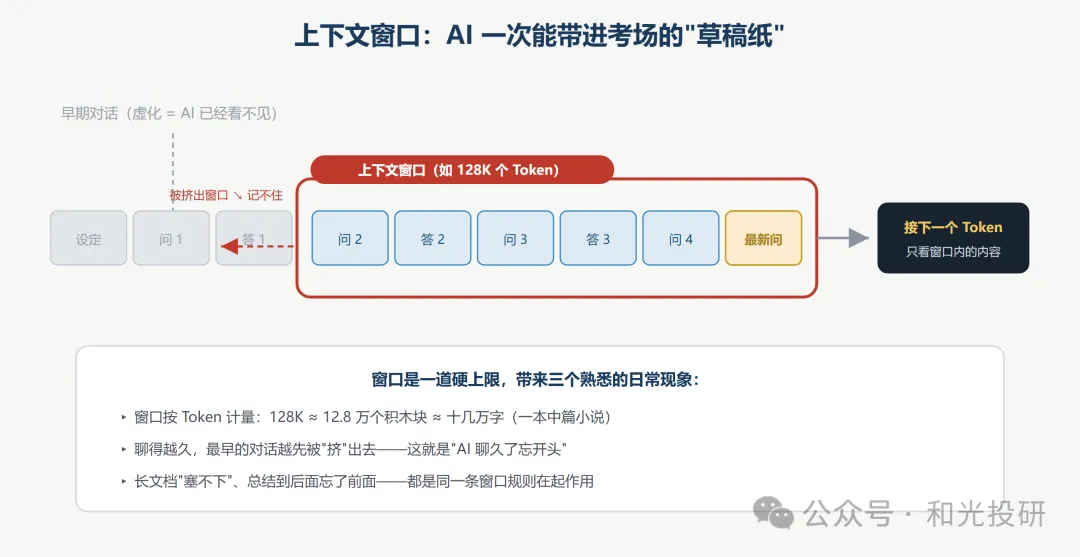
图 2:上下文窗口——AI 接龙时只能看见"草稿纸"上的内容,最早的对话会被挤出
📌 本期小结:一张知识卡带回家▸ 下一词预测——题海:遮住下一个词让模型猜,原文就是答案(自监督),不用人出题。
▸ 预训练——打底:几万亿道完形填空刷出来,GPT 的 P 就是 Pre-trained;底子好 = 题海大。
▸ 上下文窗口——草稿纸:AI 一次能看到的 Token 上限,预测只看窗口以内的内容。
▸ 两个日常现象——聊久忘开头、长文塞不下,都是窗口这道硬上限,是"看不见"不是"记不住"。
▸ 一句话记住:接龙的本事是刷几万亿道完形填空刷出来的;而它接龙时,只能看见草稿纸上的那摊内容。
✍️ 自测两道题(答得出,才算真懂):
1. 训练大语言模型为什么不需要人工标注几万亿条数据?答案从哪儿来?
2. 聊了很久之后,AI"忘了"你最开始说的话——是它记忆力坏了,还是发生了别的什么?
答案:1. 因为用的是"下一词预测"这种自监督任务:把文本里真实的下一个词遮住当题目,原文本身就是标准答案,不需要人打标签。2. 没坏。上下文窗口有限,最早的对话 Token 被挤出了窗口,模型预测下一个词时根本看不到它们——是"看不见",不是"记不住"。
下期预告 · 第 6 期提示词、提示词工程——同一个 AI,为什么别人用得顺手,你却总觉得它答非所问?差别往往不在 AI,而在"怎么问"。下期讲怎么把话说进 AI 心里:什么是提示词,为什么"给角色、给背景、给例子"能让回答质量翻倍,以及"提示词工程"到底是玄学还是手艺。下期见。
往期回顾第 1 期 · 3 个词,理清 AI、机器学习与深度学习第 2 期 · 数据喂进去,模型长出来第 3 期 · 拆开 AI 的大脑:神经网络、参数与算力第 4 期 · AI 怎么就"会说话"了:认识大语言模型与 Token(每周日更新,建议从第 1 期看起,概念前后衔接)
长川投研 · AI 概念学习 · 每周日更新 · 仅供参考