ARTICLE · 1300408
软件测试先别庆祝 AI 写得更多:任务量涨 33.7%,评审中位耗时涨 441.5%
导语
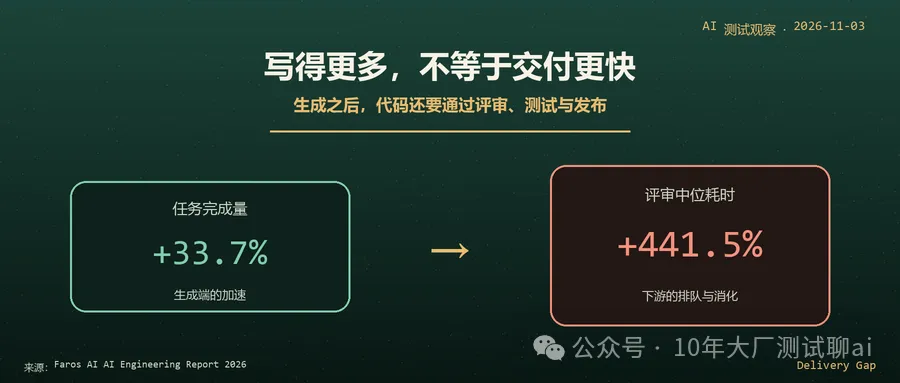
AI 编程让开发者更快完成任务,但 Faros 报告显示,人均任务量涨 33.7%,代码评审中位耗时涨 441.5%。
这篇拆清统计口径,并给出五个验收链指标,帮团队判断 AI 编程到底“写得快”还是“交得快”。
结论先给:AI 代码的价值不由“写了多少”决定,而由它多快走完评审、测试、合并和发布决定。
一、33.7% 的产出增长,被 441.5% 的评审等待吞掉了
Faros AI 基于两年遥测,覆盖约 2.2 万名开发者和 4000 个团队。高 AI 采用团队相比低采用基线,人均任务完成量增长 33.7%。
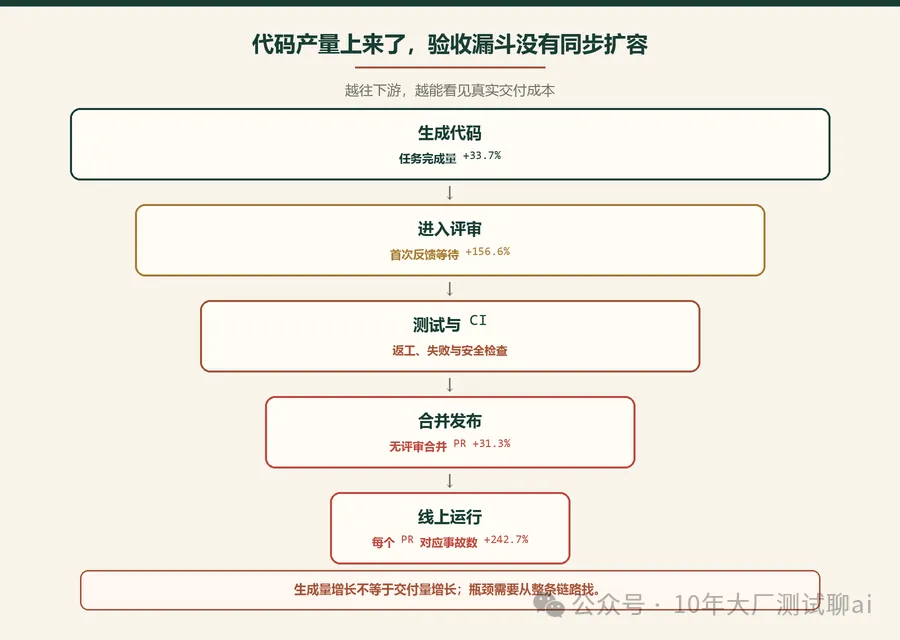
同一批数据里,代码评审中位耗时增长 441.5%,首次评审等待增长 156.6%,平均评审时间增长 199.6%。
还有两项更值得测试和工程负责人警惕:无任何评审就合并的 PR 增长 31.3%,每个 PR 对应的事故数增长 242.7%。
这不是说 AI 自动制造了全部问题,而是说明代码产量上来以后,原来的验收系统没有同步扩容。
二、这组数据是相关性观察,不是“AI 害了交付”的因果证明
报告比较的是高 AI 采用和低采用团队,并不是把团队随机分成两组。团队规模、业务类型、工程文化和统计周期都可能影响结果。
“每个 PR 对应事故数”也不是单次事故概率:一个 PR 可能关联多起事故,事故也未必由最近一次合并直接导致。
因此,正确结论是:随着 AI 采用加深,代码评审、缺陷和事故指标出现了更明显的下游压力,值得团队排查;不能写成“AI 让事故翻了 3 倍”。
作者判断是:这组数字最大的价值,是逼团队停止用生成行数、建议采纳数当 AI 提效成绩。
三、软件测试要把“生成量 KPI”换成“验收链 KPI”
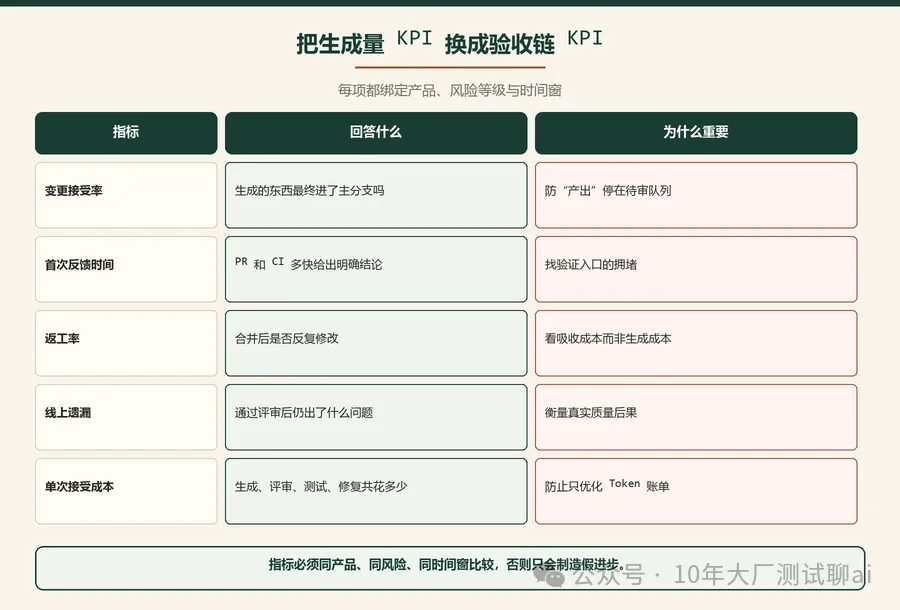
第一项是变更接受率:AI 参与的代码中,最终有多少进入主分支,而不是停在待审队列。
第二项是首次反馈时间:PR 创建到第一次明确审查意见、CI 首轮结果之间隔了多久。
第三项是返工率:合并后固定时间内,同一批文件又被反复修改的比例。
第四项是线上遗漏:通过评审和测试后才发现的缺陷、漏洞和事故。
第五项是每次被接受变更的总成本:不只算生成 Token,还要算评审、测试、返工和故障处置。
这些指标必须和同一产品、同一风险等级、同一时间窗对比。拿低风险文案修改的接受率,去对比支付链路变更,只会制造假进步。
四、30/60/90 天要改善的是反馈回路,不是简单加人审
前 30 天先建立基线:把 AI 编写变更的接受率、首次反馈、合并耗时、返工和线上遗漏放在同一张表里。
接下来 30 天把检查前移:在提交前跑静态检查、测试影响分析、安全扫描和明确的质量门槛,让问题尽量在 PR 排队前暴露。
最后 30 天再评估自动修复和规则优化,观察每次被接受变更的总成本是否下降,而不是只看到 PR 数量上涨。
边界也很清楚:缩短评审时间不能靠取消评审,自动化也不能靠一个 AI 去批准另一个 AI。支付、权限、数据删除等高风险变更,仍需要明确的人类责任人。
结语:AI 写代码的速度可以按秒提升,团队吸收代码的速度却按流程增长。软件测试真正要守的,是生成速度与验收能力之间的平衡。