ARTICLE · 1304110
免费开源、可本地运行,这个AI语音工具夯爆了!
最近逛 GitHub 的时候,找到一个有点东西的开源项目。
简单来说,就是把一整套AI语音工作室,直接部署到你的电脑本地。
不用充会员,不用传录音到云端,甚至连独立显卡都不是刚需。截至目前已有近100k星标,涨势猛得离谱...
项目地址:github.com/debpalash/VoiceStudio
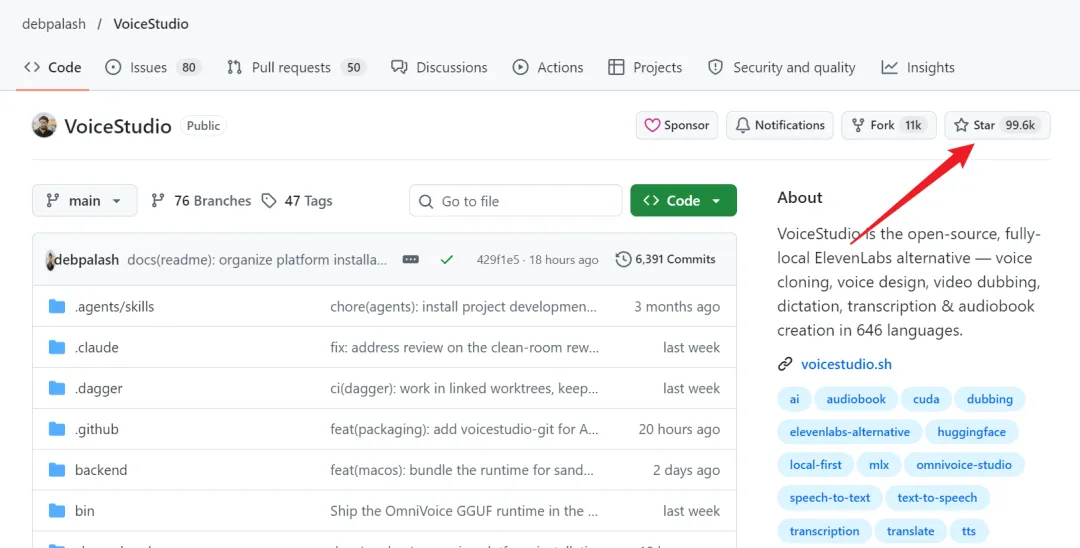
它就是VoiceStudio,一个完全本地运行的全功能音频工作台。
可能有人会问,这不就是个AI配音工具吗,至于这么火?还真至于。
市面上的语音工具不少,但大多是:想克隆声音要找克隆工具,想视频配音要用配音工具,想转文字又得用转换软件。
来回切换账号不说,你的录音、文案、视频素材,全都要上传到别人的服务器上,钱花了不少,隐私还没个兜底。
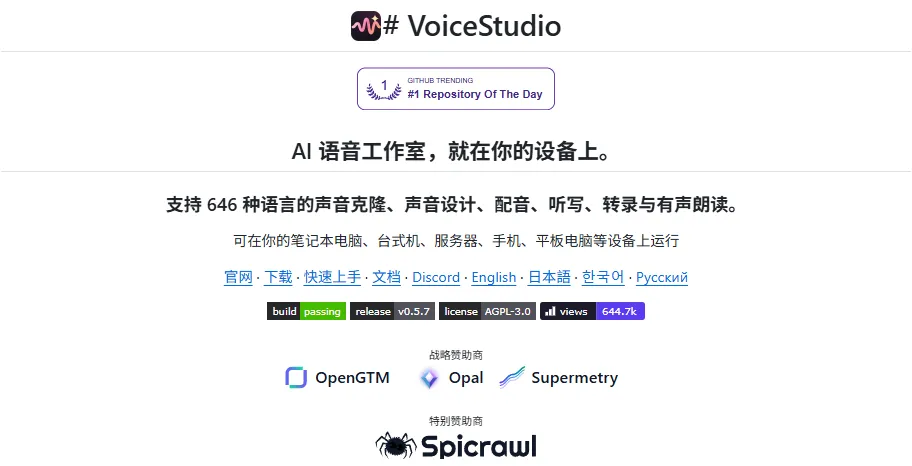
VoiceStudio的思路就很实在:把常用的语音能力全打包进一个桌面软件里,而且全程在你自己的设备上跑。
核心功能拢共四大块:声音克隆、文字转语音配音、视频配音对齐、语音转录听写。
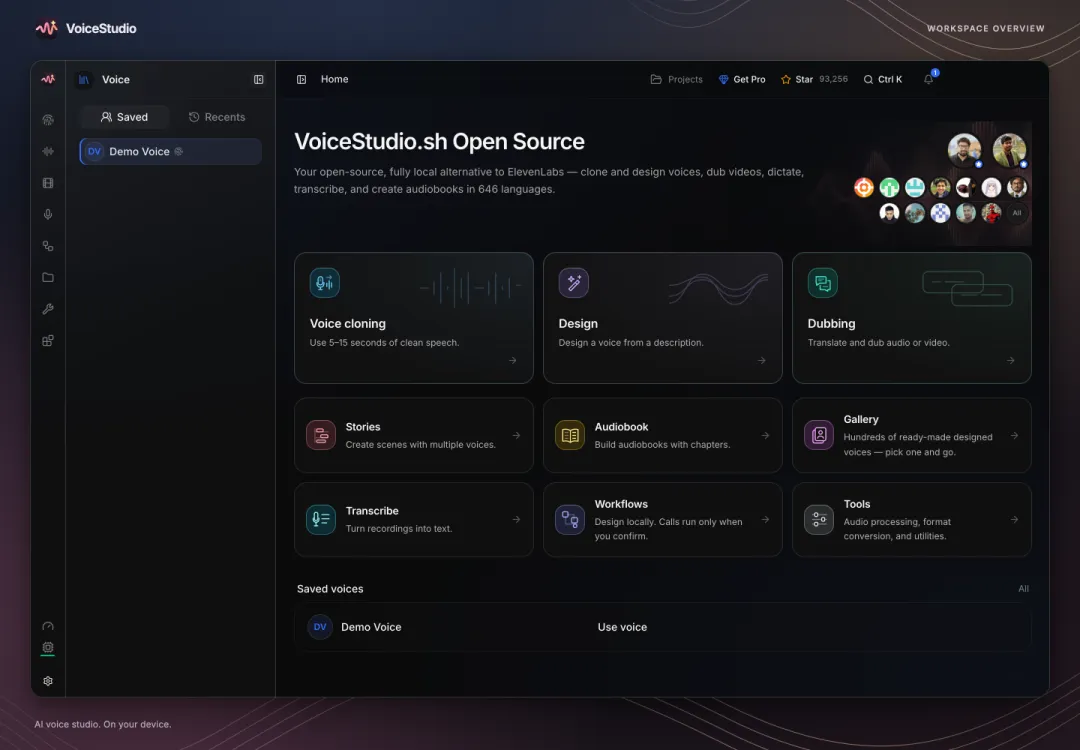
且支持646种语言,很多冷门小语种也能覆盖到。
Windows、macOS、Linux全平台都能用,没独立显卡也没关系,CPU也能跑,就是生成速度会慢一点。
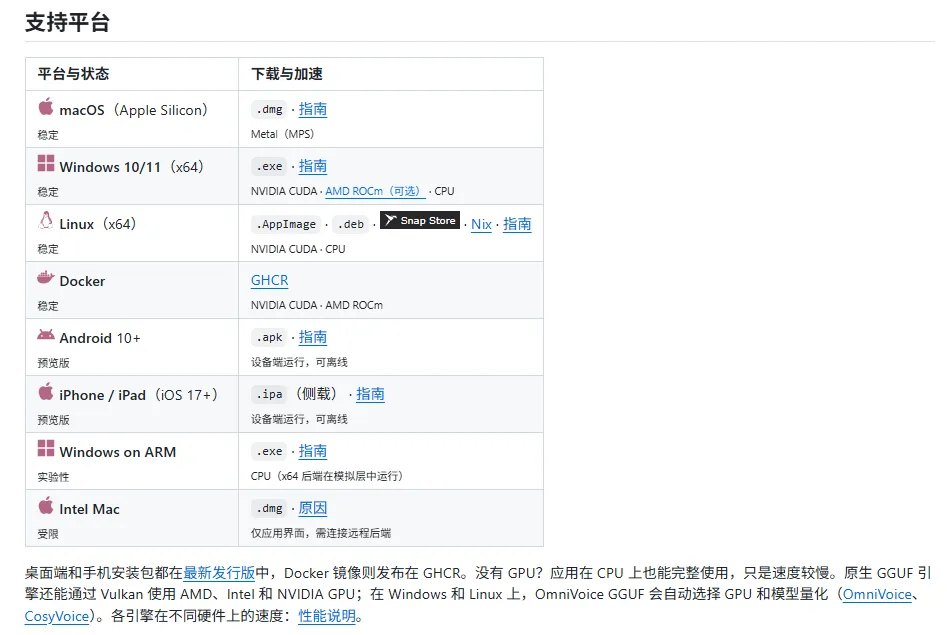
最关键的一点:所有模型、所有生成过程、所有你的素材,都只在你本地里,不用怕录音泄露,不用怕素材被拿去训练模型,隐私这块直接拉满。
挑几个我觉得最实用的点,跟大家聊聊。
1、本地声音克隆
之前试过不少在线克隆工具,效果参差不齐就算了,上传自己的录音总有点心里打鼓。
毕竟声音这东西,跟人脸一样,属于很私人的生物特征,谁也不想自己的声音被拿去乱用到别的地方,对吧?
VoiceStudio的克隆完全在本地完成,你只需要准备一段干净的参考录音,导入进去,模型就在你电脑上训练生成。
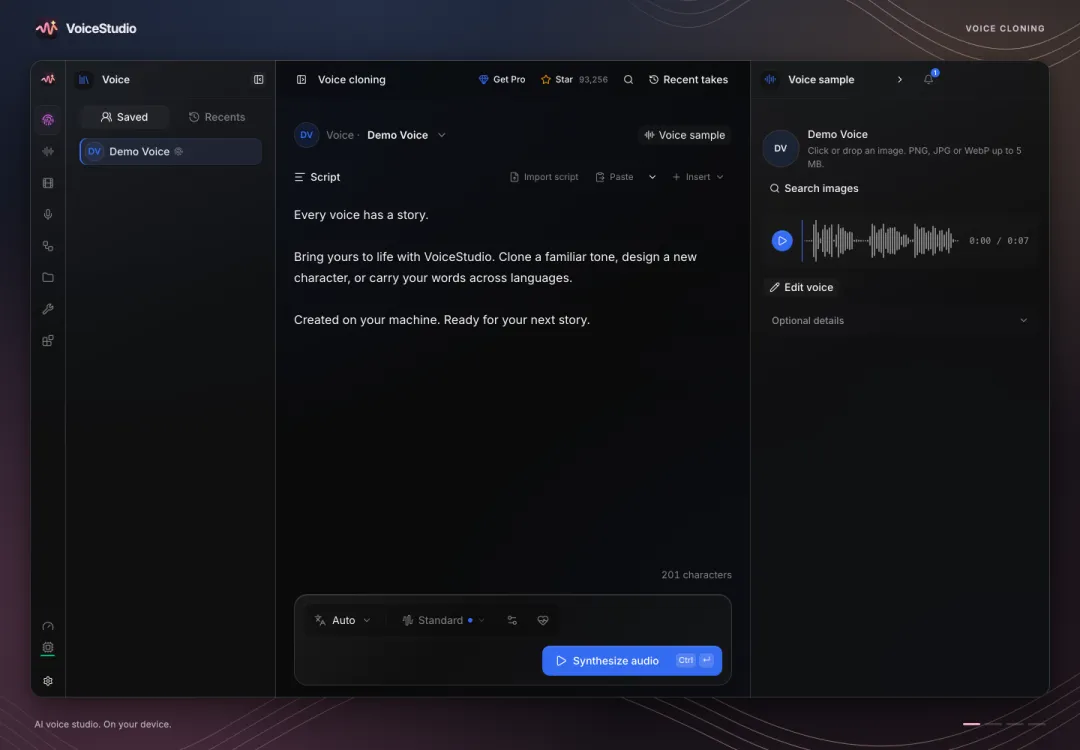
生成好的音色模型也存在你本地,下次打开软件直接调用就行。
我自己随手录了一段30秒的日常说话内容试了试,读出来的效果不能说百分百一模一样,但语气、音色、甚至说话的停顿习惯,还原度都超出了我的预期。
日常用来做配音、念稿子,完全够用,关键是全程没联网,录音文件从始至终没出过我的电脑。
2、视频配音自动对齐
做过视频二创、译制的朋友都懂,最头疼的不是生成语音,是把新音频跟原画面嘴型对上。一句一句拖时间轴,调来调去差个零点几秒,能把人搞崩溃。
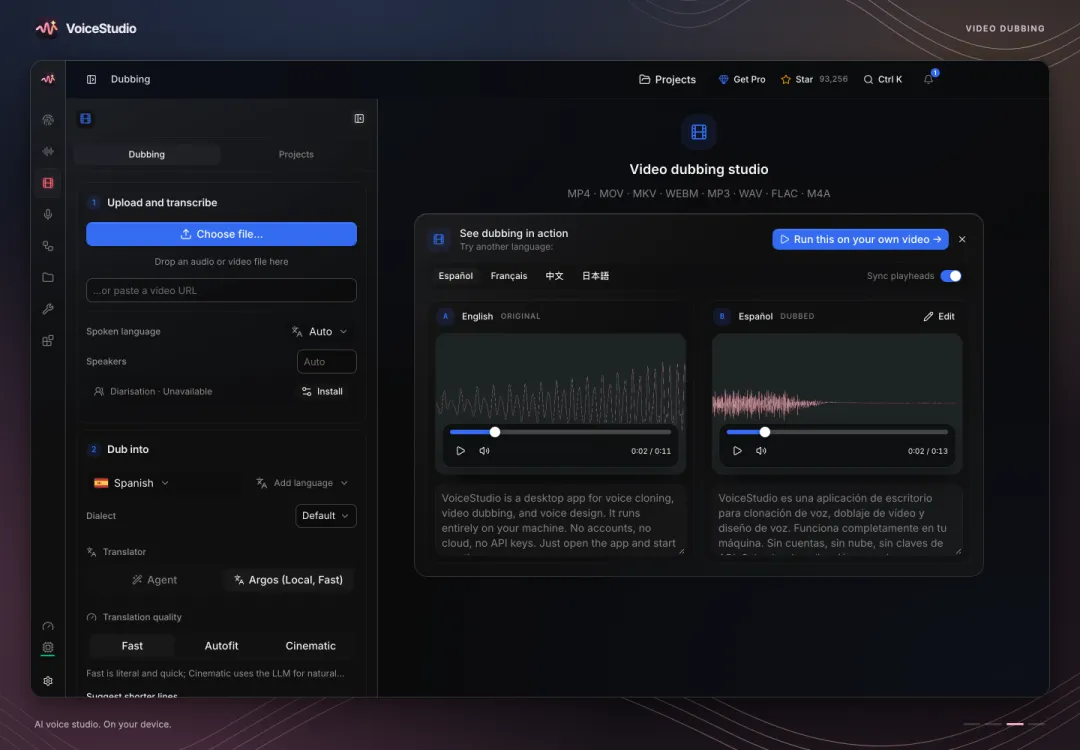
而这个工具的视频配音功能,会自动让生成的语音尽量对齐原片的说话时长。
导入视频,输入文案,选好音色,它会自己调整语速和停顿,尽量卡准原片的时间点。
虽然做不到百分百严丝合缝,但能省掉大半手动对齐的功夫。做搬运译制、多语言配音的朋友,这个功能真的能省不少时间。
3、批量长文本生成
如果需要生成很长的有声书、故事音频,它也支持批量任务处理。不用守在电脑前一句一句生成,把整段文本导进去,选好音色,挂着后台跑就行。
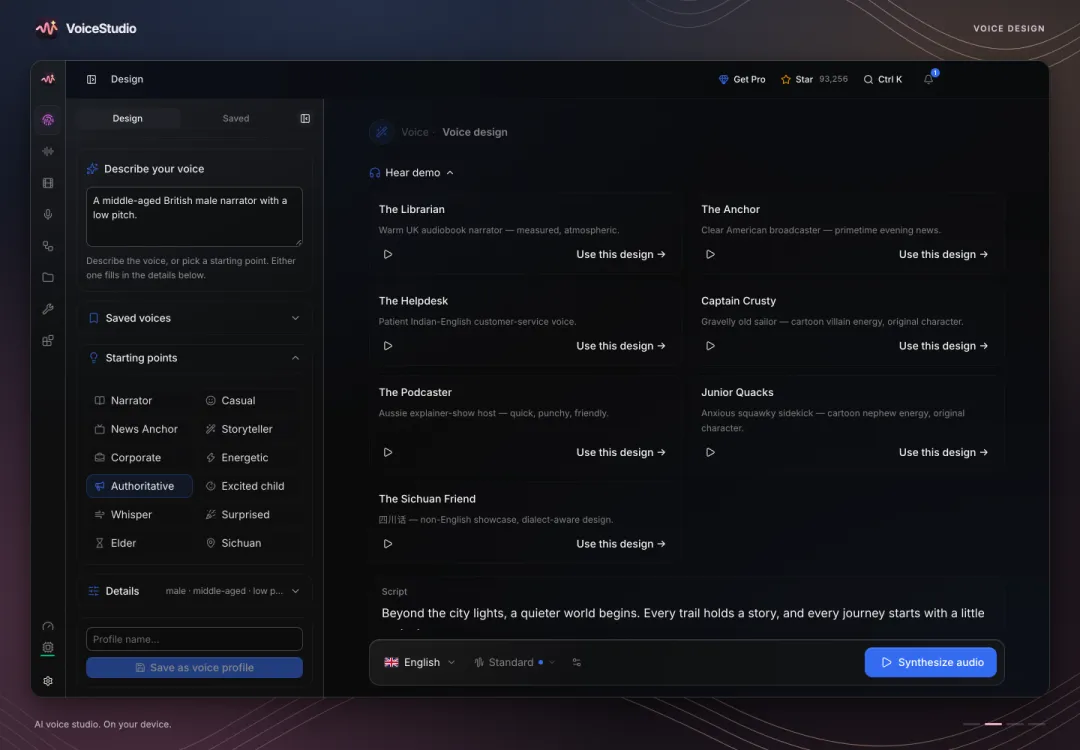
对于做有声内容、课程录制的人来说,这个批量功能能把效率提一大截,不用盯着页面等生成,该干嘛干嘛去,回来直接拿成品。
4、模型管理器
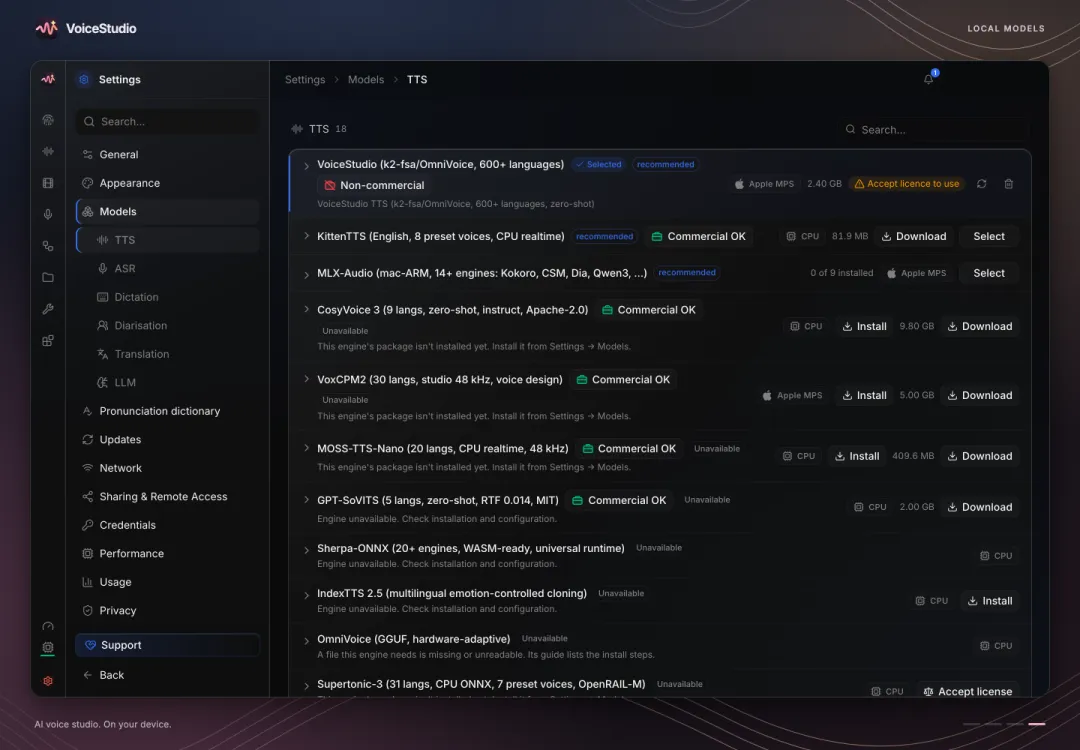
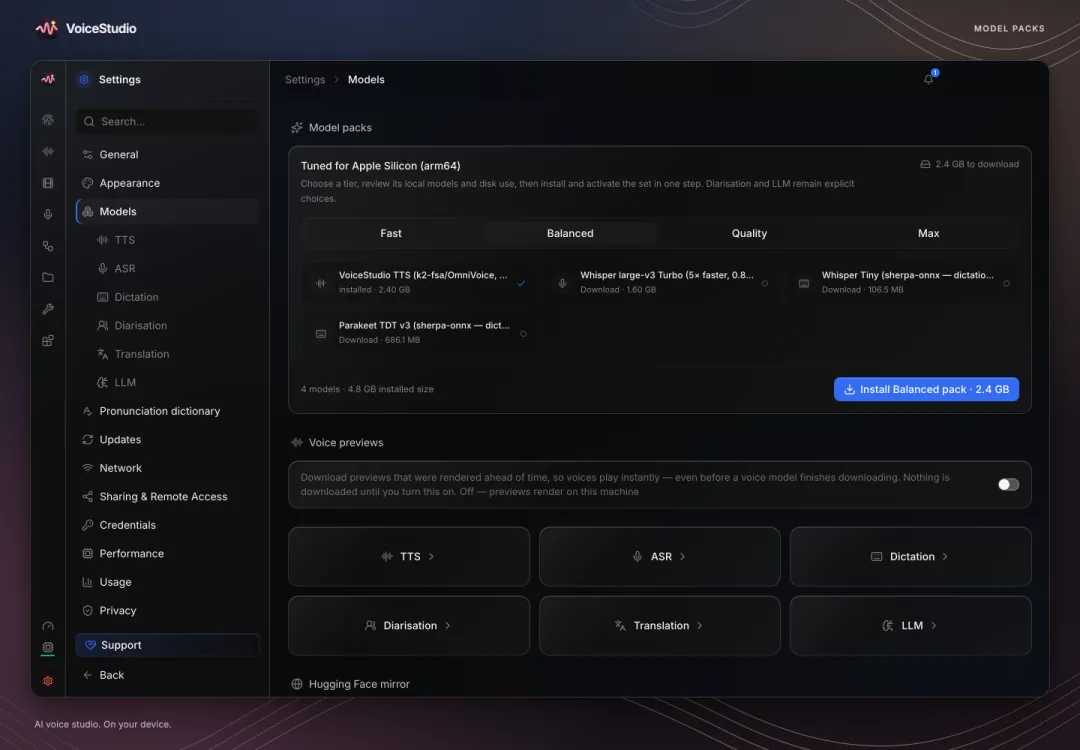
它不是一股脑把所有模型都塞给你下载。你想用什么语言、什么风格的模型,按需求下载就行,不用白白占掉几十G的硬盘空间。
不同效果的模型可以自由切换,想用哪个加载哪个,对小硬盘用户非常友好。
项目是完全开源的,直接在官方仓库地址进行下载就可以。
进去之后找release 版本,对应自己的系统下载安装包就行,安装很简单,一路下一步。
最后给大家两个实打实的小建议:
1、第一次用,先下个小模型试试水,不用上来就下最大的,先感受下效果合不合自己需求。
2、没有独立显卡也能跑,就是生成速度会慢一些,耐心等等就好,效果是一样的。
也不用想着把所有功能都玩明白,大多数人其实用得最多的就是配个音、转个文字,挑自己需要的功能用就行,不用有必须全学会的负担~
说实话,我自己日常常用的也就两三个功能