ARTICLE · 1311925
AI时代,只要你学得够慢,你就不用学了?为什么新工具层出不穷,旧优势却越来越难守住?|《演算》万字深度报告 Vol.06
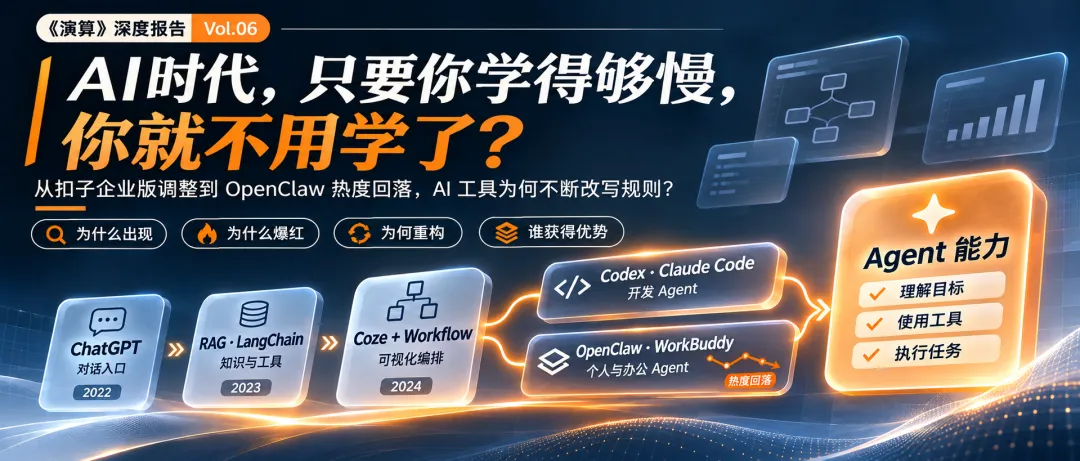
为什么新工具层出不穷,旧优势却越来越难守住?
《演算》万字深度报告 Vol.06|2026年11月5日
今年春天,网上流传一句话:“AI时代,只要你学得够慢,你就不用学了。”这句话击中了不断变化的学习成本,却还没有回答最尖锐的问题:早学的人失去了什么、保留了什么?一家企业怎样从优势走到失去定价权?当技术创造本身也能由 AI 参与,下一轮竞争将发生在哪里?
2026年10月29日,扣子宣布分阶段下线现有企业版套餐。两年前,能够拖拽节点、连接模型和工具,就足以让一个普通团队做出自己的 AI 助手;如今,AI 已经开始替人编写代码、调用软件,甚至参与开发下一代 AI。
同一个月,腾讯元器确认将于11月9日停止服务。腾讯却在10月29日进一步展示 WorkBuddy 的企业级工作能力。一个曾以“人人创建智能体”为卖点的平台准备退场,另一个让智能体直接进入工作环境的产品加速前进。
在美国,Codex 和 Claude Code 把代码补全推进到任务执行;开源的 OpenClaw 把智能体带入个人电脑和消息入口,经历爆红之后,真正的考验转向授权、稳定运行和维护成本。模型公司也没有站在变化之外:OpenAI 的 Assistants API 已在今年8月退役,研发团队开始让 AI 参与代码、实验和算法优化。
看似只是几条产品新闻,背后却是一次产业分工的迁移:过去值得专门学习、购买和开发的能力,越来越多成了下一代系统自带的功能。但问题并未消失。企业仍然需要流程控制、数据权限和结果验收;软件仍要长期维护;新的工具又把竞争引向新的难题。
要理解2026年,先得弄清过去四年每一代工具为什么会出现、为什么当时有效,以及后来究竟哪个条件改变了。
摘要
从 GPT 到 ChatGPT,从提示词、RAG、LangChain 到 Coze、OpenClaw 和 Codex,过去几年每一代 AI 工具都解决了前一代留下的难题。模型更强、接口更统一、执行更自主,使曾经稀缺的能力逐渐成为标准配置,竞争随之转向可靠交付、真实业务和成本控制。
技术让能力越来越便宜,市场却会重新决定这项能力值多少钱。这篇报告追踪技术为什么诞生、怎样建立优势、后来何以改变,并分析知识、工作、企业利润与下一轮创新将如何重新分工。
2026年最值得研究的信号:扣子企业版调整,工作流失去的是哪一部分优势
扣子的公告很具体。企业标准版和企业旗舰版从2026年11月30日起暂停新客户购买;通过火山引擎购买的旧版部分套餐于2026年12月31日下线;新版企业套餐最晚在2027年12月31日全面下线。官方同时表示,后续企业方案仍在规划,资源导出安排将另行发布。
公告涉及现有企业版套餐,扣子编程及其工作流仍然存在。Coze 一直把低代码 Workflow、知识库、插件与智能体放在同一平台里;今天发生变化的,是企业为什么需要购买这样的平台,以及愿意为哪部分能力付费。
两年前,模型能回答问题,却难以按照固定的业务步骤可靠执行。可视化工作流让开发者决定什么时候检索、什么时候调用工具、如何判断条件、如何返回结果。把原来靠代码编写的流程压缩为节点和连线,一度大幅降低了产品搭建门槛。它的流行有充分的工程理由。
后来,模型能更准确地调用工具,编程 Agent 可以生成或修改连接代码,新的工作型 Agent 可以在授权范围内自主选择执行步骤。用户不必再为每个探索性任务亲手画一套流程。被压缩价值的是“人工搭建流程”这一部分;高确定性的审批、记账、权限控制与审计步骤仍然需要明确的工作流。
曾经,“把模型接起来”就足以形成卖点;今天,客户要的是在组织内部持续交付、失败后能恢复、关键结果有证据。元器将退出服务,WorkBuddy 则把执行能力推向办公场景。两款产品的分化,把智能体市场的下一道门槛摆到了台前。
扣子的故事是开端。要看清它,必须从模型自身过去究竟做不到什么讲起。
GPT 最先改变的,是每做一件事都要重新训练的旧规则
在通用大模型出现以前,机器翻译、情感分类、搜索排序、信息抽取各有成熟的技术路线。大型企业把不同模型部署进不同业务,往往需要不同的数据、工程团队和维护流程。许多模型能够迁移学习,并非所有任务都要从零训练,但为每一种新需求单独适配和维护模型,仍是一项显著成本。
2018年的 GPT 把一种思路往前推进:先在大量无标注文本上训练通用语言表示,再将能力迁移到具体任务。到了2020年的 GPT-3,研究者发现,模型甚至可以通过自然语言指令和少量示例完成不少新任务,而不必每换一项任务就重新微调。
真正改变产业账本的,不只是准确率提高。过去,一笔模型训练投入主要服务于一个或几个任务;现在,大规模预训练投入有机会分摊到写作、分类、问答、代码等大量需求上。一套基础能力获得越多使用场景,围绕它建设基础设施就越划算,它获得的数据与市场反馈也越多。
这解释了为什么 GPT 路线能够建立强大的竞争优势,也解释了为什么它会冲击原有专用方案:通用能力一旦足够好,用户就要重新问,为这个具体任务维护一整套专门系统,还值不值?
专用模型仍在极低延迟、受限硬件、特定数据等场景发挥作用。但越来越多任务开始先问:现成的通用模型是否已经足够好?原来必须定制的能力,逐渐变成可以随时调用的能力。
接下来,一个曾经只能通过论文、API 和开发者工具接触的技术,突然找到了所有人都能使用的入口。
一个聊天框震动世界,为什么还养出一整条工具产业链
2022年11月30日,ChatGPT 把这条技术路线推到了更广泛的人群面前。它把获取 AI 能力的入口变成了自然语言对话,使用门槛因此发生了巨大变化。
过去,调用一种专业能力,常常意味着学习一套软件、找一个服务商或接入一个 API。聊天窗口改变了第一步:先把目标说出来,系统给出一个结果,再通过反馈调整。复杂模型仍在背后运行,但使用者不再需要逐个了解其内部实现。
聊天框把通用模型能力变成了容易尝试的日常产品。写作、分析、代码、翻译、检索、教育,过去分布在不同软件里的任务,开始被用户放进同一个对话框比较。
ChatGPT 改变的不仅是产品形态,还改变了“获得一项能力”原本需要付出的学习成本。下一轮行业繁荣,也正是从模型不能完成的那些工作开始的。
不过,2022年的聊天框并不能替用户完成所有事情。越多人想把它用进真实工作,越快撞上它当时的能力边界。
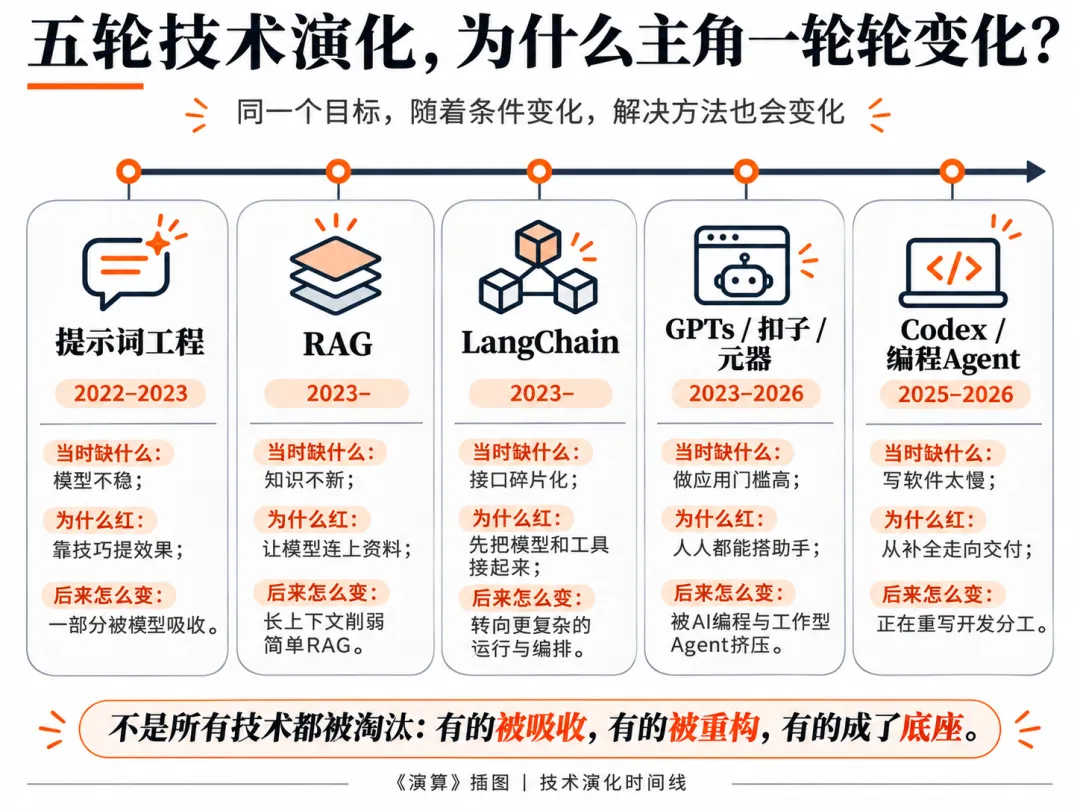
提示词工程当年为什么值钱,后来哪些价值被平台接走
2023年,提示词工程迅速从开发者经验变成课程、模板和商业服务。当时,一套有效的提示词可以显著改善模型的任务表现,减少反复调整和返工。
原因并不神秘。早期对话模型能写出令人惊讶的内容,却经常误解任务、遗漏约束、输出格式跑偏。同一条要求,换一种措辞就可能得到明显不同的结果。开发者需要让这种不稳定的能力进入产品,便把示例、角色、分步说明和输出格式组合成可重复使用的指令。对服务商而言,这意味着更少返工;对团队而言,意味着可以把个人经验固定进流程。
到了2023年,Function Calling 把一个关键环节从“请模型按某种格式写出函数名和参数”,变成了有明确接口的调用方式。2024年的 Structured Outputs 进一步提供了按指定 JSON Schema 输出的严格模式。原来需要反复试探措辞、解析自由文本才能实现的一部分功能,进入了正式的软件接口。
大量依靠经验摸索的技巧,被标准化为正式接口。过去靠特定咒语让模型吐出结构化数据,后来可以用接口约束输出;过去需要许多例子才能教会的表达习惯,后来可能成为模型指令遵循的默认能力。
提示词仍是生产系统的重要配置,却越来越难靠某些固定的词句形成壁垒。更有价值的工作转向任务定义、异常处理、版本回归测试,以及对结果好坏的持续评价。记住一版模型的特殊脾气,开始让位于管理不同模型的稳定表现。
提示词的兴起与转型揭示了第一种变化:一门手艺里能够标准化的部分,迟早可能变成产品的默认功能。
很快,更大的困难出现了。模型听懂了要求,却不知道企业昨天刚更新的制度、库存和合同;它有世界知识,却缺少当前工作所需的事实。于是下一轮工具围绕“给模型找资料”生长出来。
RAG 没被长上下文淘汰,真正失去优势的是哪一部分
2023年,一个企业想用大模型回答内部问题,常见方案是把文档切成小段,转成向量,存进数据库,提问时检索相关片段,再把片段交给模型生成回答。这套方法被称为 RAG,即检索增强生成。
它为什么迅速流行?因为当时有三道现实障碍:模型的训练知识不包含企业最新文件;上下文窗口有限,无法随意塞入资料;企业还需要知道答案依据来自哪里。RAG 并没有让模型重新学习全部知识,却能让旧模型利用新材料完成工作。向量数据库、文档切分、检索和重排序因此形成了新的工具市场。
随后局面变了。长上下文模型可以直接读取大篇幅合同、代码仓库与报告;模型平台也将文件搜索做成托管工具。对于资料规模有限、更新不频繁、一次性使用的任务,曾经必须搭建的切分、索引、向量检索、召回服务,现在可能完全不值得维护。
上下文窗口再长,企业仍要解决哪一份是最新版本、谁有权限看、依据能否追踪、每次查询花费多少。2024年发表于《Transactions of the ACL》的《Lost in the Middle》还发现,模型即使支持长上下文,也可能因关键信息在文本中的位置不同而表现不稳。
由此出现了更清晰的分工:少量确定资料可以直接放进上下文;巨大且不断更新的知识库需要检索与权限管理;复杂研究则结合搜索、长上下文和多轮验证。
早期 RAG 产品最容易被压缩利润的部分,是标准化的“上传文档、切片、向量化、回答”流水线。没有被压缩掉的,是组织知识的质量、更新机制、权限和评测。会搭一个知识库,曾经是交付;如今只是进入真实知识系统的第一步。
知识库的生意,从“把文档喂给模型”,逐渐转向“让组织的知识长期可信、可用”。同样的迁移也发生在开发框架里。
LangChain 为什么成功,后来又为什么不得不重做自己
2022年秋天,Harrison Chase 发布第一版 LangChain。根据他三年后自己的回顾,最初只是一个约800行的 Python 开源项目。那个时期,用语言模型做实际应用,开发者需要分别处理提示词、模型接口、检索、数据源和工具调用。把这些重复劳动打包,写几行代码就能跑起来,是一种直接而有价值的突破。
它迅速流行,原因还有第二层。当时模型供应商、向量数据库和各类工具都在高速变化,谁也不确定哪一种会长期领先。LangChain 提供相对统一的接法,开发者可以在不同模型与工具之间切换。它卖的不只是省几行代码,更是降低试错与迁移成本。
但原型越容易做,开发者越快走到原型之外。一个演示只需要串起几次模型调用;一项持续运行的企业任务则要回答:中途失败怎么办?一小时后如何恢复?用户什么时候可以介入?每一步如何追踪?谁记录运行状态?早期的高层封装,恰好可能遮住这些细节。最初帮助开发者少看底层的设计,到了生产环境,反过来成了调试成本。
因此 LangChain 逐步发展出 LangGraph 等运行层,用于持久化执行、循环、恢复与人工介入;商业产品也向 LangSmith 的观测、评价和管理能力延伸。到2025年的 LangChain 1.0,团队又把简单的 Agent 开发体验与底层运行时组合起来。
LangGraph 成为 LangChain 的重要运行底座。开发原型越来越容易,生产环境中的状态、恢复、观测与调试却越来越关键。LangChain 从大量集成与模板起步,逐步把精力转向 Agent 的长期运行。
OpenAI 自己也经历过类似转变。早期 Completions API 适合文本续写;Chat Completions 适合多轮对话;Assistants API 尝试加入文件、线程和托管工具。但 OpenAI 在2025年解释推出 Responses API 的原因时直言,Assistants 的接口设计限制了采用,而新的推理模型与工具链需要统一的运行方式。Assistants API 已在2026年8月26日退役,Chat Completions 则仍受支持。
这三个接口代表三种不同时期的工作单位:续写一段文本 → 回应一次对话 → 在多个步骤里思考、调用工具并完成任务。旧接口退出有技术能力变化,也有产品设计和生态迁移成本的原因,并非因为旧用户的需求突然消失。
当行业还在解决如何让开发者更快做出应用时,另一批产品把门槛进一步降到了不必亲自写代码。
为什么同一个任务,过两年就需要另一套工具?
模型每增强一项能力,开发者就少做一部分重复劳动,同时又要承担下一层更复杂的工作。
一项能力进入基础平台,原来的专门工具就要重新寻找收费理由。接下来 LangChain 的经历,把这个过程展示得尤其清楚。
从 GPTs、扣子到 WorkBuddy:当“创建助手”不再是终点
2023年11月,OpenAI 发布 GPTs,允许用户用自然语言、参考资料和能力开关创建特定用途的助手。2024年前后,扣子、腾讯元器等平台把这一方向向前推进:可视化工作流、知识库、插件、发布渠道,构成了从试验到分发的完整路径。
为什么它们能成功吸引市场?因为当时真正稀缺的是“做出一个可用 AI 应用的能力”。普通公司既缺模型工程师,也缺时间逐个连接接口。一个编辑器、一组模板、一套发布渠道,就能把创建和试错成本压下来。平台聚集更多开发者与插件,生态优势又反过来吸引新用户。
到了2026年,变化不是市场突然不需要 Agent。变化发生在用户购买的工作单位。最早,用户需要一个“自己的 AI 助手”;后来,他希望这个助手能够自动查询资料、操作系统、跨越多个软件完成任务;再后来,他希望在已有办公软件里交代目标,不必先打开编辑器设计完整流程。
这就是独立创建平台面临的新竞争:AI 编程工具可以直接生成定制应用,模型平台可以托管部分搜索和工具调用,办公软件把 Agent 直接接入企业账号、文档、消息和权限。腾讯的 WorkBuddy 与企业微信在2026年10月加深整合,就是一种典型方向。用户原先要把企业数据搬进智能体,现在智能体试图进入企业本来就在工作的地方。
产品命运于是出现分叉。腾讯元器公告将于11月9日停止服务;扣子公告的是现有企业版套餐分阶段下线,不是整个 Coze 品牌停服;OpenAI 则已宣布计划于12月11日退役自定义 GPTs,迁移到 Plugins。关停、套餐整合和产品迁移,性质各不相同,却都要求旧入口重新证明价值。
审批、财务核对、审计等业务仍然需要明确流程;探索性研究与复杂编码则越来越多交给 Agent 动态规划。人为编排的流程正成为 AI 可以辅助生成、选择和修改的对象。
因此,市场上至少存在三种不同的生意:卖创建工具,卖运行与治理平台,或直接卖最终工作结果。它们曾经看起来同属“智能体赛道”,客户却越来越按不同标准付费。卖搭建便利的产品,面临创建门槛下降;卖执行结果的产品,必须真正解决可靠性、权限和责任问题;卖基础设施的平台,则要让大量不同的 Agent 长期运转。
三种商业模式所争夺的收入不同,成功的条件也随之分化。
MCP、Skills 和 Agent:一轮淘汰之后,为什么又出现新的概念
模型本身越来越强,开发者却继续发明协议、能力包和运行框架,乍看很矛盾。可把业务放回真实环境,就能看到下一道障碍:模型能理解“查客户合同”,不等于知道合同在哪个系统;模型会调用工具,不等于天然了解公司的权限和工作规程。
最初,每家应用为每个数据源写连接代码。一家公司同时使用搜索、文档、CRM、日历和代码仓库,不同模型要访问这些系统时,往往重复开发。Anthropic 在2024年11月推出 MCP,试图统一模型连接数据与工具的协议。它解决的是每接一个系统都要重新造接头的成本。
协议普及后,问题又换了位置。连接一百个工具不等于智能体知道何时使用哪个;把所有工具说明都塞进上下文,还会增加延迟与调用成本。Anthropic 后来讨论过这类问题,并提出通过代码执行等方式提高工具利用效率。
Agent Skills 则试图解决另一种缺口:即使已经连接到工作环境,智能体仍需知道如何完成某一类专业任务。它把说明、脚本和参考资料整理为可复用的能力包。MCP 负责标准化连接,Skills 封装可复用的工作方法,Agent 则根据目标组织执行。三者共同支撑了新的工作系统。
当连接层标准化后,手工接接口的溢价下降,专业数据、工作规程、权限管理与故障恢复开始体现差异。
标准化连接降低了开发成本,也把 Agent 的运行、授权和持续交付推到了台前。OpenClaw 的走红,让这道门槛第一次进入了更广泛的公共视野。
OpenClaw 为什么引爆热潮,热度回落后留下了什么
2026年初,OpenClaw 引发了一轮个人 Agent 的安装和部署热潮。它把此前分散的模型、消息入口、工具调用和本地执行组合在一起,让“让 AI 替我办事”第一次以开源项目的形态触达了大量用户。
安装教程、部署服务和产品封装随之出现,用户尝试让它读取任务、操作软件、管理文件,并根据反馈继续工作。热度不仅来自模型又能做什么,更来自过去需要打开多个应用才能完成的操作,开始有了统一的执行入口。
但从“演示能跑”到“每天稳定帮人干活”,中间隔着很长一段工程距离。一个会执行命令的 Agent,必须处理授权范围、敏感凭据、工具出错、调用费用、长时间运行,以及任务失败后的恢复。OpenClaw 的关注度从年初高峰回落,代码仓库仍在更新。能够演示是一回事,成为日常可靠服务,还要付出长期的工程和运维成本。
Codex 集中解决代码仓库里的软件工程任务,OpenClaw 更强调个人环境中的跨工具执行,WorkBuddy 则进入企业办公系统。相似的 Agent 能力,在不同场景里要跨越的门槛完全不同。
OpenClaw 留下的真正问题是:当 Agent 已经能完成一场演示,谁能把它变成长期、可控、有人愿意付费的服务?热潮只是需求显形的一刻,随后的运营和经济账才决定产品能走多远。
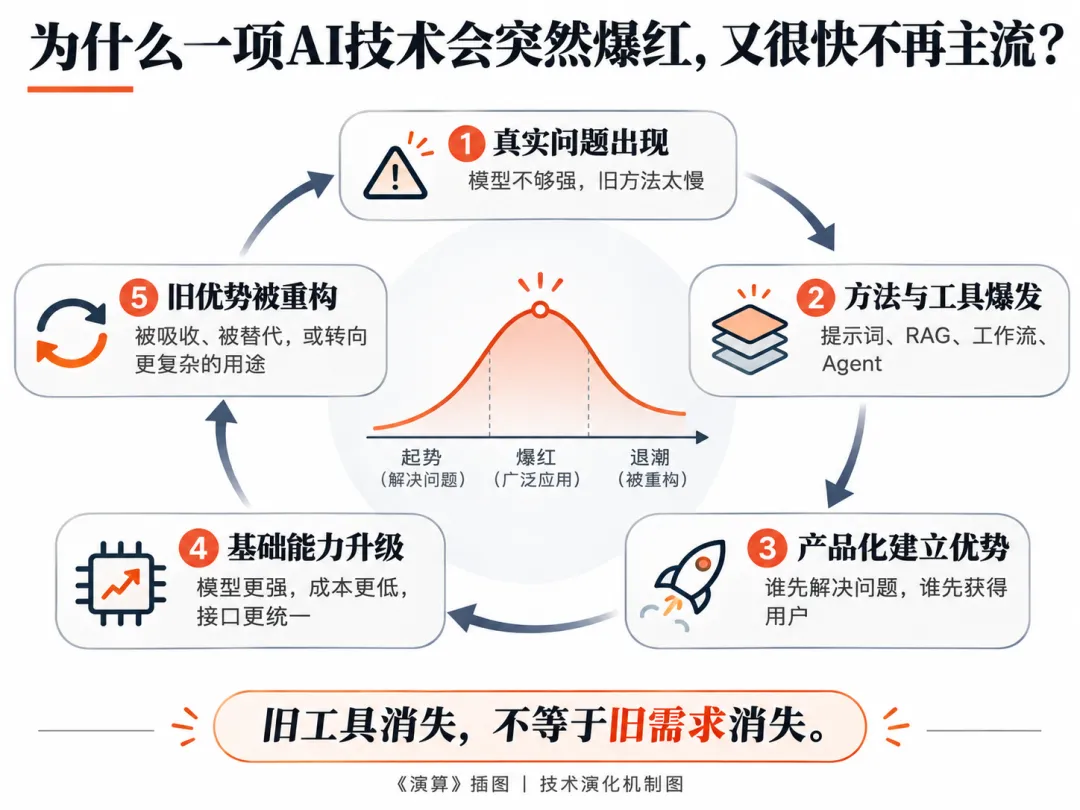
DeepSeek 让模型能力更容易获得,谁因此得利、谁丢了溢价
应用工具的更替,还受到基础模型市场的直接影响。模型能力从少数付费服务逐步扩展到多家供应商、开放权重模型和不同规模的本地部署方案,开发者便有机会在性能、成本、速度和数据控制之间重新选择。
2025年初,DeepSeek-R1 的发布展示了高水平推理模型的另一条路线。它公开了模型权重,也提供了不同规模的蒸馏模型,使更多团队能够研究、部署或调整推理能力。开发者获得了更多模型选择,也开始重新计算昂贵模型调用和封闭入口的价值。
斯坦福《2025 AI Index》记录了更大的趋势:达到近似 GPT-3.5 水平的模型调用成本,从2022年11月每百万 Token 约20美元,降到2024年10月约0.07美元。这个幅度足以改变大量应用是否值得开发的经济边界。
成本下降之后,原本“不值得调用模型”的流程可能变得可行;与此同时,单纯靠转售模型能力赚钱的空间也可能被压缩。基础层能力的普及,既扩大上层应用的机会,也不断改变上层产品赖以定价的条件。
Copilot、Cursor、Codex:编程工具到底换了几次工作单位
2021年 GitHub Copilot 兴起时,最直接的体验是开发者输入注释或代码前缀,模型补出后面的几行。它减少打字和查文档的时间,却没有改变开发者必须亲自拆解任务、切换文件、运行命令的工作方式。那时,谁能更快写出代码,往往就是产品能够直接呈现的价值。
随后,围绕整个代码库理解和编辑的工具受到关注。IDE 内的 AI 不再只看光标附近的几行,而是能够搜索项目、修改多个文件、解释报错。Cursor 等产品抓住了这一时期的需求:开发者需要的不是又一个聊天窗口,而是一个知道当前项目、能在原工作环境里帮忙的助手。
2025年推出的 Codex 等软件工程 Agent 又把工作单位往上推了一层。它可以接收一个有目标和验收条件的任务,在代码仓库中修改文件、运行测试、根据失败结果调整,并提交供人审查的变更。开发者提供的输入从“下一行写什么”,逐渐变成“这个功能要达到什么状态”。
对照三种产品的演进,真正被压低成本的是三个不同层次:写出代码、在项目里完成修改、围绕目标执行并验证一项开发任务。因而某一代工具的核心卖点,很容易成为下一代产品的标配。
但软件并没有因此免费。代码只是软件的一部分。线上服务要处理身份、数据迁移、旧系统兼容、峰值负载、故障、长期更新以及客户持续改变的业务要求。能够生成第一版应用,和能够为多年可靠运行负责,是两件差异很大的事情。
对软件公司来说,这还会改变收钱的方式。过去项目按人时计费,工程复杂意味着较长工期;当 AI 缩短一部分工序,客户就会要求更快交付、重新议价,甚至开始尝试自行开发部分功能。麦肯锡2026年调查中,32%的受访者称其所在组织曾至少一次因 AI 自建能力而放弃购买某个软件产品或功能。
所以软件工程的核心竞争并没有停止,只是从局部代码产出,逐步上升到任务定义、验证、系统集成、可维护性和持续服务。这也意味着程序员不因学会一款工具就长期安全,软件公司不因拥有一支开发团队就有永久定价权。
更尖锐的是,自动化编程已开始进入 AI 模型和底层系统的生产过程。
连 AI 算子都开始交给 AI 优化,研发的边界在哪里
这种变化甚至回到了 AI 的生产车间。
大模型运行依赖 GPU 算子、编译优化、内存访问和高效的计算调度。过去,一位能够精细优化算子的工程师,可能为大规模推理节省极其可观的成本。其专业价值来自硬件特性、数值计算和长期经验的高度结合。
如今,AI 已经进入这类优化过程。Google DeepMind 2025年发布 AlphaEvolve,利用模型生成候选算法,借助自动评价和演化搜索筛选改进方案。在可以快速验证的实验里,模型已经能够承担提出候选方案、写代码和反复测试的工作。
Meta 在2026年4月披露了 KernelEvolve:它将 GPU 算子优化变成候选代码生成、编译、基准测试和反馈搜索的闭环,在其报告的广告模型场景中取得了超过60%的推理吞吐量提升。这个例子准确展示了技术创造者面临的变化:原先需要工程师反复调参、测试和优化的工作,现在也能被智能体参与完成。
Anthropic 在2026年披露,截至8月,Claude 在其超过90%的被测 AI 研发任务中达到至少协作参与的程度,在26%的任务中承担主要执行工作。OpenAI 同年也公开介绍了内部使用自动化研究智能体的进展。
过去用来构建 AI 的某些能力,如今正在成为 AI 自己能调用的能力。算子优化、实验调度等高度数字化、结果容易评测的工作,率先进入自动化循环。
AI 参与 AI 研发,可能改变技术迭代的节奏。
一轮模型改进使代码生成更可靠,研发团队便可以运行更多实验;实验效率提高,又可能帮助开发更好的模型。技术进步反过来影响创造技术的过程,形成反馈。自动化编程、算法搜索和实验管理都已经出现这类迹象。
研发加速还受制于现实的物理账单。训练要算力,算力要电力和设备,真实改进要可靠的评估;有些优化可以自动跑上千次,有些突破需要新的科学思想或昂贵的物理实验。结果是否有效,还取决于评价方法能不能真实反映目标。
因此,技术进步不必然按同一个速度无限加速。真正值得追踪的是:哪些研发环节已经可以自动化,哪些环节仍然最昂贵,以及下一轮投入会先改变哪里。
如果创造技术的成本也被 AI 降低,行业过去形成的先发优势就可能再次被缩短。
当机器能够承担更多工作,下一场竞争就发生在价格上:同样的成果,客户还愿意支付多少?
AI 让内容制作更便宜,为什么做内容的人可能赚得更少
AI 使服务成本下降,为什么生产者不一定赚得更多?因为一个人采用工具,和整个市场采用工具,结果并不一样。
最早使用新技术的团队,确实可能用更少时间完成同样的任务,获得一段利润优势。随后工具普及,竞争者增加,买家发现有了更多选择,便重新谈价格。对单个生产者而言,效率提高了;对市场而言,原来的稀缺供给增加了。售价和利润因此可能下降。
Upwork 2026年的平台数据显示,生成式 AI 与创意生产相关合同启动量同比增加90%,但单份合同收入下降13%。与之相对,复杂 AI 辅助专业服务的业务量和收入却在增加。同样是使用 AI,有人在更低价格里竞争,有人凭借复杂交付获得新的溢价。
生产效率决定完成任务要用多少资源;客户愿意付多少钱,还取决于市场竞争和替代方案。这两个变量可以朝相反的方向变化。
AI 漫剧是观察这件事的好窗口。
在传统制作流程中,剧本、分镜、人物、场景、配音、剪辑和后期需要不同岗位协作。生成式视频技术降低了其中许多环节的时间和资金门槛,一批过去没有条件制作影视内容的团队得以进入市场。路透社2026年9月的报道记录了中国地方产业政策对 AI 视频公司的支持,也记录了制作成本下降后的作品快速增长。
供给大量增加时,旧瓶颈被突破,新瓶颈便更清晰:观众愿意看什么,是否能在推荐系统里被发现,谁拥有可以持续吸引观众的题材、人物和 IP,平台怎样分配广告与播放收益。
制作能力变便宜,并不保证题材判断、长期品牌和用户关系同步变便宜。市场还会出现另一个结果:过去承担不起制作费用的创作者也获得入场机会,内容种类可能增加,观众的选择更丰富。一个行业可以扩大,同时很多从业者面临更激烈的收入竞争。
产量增长可能伴随单位收入下降。这笔账同样开始出现在软件市场。
客户也开始造软件:企业软件公司的优势从哪里松动
麦肯锡2026年调查中那32%的回答,说明 AI 编程已经影响真实采购选择。一个客户过去只能购买现成 SaaS,或聘请团队做定制开发;当内部员工可以借助 AI 快速实现小型流程和专用界面,购买的理由就得重新计算。
最先受到压力的,是功能标准、差异有限的轻量软件。运行在数千家客户业务中的核心财务系统,则仍有大量接口、权限、审计和长期升级义务。客户可以让 AI 生成第一版功能,却还需要有人为日复一日的稳定运行负责。
但后一类厂商也不会完全置身事外。当客户学会用 AI 解决部分边缘需求,他对原供应商的付费要求、交付周期、定制费用和服务质量都会更敏感。旧软件未必被卸载,旧的定价理由却可能先被改写。
更深的影响,是软件公司的优势开始分化。依赖通用功能、靠开发人力堆出来的产品,会不断遭遇模仿与价格压力;深嵌业务流程、积累可靠运行历史、持续拥有客户信任和真实网络效应的平台,可能因为 AI 降低应用开发成本而连接更多需求。
生产工具变便宜以后,企业要重新决定哪里购买、哪里自建、哪里与外部系统合作。一个行业的总需求可以扩大,原有供应商的利润却可能减少。这和 AI 视频制作行业出现的变化,属于同一种经济机制。
同一项能力越来越便宜,技术红利究竟去了哪里
2026年,模型调用更便宜、创作和软件开发更快。新创造的收益,正在不同参与者之间重新分配。
当一项能力稀缺时,能够提供它的人可以收费;一旦许多竞争者都能低成本提供它,客户便有了新的选择。价格下降,消费者得到好处,原先提供这项能力的公司却可能难以维持利润。若成本下降又创造出大量新需求,生产者也可能从更大的市场受益。究竟发生哪一种结果,取决于需求能扩张多快,以及谁掌握了仍然紧缺的资源。
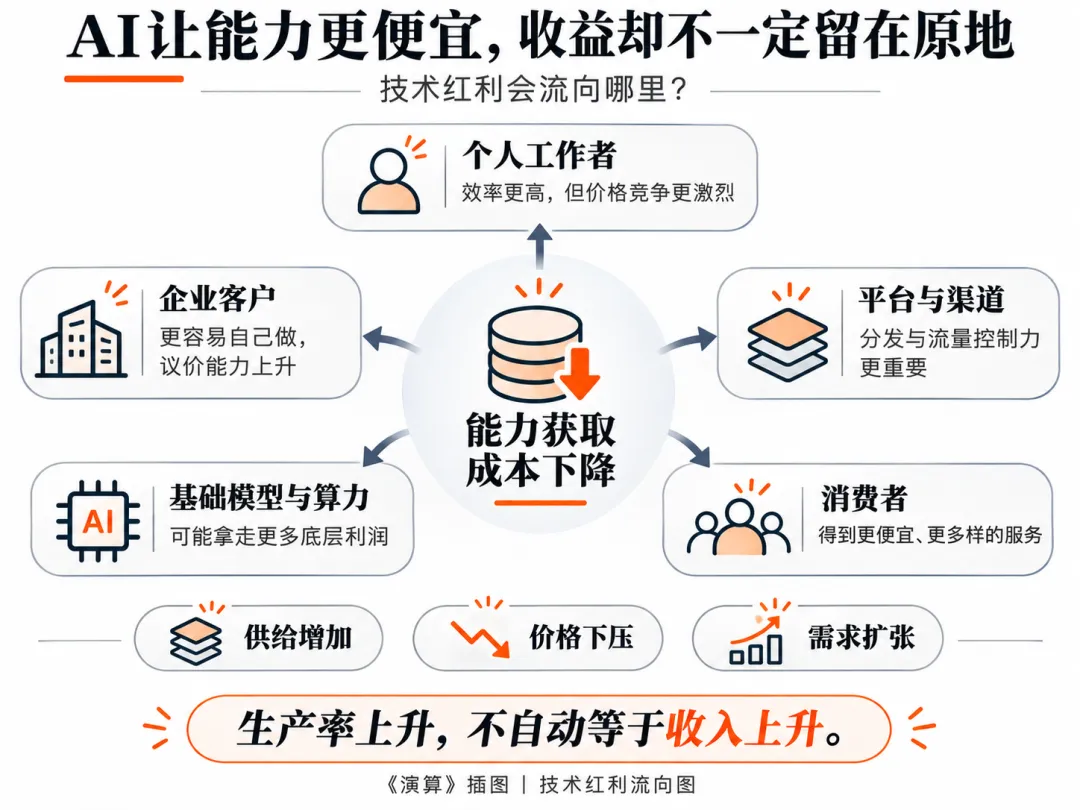
在内容行业,制作成本下降后,观众注意力和分发渠道显得更加紧缺;在软件行业,客户的自建能力增强,采购谈判也随之改变。技术进步打破旧的供应约束,又把竞争推向下一种稀缺资源。
因此,技术红利至少可能流向四个地方:消费者通过更低价格获得;客户企业通过更强议价与自建能力获得;模型、算力、分发等平台通过服务需求增长获得;拥有稀缺数据、客户关系、可靠交付能力的生产者也可能获得。
最容易被忽视的是第五种结果:原来根本不会发生的交易,因成本下降而变得值得做。小企业可以开发定制软件,偏远地区可以获得某些专业辅助服务,小团队可以制作过去负担不起的内容。旧业务利润下降,新增需求却可能使整个市场扩大。
技术提高了可以生产多少价值,竞争与组织关系决定了谁能留住其中的收益。这也是为什么个人可能更能干却难涨薪,小公司更容易开业却难赚钱,大公司拥有更多模型选择却未必保住原有软件收入。
新的稀缺环节同样不会永远稀缺。模型调用的价格会继续变,评测和集成也可能被自动化,今天的优质渠道可能被新的入口改变。观察产业时,真正需要追踪的,不是哪个环节被冠以“长期壁垒”,而是新能力普及之后,客户为什么仍愿意为某种结果付费。
“会用 AI”成为标配之后,工作与培养人才的规则也变了
随着工具普及,“会用 AI”正在越来越多地变成职业基础条件。它仍然有用,只是越来越难单凭这一点获得高溢价。就像电子表格从少数人的专门工具变成办公室标准配置,能打开软件和能承担复杂的财务工作并不是一个层次。
技术扩散会同时改变岗位内部的任务组合。某些初级写作、整理、编码和检索工作被自动化,经验丰富的人可以把更多精力放在复杂问题上。但如果大量入门任务减少,新人的学习路径就可能受到影响。过去在重复工作中形成的专业判断,未来需要重新设计培养方式。
斯坦福数字经济实验室利用工资发放数据研究美国就业变化,2026年8月更新发现,高 AI 暴露职业中22至25岁年轻员工的就业水平,落后于同龄低暴露职业的对应趋势约19%。变化正在某些职业入口出现,并进一步影响年轻人获得经验的方式。
这使企业和学校必须重新设计新人训练:当许多入门工作交给 AI,下一代专家怎样积累真实的判断经验?
技术普及也会改变需求规模。
软件生成成本下降,某些标准化开发服务的报价可能下跌,但小企业可能第一次有条件开发自己的专用系统。内容生成成本下降,某些制作环节收入承压,但新题材、新语言版本和新发行市场可能被打开。模型调用越来越便宜,一些曾经成本太高的科研、教育和专业辅助服务开始具有经济可行性。
最终就业和行业收入怎么变化,要看两股力量谁更强:单位任务需要的投入减少了多少,市场需求又增加了多少。与此同时,不同公司得到的收益也会不同。拥有客户、品牌和系统入口的公司,可能把新的生产力变成更高利润;高度标准化、可替代的服务商,则更容易被迫让价。
单项任务节省的人力,最终会不会变成就业减少,还要看新增需求能否承接这些能力。
小公司变得更有机会,大公司为什么也可能更强
公司也在不断重新学习怎样使用 AI。
一家企业可能花一年建设模型中台,下一年发现基础平台已经提供相同能力;刚建立低代码开发团队,编程 Agent 就改变了开发成本;刚采购一套智能体产品,又发现自身的业务软件开始内置类似能力。过去很好的决策,在新的技术条件下未必还是最好的决策。
但因此频繁追热点也会付出代价。系统迁移需要时间,员工需要培训,真实业务依赖历史数据和稳定流程。频繁更换平台可能把节省的模型成本重新花在组织摩擦上。
企业更需要分清两类投入:一类是容易随平台升级而改变的通用技术组件;另一类是客户、业务数据、工作流程、评价标准和长期运行经验。前者适合保持可替换,后者需要不断积累并保持自主控制。
真正能长期积累的,是在模型和工具更新之后,组织仍能保留下来的业务能力。
成本下降又改变了谁能进入市场。
过去大企业依靠资金、团队和复杂研发建立门槛。AI 工具使小团队能够完成一部分以前需要很多人的工作,创业和试验成本因此下降。另一方面,训练前沿模型、建设数据中心、购买芯片和能源基础设施又需要巨大投资,可能扩大另一部分环节的规模优势。
于是,AI 产业同时出现两种力量:应用开发的部分门槛降低,基础设施和渠道的某些优势集中。独立开发者更容易推出产品,却可能更依赖少数模型平台、云服务、应用商店和分发渠道。
这会改变企业之间的谈判关系。谁控制客户入口,谁拥有独特数据,谁能决定收费标准和使用条件,都会影响技术收益落到哪里。对社会来说,生产力增长可以改善服务的可获得性,也可能带来新的集中与依赖问题。
AI 带来的竞争,并不只发生在人与机器之间,还发生在整个产业链的不同位置之间。
一代工具退场,留下了多少技术?
回看过去四年,有些旧接口已经关闭,有些操作被模型吸收,有些产品重新定位,还有些方法沉淀为下一代系统的基础设施。
名称的热度变化远快于底层需求的变化。评估一种技术的未来,还得看它最终服务于什么任务、降低了哪部分成本。
下一波新工具出现时,先问这五个问题
每当一款新工具登上热搜,市场总会重复同一个问题:要不要马上学?过去四年的历史提供了更有用的办法:先看它解决的问题,再看优势能维持多久。
它在解决什么真实问题?2023年的 RAG 解决了模型缺少实时企业知识的问题;早期 Workflow 解决了模型难以稳定执行固定步骤的问题。问题越具体,工具价值越容易验证。
它为什么偏偏在今天出现?新模型、接口、算力成本或市场需求跨过某个门槛,才会让旧想法突然变成可行产品。OpenClaw 的爆红,建立在模型工具使用和本地执行能力已经改善的基础上。
它靠什么形成优势?是独特数据、客户关系、执行环境和可靠结果,还是一段别人很快就能复制的操作流程?前者需要时间积累,后者很可能随着基础能力普及被迅速压价。
哪些能力下一步会被吸收?当模型开始内置检索和结构化输出,手工搭建的基础管线就失去了部分收费理由。观察基础平台正在解决什么,比盯着某一款产品的排行榜更有用。
最后谁能留下收入?生产能力普及后,客户可能要求降价,平台可能掌握分发与计费入口,新的需求也可能出现。能持续兑现结果、控制复杂成本并留住客户,才有机会把技术优势变成长期收益。
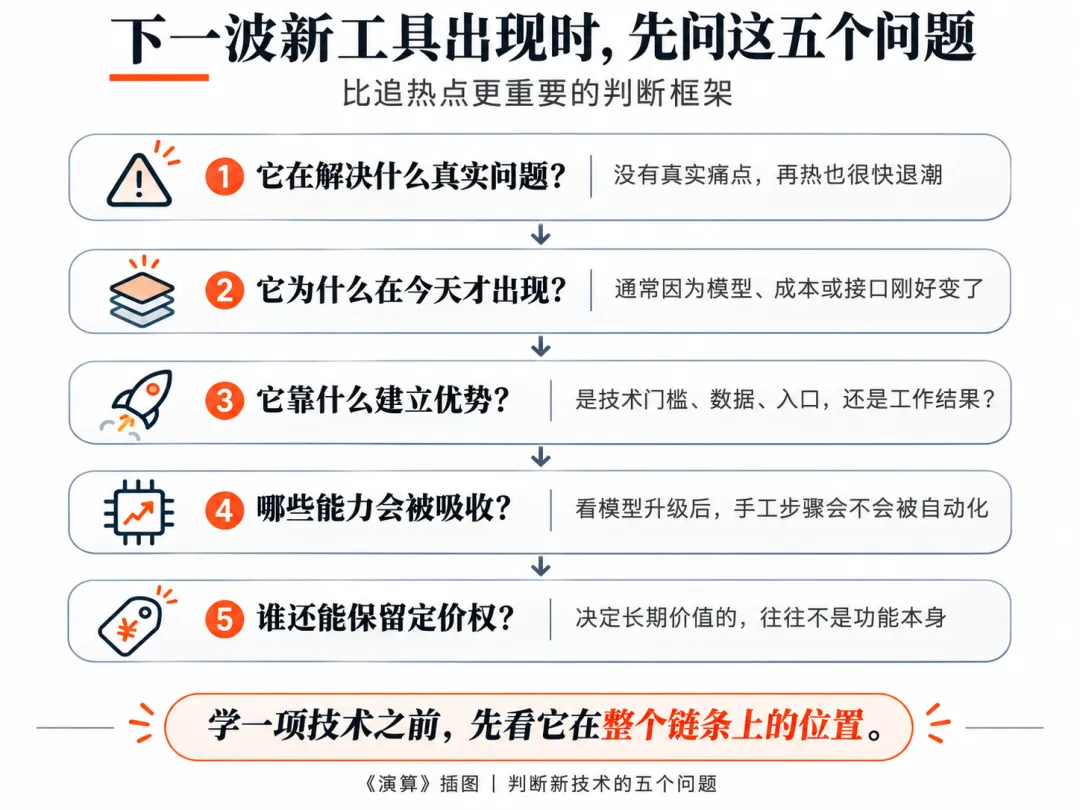
这五个问题既适用于学习一款工具,也适用于企业采购、产品创业和技术投资。它们把选择从“哪个名字现在最火”,重新放回需求、成本和竞争条件之中。
下一轮机会常常藏在今天最贵、最慢、最容易失败的环节。模型不能调用工具时,连接 API 是突破;连接能力普及后,运行治理与权限成为新门槛。代码生成更便宜了,长期维护与交付的价值又被放大。
重要的不是押中下一个热词,而是看清旧难题被解决之后,市场还愿意为哪一项能力付费。
学得越晚,真的就越不用学了吗?
2026年11月的 AI 行业,把几种过去相对分离的竞争放在了一起。
研究人员用 AI 加速研发,软件团队用 AI 开发软件,企业客户用 AI 替代部分采购,内容生产者用 AI 降低制作成本,所有人又在面对新能力的快速普及。不同领域的变化并不整齐,但同一条逻辑不断重现:某种能力获得得越容易,单凭拥有它就越难保持溢价。
学习与创造因此被赋予了更难的任务。技术变动越快,越需要对问题、成本、需求和运行环境有清醒认识。真正危险的,是把一时的工具熟练等同于长期的竞争优势,把效率提高直接等同于收益增加。
当行业各个层次都在重新分工,最值得积累的,是识别真实需求、构建可持续系统、理解谁会因为技术进步而改变选择,并及时调整自己的位置。
“学得越晚,越不用学”之所以引发共鸣,是因为后来者确实可以跳过先行者花费大量时间摸索的操作。每一次模型更新,都可能把一门繁琐的手艺变成简单的调用。
这份便利来自前几代人的研究、试错与工程积累。提示词、RAG、工作流和 Agent 框架解决过的难题,才让今天的系统成为可能。它们留下的技术成果,往往已经融进新的模型、接口和运行平台。
更深的变化发生在市场里。能力越便宜,拥有它的人越难单凭这一点收费;客户获得新的选择,企业重新决定采购还是自建,利润流向新的稀缺环节。技术越成功,原先的竞争优势就越需要重新建立。
站在2026年11月回看,从 GPT 到 ChatGPT,从早期 Agent 框架到 Codex、WorkBuddy,从人工编排到研发自动化,每次变动都沿着同一条路径展开:人们遇到问题,创造技术解决问题;技术扩散,又改变问题本身;新的能力把旧优势变成起点,新的瓶颈随之出现。
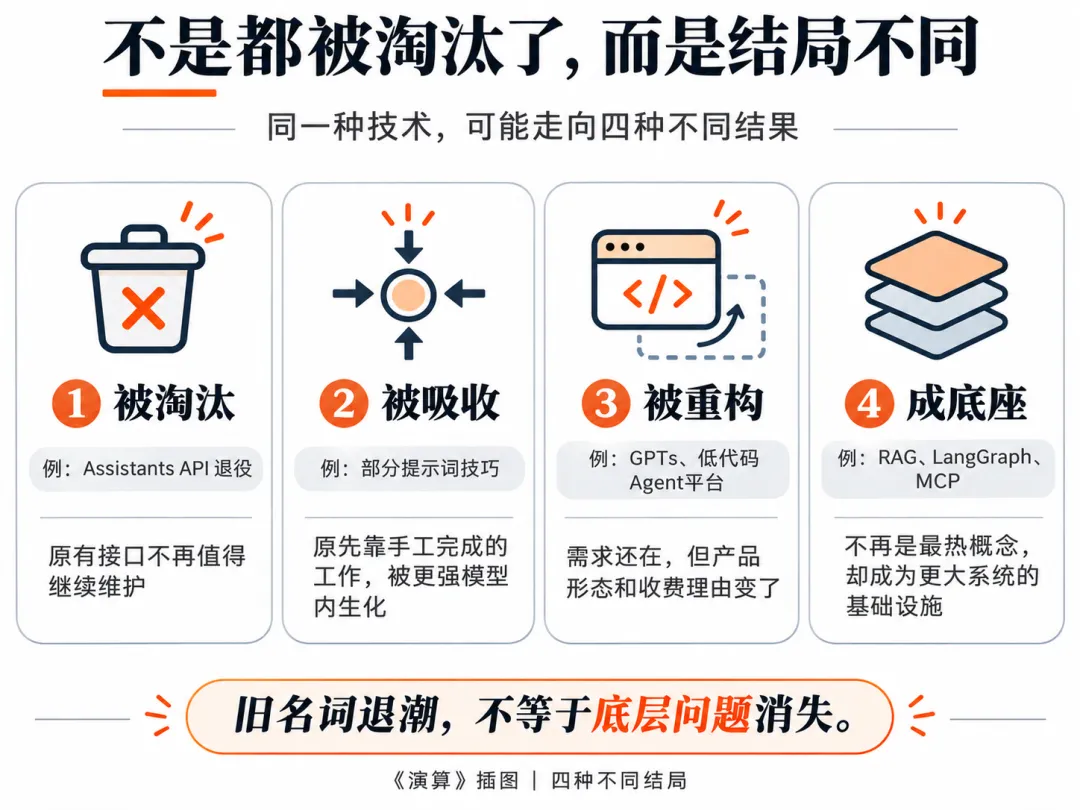
下一轮值得关注的,不只是 AI 又学会了什么,而是它把谁原来需要花钱购买的能力变成了日常配置,又把哪一种难题推到了前台。
学得慢可以省掉旧操作,学得深才更有机会看见下一轮问题。未来的优势,建立在真正理解需求、成本和变化之上。
参考资料
OpenAI(2018),Improving language understanding with unsupervised learning。 OpenAI(2020),Language models are few-shot learners。 OpenAI(2022),Introducing ChatGPT。 OpenAI(2023),Function calling and other API updates。 OpenAI Developers(2025),Why we built the Responses API。 LangChain(2025),Reflections on Three Years of Building LangChain。 LangChain(2025),Building LangGraph: Designing an Agent Runtime from first principles。 Anthropic(2024),Introducing the Model Context Protocol。 Anthropic(2025),Equipping agents for the real world with Agent Skills。 Anthropic(2026),Donating Agent Skills to the Agentic AI Foundation。 DeepSeek(2025),DeepSeek-R1 开源项目与研究说明。 OpenAI(2025),Introducing Codex。 腾讯元器(2026),关于元器平台停止服务通知。 扣子(2026),扣子企业版下线公告。 OpenAI Help Center(2026),自定义 GPT 停用与迁移常见问题。 Stanford HAI(2025),AI Index: Research and Development。 McKinsey(2026),The State of AI in 2026: On the Road to ROI。 JetBrains(2026),AI Coding Agents: Adoption Trends。 Reuters(2026-09-25),China fuels rush to turn AI video into an industry。 Upwork(2026),The Future Workforce Index 2026。 Google DeepMind(2025),AlphaEvolve: A Gemini-powered coding agent for designing advanced algorithms。 Anthropic(2026),Measurements for understanding the pace of AI development inside frontier labs。 OpenAI(2026),Research acceleration: The view inside OpenAI。 Stanford Digital Economy Lab(2026),Canaries in the Coal Mine? Six Facts about the Recent Employment Effects of Artificial Intelligence。 新浪财经转载「雷叔写故事」(2026-04-01),AI时代,只要你学得够慢,你就不用学了。 OpenAI(2023),Introducing GPTs。 OpenAI Developers(2024),Introduction to Structured Outputs。 Liu et al.(2024),Lost in the Middle: How Language Models Use Long Contexts。 Anthropic(2024),Building Effective Agents。 OpenAI Developers(2026),Migrate to the Responses API。 新华网(2026-10-14),腾讯AI办公再进一步:企业微信与WorkBuddy深度联合。 扣子(2026),低代码工作流介绍。 OpenClaw(2026),官方版本发布记录。 Meta Engineering(2026),KernelEvolve: How Meta’s Ranking Engineer Agent Optimizes AI Infrastructure。 腾讯(2026),2026 Tencent Global Digital Ecosystem Summit: WorkBuddy 企业能力。
《演算》|从事实出发,理解技术如何改变能力、竞争与文明。