ARTICLE · 1319633
每天学一点AI知识|DAY 60 - BPE
每天学一点AI知识|DAY 60 - BPE
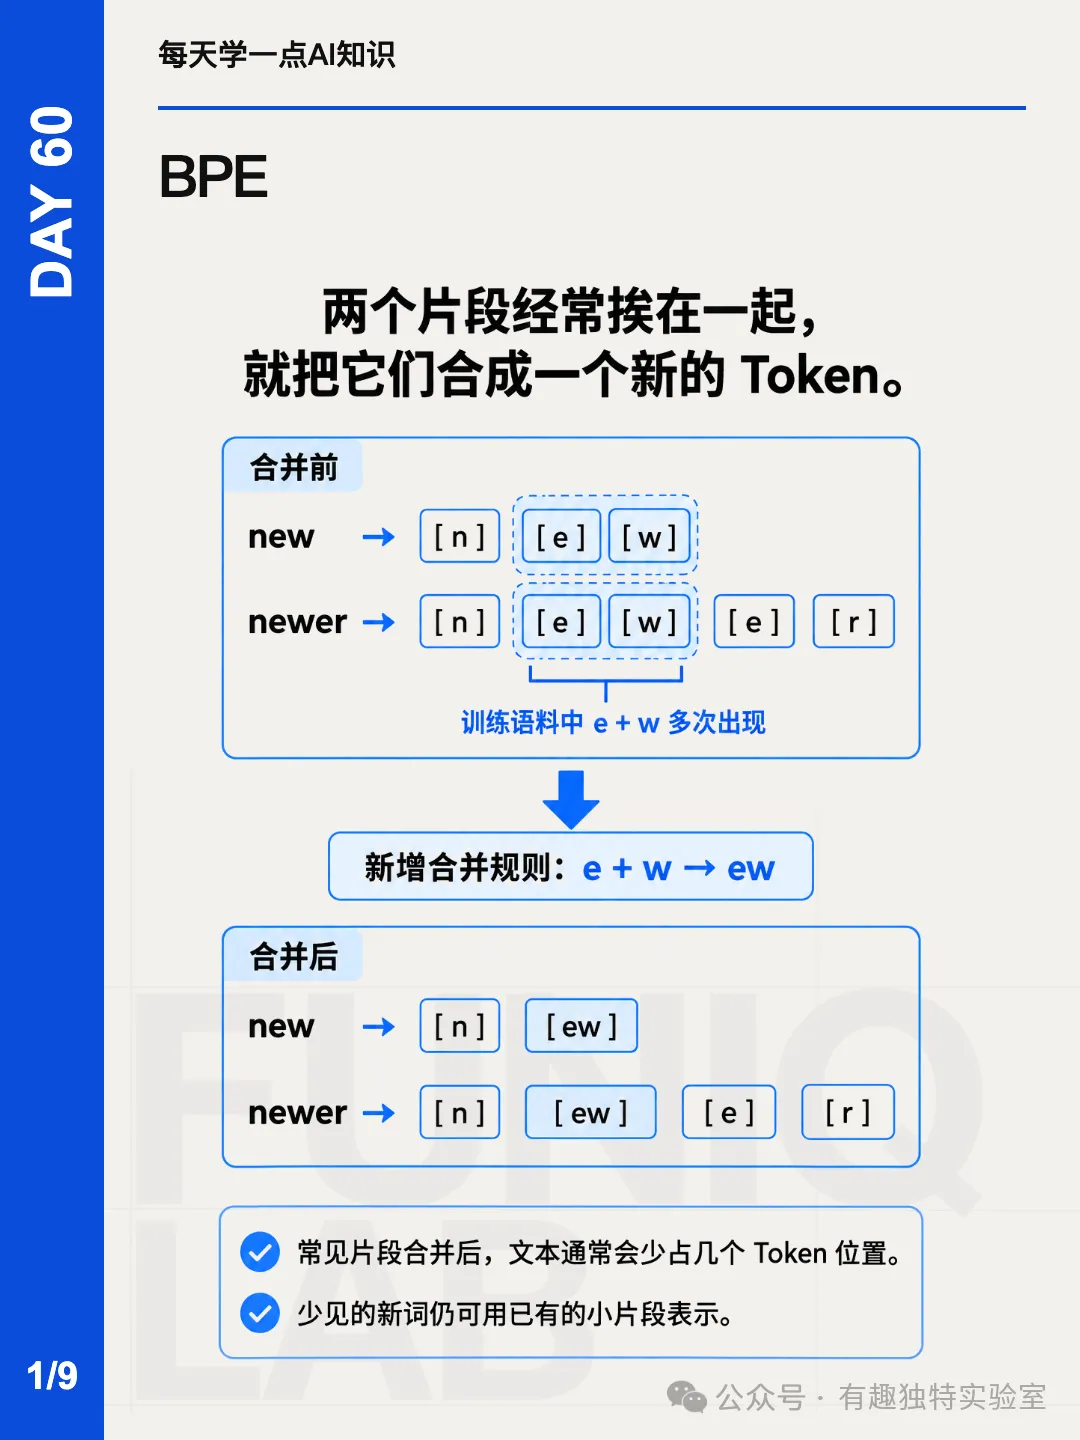
BPE 的核心动作并不复杂:从较小的基础符号出发,反复统计当前序列中经常相邻出现的片段对,再把高频片段对合并成一个新 Token。有限的词表位置因此优先留给可反复复用的组合,而没有完整收录的新词仍能由较小片段拼出来。
在 Day 59,我们认识了词表、Token ID 与特殊 Token,也知道每个 ID 都像一个地址:输入端用它读取 Embedding 的对应参数行,输出端用它定位词表中的候选 Token。
但那里留下了一个更基础的问题:词表中的条目究竟是怎样选出来的?
如果把每个完整单词都收入词表,新词、派生词、拼写变化和专有名词会让词表不断膨胀;如果只保留单个字符,几乎所有文本都能表示,但一句话可能被拆成很长的序列。
BPE 提供了一种折中思路:
两个片段经常挨在一起→ 把它们合成一个新 Token→ 常见文本少占一些序列位置→ 少见的新组合仍可退回较小片段表示
这就是 Byte Pair Encoding,简称 BPE。名字里虽然有 Byte,但理解它时要把“反复合并高频相邻片段”与“基础单位究竟是字符还是字节”分开。BPE 描述的是合并框架,具体从什么单位开始,由 Tokenizer 的设计决定。
核心问题
词表不可能预先收录所有完整单词与未来出现的新词。BPE 怎样从较小的基础符号出发,逐轮学习高频的相邻片段组合?为什么合并规则必须保存顺序?训练完成以后,新文本又怎样复用这些固定规则,在词表大小和序列长度之间取得平衡?
一句话结论
BPE 先把训练语料表示成基础符号序列,再统计当前序列中相邻 Token 对的频率。每一轮选出值得复用的高频相邻对,把它合并成一个新 Token,更新语料表示并记录这条规则,然后重新统计。达到目标词表大小或合并预算后,训练停止。
使用阶段不再根据新文本重新学习,而是加载训练时保存的基础词表与有序合并规则,按同一优先级切分文本。合并较多时,词表和相关模型参数通常更大,常见文本的 Token 序列通常更短;合并较少时,词表较小,但序列往往更长。
一、为什么不能只把完整单词放进词表
先设想一种最直观的方案:每个完整单词对应一个 Token。
对于 newer,它可能得到非常短的表示:
newer → [newer]如果所有可能出现的单词都已收录,这种方案看起来很高效。但自然语言不是一张封闭清单。它会不断产生:
新词与网络用语; 人名、地名和品牌名; 单复数、时态等词形变化; 拼写变化与输入错误; 多语言混合与临时组合; 数字、代码、网址等开放形式。
要为每一种完整形式都准备独立词表条目,词表会非常大;没有被收录的形式又无法直接表示,只能依赖未知标记或其他退路。
更关键的是,完整单词之间存在大量可复用结构。例如 new 与 newer 共享 new,low 与 lowest 共享 low。若把每种完整形式视为互不相关的独立条目,这些共同片段便难以被词表直接复用。
二、为什么也不能永远只按单个字符
另一个极端是:只保留单个字符。
newer → [n, e, w, e, r]这种做法覆盖能力很强。只要基础字符集合足够,许多没见过的单词都能被逐字符表示。但代价是序列更长:newer 需要占用 5 个位置,而不是 1 个或 2 个。
模型需要在每个 Token 位置上执行计算。序列越长,同样一段文字就占用越多上下文空间,也需要处理更多位置。常见片段明明在语料中反复出现,如果每次都重新拆成多个小单位,就没有充分利用这种重复结构。
于是,我们面临两个极端:
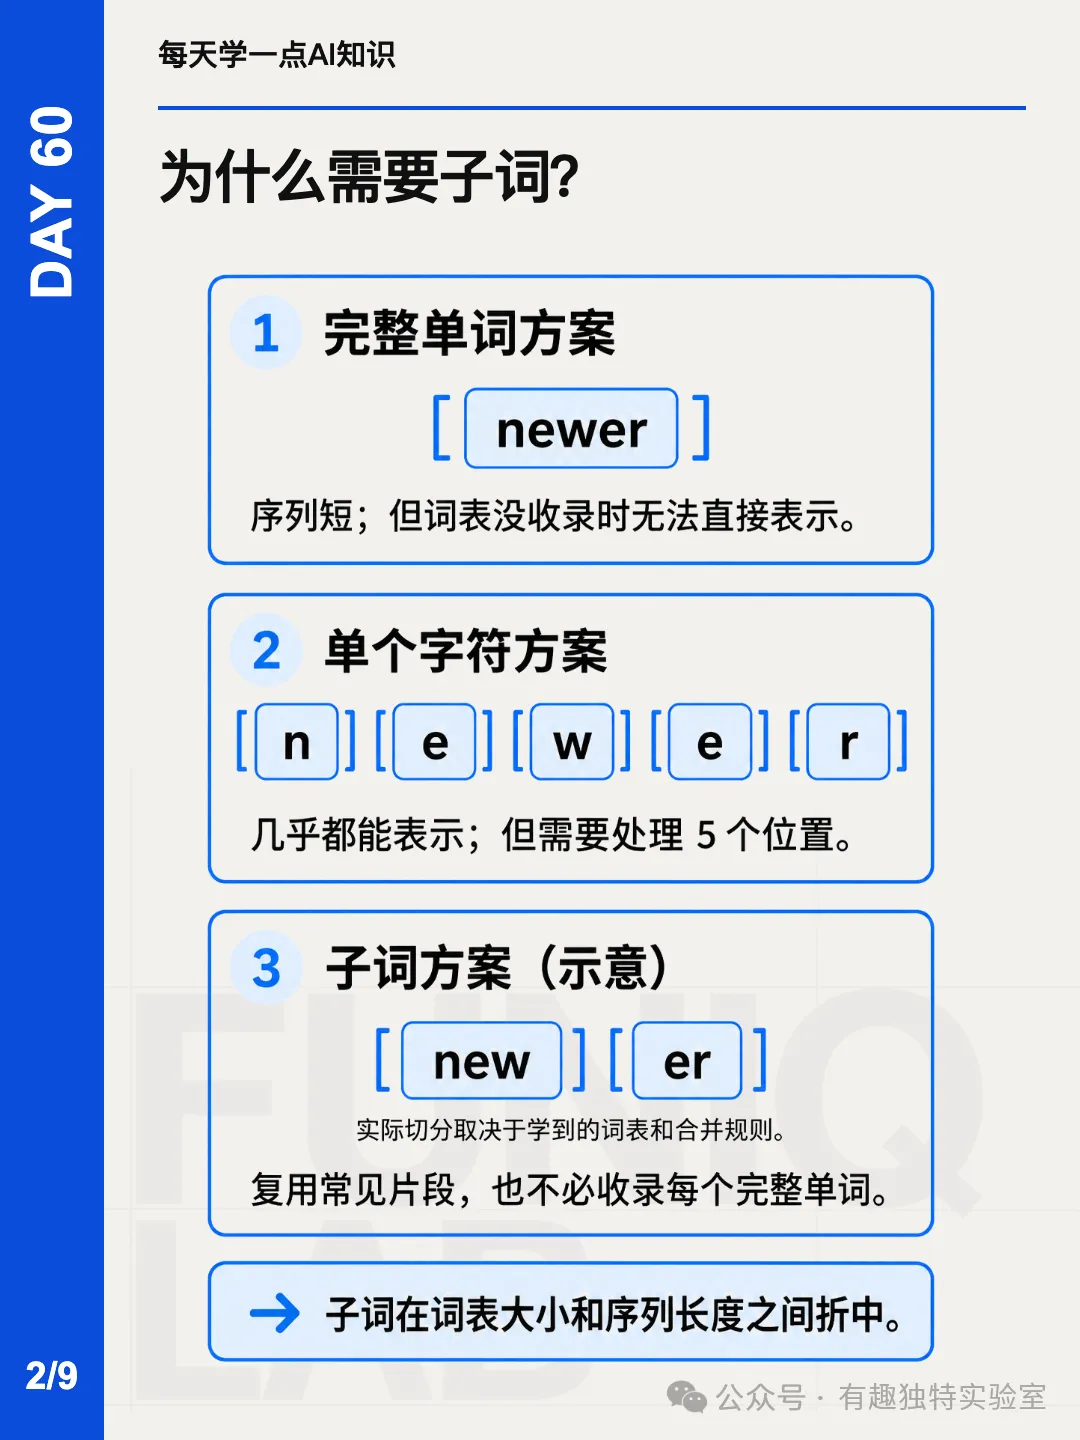
子词(subword)正好位于两者之间。它可能是完整词,也可能只是词的一部分;在其他语言或其他设计中,还可能对应汉字、标点、字节片段或别的预定义单位。
BPE 的目标不是让每个 Token 都尽可能长,而是让经常出现、值得反复复用的片段有机会变长。
三、BPE 要记住的三个对象
学习 BPE 时,先抓住三个对象就够了。
1. 基础符号
基础符号是开始合并前已有的最小单位。为了方便观察,本文的教学示例从字符开始:
new → [n, e, w]但“从字符开始”不是 BPE 的普遍定义。其他 Tokenizer 可以从字节或另一套预定义单位出发。BPE 规定的是后续怎样合并,不单独规定最初必须是什么。
2. 相邻片段对
pair 指当前序列中紧挨着的两个 Token。例如:
[n, e, w]其中存在两个相邻对:
n + ee + w
n 与 w 虽然出现在同一个词里,却没有直接相邻,所以 n + w 不是当前序列中的 pair。
3. 合并规则
合并规则记录“哪两个相邻片段合成哪个新 Token”。例如:
e + w → ew执行以后,[n, e, w] 变成 [n, ew],词表中新增组合 Token ew。
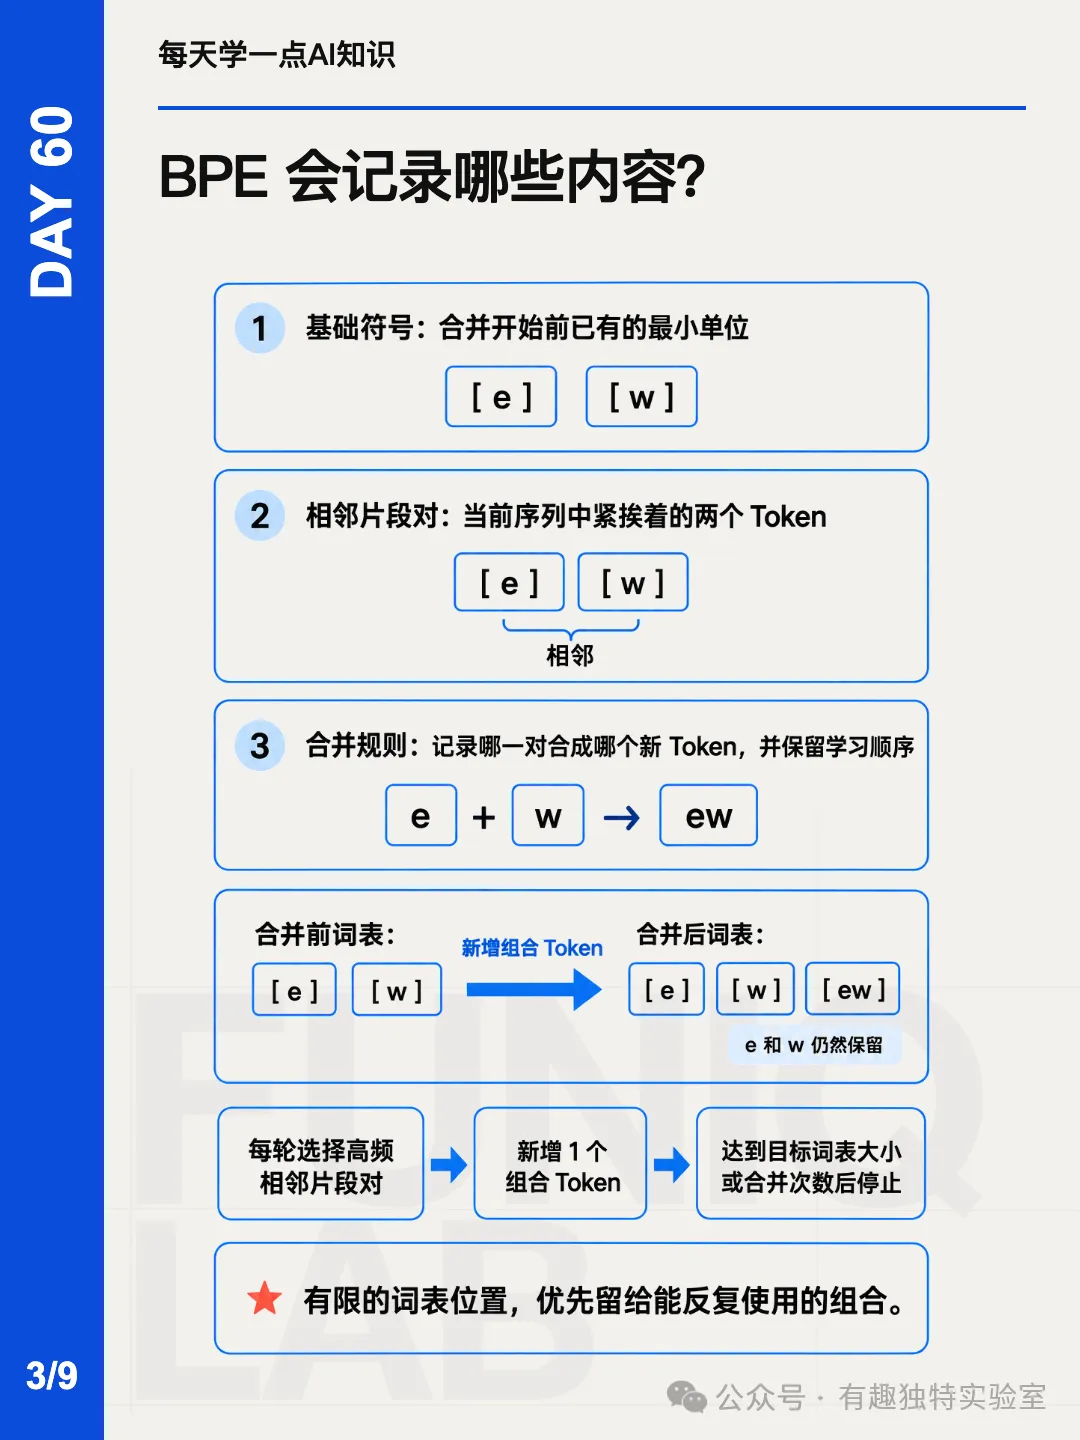
这里有一个容易忽略的细节:合并通常是新增组合 Token,而不是删除组成它的基础 Token。学习 e + w → ew 后,e、w 和 ew 都可以继续存在于词表中。
保留小片段非常重要,因为不是所有上下文都会出现 e w 这一组合。基础片段仍要负责表示其他单词和未见组合。
四、BPE 训练的完整循环
一轮 BPE 训练可以拆成五步:
1. 用当前词表表示训练语料2. 统计当前序列中的相邻片段对3. 选择当前高频或最值得合并的一对4. 新增组合 Token,并更新语料中的序列5. 记录规则,然后重新统计下一轮
这个循环会持续到某个预先规定的停止条件,例如:
词表达到目标大小; 已执行预定数量的合并; 或训练配置规定的其他条件满足。
它不是一次把所有高频片段都找完。因为每次合并都会改变当前序列,相邻关系也会随之变化,下一轮必须基于更新后的表示重新统计。
例如:
合并前:[n, e, w, e, r]执行 e + w → ew合并后:[n, ew, e, r]
合并前存在 n + e、e + w、w + e、e + r;合并后则变成 n + ew、ew + e、e + r。n + ew 是在第一轮合并之后才出现的新相邻关系。
因此,BPE 是一个逐轮更新的过程,而不是对最初字符统计一次就结束。
五、用一个微型语料手算两轮 BPE
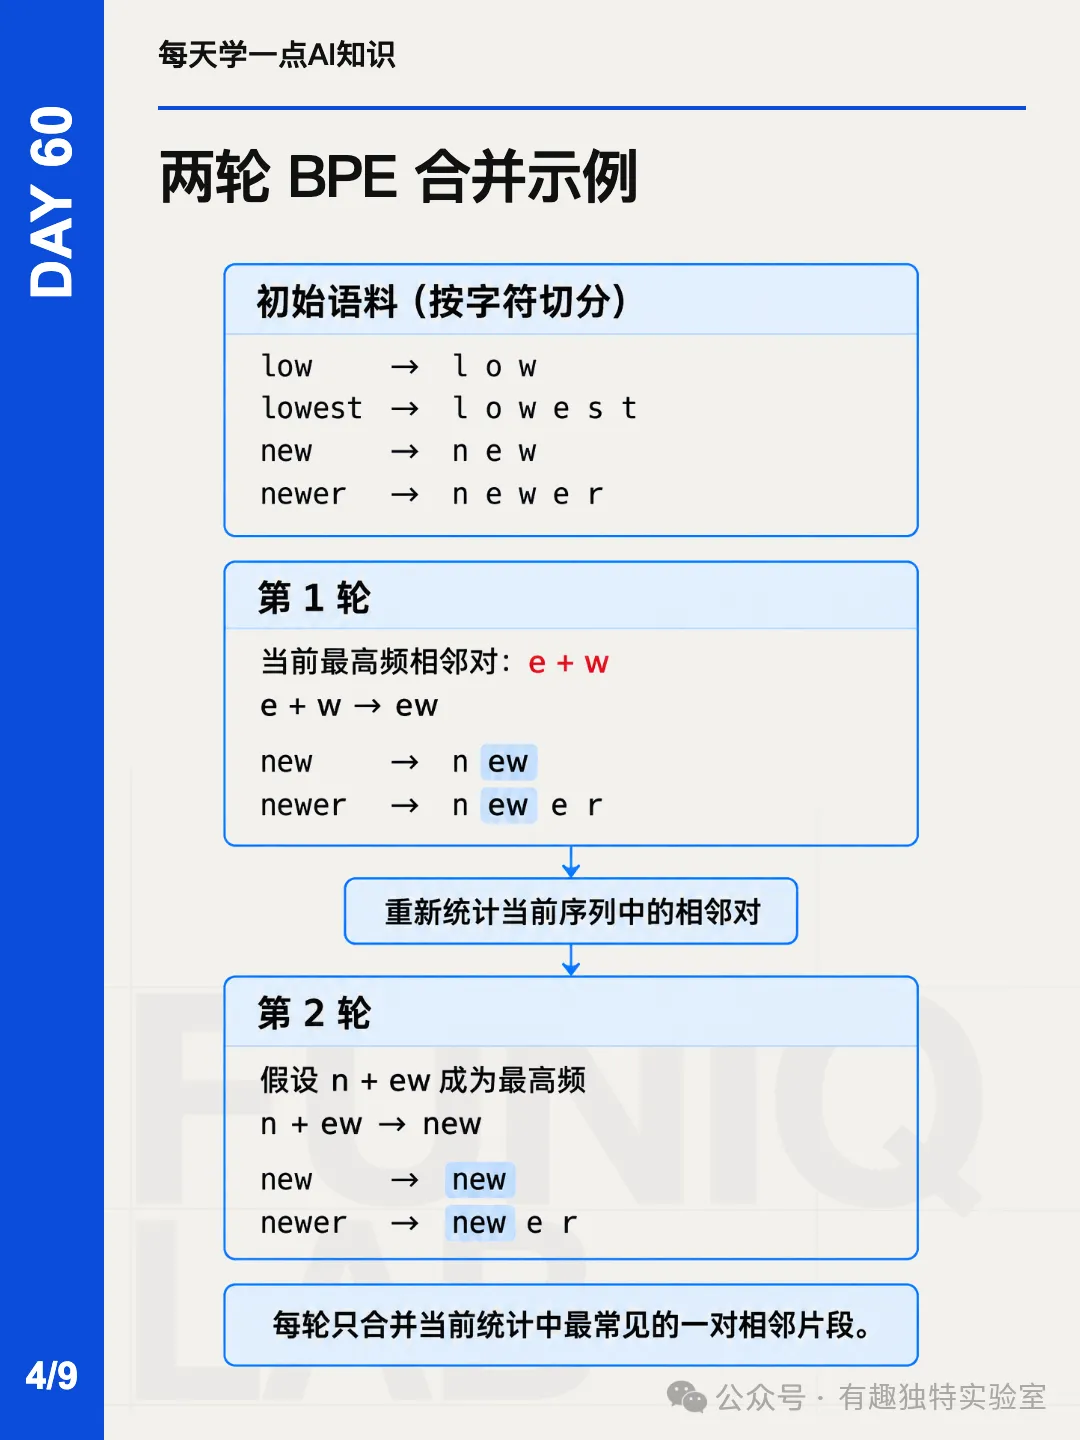
假设训练语料只有四个词,并用字符作为基础符号:
low → l o wlowest → l o w e s tnew → n e wnewer → n e w e r
现在统计各序列中相邻片段对。这个极小示例会出现多个并列高频项;真实实现需要稳定的选择或并列处理规则。为了专注合并机制,我们约定第一轮选择 e + w。
第一轮:合并 e + w
新增规则:
e + w → ew所有能匹配这对相邻片段的位置更新为:
low → l o wlowest → l o w e s tnew → n ewnewer → n ew e r
此时 new 的序列长度从 3 变成 2,newer 从 5 变成 4。low 和 lowest 没有包含相邻的 e w,所以这一轮保持不变。
第二轮:重新统计,再合并 n + ew
第一轮结束后,必须重新查看更新后的当前序列。为了教学,假设 n + ew 成为这一轮选中的高频相邻对:
n + ew → new更新结果是:
new → newnewer → new e r
两轮规则合在一起:
规则 1:e + w → ew规则 2:n + ew → new
注意,new 并不是因为训练器一开始认出“这是一个英文单词”,就被整体塞进词表。它是经过两次局部合并逐步形成的:
[n, e, w]→ [n, ew]→ [new]
这正是 BPE 的局部性:每轮只处理当前序列中的一个高频相邻片段对,更长 Token 由更早形成的短 Token 继续组合而来。
六、为什么合并规则必须有顺序
刚才学到的两条规则存在依赖:
规则 1:e + w → ew规则 2:n + ew → new
规则 2 的右侧需要片段 ew,而 ew 是规则 1 先创造出来的。因此,切分新文本 new 时,必须先让 e + w 合并:
初始:[n, e, w]规则 1 后:[n, ew]规则 2 后:[new]
如果把顺序调换,第一步想执行 n + ew → new 时,当前序列中还没有 ew:
初始:[n, e, w]先尝试规则 2:无法匹配再执行规则 1:[n, ew]
如果流程到这里就结束,最终结果会停在 [n, ew],而不是 [new]。
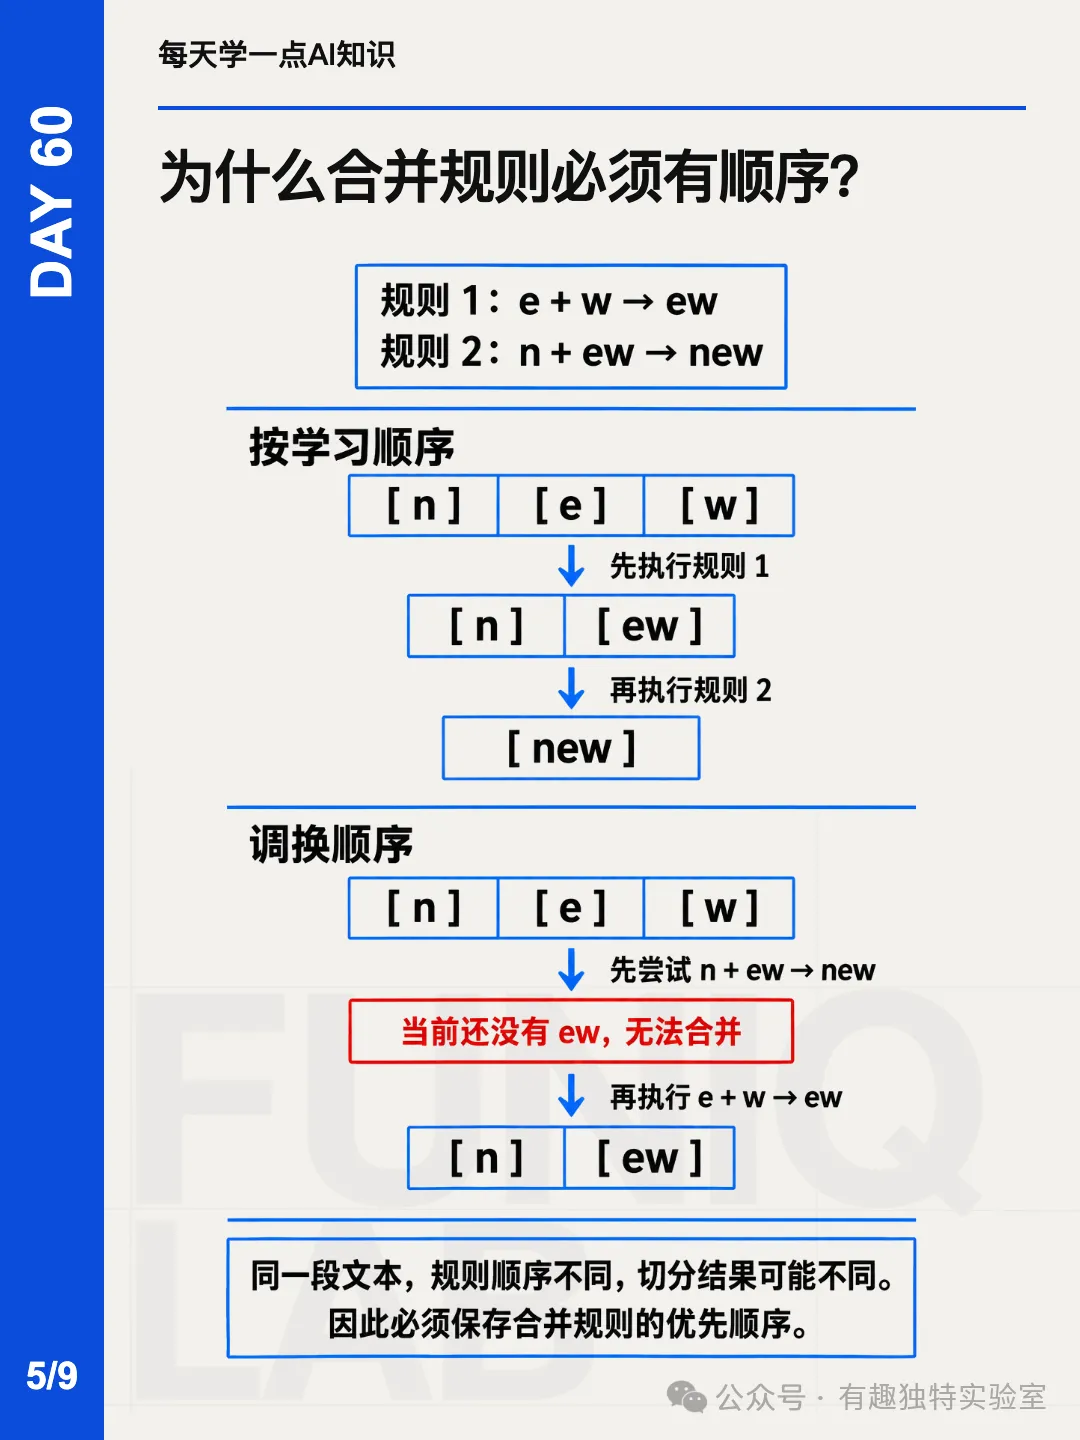
所以,BPE 训练结果不只是一个“最终有哪些 Token”的无序集合。它还需要保存合并的优先级或学习顺序。
换句话说,下面两份信息共同决定切分:
词表:最终允许哪些 Token合并规则:这些 Token 按什么优先级形成
只拿到词表、丢失规则顺序,并不能保证把新文本切成训练模型时使用的同一序列。
这与 Day 59 的结论直接相连:一旦切分结果变化,Token ID 序列就会变化;模型读取的 Embedding 行、序列长度和上下文位置也都会随之改变。
七、训练 BPE 与使用 BPE 是两件事
“训练 Tokenizer”与“用 Tokenizer 编码文本”经常被混为一谈。两者处理的对象和工作量完全不同。
训练阶段:从语料中学习规则
训练阶段需要代表性语料,并反复执行:
语料→ 拆成基础符号→ 统计当前相邻片段对→ 选择高频对→ 合并并更新当前序列→ 保存有序规则→ 继续下一轮
最终产物至少包括可用词表与合并规则。它们决定以后怎样把文本变成 Token 和 Token ID。
使用阶段:加载固定规则处理新文本
使用阶段面对一段新文本时,大致执行:
新文本→ 拆成同类基础符号→ 加载已保存的词表与规则→ 按既定优先级合并→ 得到最终 Token→ 查询词表得到 Token ID
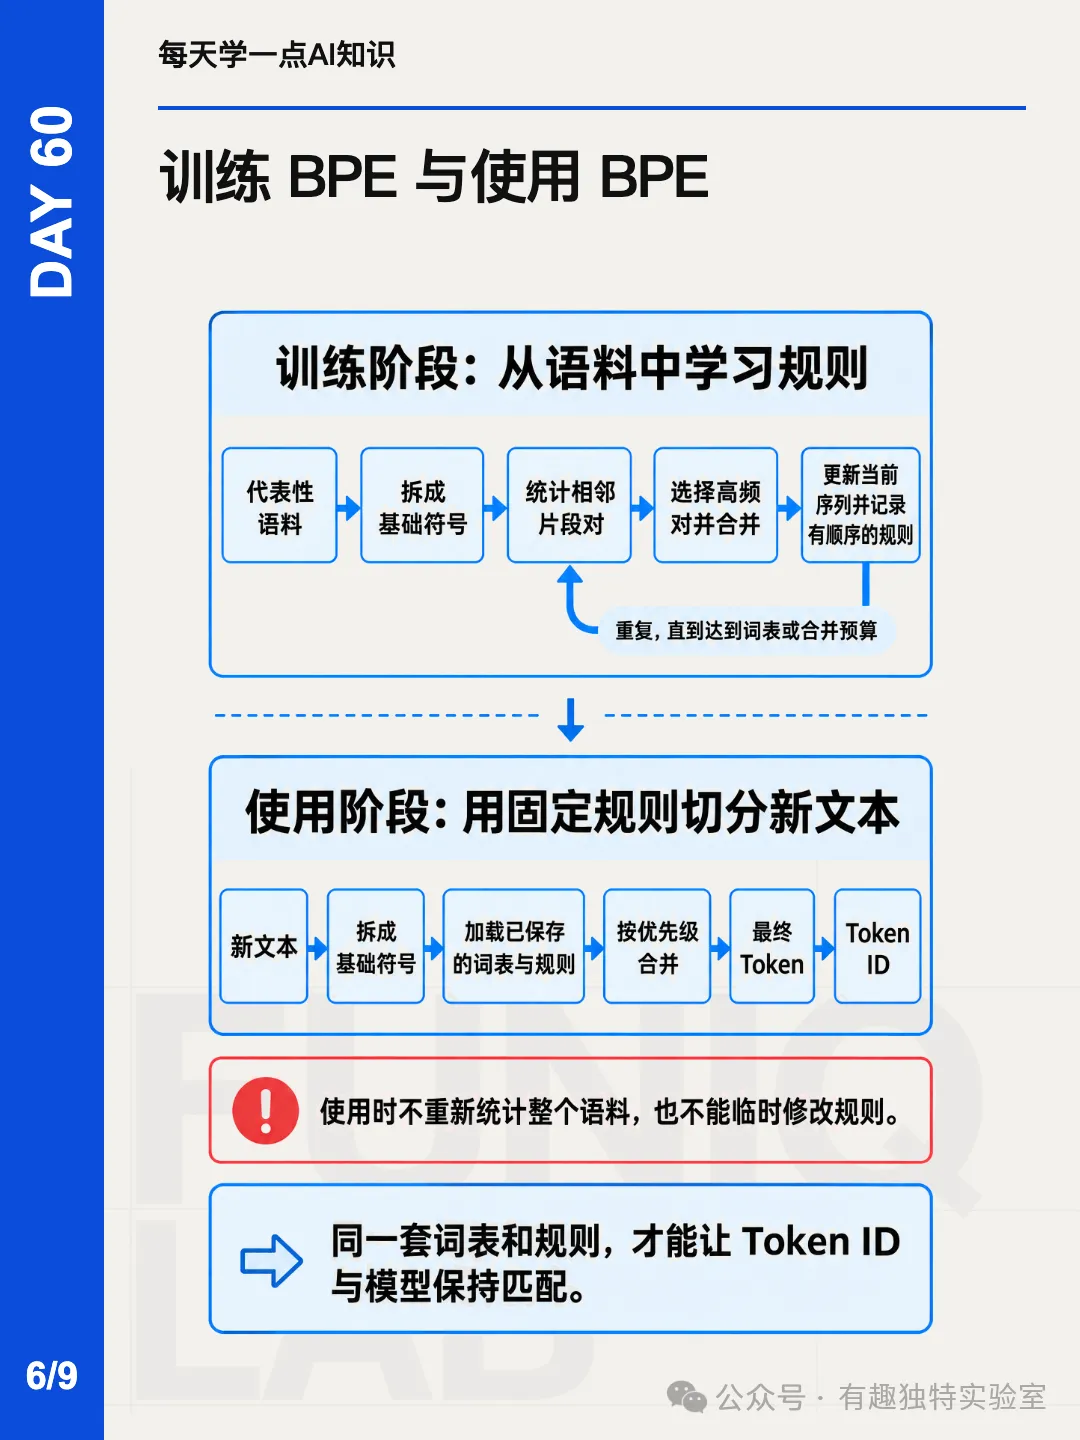
使用阶段不会因为这一次输入中某对片段重复很多,就临时把它提升为新 Token;也不会为某个新词现场重训整套 BPE。否则,同一段文本在不同批次、不同用户甚至不同时间可能得到不同 ID,模型与 Tokenizer 的契约就被破坏了。
因此:
训练时:频率用来学习规则使用时:固定规则用来执行切分
如果确实重新训练或修改了 Tokenizer,就得把它视为一套新的编号与切分协议,而不能假设原模型参数会天然理解它。
八、BPE 怎样控制词表不会无限增长
训练语料里可以出现海量片段组合。如果把所有出现过的相邻组合都加入词表,BPE 最终仍可能走向“记住所有完整形式”的极端。
所以,训练前通常要规定预算。假设基础词表大小为 V₀,执行 M 次有效合并,而且每次新增一个组合 Token,那么教学意义下的最终词表大小可以写成:
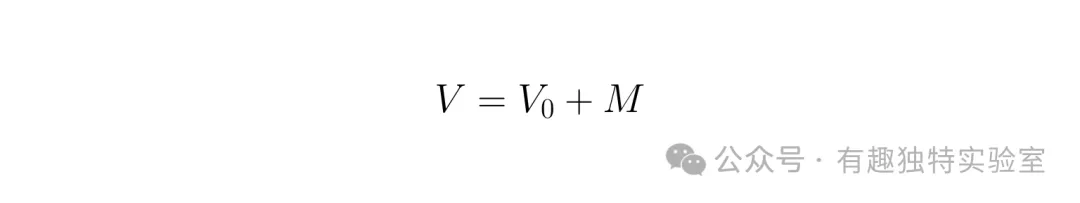
这个式子表达的是最核心的增长关系:词表从基础符号集合开始,随着合并逐步增加,而不是越合并越小。
为什么人们有时又说 BPE 能得到“较小词表”?这里的“较小”是相对于把所有完整单词与变体都单独收录的方案。BPE 本身的训练过程仍然是在基础词表上新增条目。
有限预算会迫使训练器做资源分配:
许多文本都会复用的组合,值得占据一个词表位置; 只出现极少次数的组合,可能继续由更小片段表示; 达到目标词表大小或合并次数后,即使还能继续合并,也要停止。
于是,词表把有限容量优先分配给统计上更值得复用的结构。
九、词表大小与序列长度之间的取舍
可以把合并预算想成一个旋钮。
合并规则较少
newer → [n, e, w, e, r]可用组合 Token 少,词表相对小,但需要更多序列位置。
学到常见组合后
newer → [new, er]可用组合 Token 更多,同一常见文本可能只需要较少位置。
继续增加合并规则
词表会继续增长。Day 59 已经知道,词表增大通常意味着:
Embedding 需要更多行; 输出端需要为更多 Token 位置产生 logit; 词表文件与相关参数的存储开销增加。
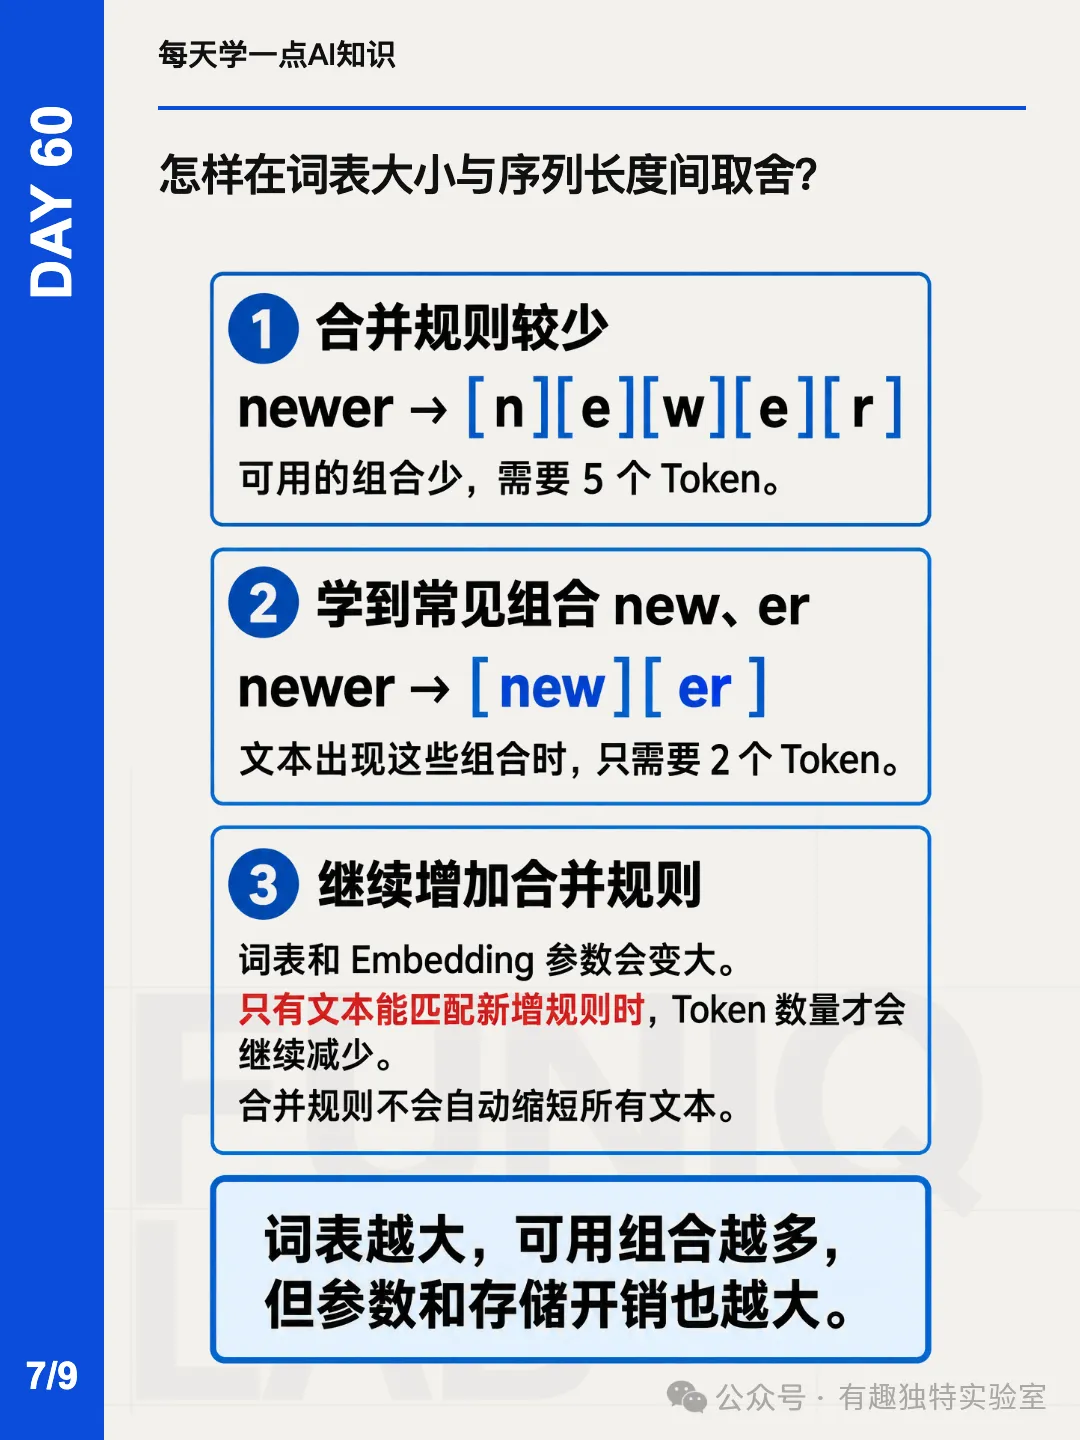
因此,没有一个脱离语料、模型规模和使用目标的“绝对最佳词表大小”。实际设计要在多个因素间折中:
还要加上一个重要限定:合并更多,只是让能够匹配新增规则的文本有机会变短,并不保证每一段输入都更短。
如果某段文本从未出现相应常见组合,它仍可能由小片段表示。某条新规则对训练语料中的高频表达很有效,却未必能缩短另一种语言、另一领域或罕见字符串。
十、没有收录完整单词,为什么仍然能表示
BPE 的覆盖能力来自“保留小片段”。训练器添加长 Token 时,不会把组成它的基础 Token 全部丢掉。
假设词表中有:
[auto] [matic] [s]即使没有完整收录 automatics,它仍可能被表示为:
automatics → [auto, matic, s]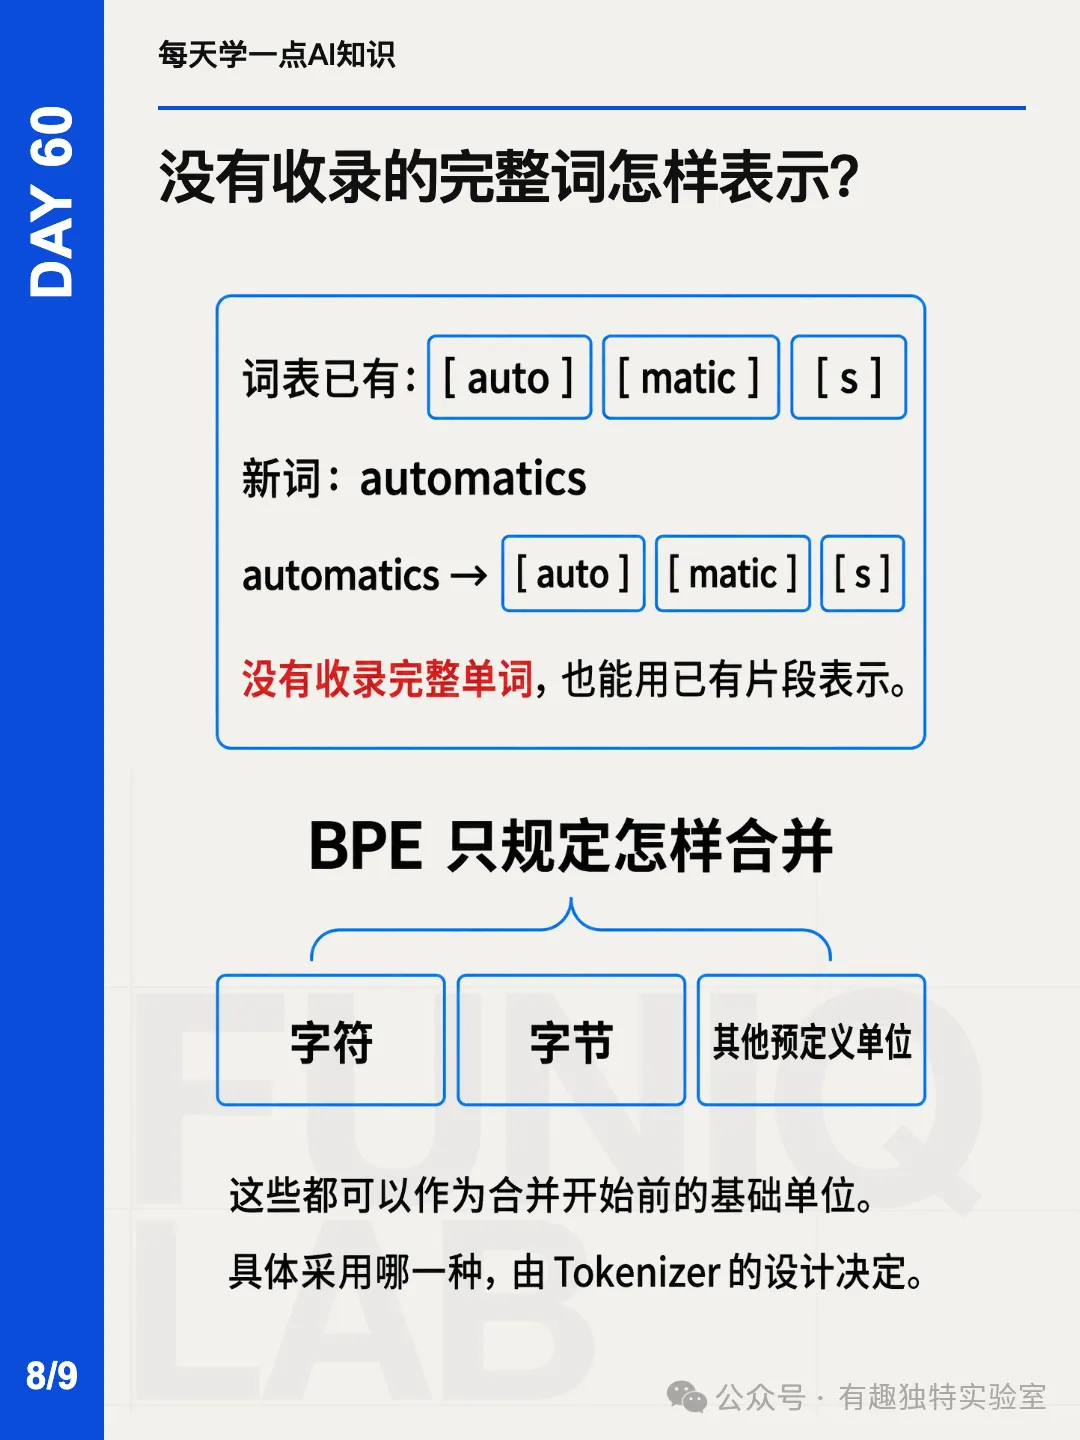
这个例子只说明“用已知片段组合未完整收录的词”,不表示真实 Tokenizer 必然采用这三个边界。实际结果由训练语料、基础符号、词表与合并规则共同决定。
同理,一个词在训练语料里没作为完整形式出现过,不等于它一定无法编码。只要它能被拆成词表已有的更小单位,就仍然可以转换为 Token ID。
这让子词方案同时获得两种能力:
对常见片段:合成长 Token,节省位置对罕见组合:拆回小 Token,保持可表示性
相比完整单词词表,它不必为每个新词准备独立条目;相比永远逐字符切分,它又能压缩语料中反复出现的常见结构。
十一、BPE 与字符、字节是什么关系
“Byte Pair Encoding”这个名称容易让人直接得出结论:BPE 一定从 UTF-8 字节开始。这个推断并不可靠。
BPE 的核心框架只要求:
有一套初始基础单位; 能观察当前序列中相邻的片段对; 能把选中的相邻对合并成新单位; 能保存并复用合并规则。
基础单位可以是:
字符; 字节; 或 Tokenizer 预先定义的其他单位。
本文从字符开始,只因为 l o w、n e w 便于手算。它展示的是合并机制,不是在声明所有 BPE Tokenizer 都进行相同预处理。
如果基础单位不同,即使后续都采用 BPE,面对同一文本也可能得到不同的初始序列、不同的频率统计、不同的合并规则与最终 Token ID。
Byte-level BPE 怎样以字节提供更稳定的基础覆盖,以及它与其他子词方案有什么区别,将在 Day 61 继续讨论。
十二、同一个词为什么可能被不同 BPE 切得不一样
知道了训练过程,就能看出切分差异可能来自多层:
训练语料不同
某个片段在技术文档里很常见,在小说中却很少见。它是否值得单独占据词表位置,会随训练语料分布变化。
基础符号不同
字符级和字节级方案从不同起点出发,候选相邻对自然不同。
词表预算不同
合并轮数较多的 Tokenizer 可能已经形成更长片段;预算较小的版本则停留在较细粒度。
合并顺序不同
早期选择会改变后续序列中的相邻关系,因此规则优先级不同可能产生不同最终切分。
预处理规则不同
文本在进入 BPE 合并前怎样规范化、怎样划分初始区域,也属于具体 Tokenizer 的设计,而不是仅凭“使用 BPE”四个字就能确定。
因此,不能仅凭肉眼观察一个单词,就准确断言它在某个模型中一定有几个 Token。与 Day 58、Day 59 一样,最可靠的答案来自目标模型的实际 Tokenizer。
十三、一个可操作的手算方法
面对小型教学语料,可以按下面步骤手算 BPE:
第一步:写出当前 Token 序列
new → [n, e, w]newer → [n, e, w, e, r]
第二步:只统计相邻项
new: n+e, e+wnewer: n+e, e+w, w+e, e+r
于是,这两行中 n + e 出现 2 次,e + w 也出现 2 次。教学题若出现并列,必须给出选择约定;工程实现则应使用自己的确定性规则处理。
第三步:执行选定合并
假设选 e + w → ew:
new → [n, ew]newer → [n, ew, e, r]
第四步:重新统计,不要沿用旧计数
new: n+ewnewer: n+ew, ew+e, e+r
此时 n + ew 出现 2 次,是第一轮之后才形成的候选组合。
第五步:保存每一轮顺序
1. e + w → ew2. n + ew → new
仅仅在最后写下词表里有 ew 和 new 还不够。使用新文本时,需要知道哪个组合先形成。
这套手算流程能避免三类常见错误:统计不相邻的 Token、合并后忘记重新计数、只记结果而丢失规则顺序。
十四、从 BPE 结果到 Token ID
BPE 负责决定片段边界,但模型最终仍需要整数 ID。
假设固定规则把 newer 切成:
[new, er]词表又规定:
new → 120er → 87
那么模型输入是:
[120, 87]这两个 ID 再按 Day 59 的机制读取 Embedding 参数行。完整链路可以写成:
原始文本→ 预处理与基础符号→ BPE 按有序规则合并→ 最终 Token 列表→ 词表查找→ Token ID→ Embedding
如果推理时换了一套 BPE 规则,newer 可能变成 [n, ew, er];即使每个片段都能查到合法 ID,模型收到的序列也已经不同。因此,词表、规则、编号与模型参数必须作为一个整体保持匹配。
十五、如何判断一段描述说的是不是 BPE
看到一种 Tokenizer 描述时,可以问四个问题:
基础符号是什么? 是字符、字节,还是其他预定义单位? 候选关系是什么? 是否只考虑当前序列中相邻的片段对? 合并规则怎样保存? 是否记录了优先级或学习顺序? 合并预算是什么? 何时停止新增组合 Token?
如果只说“把词拆成更小片段”,信息还不足以说明它就是 BPE;如果只给出最终词表,也无法还原完整切分过程。
一套可复现的 BPE 描述,至少应让使用者知道从什么基础单位开始、有哪些规则、规则按什么优先级应用,以及最终怎样映射到 Token ID。
十六、关于 BPE 的常见误解
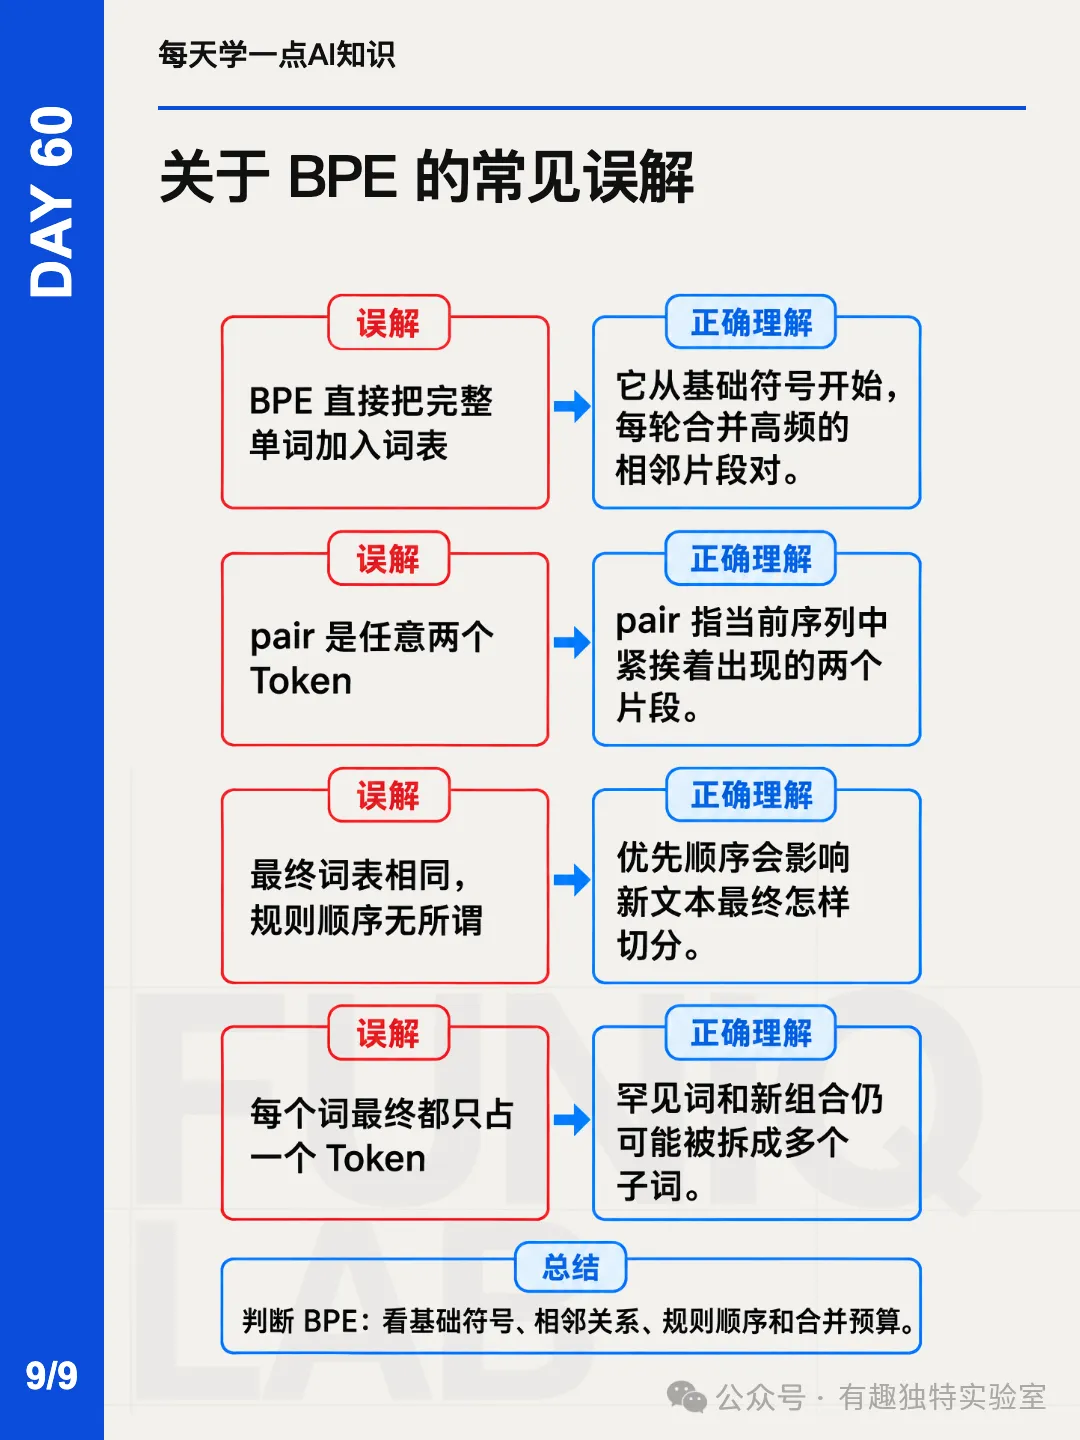
误解一:BPE 直接把完整单词加入词表
不对。BPE 从基础符号开始,每轮合并当前高频的相邻片段对。完整词若成为一个 Token,也是多轮局部合并逐步形成的结果。
误解二:pair 可以是任意两个 Token
不对。这里的 pair 指当前序列中紧挨着出现的两个片段。不相邻的两个 Token 不能直接参与同一次合并。
误解三:合并就是用新 Token 替换并删除基础 Token
不对。训练通常向词表新增组合 Token,同时保留基础 Token,以便表示没有匹配该组合的其他文本。
误解四:只要最终词表相同,合并顺序无所谓
不对。较晚规则可能依赖较早规则创造的片段。优先顺序会影响新文本最终怎样切分。
误解五:每个词最终都会只占一个 Token
不对。词表预算有限,罕见词、新组合和特殊字符串仍可能被拆成多个子词。
误解六:增加合并次数会自动缩短所有文本
不一定。只有能匹配新增规则的文本才会受益;不常见输入可能仍保持较细切分。
误解七:BPE 一定从字符开始
不对。字符只是本文为了方便演示采用的基础单位。BPE 也可以构建在字节或其他预定义单位上。
误解八:使用 BPE 时还要为每段新文本重新统计频率
不对。频率统计属于训练阶段。使用阶段加载固定词表和有序规则,不能根据单次输入临时改写协议。
十七、今天真正要建立的心智模型
BPE 不是“猜一个单词该从哪里切开”,而是在有限预算下,把训练语料中的重复局部结构逐步写进词表:
从小单位开始→ 统计当前相邻对→ 合并高频组合→ 新增一个更长 Token→ 更新当前序列→ 重新统计→ 达到预算后停止
训练完成后,这个学习过程被冻结为一套词表与有序规则:
新文本→ 相同基础单位→ 相同规则顺序→ 相同 Token 切分→ 相同 Token ID 协议→ 与模型参数保持匹配
它解决的不是“怎样让所有词都成为一个 Token”,而是更实际的问题:在有限词表中,哪些片段值得拥有独立地址?
常见片段被打包后可以减少序列位置;罕见新词则继续使用较小片段表示。词表大小、模型参数规模、文本覆盖能力和序列长度之间的平衡,就体现在一次次合并选择里。
十八、本日总结
BPE 从基础符号开始。 基础单位可以是字符、字节或其他预定义单位,并非固定为字符。 每轮只合并当前序列中的相邻片段对。 不相邻的 Token 不能直接组成一次 BPE 合并。 合并会新增组合 Token,并保留较小片段。 因而词表通常随合并轮次逐步增大。 每轮结束后必须更新序列并重新统计。 一次合并会创造新的相邻关系,也会消除旧关系。 合并规则必须有顺序。 后续规则可能依赖前序规则产生的片段,顺序不同可能导致最终切分不同。 训练与使用是两个阶段。 训练阶段从语料统计并学习规则;使用阶段加载固定规则,不重新训练。 BPE 在词表大小与序列长度间折中。 较多合并通常带来较大词表,并让匹配常见片段的文本使用较少 Token。 未完整收录的词仍可能被表示。 只要它能拆成已有基础符号或子词,就不需要为每个完整形式单独准备条目。 BPE 结果最终仍要映射成 Token ID。 词表、规则、编号与模型参数必须保持匹配。
自检
如果当前序列中选中的相邻片段对是 e + w,BPE 下一步做什么?在 [n, e, w]中,n + w能否直接成为当前相邻对?为什么执行 e + w → ew后要重新统计?为什么必须保存合并规则顺序? 合并次数较少和较多时,词表大小与序列长度通常怎样变化? 训练语料中没作为完整形式出现过的单词,为什么仍可能被表示? 使用阶段是否要针对每段新文本重新统计整个训练语料? 看到“BPE”能否断定基础单位一定是 UTF-8 字节?