ARTICLE · 1321829
百度文档识别免费了:2000页不要钱,别再花钱录入
10月27日,百度发布了并开源了文心 Unlimited OCR 2,可以一次性解析《哈利·波特》全系列七部,总共超过三千六百页。更实在的是价格:云上每月2000页免费,超过的部分限时0.02元/页。
对于普通用户而言,这条新闻的价值不在于它是“全球首次”,而是在于它以后可以用来处理一堆PDF文件的时候,又多了一个不用花钱的选择。
它到底解决了什么麻烦
传统的OCR就是一页页地拍照然后拼接起来:标题、正文、表格混在一起,表格被翻页拦腰截断,段落读到一半就接不上了。做过扫描件录入的人知道,最耗时的是识别之后再一页页地核对。
Unlimited OCR 2把版面理解也纳入模型:标题、段落、表格、公式、图片都能自动切分,输出顺序与人的阅读顺序一致。跨页表格能识别出延续的关系并合并,模型也会按语义接续被打断的段落,不会丢失文字、不会乱序、不会重复。
举一个最常见的情况就是一份几百页的合同,财务报表占了两页。以前只能手工拼表或者复制粘贴,数字就会错位。现在的输出就是完整的表格了,你可以直接筛选、求和。
用普通的话来说,以前你要对着两页截图手工拼表,现在它自己就接上了。
免费额度够不够用
我特意查看了百度智能云的公告页面,额度会按照自然月来自动刷新,个人和企业认证的用户都是一样的标准,当月没有用完的额度不会结转到下个月。超出部分按页后付费方式计费,并且不预充值,也不购买套餐。
算给你看:处理5000页文档的话,前2000页是免费的,剩下的3000页按照每页0.02元来计算,总共是60元。2000页的免费额度,大约相当于20份百页合同,日常办公应该够用了。
60元是什么意思呢?人工录入,按页报价一般远远超过这个数字;购买一些扫描转换软件,一年会员费就可以解析几千页。最容易多花冤枉钱的地方就是为了一堆用不上的功能而购买顶配。就是转几份合同,免费额度基本上用不完,没有必要上来就充钱。
但是如果有几千页档案需要处理,按量付费比包月更合算。开源模型可以在GitHub和HuggingFace上免费下载,自己部署不需要支付调用费用,但是需要有显卡,并且会调环境——节省的是钱,花费的是时间。
另外一点要注意的是:如果只是一月转几份文件,用完免费额度就停止使用,不要顺手勾选自动续费或者年包。工具再好,不用也是白搭。
分数之外,看它能干什么
公开基准上,MPDocBench得了84.6分,专门测试百页级超长文档的MarathonDocBench得了77.1分,两者都是端到端SOTA,官方表示比Qwen 3.8-Max、Gemini-3.8-Flash等模型领先3.8-Max。
分数不用记,记场景就可以:几百页的招股书、砖头一样的合同卷宗、一仓库的历史档案,丢进去之后出来的是可以直接检索的结构化文本。以前这样的工作要么外包,要么熬夜复制粘贴。
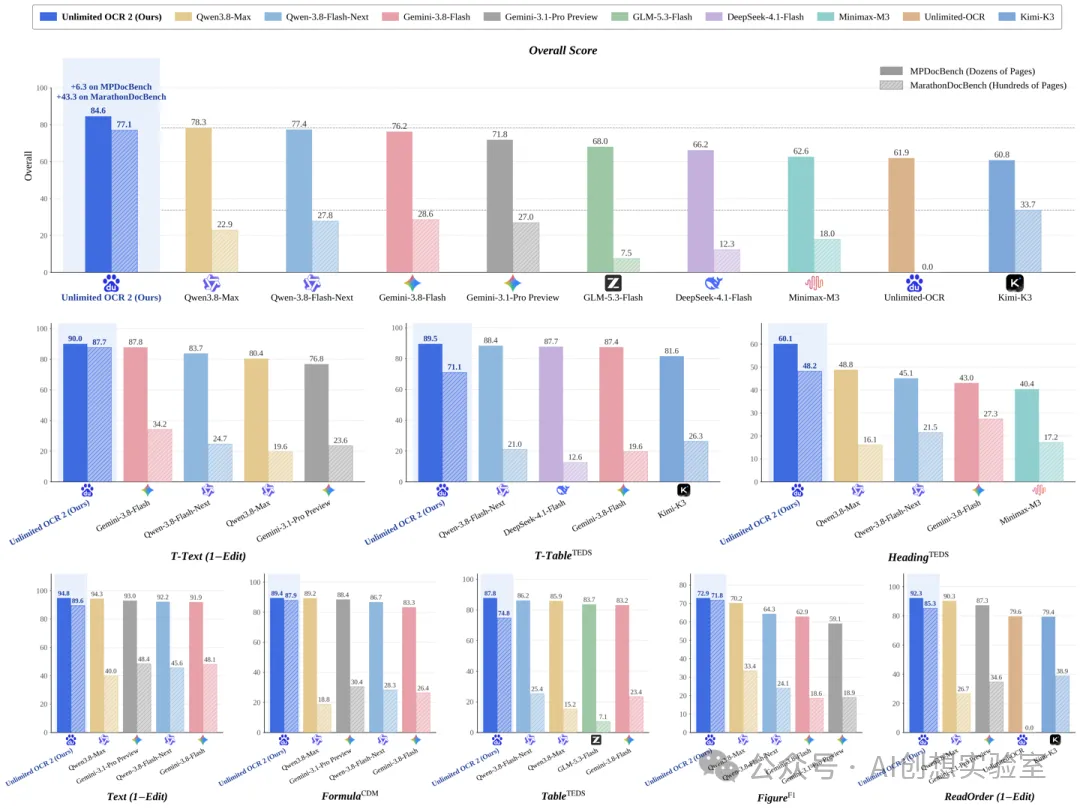
另外一点就是:在同样的算力下,可以处理更多数据,速度更快,成本更低。对于按页收费的用户来说,这就是账单上的体现。
两条路,坑在哪
不想碰代码的,可以使用百度智能云或者百度AI开放平台的文档解析接口,认证之后领取额度,按页收费,适合个人和小团队。懂技术的可以直接拿开源模型自己部署,适合量大、又不希望把资料传出去的情况。
坦白地说,有两个地方需要提前说明一下。第一,“无限页数”指的是模型可以连续处理超长文档,并不意味着糊照片也能识别出来,扫描的质量、字体、手写的内容都会影响到结果,重要的文件可以先少量试一下。第二,免费额度当月清零,不要攒到年底再一次性使用;0.02元是限时价,之后是否调整要看官方公告。
今天就能做的三件事
手上如果有几百页一直懒得整理的PDF,先拿20页来试一下识别功能,看表格和段落衔接得是否顺畅;如果效果好,再决定是否继续使用免费额度或者付费;资料中包含个人隐私信息的,优先选择本地部署,不要为了省事把整个档案上传到云端。
工具是免费的,你节省下来的不只是订阅费,还有盯着屏幕复制粘贴的时间。如果你的文章能帮人算清账,就点个赞吧,转发给那个被合同、报表困住的同事。