ARTICLE · 1325223
装个软件就有人替你挑模型,它挑得准吗
赛博充电桩 | Skill 实测 | 实测日期 2026-11-06 | 花费 0 元 | 全程本机
装一个软件,在自己电脑上跑 AI 这件事,就不需要你再挑模型了。
这句话听着太舒服了,舒服到我一开始不太敢信。
我是赛博充电桩,手边一台笔记本,专挑别人说「装完就能用」的东西自己装一遍。
我这人懒,最受不了为了跑一个模型先花两个晚上比较哪个量化档(把权重从高位宽压到低位宽、体积更小)更划算。
所以看到 hob 那句「它会替你挑一个你机器跑得动的模型,还顺手把环境配好」,我当天就装了。
装完脑子里只剩一个问题:它挑得准吗?
它挑模型是真的,而且不瞎
它怎么挑:逻辑几十行,配一张显卡带宽表。我把这段逻辑单独拎出来,喂它九台机器的参数;同一份目录、同一套规则,只改机器。
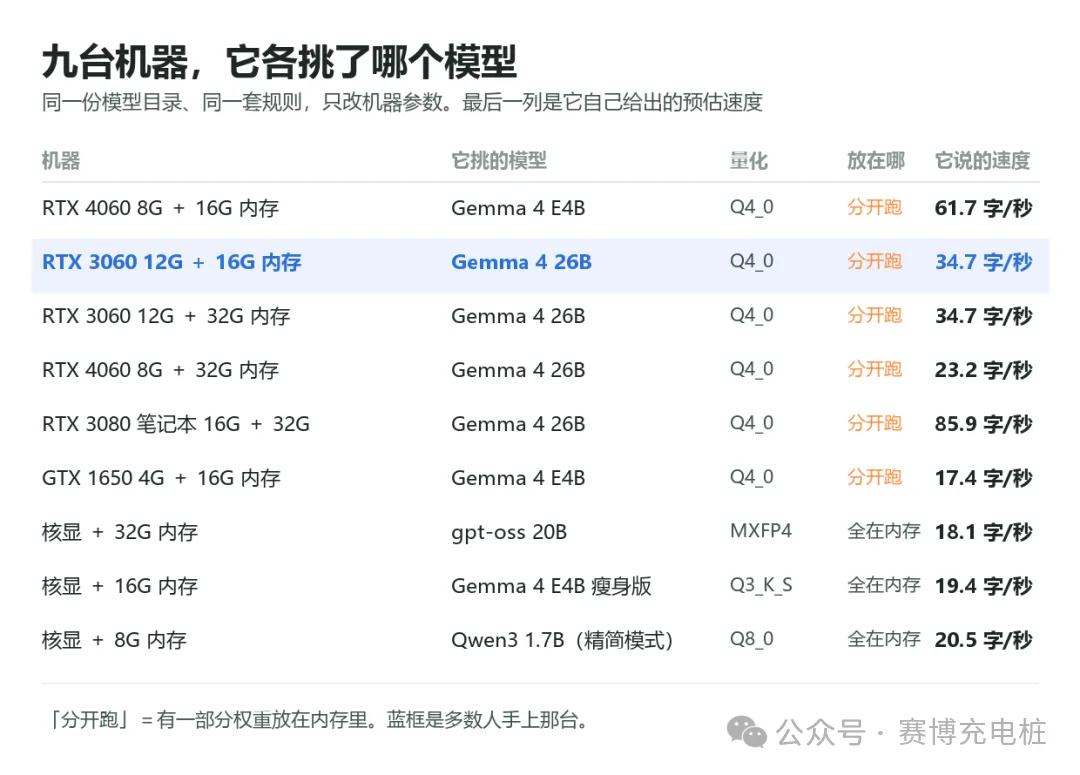
方向是对的:显卡越强,它给的模型越大。4GB 显存的旧卡(显存指显卡上专门放权重和中间结果的内存,不够就装不下),它给一个 3.35GB 的;12GB 的卡上一个 14.44GB 的大家伙。核显机器也没被放弃:8GB 内存的核显机,它自动切到精简模式,只留一个 1.7B 的小模型。
我在别的工具上见过太多「没显卡就白屏」的处理,它这里老老实实降档,一点不装。
它报的速度,笔记本要打折
表里每行后面还有个「字/秒」,那是它算的,比模型名字重要——决定你等不等得起。
它算得准不准?我把这台笔记本的实测数拉出来,一个个对。
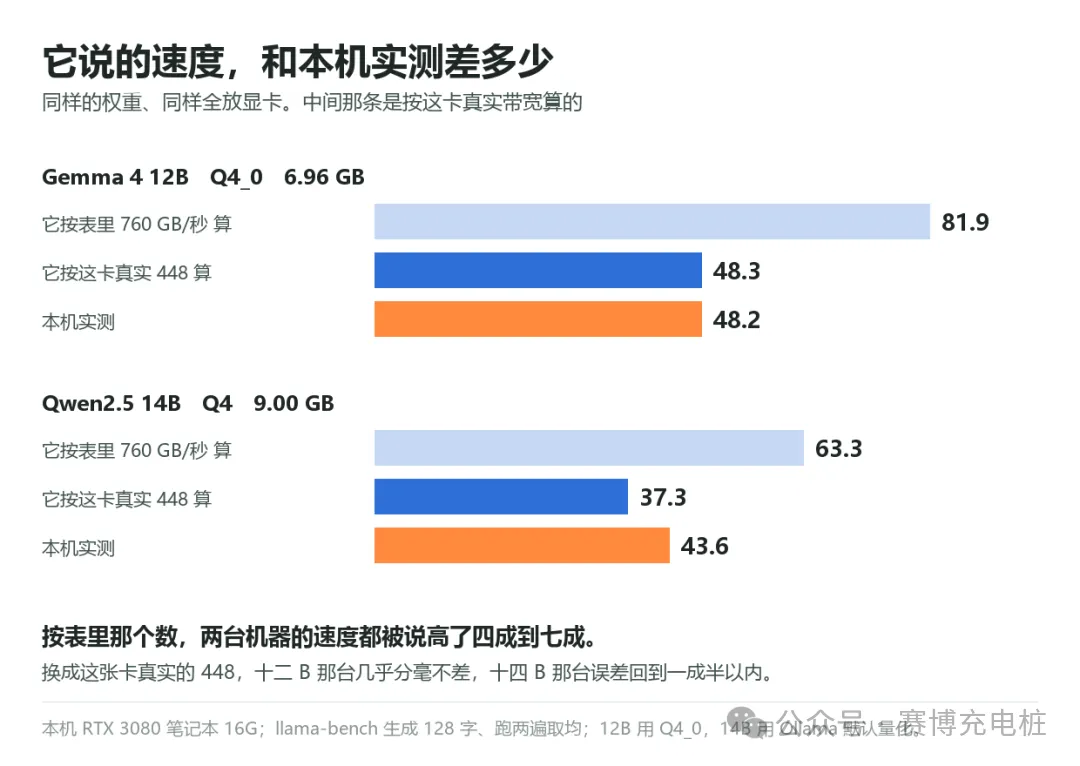
同一个 12B 的模型,全放显卡上跑,它说能到 81.9,本机实测 48.2。
我以为是这一个模型的问题,又换了个 14B 的,它说 63.3,实测 43.6。
这一行口径单说:63.3 按表里的 760 算,37.3 按这卡真实的 448 算,公式都是「带宽 ÷ 权重字节 × 0.75」——据源码,0.75 是写死的折扣。43.6 是本机实测:这一档跑起来的效率接近 0.87,比 0.75 高,所以高出一截。
43.6 是 Ollama 自己报的 eval rate:吐出的词元(token)数除以耗时,读提示词的时间不算;API 文档里这两个字段叫 eval_count 和 eval_duration。
想自己复一遍就下面两行,模型选 qwen2.5:14b,跟实测那一档同一个。
ollama pull qwen2.5:14b ollama run qwen2.5:14b --verbose # 提示词:用三句话说明为什么本地跑模型要关心显存带宽。43.6 是脚本打 /api/generate 自己算的;命令行里 --verbose 打出来的 eval rate 也是这个数。
差四成到七成。这已经不是四舍五入,是你端着一杯水等它和放下杯子就能用的区别。
原因藏在表里:「RTX 3080 是 760」对台式机那张卡是对的,可它认卡只看名字里有没有这几个字——笔记本那张也带着,就被当成台式机算了。
这卡真实带宽 448,差不多正好是台式那张的六成。代回去,12B 那台算出来 48.3,实测 48.2。
差的那一点点,才叫四舍五入。所以算法本身站得住,垮掉的是表里那一个数。
你要是台式机,这条跳过;你要是笔记本,看到它给的速度先按七折算。
这些模型放在一个打不开的地方
上面还只是准不准,下面是能不能用上,更扎心。
它列的八个模型、十三个下载文件,地址我逐个看过——全在一个网站上。
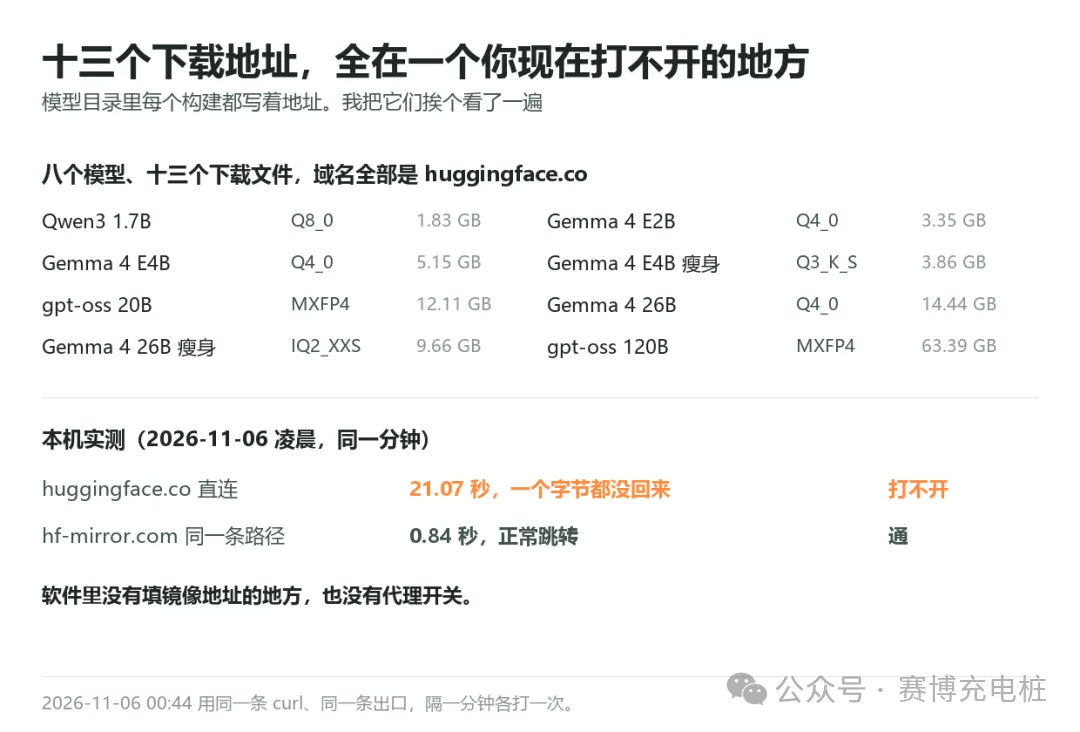
同一分钟里我亲手打了两次:直连等到 21 秒,一个字节都没回来;换同一个文件的镜像路径,0.84 秒就跳过去了。
客户端我没打开过,界面能不能填镜像地址我不猜。能查的是源码:下载地址写死在各处,全是 huggingface.co,没镜像项、没代理开关。软件你装上了,模型下不下来是另外一关。
显存多两 G,它报得更慢
我原先以为显存越大报得越高,扫描完才发现不是这么回事。
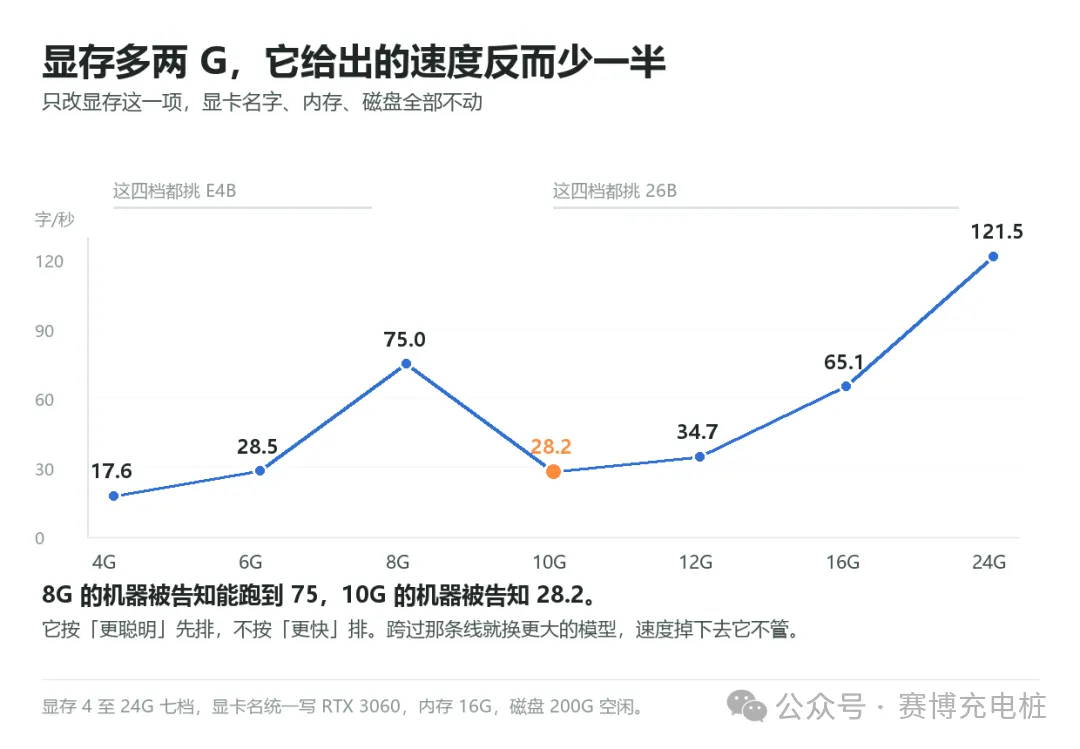
8GB 的机器,它挑一个 5.15GB 的模型,报 75;10GB 的机器,它挑一个 14.44GB 的,报 28.2。不复杂:它按「更聪明」排,不按「更快」排——放得下更大的就立刻换,哪怕得挪一部分去内存跑。
所以你看到的是取舍,把它当速度看就偏了:它把「我要最聪明」当默认,多数人想的是「别让我等」。
挪一部分去内存,有多伤
「分开跑」听着温和,实际多伤?我拿一个 14B 试:同一个模型,48 层,只改放在显卡上的层数。
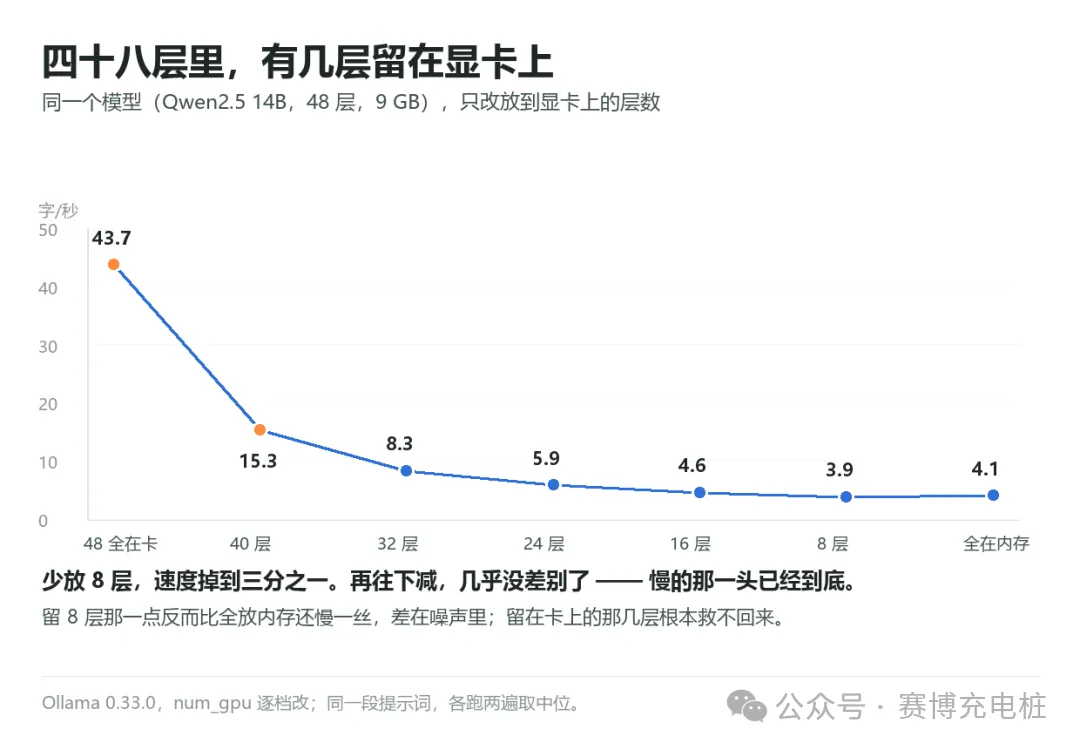
全放卡上 43.7;少放 8 层,掉到 15.3;再往下减,差不多就是一条平线。
慢的那头已经到底,再腾一层也救不回多少。规律很硬:塞得进显存速度就在,塞不进就别指望剩几层能救。
怪不得它给 12GB 卡推那个 14.44GB 的模型时,报出来的数只有 34.7。
落到你那台机器上,分三档
第一档,8GB 显存:挑那个 5.15GB 的,据它模型目录是 gemma-4-E4B_q4_0-it.gguf;整块塞进显存比挪一层去内存稳,跑得动也够用。
第二档,12GB 显存:它推的那个 14.44GB 大模型,你自己往小改一档,省下的差不多是一倍——这档最容易被默认值带偏。
第三档,核显机器:直接用它的精简档,别硬上大的,反正大的也跑不动。这三条你不用记型号,记一句就够:塞得进去就快,塞不进去就慢。
它没管到的地方
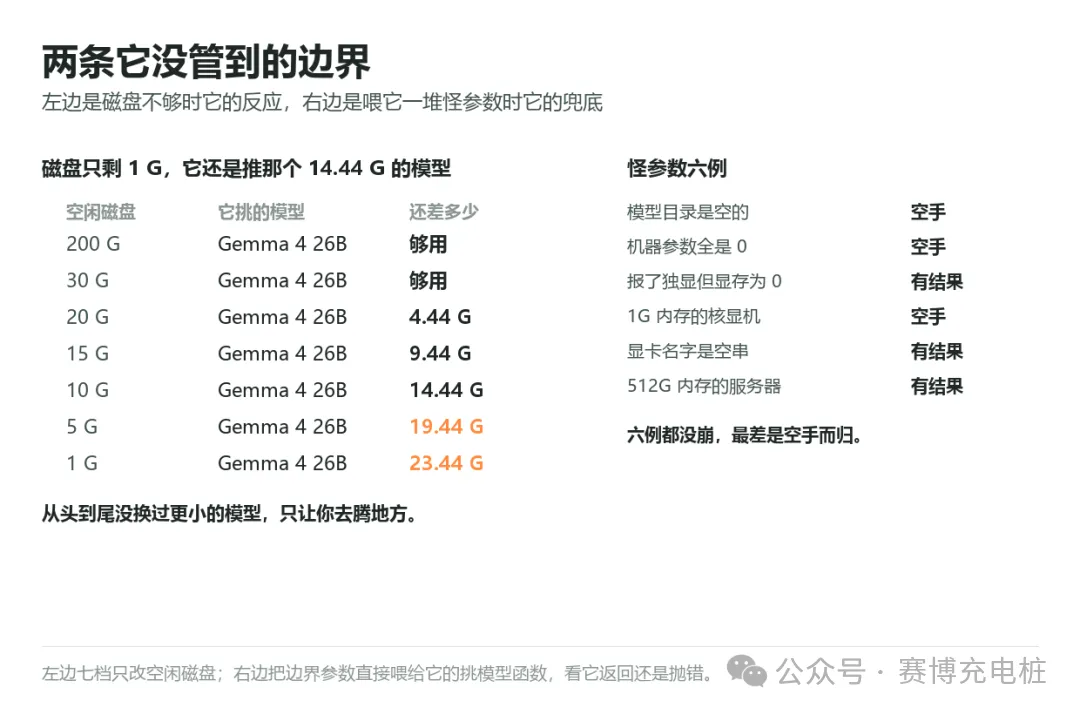
磁盘不够,它不降级:剩 1GB 时还在推那个 14.44GB 的模型,只提示还差 23.44GB。据它源码,14.44GB 是文件体积;23.44GB 是差额口径——模型体积加 10GB 余量,再减去剩的 1GB。明明目录里就有更小的能跑,它没换,偏偏让你去腾地方。
倒是怪参数那六种,它一个都没崩,最差是空手而归——比我想的稳。
还有几件没做成,一条条说:客户端我装上了,安装包 402MB,装完目录也在,它也自己起过一次。
但它在这台机器起不来窗口:进程起过、配置目录写出来了,窗口一次没出现,也没任何报错,界面我到今天没点进去。
所以「点了下载之后会发生什么」,我是按源码和网络实况说的,没亲眼看见。另外,它推的大模型是混合专家结构,本机没有同尺寸权重,那条「分开跑」曲线是用普通结构做的;普通结构对分开跑更敏感,跌幅说不定更狠。
台式机的 3060 和 4060 我也没实机跑,手里只有一台笔记本。
「最后」
我的判断:它挑模型是真的,方向对,降档也稳,这部分值得留着。速度那个数字,笔记本用户先打七折再看,别按它写的数去安排时间。而权重全在墙外这一关,才是真正拦人的那道门。
这让我想起早年装播放器:软件装得挺顺,片子还得自己满世界找。它把「选」做完了,「拿」没做完——像一个替你写好清单的帮手,清单是对的,超市得你自己进。清单对了,也算替我省了两个晚上。
我是赛博充电桩,专挑别人说跑不动的东西试。下次见。
本文所据
软件仓库(MIT,本文测的 0.2.6):github.com/FrigadeHQ/hob
文中那个 5.15GB 权重对应的模型卡:huggingface.co/google/gemma-4-E4B-it-qat-q4_0-gguf
测速口径(eval_count / eval_duration):github.com/ollama/ollama/blob/main/docs/api.md
ollama run 用法与 --verbose 计时:github.com/ollama/ollama
对照一,同样在本地加载权重的 LM Studio:lmstudio.ai
对照二,它底下的推理引擎 llama.cpp(经 node-llama-cpp 接入):github.com/ggml-org/llama.cpp
数据来源:本机实测 2026-11-06,对象是 hob 0.2.6(MIT 授权,Windows 安装包 421,875,040 字节,仓库文件一行未改,仅把两处相对导入补上扩展名以便单独运行)。九台机器的挑选结果与磁盘七档、怪参数六例,来自仓库自带的挑模型函数与模型目录原文;两遍哈希一致、无随机项。速度对账与四十八层卸载曲线来自本机 RTX 3080 笔记本 16G(驱动 610.62),llama.cpp 内部版本 9128 与 Ollama 0.33.0,权重为 gemma-4-12B Q4_0、qwen2.5 14B;提示词与采样参数固定,各跑两遍取中位。带宽 448 GB/s 取该卡官方规格。下载可达性为同一分钟两条 curl 实测。